Mười một phần trước mỗi phần dựng một tình huống và đếm: dòng mất, giây chờ, byte WAL, lần vacuum. Phần này không dựng thêm gì. Nó gom những con số đó thành thứ người vận hành thật sự cần lúc 3 giờ sáng: một runbook ngắn — làm gì, bao lâu một lần, vì sao — và một bó truy vấn trả lời "cụm này hôm nay có gì cần tay" trong mười giây. Để bó truy vấn không là lý thuyết, nó chạy trên chính cụm thí nghiệm của sê-ri — cụm đã qua năm timeline, hai lần kill, một lần rewind, và 39 GB WAL — và kết quả chỉ ra ba việc.
Runbook: bốn mục, mỗi dòng một con số đứng sau

Hình 1: Bốn mục của runbook. Mỗi dòng là một việc, một nhịp, và con số đo được trong sê-ri khiến dòng đó có mặt.
Sao lưu. Câu hỏi đúng không phải "tệp bao nhiêu MB" mà là khôi phục về khi nào, mất bao lâu. Phần 1 đo: dump chụp lúc bắt đầu, basebackup nhất quán lúc kết thúc, và chỉ basebackup cộng WAL lưu trữ mới về được một giây bất kỳ. Phần 4 đo giá của một giây: 1.500 dòng hay 100 dòng, và RTO là chép basebackup cộng WAL chia 250–440 MB/s — nên nhịp basebackup là hàm của tốc độ sinh WAL, không phải của lịch. Phần 2 nhắc hai việc dump không làm: pg_dumpall --globals-only trước và ANALYZE sau. Và một việc duy nhất không có công cụ nào thay được: tập khôi phục thật, hằng tháng, tới một đích thời gian — vì "ready to accept read-only connections" chưa phải xong và đích trước basebackup không báo lỗi.
Sao chép. Phần 5 cho thấy slot là khác biệt giữa "bắt kịp sau 5 giây" và "dựng lại từ đầu", và cũng là cách replica chết kéo primary đầy đĩa — nên slot đi kèm max_slot_wal_keep_size. Phần 7 đo cái giá của đồng bộ: async mất 22 commit đã xác nhận, sync mất 0 nhưng một replica sync chết làm primary treo chín phút mà statement_timeout không cắt — nên synchronous_commit đặt theo bảng, và ít nhất hai replica sync. wal_log_hints = on phải bật trước ngày cần pg_rewind. Phần 6 cho replica báo cáo một công thức: hot_standby_feedback on cộng statement_timeout, biết rằng bloat chuyển sang primary. Phần 8 cho logical replication ba quy ước thay cho ba cơ chế không có.
Sức khoẻ. Tám con số, không phải tám mươi: archiver không lỗi; lag đo bằng LSN chứ không bằng now() − pg_last_xact_replay_timestamp() (tăng tới 20 giây khi primary rảnh); slot active và wal_status; age(datfrozenxid) so với ngưỡng; n_dead_tup theo bảng — răng cưa là khoẻ, leo thẳng là bệnh; pg_stat_activity với Lock, idle in transaction, giao dịch dài nhất; kết nối so với max_connections và cl_waiting ở pool; tỉ lệ checkpoint bị ép và buffers_backend so với buffers_checkpoint.
Thay đổi. Phần 10 đo thứ làm migration "vô hại" thành sự cố: không phải ALTER mà là giao dịch quên đóng ở chỗ khác — nên SET lock_timeout cộng retry là dòng đầu tiên của mọi migration; CONCURRENTLY, NOT VALID → VALIDATE, và CHECK rồi SET NOT NULL tách khoá ngắn khỏi quét dài; default volatile viết lại bảng còn now() thì không. Phần 11 thêm: qua pool, SET dính vào kết nối cho người sau, nên SET LOCAL. Phần 9: autovacuum mặc định không theo kịp bảng lớn theo thiết kế, chỉnh per-table.
Bó truy vấn trên cụm thật, và ba việc nó chỉ ra
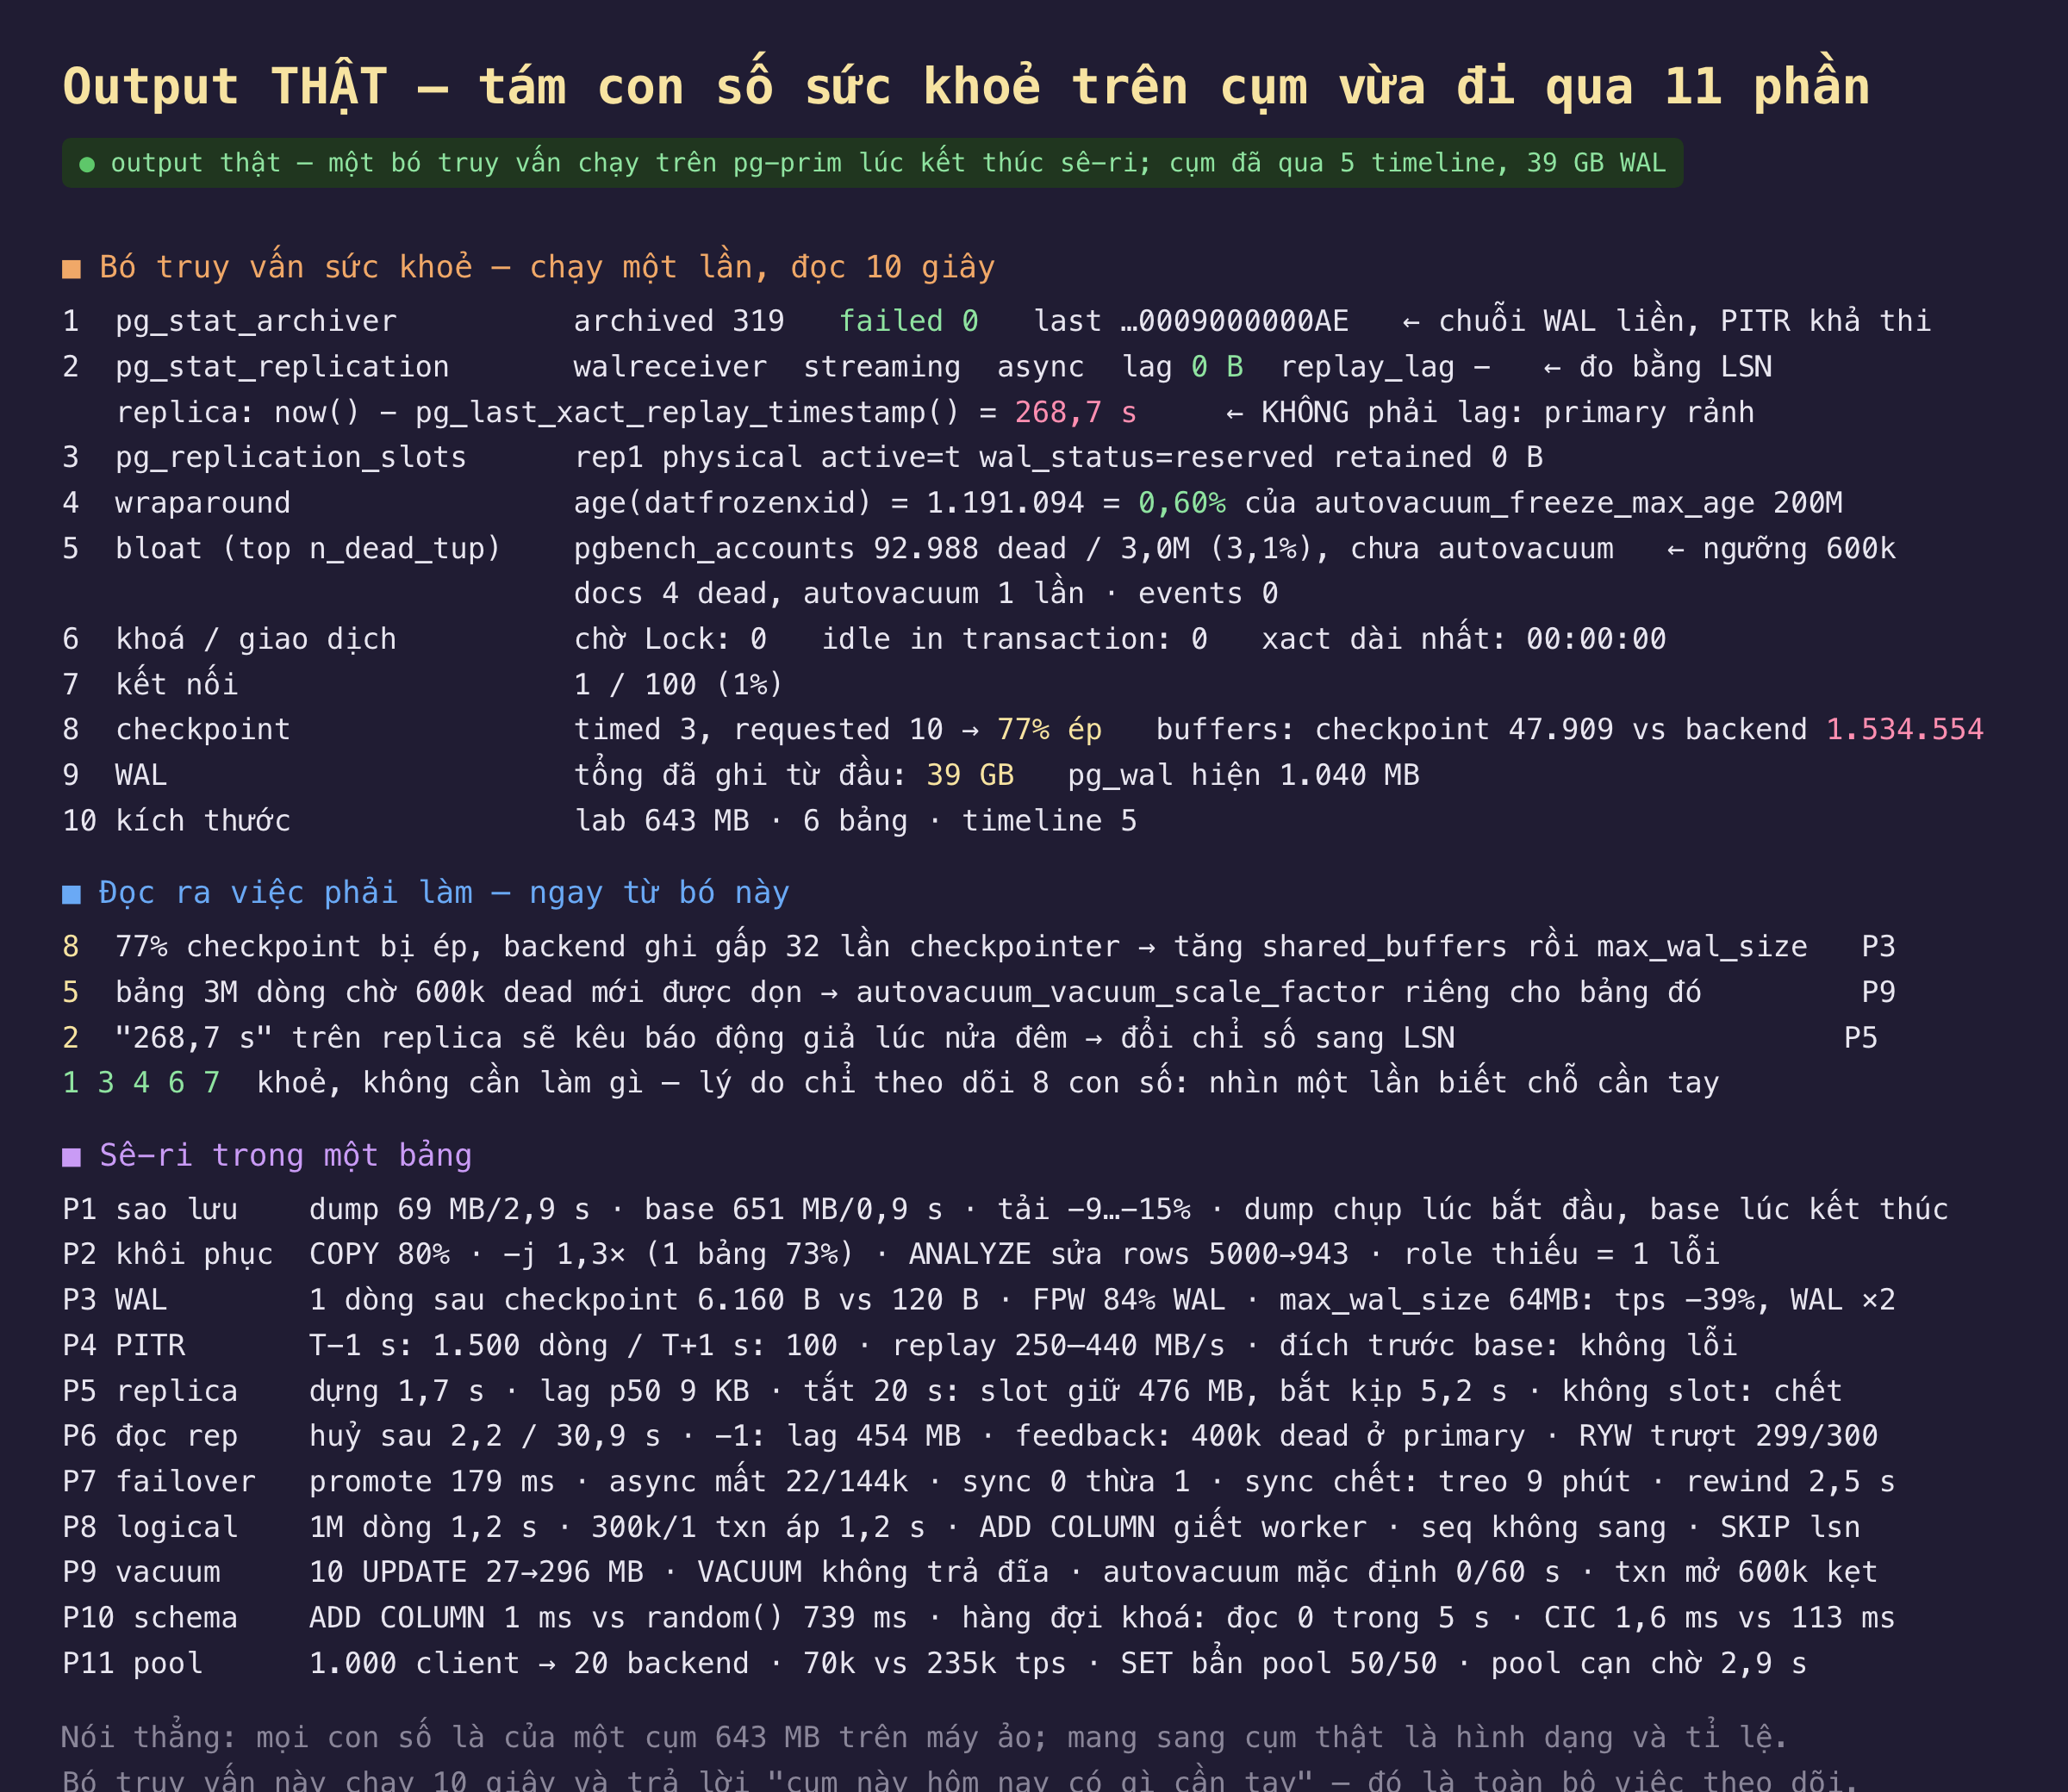
Hình 2: Mười truy vấn trên cụm thí nghiệm lúc kết thúc. Năm chỉ số khoẻ, ba chỉ số chỉ ra việc phải làm, và một chỉ số là báo động giả nếu đo sai cách.
| chỉ số | giá trị trên cụm | đọc ra |
|---|---|---|
| archiver | 319 segment, 0 lỗi | chuỗi WAL liền, PITR còn khả thi |
| replication lag (LSN) | 0 B | khoẻ |
replica now() − last_xact_replay |
268,7 s | báo động giả: primary rảnh |
| slot | active, reserved, 0 B giữ | khoẻ |
age(datfrozenxid) |
1,19 triệu = 0,60% ngưỡng | khoẻ |
| dead tuple | pgbench_accounts 92.988 (3,1%), chưa autovacuum |
chỉnh scale_factor per-table |
| lock / idle in txn / xact dài | 0 / 0 / 0 | khoẻ |
| kết nối | 1/100 | khoẻ |
| checkpoint | 77% requested, backend 1,53M vs checkpointer 48k buffer | tăng max_wal_size, shared_buffers |
| WAL đã ghi | 39 GB cho CSDL 643 MB | giá của 11 phần thí nghiệm |
Năm chỉ số nói "không cần làm gì", và đó là giá trị của chúng. Archiver 319 segment không lỗi — kho WAL liền mạch kể từ lần dọn cuối, PITR của phần 4 vẫn khả thi. Lag 0 byte, slot active với 0 byte giữ, không ai chờ khoá, không idle in transaction, một kết nối trên trăm, age 0,6% ngưỡng. Một bảng theo dõi tốt phần lớn thời gian trông đúng như thế này, và lý do để nó chỉ có tám dòng là để dòng khác thường nổi lên ngay.
Ba chỉ số chỉ ra việc phải làm — trên một cụm vừa được chăm sóc suốt mười một phần. Thứ nhất: 77% checkpoint bị ép bởi max_wal_size (10 requested trên 3 timed) và backend tự ghi 1,53 triệu buffer so với 48.000 của checkpointer — đúng hình dạng phần 3 đã đo ở shared_buffers 128 MB mặc định. Việc: tăng shared_buffers rồi max_wal_size, theo thứ tự đó. Thứ hai: pgbench_accounts ba triệu dòng có 92.988 dead tuple và chưa được autovacuum lần nào — vì scale_factor 0.2 nghĩa là chờ 600.000, y như phần 9. Việc: ALTER TABLE … SET (autovacuum_vacuum_scale_factor = 0.01). Thứ ba: replica báo 268,7 giây kể từ giao dịch cuối cùng được replay, trong khi lag thật là 0 — chỉ số này sẽ kêu lúc nửa đêm vì hệ thống rảnh, như phần 5 cảnh báo. Việc: đổi cảnh báo sang pg_wal_lsn_diff trên primary hoặc replay_lag.
Cụm thí nghiệm trả giá 39 GB WAL cho 643 MB dữ liệu. Con số cuối không phải để sửa mà để nhớ: mười một phần với pgbench, UPDATE toàn bảng, basebackup và failover đã sinh WAL gấp 60 lần kích thước CSDL. WAL là giá của mọi thứ — sao lưu, sao chép, khôi phục — và cũng là thứ đầy đĩa trước tiên khi slot kẹt hay archive hỏng. Tám con số ở trên có bốn con liên quan tới nó.
Sê-ri trong một bảng
| phần | con số đáng nhớ |
|---|---|
| 1 Sao lưu | dump 69 MB / 2,9 s, basebackup 651 MB / 0,9 s; dump chụp lúc bắt đầu, basebackup lúc kết thúc |
| 2 Khôi phục dump | COPY 80%; -j 1,3× khi một bảng 73%; ANALYZE sửa rows 5000 → 943; role thiếu = 1 lỗi |
| 3 WAL & checkpoint | 1 dòng sau checkpoint 6.160 B vs 120 B; FPW 84% WAL; max_wal_size 64 MB: TPS −39%, WAL ×2 |
| 4 PITR | T−1 s: 1.500 dòng, T+1 s: 100; replay 250–440 MB/s; đích trước basebackup không lỗi |
| 5 Streaming replication | dựng 1,7 s; lag p50 9 KB; tắt 20 s: slot giữ 476 MB, bắt kịp 5,2 s; không slot: dựng lại |
| 6 Đọc trên replica | huỷ sau 2,2 / 30,9 s; −1: lag 454 MB; feedback: 400k dead ở primary; đọc-sau-ghi trượt 299/300 |
| 7 Failover | promote 179 ms; async mất 22/144k; sync 0 thừa 1; sync chết: treo 9 phút; rewind 2,5 s |
| 8 Logical replication | 1M dòng 1,2 s; 300k dòng/1 txn áp 1,2 s; ADD COLUMN giết worker; sequence không sang |
| 9 VACUUM | 10 UPDATE 27 → 296 MB; VACUUM không trả đĩa; autovacuum mặc định 0/60 s; txn mở kẹt 600k |
| 10 Đổi schema | ADD COLUMN 1 ms vs random() 739 ms; hàng đợi khoá: đọc 0 trong 5 s; CIC 1,6 ms vs 113 ms |
| 11 PgBouncer | 1.000 client → 20 backend; 70k vs 235k TPS; SET bẩn pool 50/50; pool cạn chờ 2,9 s |
Phạm vi của cả sê-ri
Mọi con số đến từ một cụm 643 MB trên một máy ảo 10 CPU, PostgreSQL 16, các container cùng một mạng Docker; shared_buffers 128 MB mặc định của image làm backend-write lấn át ở mọi phần có tải ghi. Thứ mang sang cụm thật là hình dạng và tỉ lệ — dump chụp lúc bắt đầu, lệch một giây là khác hẳn, slot giữ WAL, SET dính pool, ALTER chờ sau giao dịch mở — không phải giá trị tuyệt đối. Sê-ri không chạm: nâng cấp phiên bản lớn, Patroni hay repmgr cho failover có trọng tài, pg_repack, TOAST, và theo dõi bằng Prometheus (phần observability của một sê-ri khác đã làm).
Ba ý mang về
- Runbook là bốn câu hỏi, không phải bốn mươi lệnh: khôi phục về khi nào và mất bao lâu; slot và sync trả giá ở đâu; tám con số nào phải xanh; thay đổi này giữ khoá bao lâu. Mỗi câu có một con số đo được đứng sau.
- Tám con số đủ để biết hôm nay cần tay ở đâu: chạy trên cụm thí nghiệm, năm con xanh, ba con chỉ việc (checkpoint bị ép 77%, bảng lớn chưa vacuum, chỉ số lag sai) — đúng ba thứ phần 3, 9, 5 đã dạy.
- Đo bằng cách đúng, không phải bằng con số có sẵn: lag bằng LSN chứ không bằng timestamp cuối; "xong" bằng
pg_is_in_recovery()chứ không bằng cổng mở; thời gian khoá chứ không thời gian lệnh. Sai cách đo là báo động giả lúc nửa đêm và im lặng lúc sự cố.
Nguồn
- PostgreSQL 16 — Server Administration (toàn bộ phần III): https://www.postgresql.org/docs/16/admin.html
- PostgreSQL 16 — Monitoring Database Activity, các view
pg_stat_*: https://www.postgresql.org/docs/16/monitoring-stats.html - PostgreSQL 16 — Routine Database Maintenance Tasks: https://www.postgresql.org/docs/16/maintenance.html
- PostgreSQL Wiki — Don't Do This: https://wiki.postgresql.org/wiki/Don%27t_Do_This
- Mười một phần trước của sê-ri, mỗi phần kèm số đo và lệnh dựng lại: từ phần 1 đến phần 11.
