Bạn gõ Google "tối ưu PostgreSQL", nhận về 20 mẹo: thêm index, tăng shared_buffers, tránh SELECT *, dùng connection pool... Rồi bạn áp hết vào hệ thống, và nó vẫn chậm — hoặc tệ hơn, chậm đi. Vấn đề không nằm ở các mẹo (chúng đúng), mà ở chỗ bạn áp mẹo mà không biết nút thắt thật nằm đâu. Sê-ri này bắt đầu bằng nguyên tắc quan trọng nhất, thứ mà 199 bài sau đều dựa vào: đo trước, đoán sau.
Vì sao "đoán" luôn thua
Trực giác về hiệu năng gần như luôn sai, vì cơ sở dữ liệu là một cỗ máy nhiều tầng: planner, cache, đĩa, khóa, thống kê. Một truy vấn "trông đơn giản" có thể quét cả bảng; một truy vấn "trông nặng" có thể chạy trong 1ms nhờ index. Cách duy nhất để biết là hỏi thẳng PostgreSQL nó định làm gì và đã làm gì — đó là việc của EXPLAIN.
Hãy dựng dữ liệu thật để đo. Một triệu đơn hàng, không phải mười dòng đồ chơi:
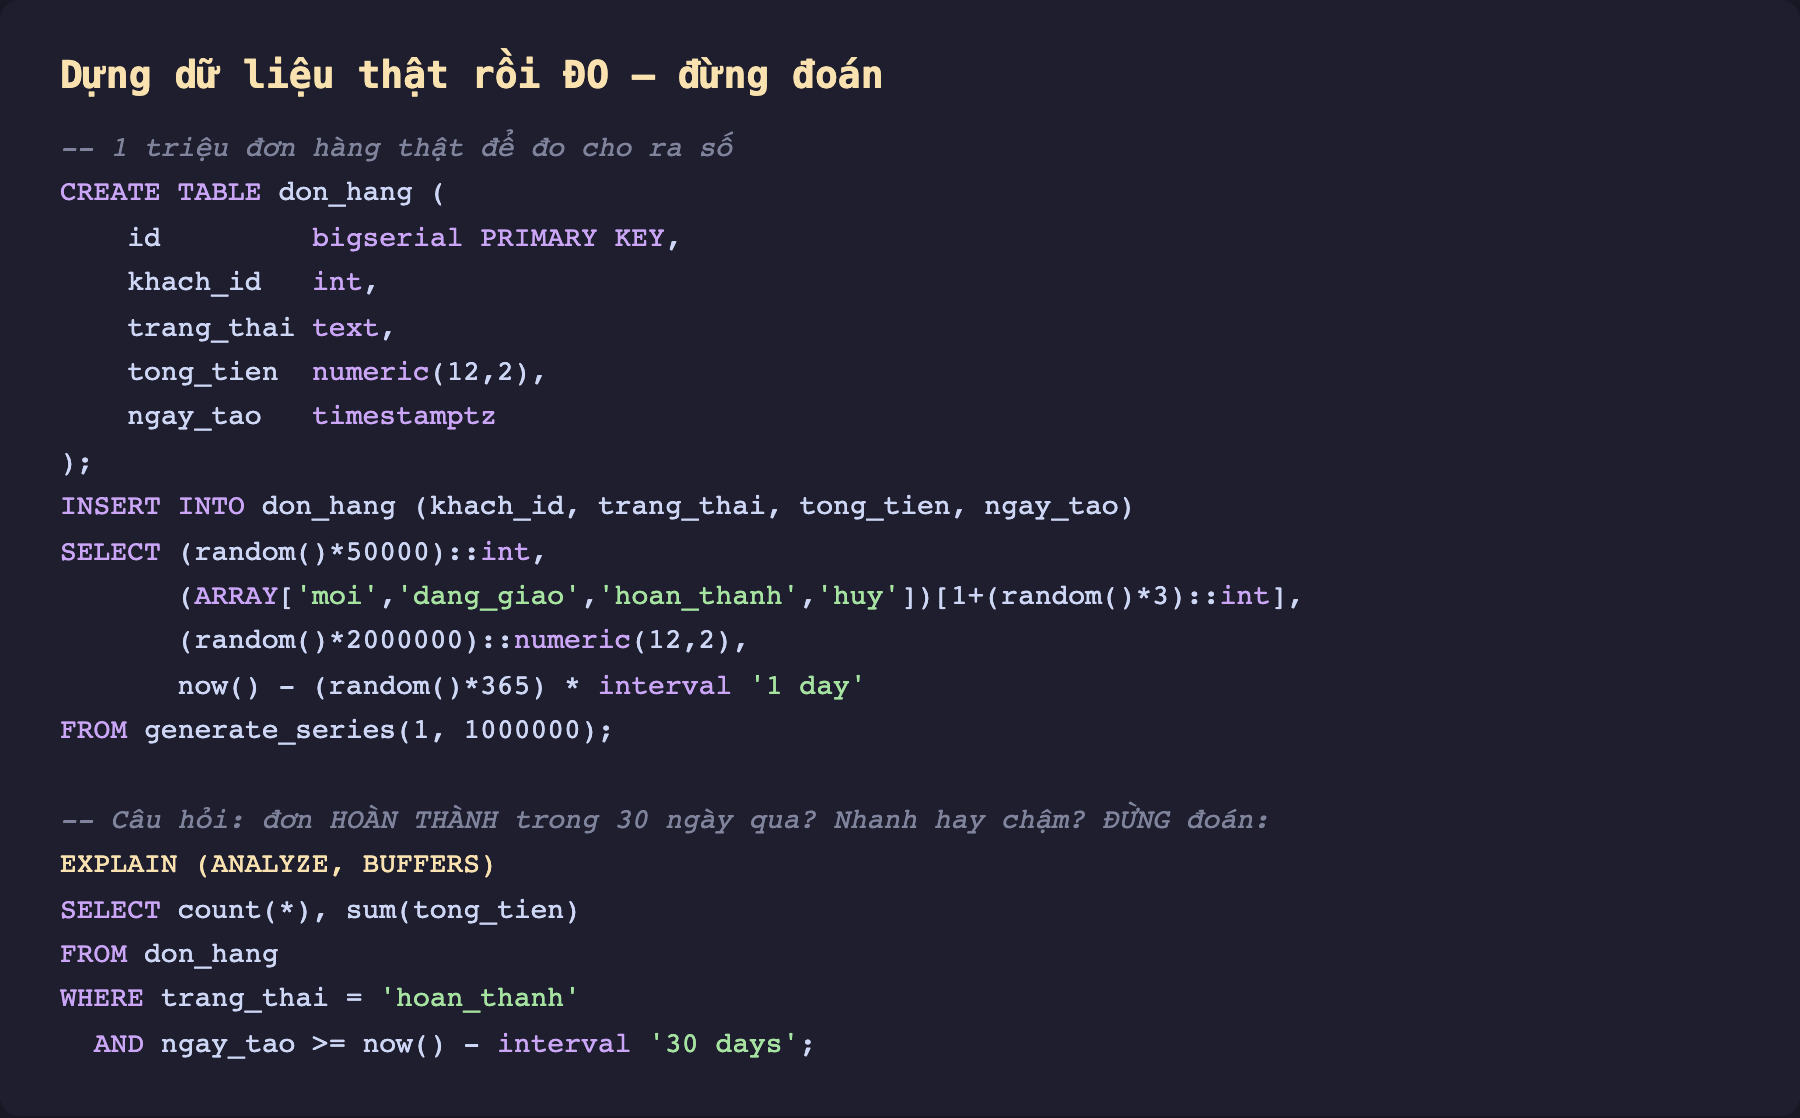
Hình 1: Bảng don_hang với 1 triệu dòng sinh bằng generate_series — dữ liệu ngẫu nhiên nhưng đủ lớn để con số đo có ý nghĩa. Câu hỏi nghiệp vụ: tổng tiền đơn "hoàn thành" trong 30 ngày qua. Thay vì đoán nó nhanh hay chậm, ta bọc truy vấn trong EXPLAIN (ANALYZE, BUFFERS).
EXPLAIN (ANALYZE, BUFFERS): ba từ khoá, cả sự thật
EXPLAIN— PostgreSQL in ra kế hoạch nó định chạy, kèm chi phí ước lượng (cost).ANALYZE— chạy thật rồi in thời gian và số dòng thực tế (actual time,rows). (Cẩn thận:ANALYZEthực thi truy vấn — vớiUPDATE/DELETEphải bọc trong transaction rồiROLLBACK.)BUFFERS— cho biết đọc bao nhiêu trang từ cache (shared hit) so với từ đĩa (read).
Chạy thật trên PostgreSQL 16 với bảng 1 triệu dòng:
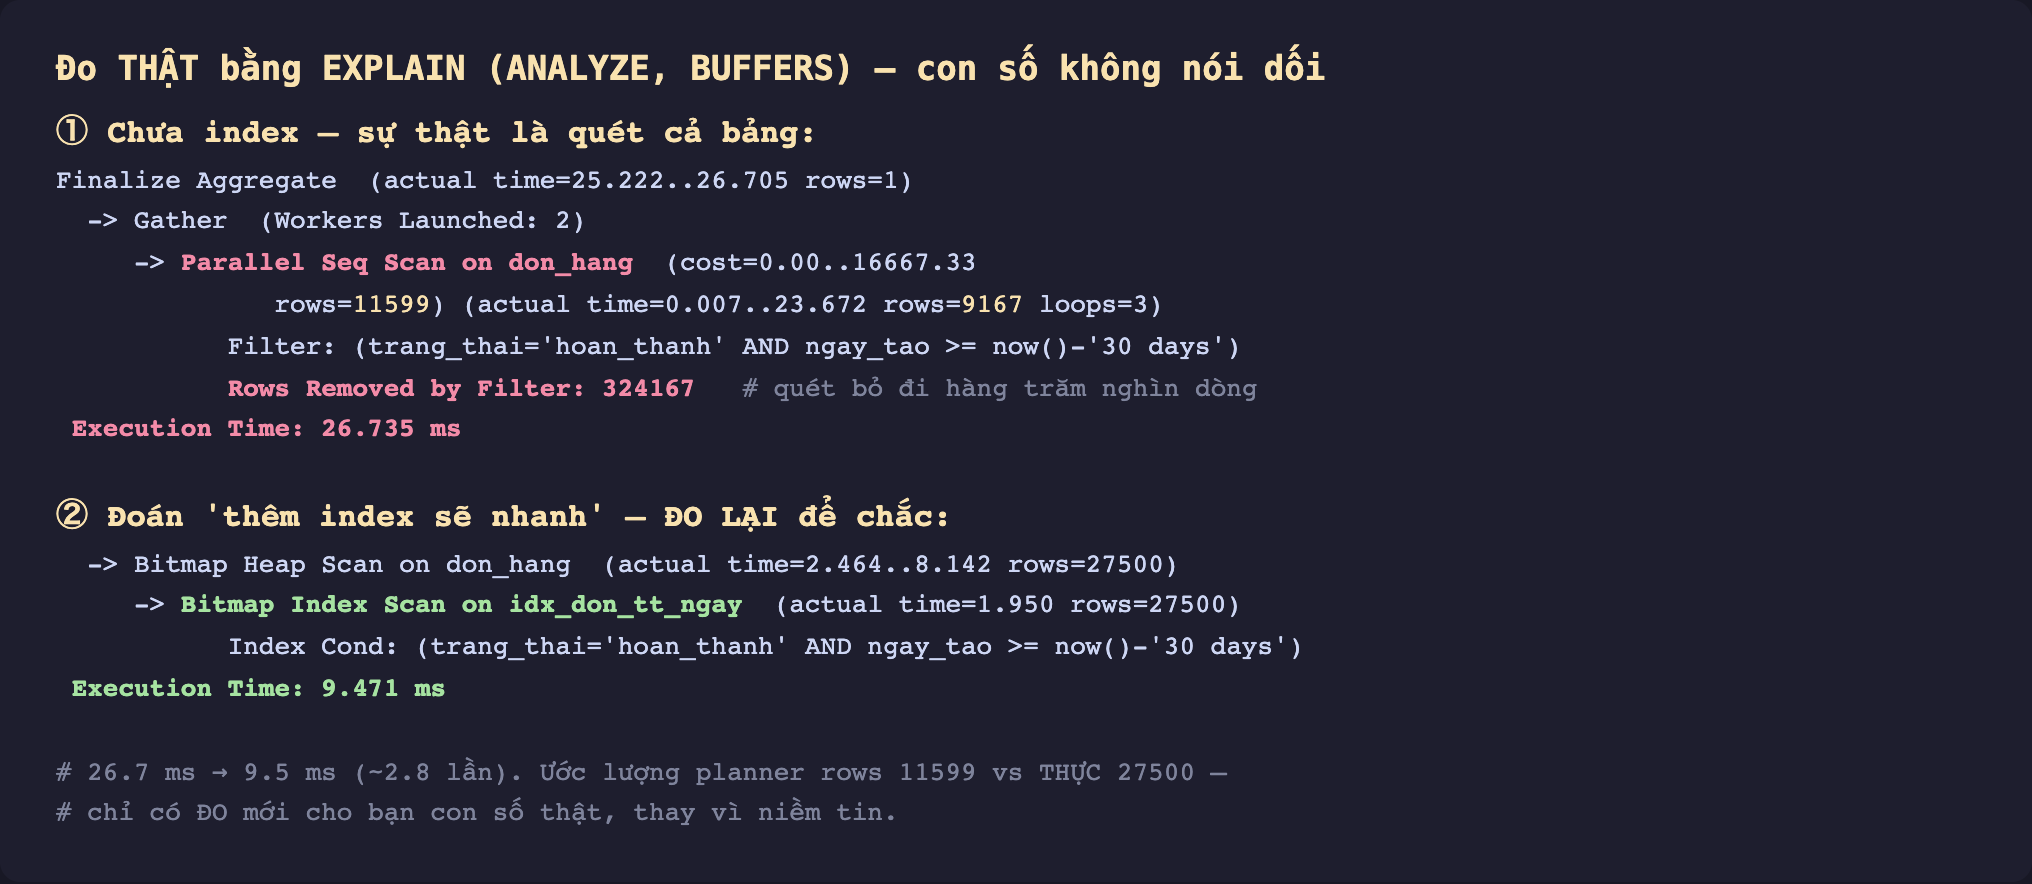
Hình 2: Sự thật hiện ra. Chưa index: Parallel Seq Scan — PostgreSQL huy động 2 worker quét toàn bộ bảng, mỗi worker vứt bỏ 324.167 dòng không khớp, mất 26,7ms. Thêm index rồi đo lại: Bitmap Index Scan → 9,5ms, nhanh ~2,8 lần. Và để ý con số vàng: planner ước lượng 11.599 dòng, thực tế 27.500 — ước lượng lệch hơn 2 lần. Chỉ có đo mới lộ ra điều đó.
Ba điều bức ảnh trên dạy ta
- "Chậm" là một con số, không phải cảm giác. 26,7ms hay 9,5ms — giờ ta có mốc để so, để biết một thay đổi có thực sự giúp không.
- Ước lượng của planner có thể sai (11.599 vs 27.500). Khi ước lượng lệch, planner chọn nhầm kế hoạch — một chủ đề lớn ta sẽ đào ở các bài về thống kê.
- Thay đổi phải được đo lại. Ta đoán index giúp; con số xác nhận (2,8 lần) — và cũng cho biết nó không phải phép màu 100 lần, vì 2,75% số dòng vẫn là hàng chục nghìn dòng phải chạm tới.
Bộ đồ nghề đo lường của sê-ri này
Xuyên suốt 132 bài, ta sẽ đo bằng đúng vài công cụ, giới thiệu dần:
EXPLAIN (ANALYZE, BUFFERS)— soi một truy vấn cụ thể (bài này và xuyên suốt).\timingtrongpsql— thời gian thô tính cả mạng, đơn giản mà hữu ích.pg_stat_statements— xếp hạng mọi truy vấn theo tổng thời gian, để biết nên tối ưu cái nào trước (bài 7).auto_explainvàlog_min_duration_statement— tự bắt truy vấn chậm trên production (bài 8–9).pgbench— tạo tải để đo dưới áp lực thật (bài 2).
Điểm chung: tất cả cho ra số. Sê-ri này không có câu "làm thế này sẽ nhanh hơn" mà không kèm con số trước và sau.
Cạm bẫy "tối ưu theo cảm tính"
Vài lỗi kinh điển khi bỏ qua bước đo:
- Tối ưu nhầm truy vấn. Bạn dành cả ngày tối ưu một truy vấn chạy 200ms/lần nhưng ngày chạy 10 lần, trong khi một truy vấn 5ms chạy 2 triệu lần mới là thủ phạm.
pg_stat_statements(tổng thời gian) chỉ đúng chỗ. - Thêm index bừa. Mỗi index làm chậm ghi và tốn đĩa. Thêm index không ai dùng là lỗ ròng — ta sẽ đo cả chi phí này.
- Chỉnh config theo bài trên mạng.
shared_buffers,work_mem... phụ thuộc RAM, tải, và loại truy vấn của bạn. Con số của người khác không phải của bạn.
Ba ý mang về
- Đo trước, đoán sau. Trực giác hiệu năng thường sai;
EXPLAIN (ANALYZE, BUFFERS)cho bạn kế hoạch thật, thời gian thật, và lượng đọc cache/đĩa thật. - Luôn có mốc trước/sau. Đã thấy 26,7ms → 9,5ms trên bảng 1 triệu dòng — mọi tối ưu trong sê-ri này đều kèm con số so sánh, không nói suông.
- Sửa đúng chỗ. Đo giúp bạn tối ưu truy vấn đáng tối ưu, thêm index đáng thêm, chỉnh config hợp hệ thống của mình — thay vì rải mẹo và hy vọng.
Có nguyên tắc rồi, Phần sau ta dựng một môi trường đo hiệu năng đàng hoàng — pgbench, sinh dữ liệu lớn giống production, và cách tạo tải để con số đo ra đáng tin, không bị nhiễu bởi cache lạnh hay dữ liệu tí hon.
