Nhiều người nhìn output của EXPLAIN rồi bỏ cuộc: một mớ chữ thụt lề với những con số khó hiểu. Nhưng EXPLAIN thực ra rất có cấu trúc — nó in ra một cái cây, mỗi dòng là một node (bước xử lý), và một khi biết đọc cây đó theo đúng thứ tự, bạn thấy chính xác PostgreSQL định làm gì. Bài này dạy đọc kế hoạch, chưa cần chạy truy vấn (ANALYZE để bài sau).
EXPLAIN: kế hoạch ước lượng, chưa chạy
EXPLAIN (không kèm ANALYZE) cho bạn xem kế hoạch planner định dùng, kèm chi phí ước lượng — nó không thực thi truy vấn, nên an toàn và tức thì kể cả với UPDATE/DELETE.
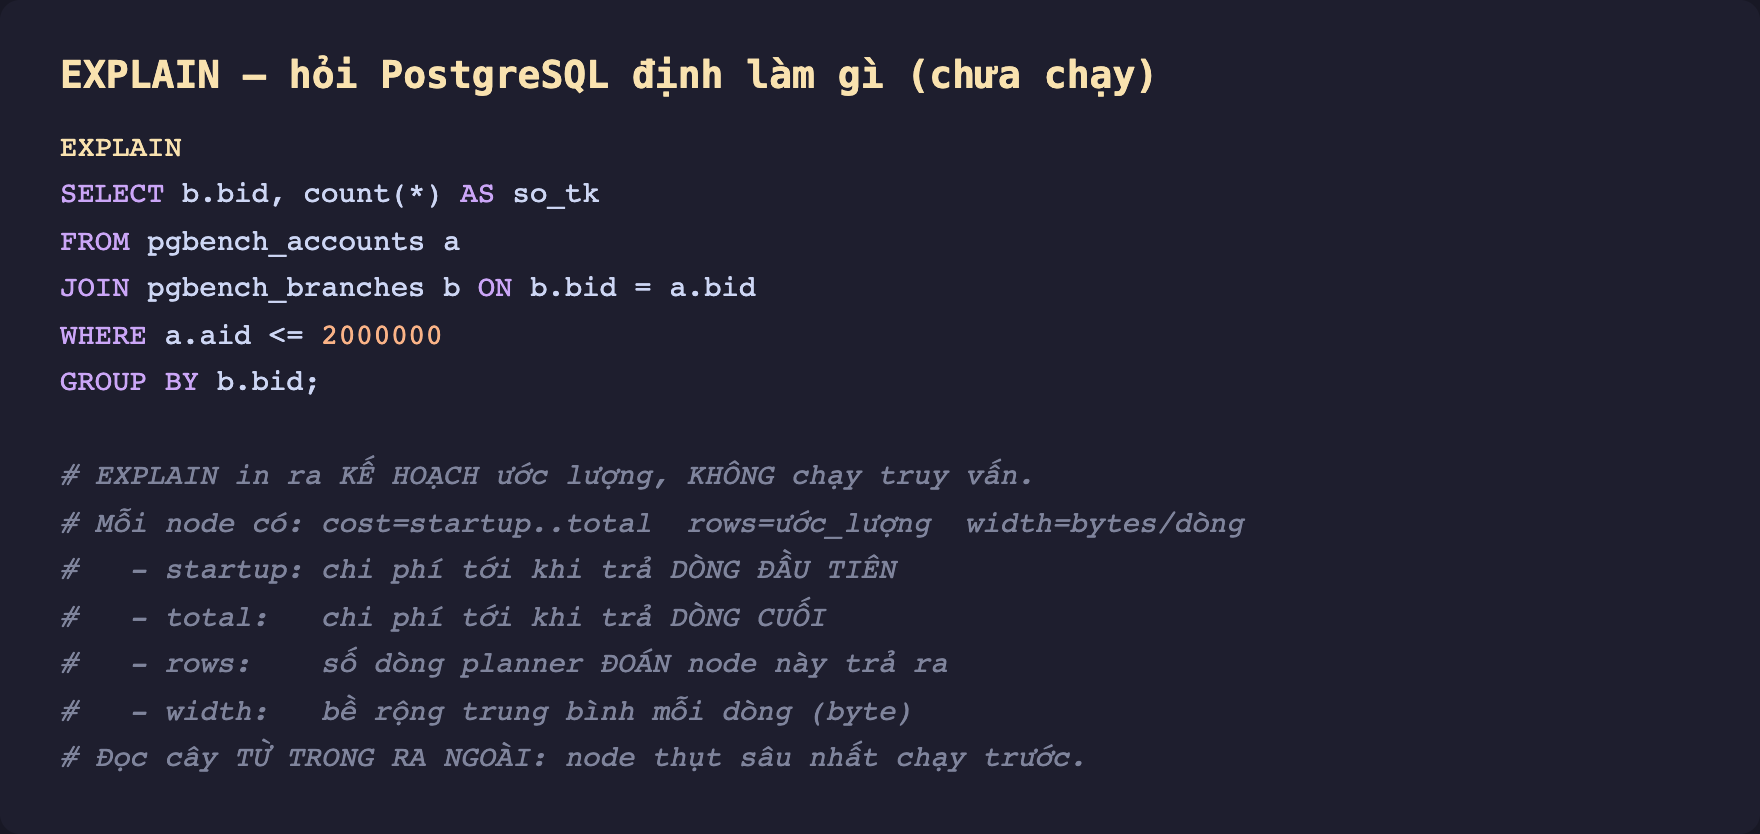
Hình 1: Một truy vấn join + group. Mỗi node trong kế hoạch mang bốn thông tin: cost=startup..total (chi phí ước lượng tới dòng đầu / dòng cuối, đơn vị trừu tượng của planner), rows (số dòng đoán trả ra), width (số byte trung bình mỗi dòng). Điểm mấu chốt: kế hoạch là cây, và ta đọc nó từ trong ra ngoài.
Đọc cây từ trong ra ngoài
Đây là kế hoạch thật của truy vấn trên, và cách lần nó:
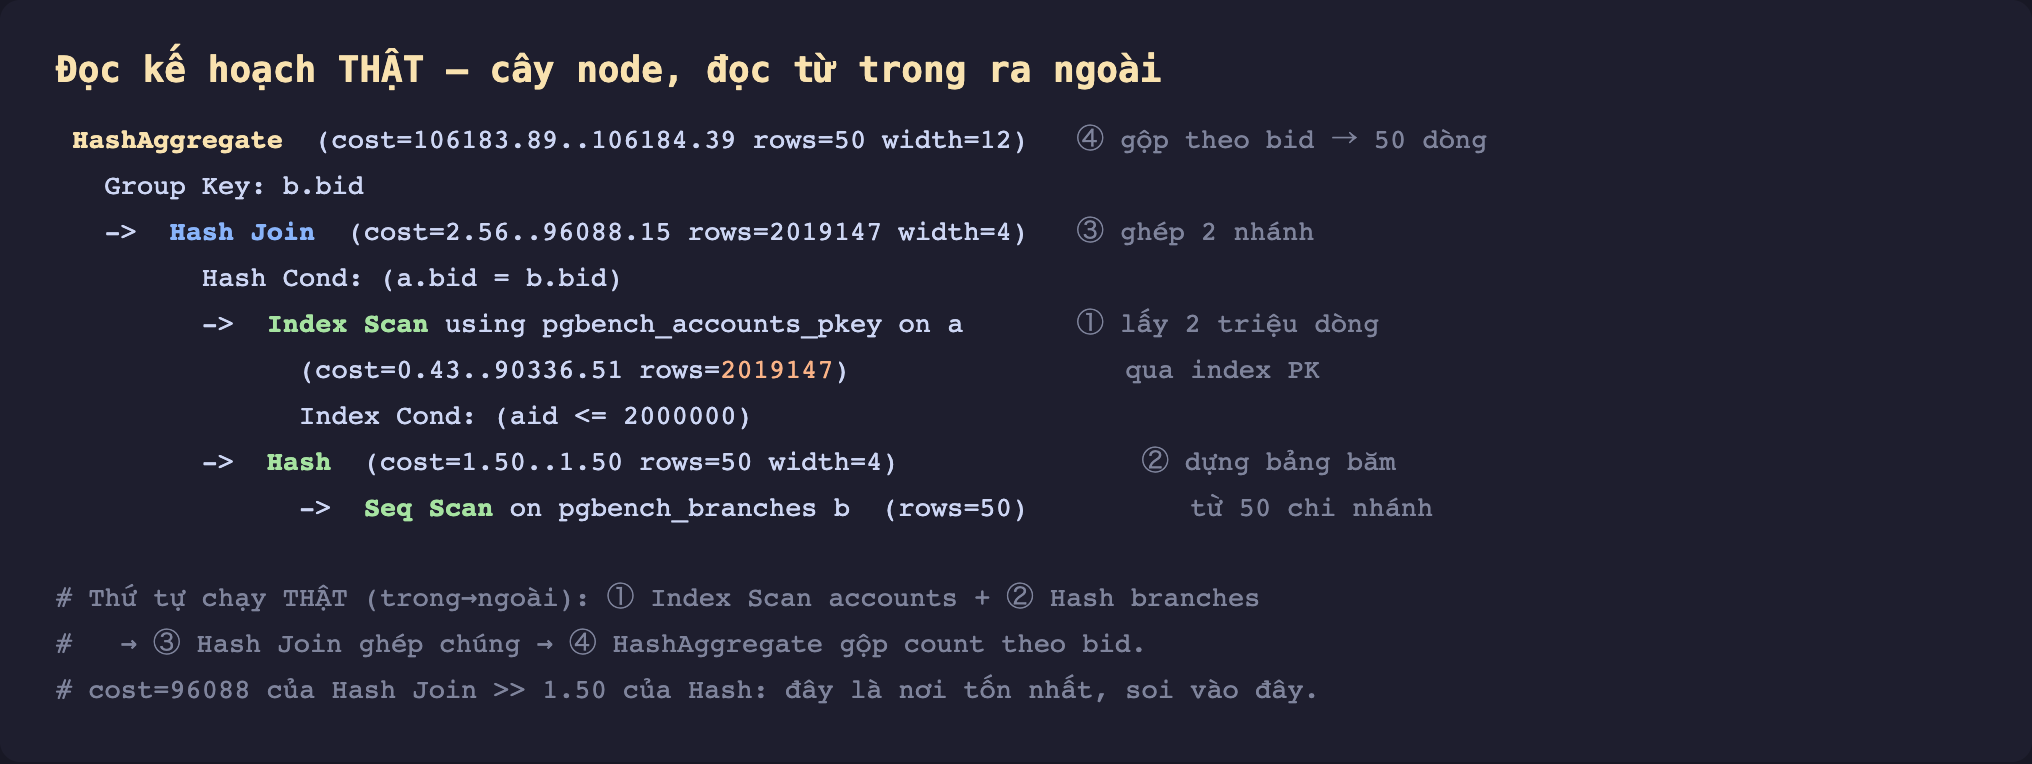
Hình 2: Cùng một kế hoạch, đánh số theo thứ tự chạy thật. Dấu -> và độ thụt lề cho biết quan hệ cha–con. Node thụt sâu nhất chạy trước: ① Index Scan lấy ~2 triệu dòng accounts qua index khóa chính; ② Seq Scan + Hash dựng bảng băm từ 50 chi nhánh; ③ Hash Join ghép hai nhánh; ④ HashAggregate gộp count theo bid, ra 50 dòng. Dù in từ trên xuống, dữ liệu chảy từ dưới lên.
Ba con số, đọc cho đúng
cost=startup..total— không phải mili-giây, mà là đơn vị trừu tượng planner dùng để so sánh các kế hoạch.startuplà chi phí đến dòng đầu tiên (quan trọng vớiLIMIT),totalđến dòng cuối. Socostgiữa các node để biết node nào tốn nhất — ở đâyHash Join(96.088) áp đảoHashcủa branches (1,50), nên muốn tối ưu thì soi vào phần join/scan accounts.rows— số dòng planner đoán. Con số này lái toàn bộ quyết định chọn kế hoạch. Nếu nó sai nhiều, planner chọn nhầm — đó là lý do bài sau ta so nó với số thực tế bằngANALYZE.width— byte trung bình mỗi dòng. Ảnh hưởng chi phí sort, hash, và truyền dữ liệu; đây là một lý doSELECT *đắt hơn cần thiết.
Nhận diện vài node hay gặp
Kế hoạch này đã có bốn loại node phổ biến nhất:
Seq Scan— quét tuần tự cả bảng (branches nhỏ nên rẻ).Index Scan— đi qua index để lấy dòng (accounts qua khóa chính).Hash Join— dựng bảng băm từ bảng nhỏ rồi dò từng dòng bảng lớn.HashAggregate— gộp nhóm bằng bảng băm trong bộ nhớ.
Còn Nested Loop, Merge Join, Bitmap Heap Scan, Sort, Gather (song song)... ta sẽ gặp và mổ ở các bài chuyên về kế hoạch. Mẹo đọc nhanh: tìm node có cost total lớn nhất — đó là nơi thời gian đổ vào, và là chỗ đáng tối ưu trước.
Lưu ý nhỏ nhưng quan trọng
costlà ước lượng, không phải thời gian. Đừng quy đổi ra mili-giây; nó chỉ để planner so sánh. Muốn thời gian thật, cầnANALYZE(bài sau).- Đọc từ trong ra ngoài, dưới lên trên. Node ngoài cùng (trên cùng) là bước cuối.
- Dòng
JIT:ở cuối (nếu có) là biên dịch tức thời cho truy vấn nặng — một chủ đề riêng, cứ bỏ qua khi mới đọc.
Ba ý mang về
- EXPLAIN in ra một cây node, đọc từ trong ra ngoài — node thụt sâu nhất chạy trước, dữ liệu chảy từ dưới lên; node trên cùng là bước cuối.
- Mỗi node có
cost=startup..total,rows,width—costlà đơn vị so sánh (không phải ms),rowslà ước lượng lái mọi quyết định,widthlà byte/dòng. Tìm nodecostlớn nhất để biết soi vào đâu. - EXPLAIN không chạy truy vấn — an toàn, tức thì, cho bạn ý định của planner. Để biết ý định đó có khớp thực tế không, cần bước tiếp theo.
Kế hoạch mới chỉ là dự định của planner. Phần sau ta thêm ANALYZE để chạy thật và so ước lượng với thực tế — nơi lộ ra những chỗ planner đoán sai, thủ phạm số một của các truy vấn chậm khó hiểu.
