Bài trước ta chốt nguyên tắc "đo trước, đoán sau". Nhưng đo sai cách còn tệ hơn không đo: chạy một truy vấn trên bảng 10 dòng rồi kết luận "nhanh lắm", lên production 10 triệu dòng thì sập. Bài này dựng một môi trường đo đàng hoàng bằng pgbench — công cụ benchmark đi kèm sẵn PostgreSQL — để mọi con số về sau đều có mốc tin cậy.
pgbench: tạo dữ liệu và tải chỉ bằng vài lệnh
pgbench làm hai việc: (1) khởi tạo một bộ dữ liệu chuẩn theo mô hình ngân hàng (TPC-B), và (2) bắn nhiều client song song vào để đo. Kích thước dữ liệu điều khiển bằng scale factor — mỗi đơn vị scale ≈ 100.000 dòng trong bảng pgbench_accounts.
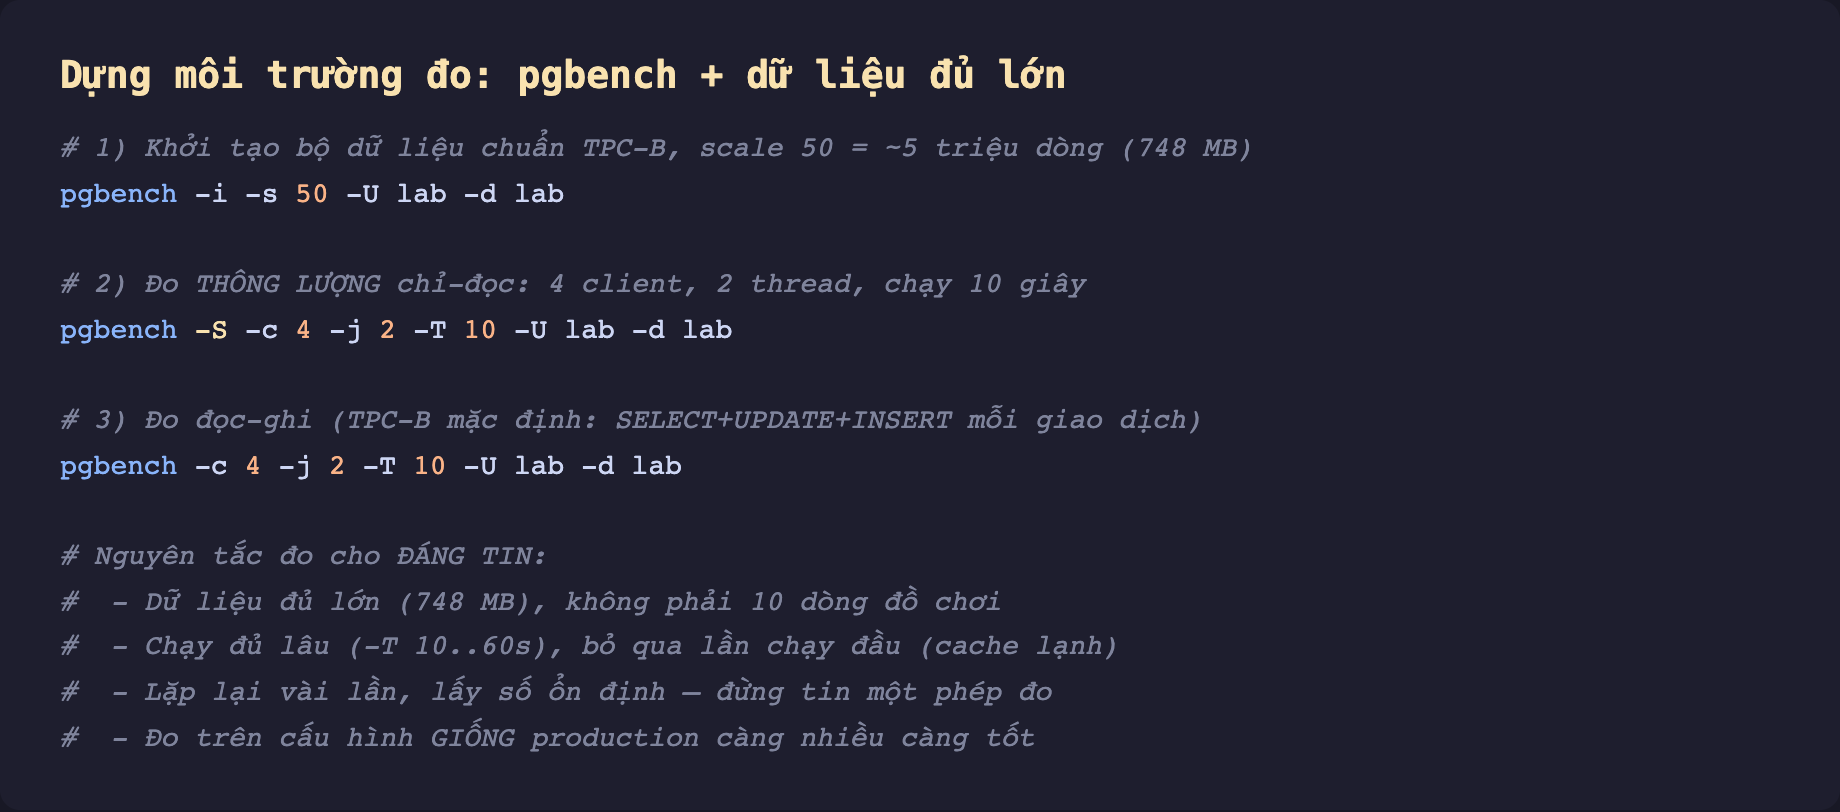
Hình 1: Ba lệnh dựng môi trường đo. -i -s 50 tạo ~5 triệu dòng (748 MB). -S đo tải chỉ đọc; bỏ -S là tải đọc-ghi TPC-B. -c số client đồng thời, -j số thread của pgbench, -T số giây chạy. Bốn nguyên tắc bên dưới là thứ tách một phép đo tin được khỏi một con số vô nghĩa.
Con số thật: đọc nhanh gấp 10 lần ghi
Chạy cả hai loại tải trên cùng một máy, cùng bộ dữ liệu 748 MB:
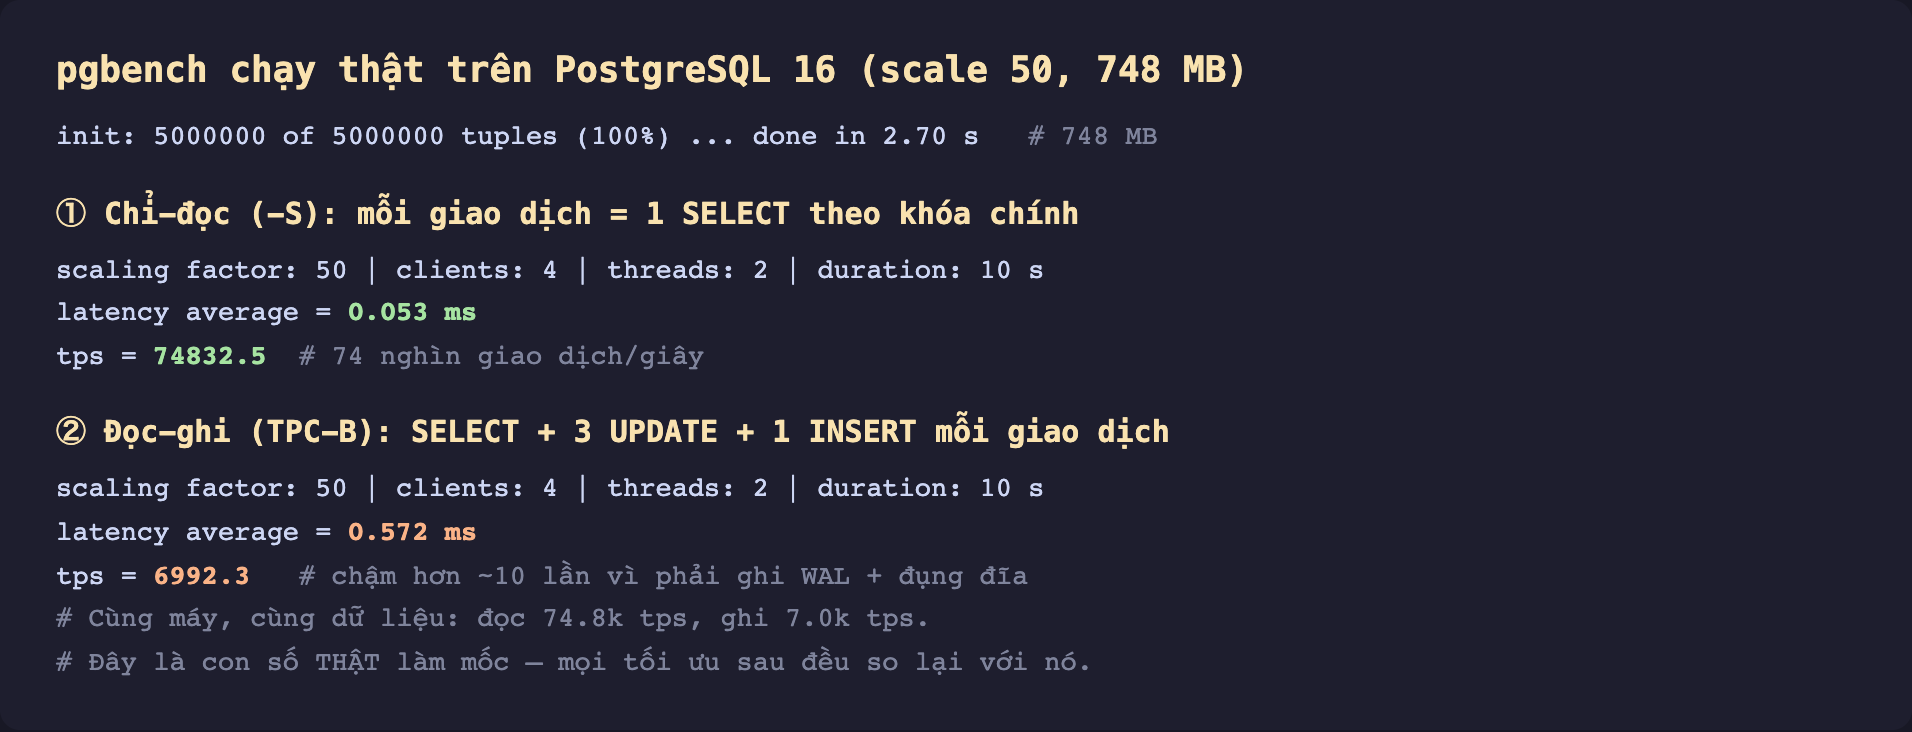
Hình 2: Thật. Tải chỉ đọc đạt 74.832 TPS, độ trễ trung bình 0,053 ms. Cùng máy đó, tải đọc-ghi chỉ 6.992 TPS, độ trễ 0,572 ms — chậm hơn ~10 lần. Lý do: mỗi giao dịch ghi phải ghi WAL, cập nhật nhiều dòng và cuối cùng chạm đĩa, trong khi đọc phần lớn phục vụ từ bộ nhớ. Đây là bài học đầu tiên về đánh đổi: đọc và ghi là hai thế giới hiệu năng khác hẳn nhau — đừng gộp chung khi đánh giá.
Bốn nguyên tắc để con số đáng tin
- Dữ liệu phải đủ lớn. Trên bảng nhỏ, mọi thứ vừa trong cache và mọi kế hoạch đều nhanh — bạn không thấy được index hay bloat có tác dụng gì. 748 MB (lớn hơn
shared_buffersmặc định 128 MB) mới lộ ra hành vi thật. - Chạy đủ lâu, bỏ lần đầu. Lần chạy đầu tiên đọc dữ liệu từ đĩa vào cache (cache lạnh) nên chậm bất thường. Đo
-Tvài chục giây và lặp lại vài lần, lấy số đã ổn định. - Đừng tin một phép đo. TPS dao động theo tải nền của máy. Chạy 3–5 lần, nhìn khoảng dao động, không chỉ một con số.
- Càng giống production càng tốt. Cùng phiên bản PostgreSQL, cùng cấu hình bộ nhớ, tỉ lệ đọc/ghi giống thật. Đo trên laptop rồi suy ra server là nguồn sai lầm kinh điển.
Khi nào dùng pgbench, khi nào dùng EXPLAIN
Hai công cụ trả lời hai câu hỏi khác nhau, dùng đúng chỗ:
pgbenchđo thông lượng toàn hệ thống dưới tải đồng thời — "hệ thống chịu được bao nhiêu giao dịch/giây?". Hợp để đánh giá cấu hình, phần cứng, hay so trước/sau một thay đổi lớn.EXPLAIN (ANALYZE)(bài 1) soi một truy vấn cụ thể — "vì sao câu này chậm và sửa ra sao?". Hợp để gỡ một truy vấn cá biệt.
Quy trình thực chiến: pg_stat_statements (bài 7) chỉ ra truy vấn tốn nhất → EXPLAIN ANALYZE mổ từng câu → pgbench (hoặc tải thật) xác nhận cải thiện ở mức hệ thống.
Ba ý mang về
- Đo trên dữ liệu tí hon là tự lừa mình. Dùng
pgbench -i -s <scale>tạo bộ dữ liệu đủ lớn (ở đây 748 MB) để hành vi thật lộ ra. - Đọc và ghi khác nhau ~10 lần trên cùng máy (74.832 vs 6.992 TPS) — vì ghi phải qua WAL và đĩa. Luôn tách hai loại tải khi đánh giá.
- Con số chỉ đáng tin khi đúng cách: dữ liệu đủ lớn, chạy đủ lâu, bỏ lần cache lạnh, lặp lại, và đo trên cấu hình giống production.
Có mốc đo rồi, giờ tới lúc học đọc thứ mà PostgreSQL nói với ta. Phần sau mổ xẻ cách đọc kế hoạch truy vấn EXPLAIN cho kỹ — cây node, chi phí, và cách lần theo nó từ trong ra ngoài để biết PostgreSQL thực sự định làm gì với câu lệnh của bạn.
