Phần trước ta gộp query ở tầng code. Nhưng ngay cả một câu SQL duy nhất cũng có thể chậm — nếu PostgreSQL phải quét cả bảng để tìm dòng bạn cần. Giải pháp là index: một cấu trúc B-tree cho phép nhảy thẳng tới dòng thay vì đọc từng dòng một. Bài này chỉ Odoo tự tạo index gì, khi nào bạn phải thêm index=True, và — quan trọng — đo bằng EXPLAIN ANALYZE thật để thấy khác biệt.
Odoo tự tạo index gì
Không phải field nào cũng có index. Nhìn thẳng vào PostgreSQL cho biết sự thật:
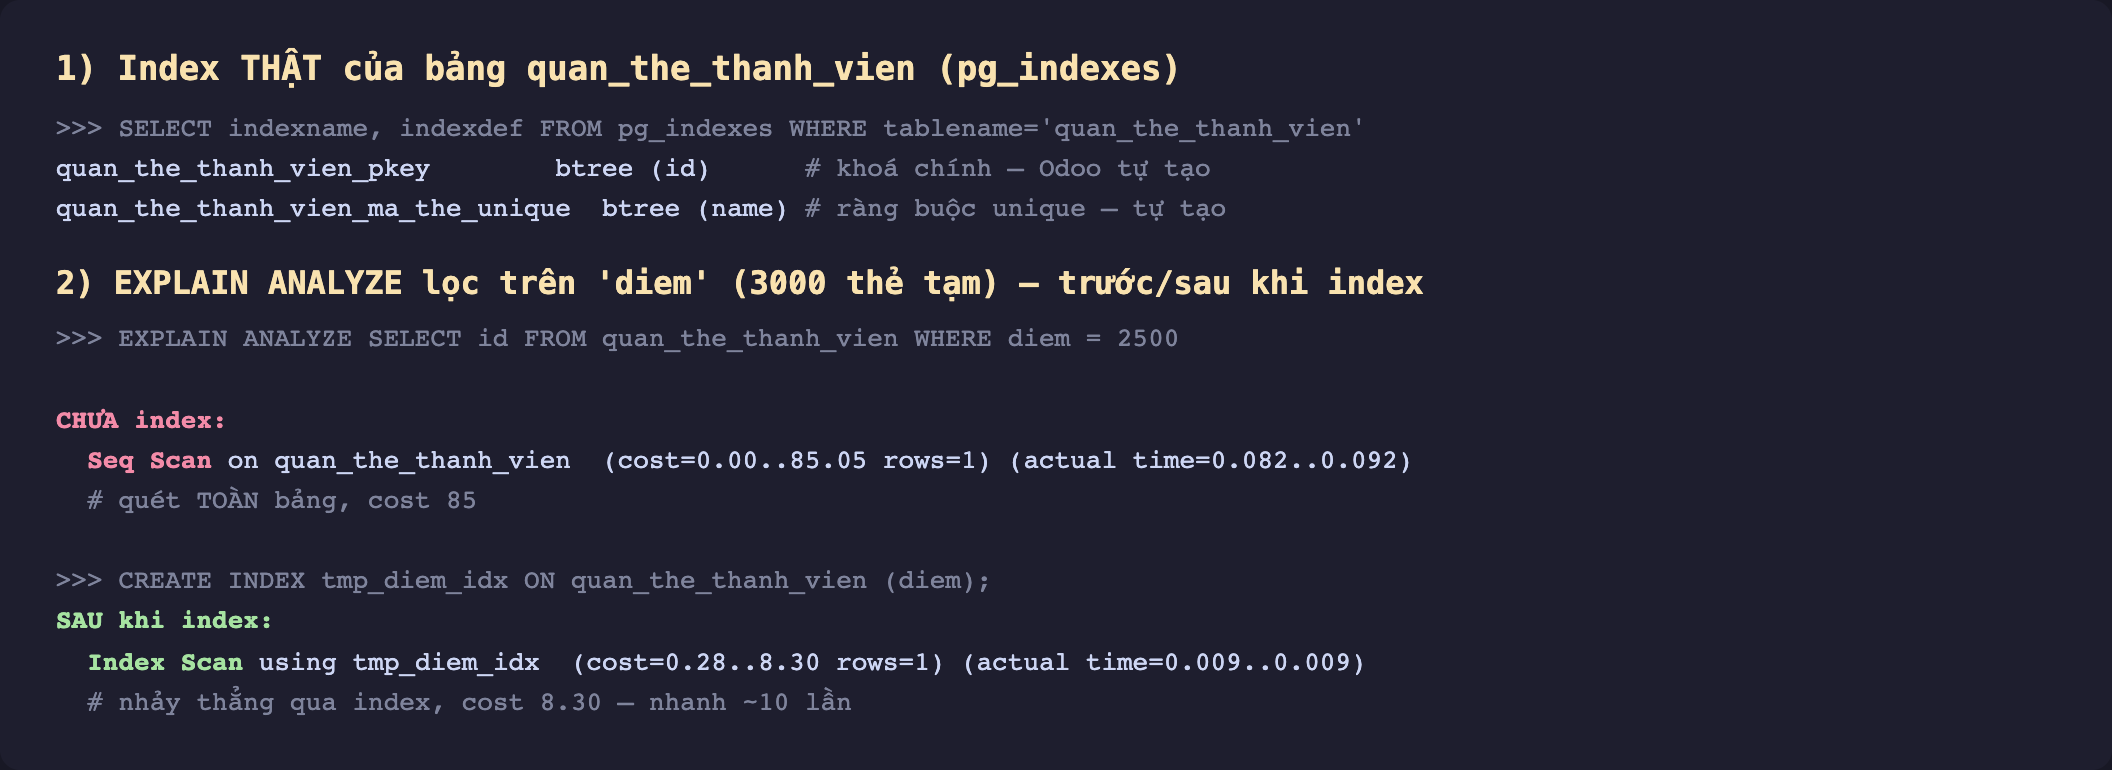
Hình 1: Thật, đọc trực tiếp từ PostgreSQL. Bảng quan_the_thanh_vien chỉ có hai index tự động: pkey trên id (khoá chính) và ma_the_unique trên name (do ràng buộc unique). Field diem không có index. Phần dưới: EXPLAIN ANALYZE cùng một câu WHERE diem = 2500 trên 3000 bản ghi — Seq Scan (quét cả bảng, cost 85) khi chưa index, đổi thành Index Scan (cost 8.30, nhanh ~10 lần) sau khi tạo index. Sau đó mình đã xoá index và 3000 thẻ tạm.
Điểm bất ngờ với nhiều người: Many2one trong Odoo 19 không còn tự động được index. Nếu bạn hay lọc/sắp theo một field — kể cả Many2one — phải tự thêm index=True.
Thêm index bằng index=True
Trong định nghĩa field, thêm tham số index:
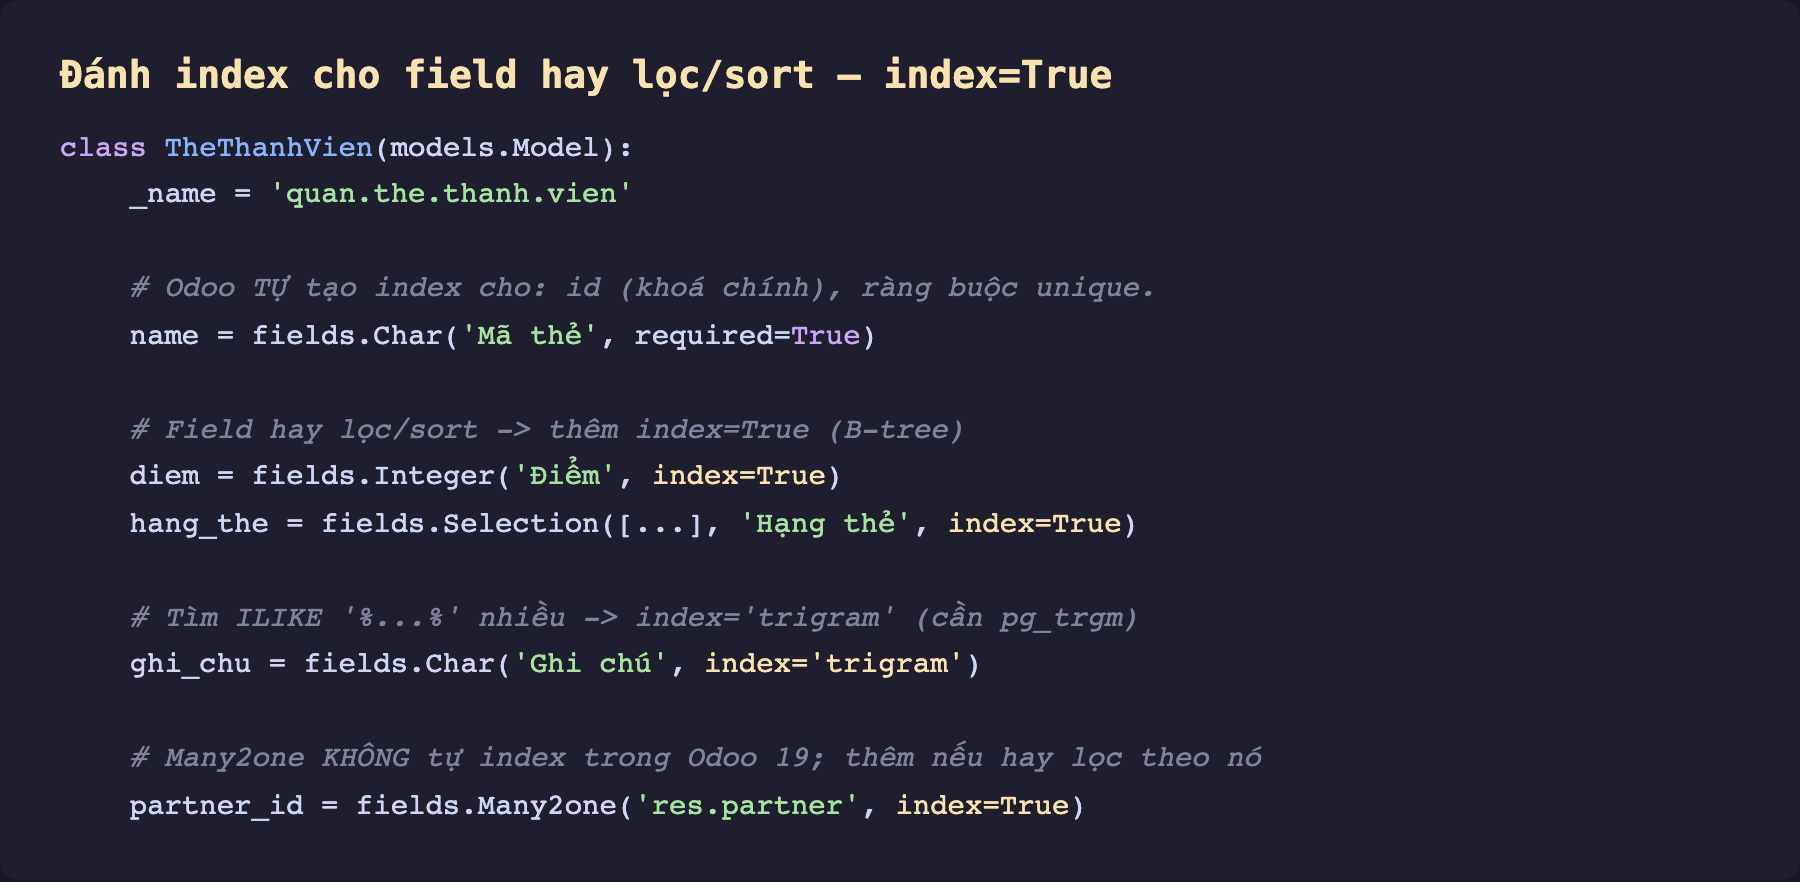
Hình 2: Cú pháp index. index=True tạo B-tree index — hợp cho so bằng, so sánh, và sắp xếp. index='trigram' tạo index dạng trigram (cần extension pg_trgm) — hợp cho tìm ILIKE '%...%' (tìm gần đúng trong chuỗi). Sau khi thêm và nâng cấp module (-u), Odoo tự chạy CREATE INDEX cho cột đó.
Đọc EXPLAIN ANALYZE
Công cụ để biết truy vấn có dùng index không là EXPLAIN ANALYZE. Hai dòng đầu tiên cho biết tất cả:
Seq Scan(Sequential Scan): PostgreSQL đọc từng dòng của bảng để lọc. Với bảng nhỏ thì nhanh, nhưng chi phí tăng tuyến tính theo số dòng — bảng càng lớn càng chậm.Index Scan: PostgreSQL dùng index để nhảy thẳng tới dòng khớp. Chi phí gần như không đổi dù bảng to lên.
Con số cost= là ước lượng của bộ tối ưu; actual time= là thời gian thật. Trong đo của mình, cost sụt từ 85 xuống 8.30 — và quan trọng hơn con số cụ thể là hình dạng: Seq Scan sẽ tệ dần khi bảng lớn, Index Scan thì không.
Index không miễn phí
Đừng index mọi thứ. Index có cái giá:
- Chậm GHI. Mỗi
INSERT/UPDATE/DELETEphải cập nhật cả index. Bảng nhiều index thì ghi chậm hơn. - Tốn dung lượng. Index là cấu trúc lưu riêng trên đĩa.
- Vô ích nếu không dùng. Index trên field chẳng ai lọc/sort chỉ tổ tốn chỗ và làm chậm ghi.
Quy tắc: chỉ index field bạn thật sự hay lọc (search domain), sắp xếp (_order), hoặc dùng trong name_search. Field chỉ để hiển thị thì không cần.
# field xuất hiện trong _order hay domain search thường xuyên -> nên index
_order = 'diem desc'          # sort theo diem -> diem nên index=True
# search([('hang_the','=','vang')]) chạy nhiều -> hang_the nên index=True
Vài lưu ý thực tế
- Với bảng nhỏ, index có thể bị bỏ qua. Bộ tối ưu của PostgreSQL đủ khôn để chọn Seq Scan khi bảng chỉ vài dòng (quét còn nhanh hơn đọc index). Đừng ngạc nhiên nếu index "không có tác dụng" trên 4 bản ghi — nó chỉ tỏa sáng khi dữ liệu lớn.
index='trigram'cho tìm gần đúng. TìmILIKE '%abc%'(có%ở đầu) không dùng được B-tree thường; cần trigram index.- Chạy
ANALYZEsau khi nạp nhiều dữ liệu để PostgreSQL cập nhật thống kê, chọn plan đúng. - Đo trước khi thêm. Dùng
EXPLAIN ANALYZEđể xác nhận truy vấn thật sự chậm vì Seq Scan, đừng đoán.
Ba ý mang về
- Odoo tự tạo index cho
id(khoá chính) và ràng buộc unique — đã xác nhận bằngpg_indexesthật. Many2one trong Odoo 19 không tự index; field hay lọc/sort thì tự thêmindex=True(hoặcindex='trigram'cho tìmILIKE). EXPLAIN ANALYZEcho thấy sự thật: cùng câuWHERE diem=2500trên 3000 dòng, chưa index làSeq Scan(cost 85), có index làIndex Scan(cost 8.30) — và Seq Scan tệ dần khi bảng lớn, Index Scan thì không.- Index có giá: chậm ghi, tốn dung lượng. Chỉ index field thật sự dùng để lọc/sort/tìm; đo bằng
EXPLAIN ANALYZEtrước khi thêm.
Code nhanh, truy vấn nhanh rồi — mảnh ghép cuối là chạy nhiều tiến trình để phục vụ nhiều người cùng lúc. Phần sau bước vào triển khai với nhiều worker — cách Odoo dùng đa tiến trình để không nghẽn ở một luồng, và cấu hình số worker theo CPU.
