Code đã tối ưu, index đã đủ. Nhưng nếu Odoo chỉ chạy một tiến trình, thì dù máy có 10 CPU, hai người dùng gửi request nặng cùng lúc vẫn phải xếp hàng. Lý do nằm ở Python: GIL (Global Interpreter Lock) cho phép chỉ một luồng chạy bytecode Python tại một thời điểm. Muốn dùng nhiều CPU thật, Odoo phải chạy nhiều tiến trình — đây là ranh giới giữa cấu hình dev và cấu hình production.
Hai chế độ: threaded và multi-process
- Threaded (
workers = 0): một tiến trình, nhiều luồng. Đây là mặc định khi phát triển. Vì GIL, các luồng không chạy Python song song thật — chỉ hợp dev hoặc site rất nhỏ. Container demo của mình đang chạy đúng chế độ này:workers = 0, chỉ một tiến trình odoo. - Multi-process (
workers = N > 0): kiểu prefork — một tiến trình master sinh ra N tiến trình worker con. Mỗi worker là một tiến trình HĐH độc lập, có GIL riêng, nên chạy trên CPU riêng. Đây là chế độ bắt buộc cho production.
Đừng nói suông — mình khởi động tạm một Odoo với --workers=2 rồi ps để nhìn tận mắt:
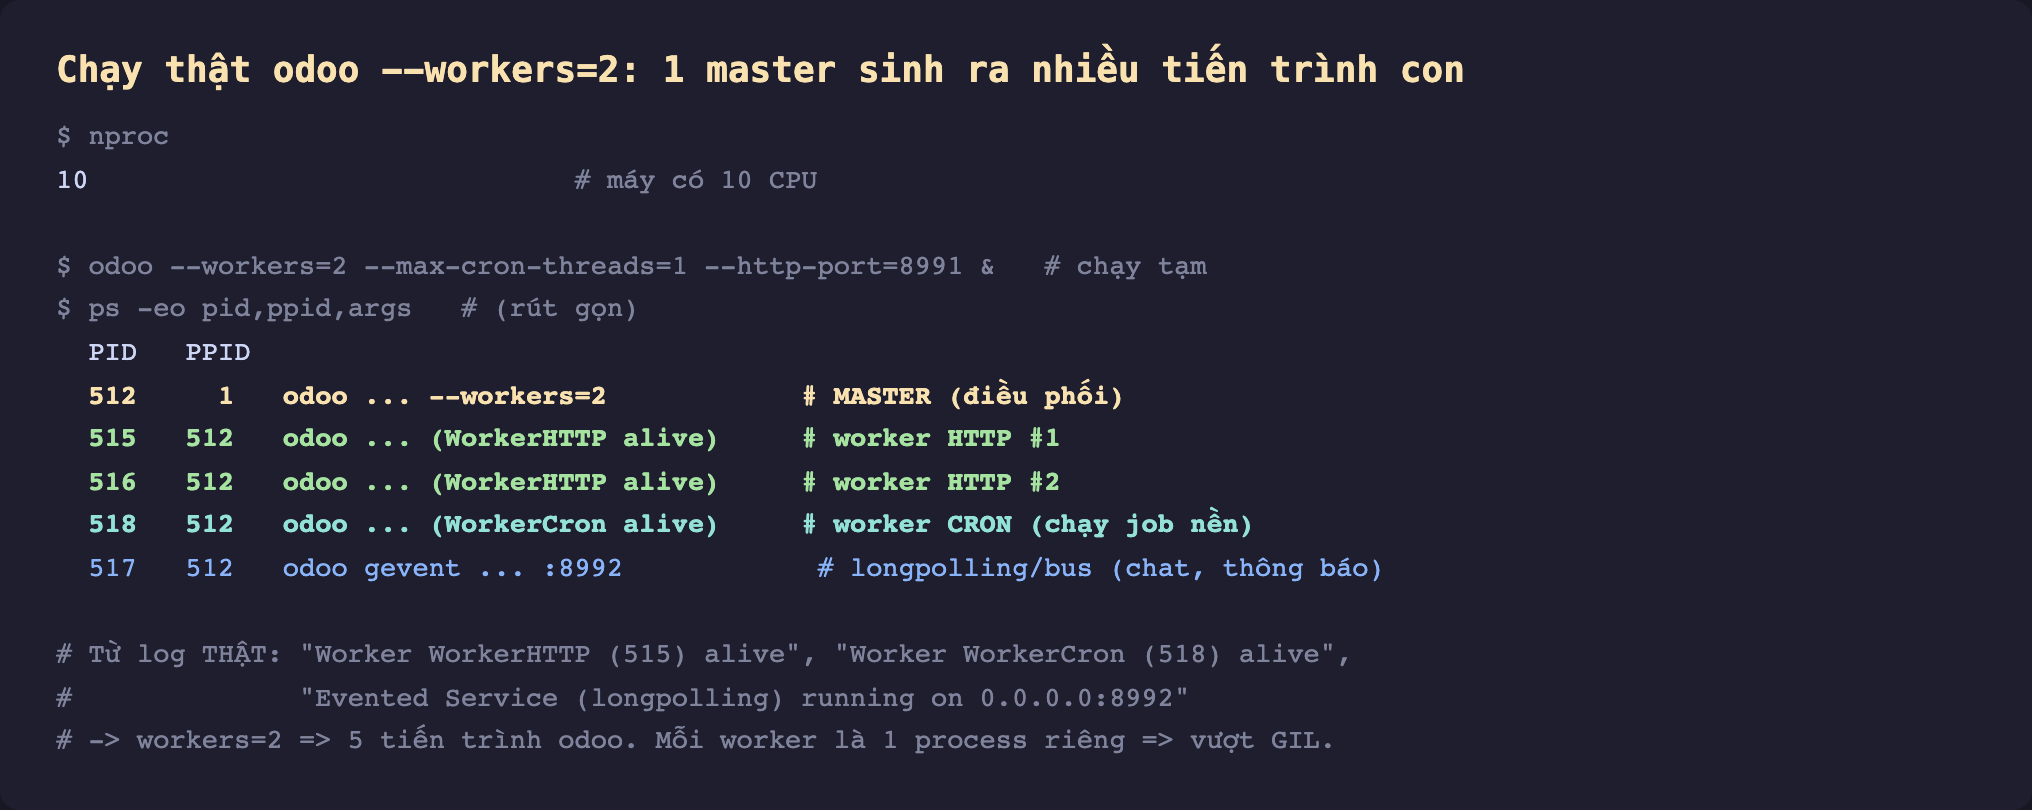
Hình 1: Thật, đọc từ ps và log. --workers=2 tạo ra: 1 master (PID 512, điều phối và giám sát), 2 worker HTTP (515, 516 — mỗi cái phục vụ request độc lập), 1 worker cron (518 — chạy job nền, riêng khỏi HTTP), và 1 tiến trình gevent (517 — longpolling/bus cho chat và thông báo real-time trên cổng riêng 8992). Máy có nproc = 10 CPU. Mỗi worker là một tiến trình riêng nên vượt được giới hạn GIL — hai request nặng chạy trên hai CPU thật.
Cấu hình production: workers và các limit
Số worker không phải càng nhiều càng tốt — mỗi worker tốn RAM. Công thức phổ biến: workers ≈ (2 × số CPU) + 1 cho worker HTTP, cộng thêm cron. Nhưng cái quan trọng ngang với số worker là các limit để một request lỗi không kéo sập cả server:
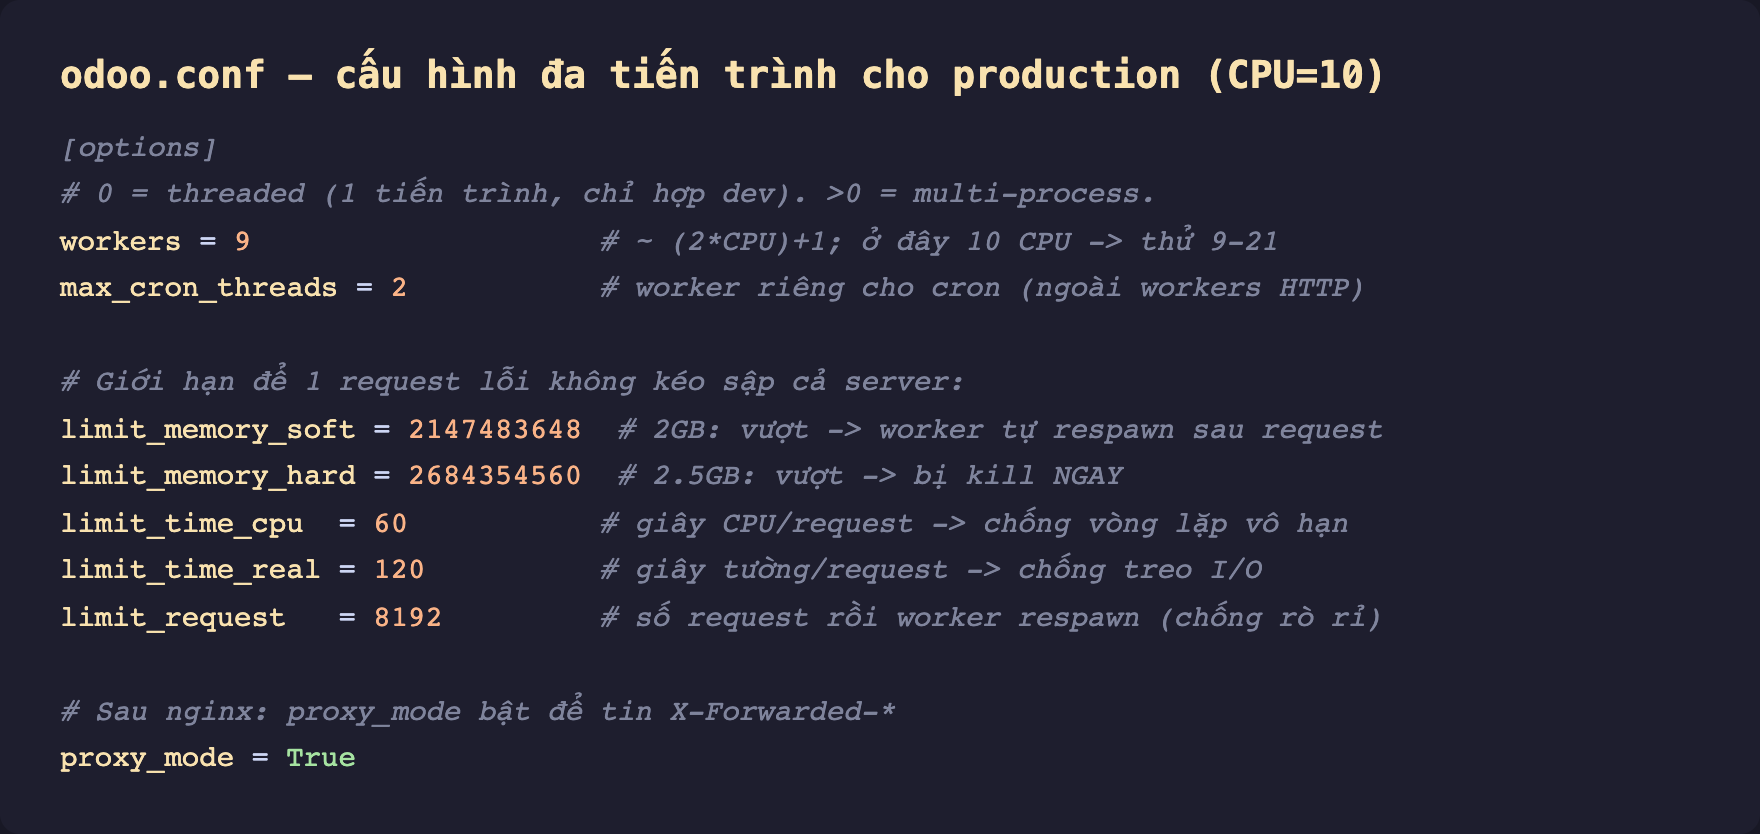
Hình 2: odoo.conf production. workers là số worker HTTP. max_cron_threads tách riêng cho cron. Bộ limit_* là lưới an toàn: limit_memory_soft/hard — worker vượt RAM mềm thì respawn sau khi xong request, vượt cứng thì bị kill ngay (chống rò rỉ bộ nhớ); limit_time_cpu/real — request quá lâu bị cắt (chống vòng lặp vô hạn và treo I/O); limit_request — sau N request thì worker tự respawn. Các giá trị này là cấu hình mặc định thật đọc từ container.
Vì sao cron và longpolling tách riêng
Nhìn lại Hình 1: ngoài worker HTTP còn có worker cron và tiến trình gevent. Đây là thiết kế có chủ đích:
- Cron riêng để job nền (gửi email, tính toán định kỳ) không chiếm worker HTTP đang phục vụ người dùng.
max_cron_threadsđiều khiển số này. - Longpolling/bus (gevent) riêng vì chat và thông báo real-time cần giữ kết nối lâu (long-lived); để chung worker HTTP thường sẽ chiếm chỗ. Nó chạy trên cổng riêng (
gevent_port), và nginx phía trước định tuyến/longpollingsang đó.
Vài lưu ý khi lên production
workers = 0là bẫy production phổ biến. Quên đổi thì dù máy mạnh, Odoo vẫn nghẽn ở một tiến trình. Luôn đặtworkers > 0khi lên thật.- Tính RAM theo worker. Mỗi worker HTTP ăn vài trăm MB tới hơn 1GB.
workers × limit_memory_softkhông được vượt RAM máy, chừa chỗ cho PostgreSQL và hệ điều hành. proxy_mode = Truekhi sau nginx, để Odoo tin các headerX-Forwarded-*(địa chỉ IP thật của khách, giao thức https).limit_time_realphải đủ cho tác vụ nặng nhất (xuất báo cáo lớn), nếu không request đó bị cắt giữa chừng.
Ba ý mang về
- Threaded (
workers=0) chỉ hợp dev — một tiến trình, và GIL của Python khiến nó không dùng nổi nhiều CPU. Production phảiworkers > 0(prefork), để mỗi worker là một tiến trình riêng, vượt GIL. - Đã thấy thật:
--workers=2sinh ra 1 master + 2 worker HTTP + 1 worker cron + 1 gevent longpolling — năm tiến trình, mỗi cái một PID. Cron và longpolling tách riêng để không chiếm worker HTTP. - Số worker ~
(2×CPU)+1, kèm cáclimit_*(memory soft/hard, time cpu/real, request) làm lưới an toàn để một request lỗi không kéo sập server; vàproxy_mode=Truekhi chạy sau nginx.
Odoo đã sẵn sàng phục vụ nhiều người, nhưng nó vẫn đang nghe trên cổng nội bộ. Mảnh ghép cuối cùng đưa nó ra Internet an toàn. Phần sau dựng nginx làm reverse proxy — TLS, nén, định tuyến /longpolling, và các header bắt buộc để Odoo nhìn đúng khách đằng sau proxy.
