Code chạy ngon trên máy dev với 10 bản ghi, lên production 10.000 bản ghi thì đơ. Thủ phạm số một là bẫy N+1: một vòng lặp trông vô hại nhưng mỗi lần lặp lại bắn thêm một câu SQL. Với 10 bản ghi bạn không thấy gì; với 10.000 bản ghi là 10.000 câu SQL, và trang treo. Bài này đo số query thật để phơi bày bẫy đó, rồi chỉ cách né bằng read_group và mapped.
N+1 là gì
Tên "N+1" nghĩa là: 1 câu để lấy N bản ghi, rồi N câu nữa — mỗi bản ghi một câu — để lấy dữ liệu liên quan. Tổng N+1 câu SQL cho một việc lẽ ra chỉ cần 1-2 câu.
Odoo có cơ chế prefetch tự động — khi bạn duyệt một recordset và đọc một field, Odoo đọc field đó cho cả recordset trong một câu. Nhờ vậy nhiều vòng lặp không dính N+1. Nhưng prefetch không cứu được khi bạn gọi search() bên trong vòng lặp — mỗi search là một truy vấn mới, độc lập.
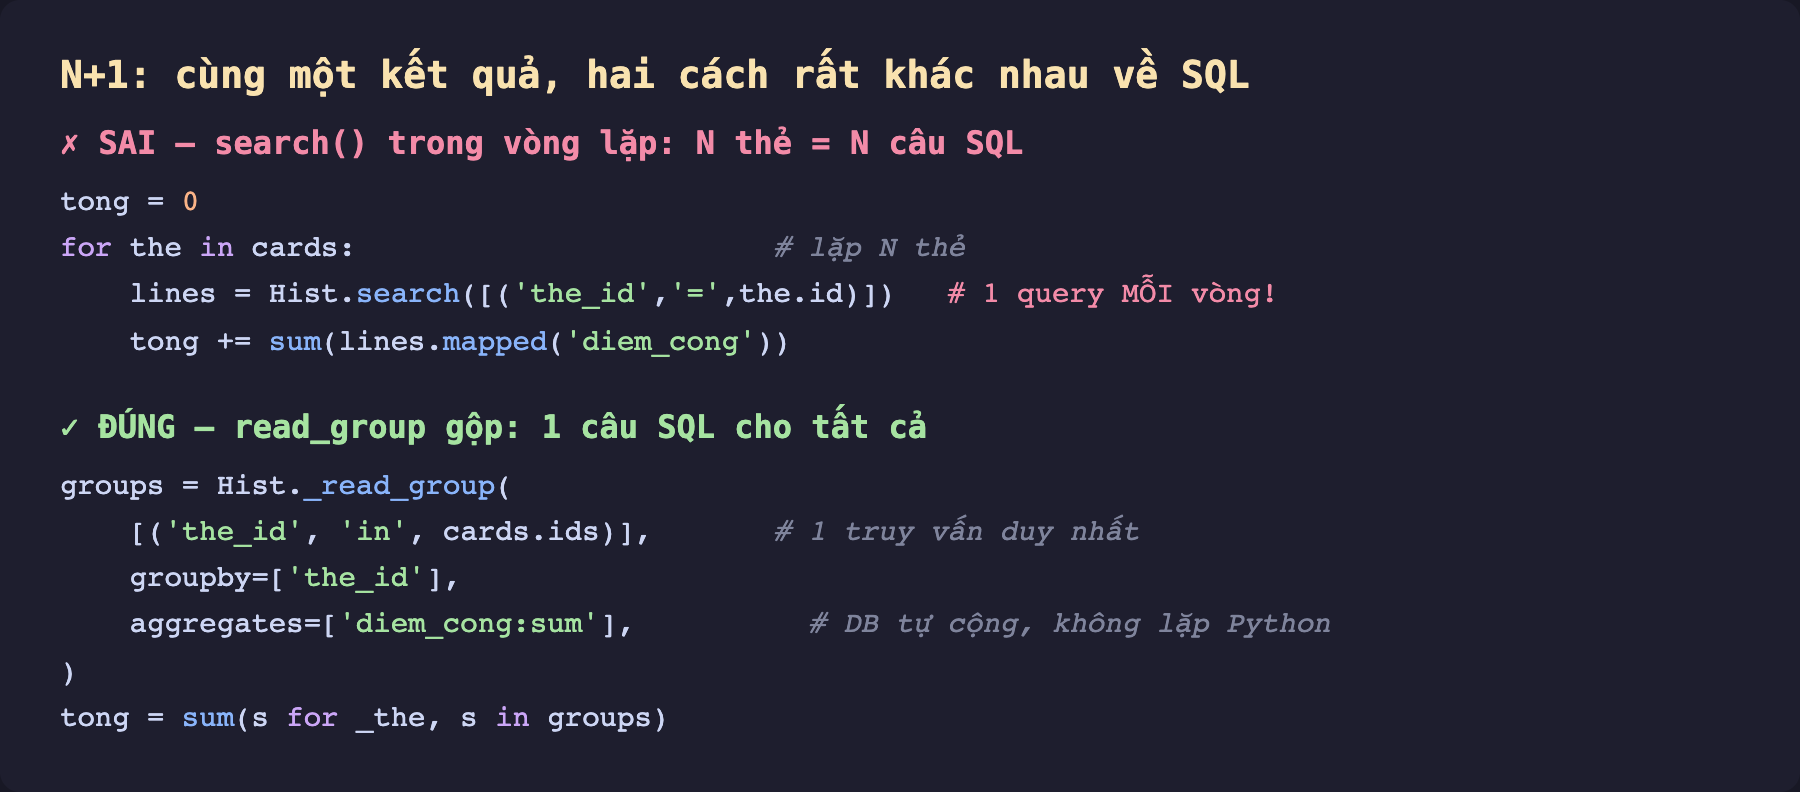
Hình 1: Hai cách tính cùng một tổng. Cách sai: lặp qua từng thẻ, mỗi vòng gọi search() để lấy lịch sử của riêng thẻ đó — mỗi vòng một câu SQL. Cách đúng: một _read_group gộp tất cả, để PostgreSQL tự cộng (diem_cong:sum) thay vì kéo hết về Python rồi cộng bằng vòng lặp.
Đo thật: 50 câu SQL sụt còn 1
Không nói lý thuyết. Mình tạo 50 thẻ tạm (mỗi thẻ 3 dòng lịch sử điểm) trên blog19, bọc cr.execute để đếm số câu SQL thật, rồi chạy cả hai cách:
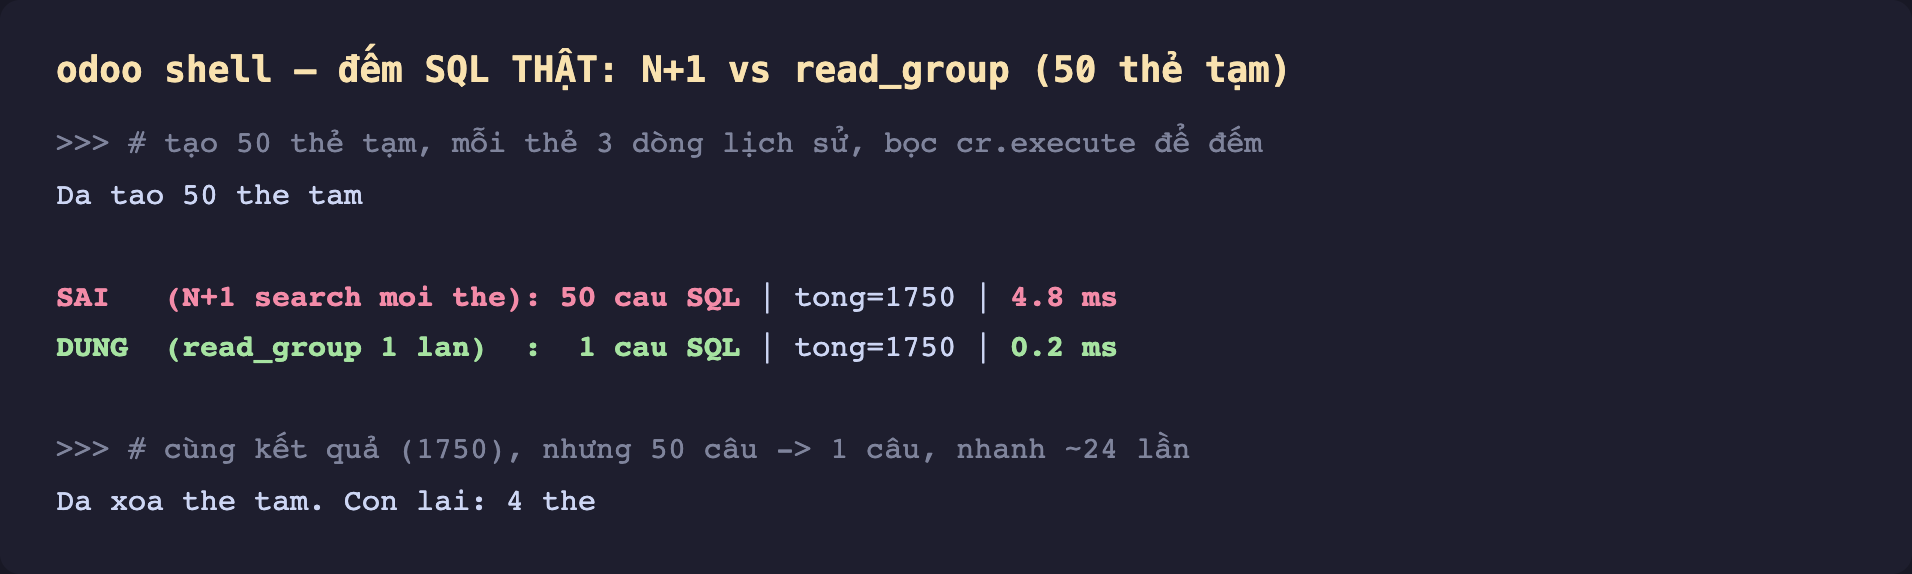
Hình 2: Thật, đo bằng bộ đếm bọc quanh cr.execute. Cách N+1: 50 câu SQL, 4.8 ms. Cách read_group: 1 câu SQL, 0.2 ms. Cùng ra kết quả 1750 — không cách nào sai về mặt số liệu — nhưng một cách nhanh gấp ~24 lần và, quan trọng hơn, số query của nó không tăng theo số thẻ. Với 50 thẻ khác biệt đã rõ; với 5.000 thẻ, cách sai là 5.000 câu SQL. (Đã xoá 50 thẻ tạm sau khi đo.)
Bốn công cụ để né N+1
Odoo cho sẵn công cụ, dùng chúng thay cho vòng lặp Python:
read_group/_read_group— gộp thống kê (đếm, tổng, trung bình) ngay trong SQL. Thay cho "lặp rồi đếm/cộng".mapped('field')— lấy một field (hay đi qua quan hệ) cho cả recordset một lần, tận dụng prefetch.cards.mapped('lich_su_ids.diem_cong')thay cho vòng lặp.filtered(func)— lọc trong bộ nhớ trên recordset đã nạp, không đẻ query mới.- Một
searchrồi nhóm bằng dict — nếu cần dữ liệu con,searchmột lần cho mọi cha rồi gom bằngdefaultdict, thay vì search trong vòng lặp.
# thay vì search trong vòng lặp:
lines = Hist.search([('the_id', 'in', cards.ids)])   # 1 query
theo_the = defaultdict(list)
for l in lines:
    theo_the[l.the_id.id].append(l)                  # gom trong Python
Cách phát hiện N+1
- Bật log SQL: chạy Odoo với
--log-level=debug_sql(hoặc bọccr.executenhư trên) và nhìn số câu lặp lại giống hệt nhau chỉ khác tham sốid. - Nghi ngờ mọi
search/search_countnằm trongfor. Đó là dấu hiệu số một. - Dùng profiler của Odoo (
from odoo.tools.profiler import Profiler) để đếm query theo từng đoạn. - Quy tắc ngón tay cái: số câu SQL không được tăng theo số bản ghi. Nếu thêm dữ liệu mà số query tăng tuyến tính, bạn đang dính N+1.
Ba ý mang về
- Bẫy N+1 là gọi
search()/truy vấn con bên trong vòng lặp — mỗi vòng một câu SQL. Prefetch tự động của Odoo cứu được việc đọc field, nhưng không cứu đượcsearchtrong loop. - Đo thật cho thấy 50 câu SQL (4.8 ms) sụt còn 1 câu (0.2 ms) khi thay vòng lặp
searchbằng_read_group— cùng kết quả 1750, nhưng số query không tăng theo số bản ghi. - Dùng công cụ ORM thay vòng lặp:
read_groupđể gộp thống kê,mappedđể đọc field/quan hệ cả recordset,filteredđể lọc trong bộ nhớ, và mộtsearch+ nhóm bằng dict thay cho search trong loop.
Né được N+1 ở tầng code rồi, còn một tầng nữa quyết định tốc độ truy vấn: cách CSDL tìm dữ liệu. Phần sau nói về index và tối ưu truy vấn — khi nào Odoo tự tạo index, khi nào bạn phải thêm index=True, và vì sao một field tìm kiếm thiếu index có thể làm chậm cả bảng.
