Bài trước ta đọc kế hoạch mà EXPLAIN dự định. Nhưng dự định có thể sai. Thêm một từ — ANALYZE — và PostgreSQL sẽ chạy thật truy vấn rồi in số dòng và thời gian thực tế bên cạnh ước lượng. Khoảng cách giữa "đoán" và "thật" chính là công cụ chẩn đoán mạnh nhất bạn có: khi planner đoán sai số dòng, nó chọn nhầm kế hoạch, và đó là thủ phạm số một của những truy vấn chậm khó hiểu.
EXPLAIN ANALYZE: thêm cột "thực tế"
EXPLAIN thường chỉ cho cost và rows ước lượng. EXPLAIN ANALYZE thực thi truy vấn và thêm actual time và rows thực tế vào mỗi node.
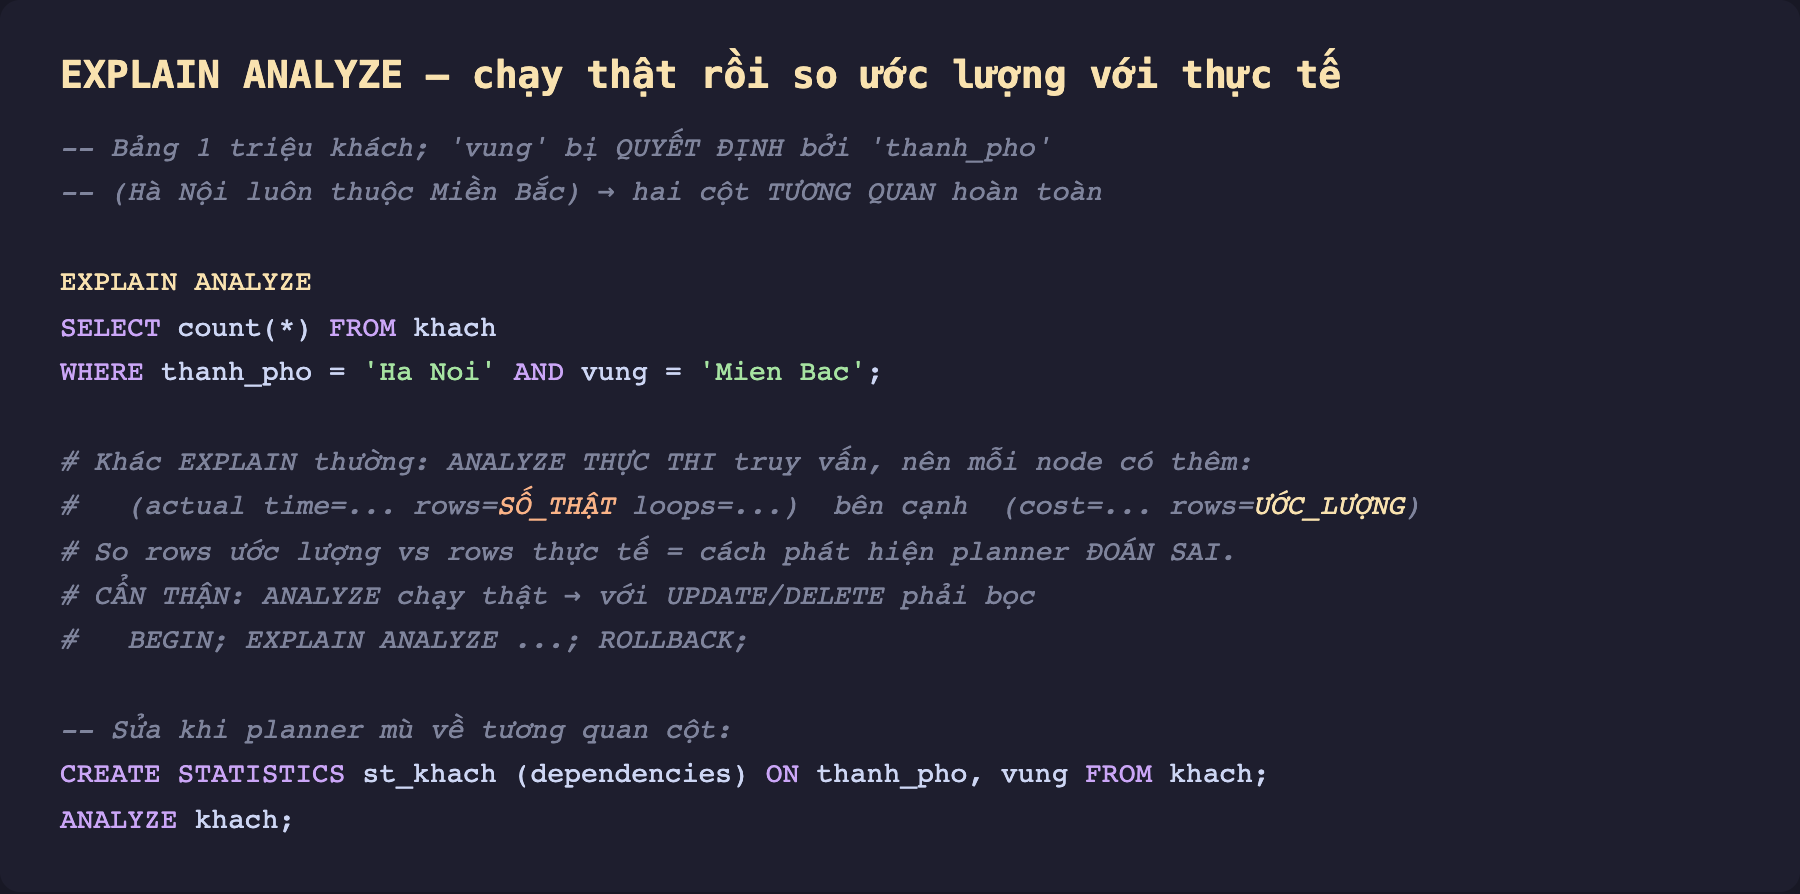
Hình 1: Bảng khach 1 triệu dòng, với vung bị quyết định bởi thanh_pho (Hà Nội ⇒ Miền Bắc) — hai cột tương quan hoàn toàn. Ta hỏi số khách vừa ở 'Ha Noi' vừa thuộc 'Mien Bac'. Lưu ý an toàn: ANALYZE chạy thật truy vấn — với UPDATE/DELETE phải bọc trong BEGIN; ... ROLLBACK; để không đổi dữ liệu.
Khoảng cách ước lượng — thực tế
Chạy thật, và nhìn hai con số cạnh nhau:
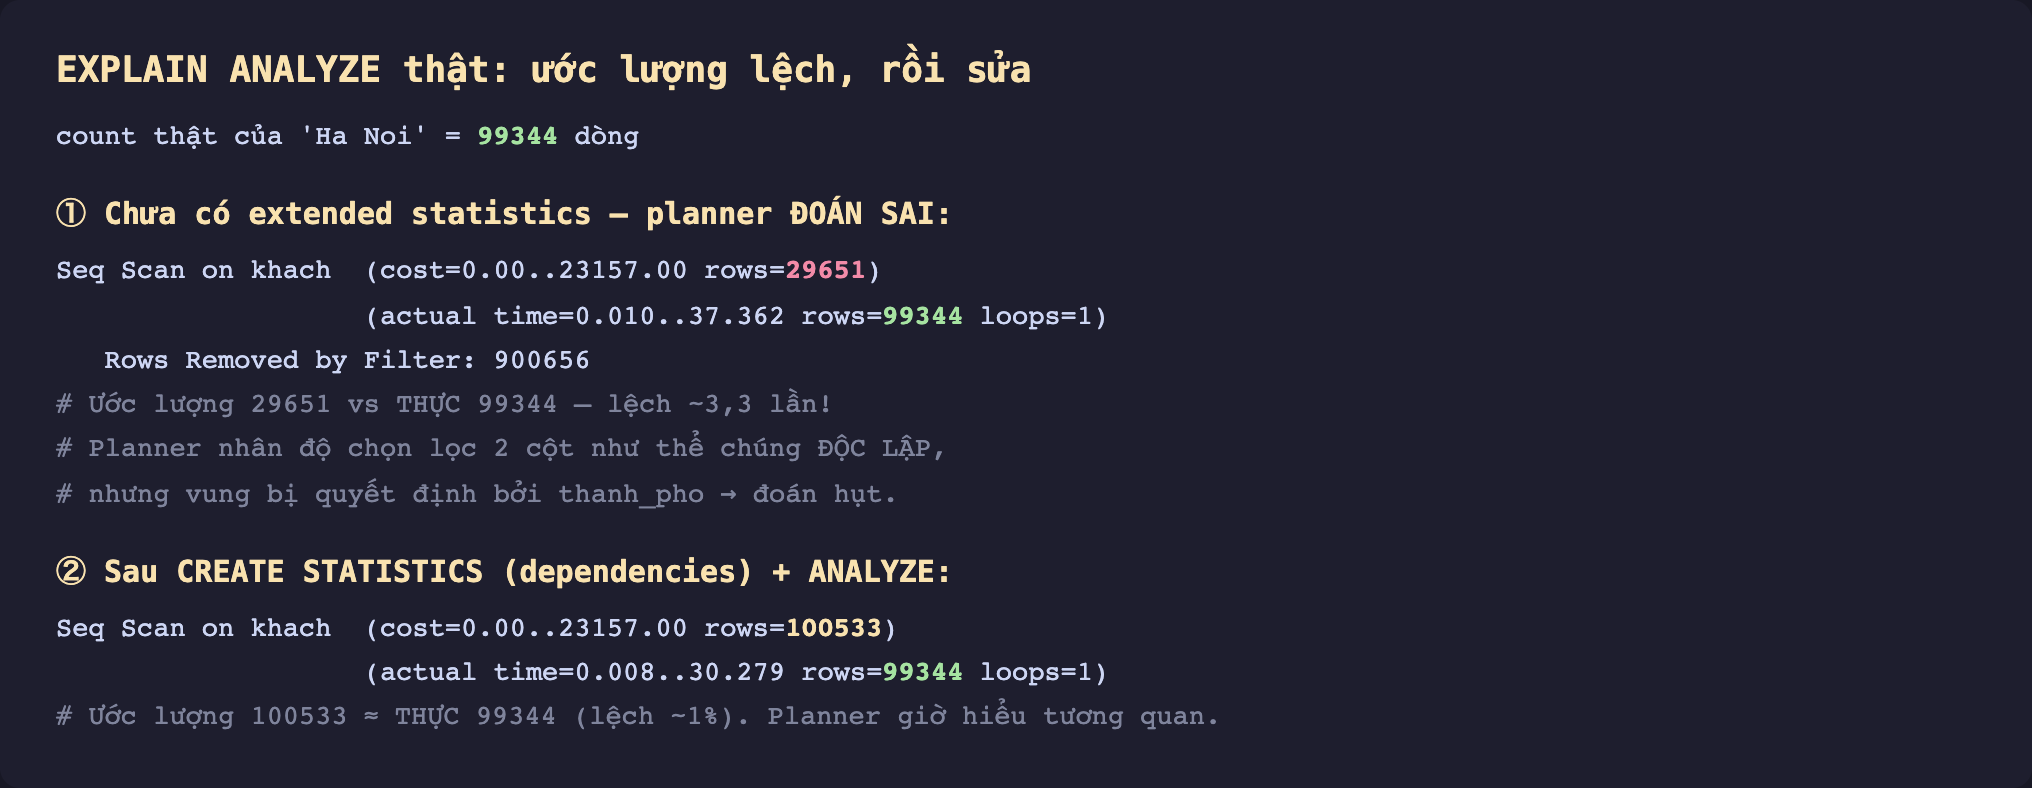
Hình 2: Thật. Số khách "Ha Noi" thực tế là 99.344. Nhưng planner ước lượng chỉ 29.651 — lệch ~3,3 lần. Lý do: nó tính độ chọn lọc của thanh_pho='Ha Noi' và vung='Mien Bac' rồi nhân với nhau như thể hai cột độc lập. Chúng không độc lập — mọi khách Hà Nội đều ở Miền Bắc — nên phép nhân ra con số quá nhỏ. Sau khi khai CREATE STATISTICS cho cặp cột, planner ước lượng 100.533 — sát thực tế 99.344 (~1%).
Vì sao ước lượng sai lại nguy hiểm
Trong ví dụ này cả hai lần đều Seq Scan nên thời gian không đổi nhiều. Nhưng khi truy vấn phức tạp hơn, ước lượng sai làm planner chọn nhầm kế hoạch, và hậu quả rất nặng:
- Đoán ít dòng → chọn Nested Loop (tốt cho ít dòng) nhưng thực tế nhiều dòng → chạy hàng triệu vòng lặp, chậm gấp trăm lần.
- Đoán ít dòng → cấp
work_memkhông đủ → sort/hash tràn ra đĩa. - Đoán nhiều dòng → bỏ qua index đáng lẽ nên dùng.
Vì vậy quy tắc đọc EXPLAIN ANALYZE: luôn so rows ước lượng với rows thực tế ở từng node. Node nào lệch nhiều (chục lần trở lên) là nơi planner "mù", và thường là gốc rễ của sự chậm.
Đọc actual time và loops
actual time=x..y—xlà thời gian tới dòng đầu tiên,ytới dòng cuối, cho một lần chạy node.loops=N— node chạy bao nhiêu lần (ví dụ trong Nested Loop). Tổng thời gian thực của node ≈actual time(dòng cuối) ×loops— một cái bẫy: một node "3ms" nhưngloops=5000thực ra tốn 15 giây.Rows Removed by Filter— số dòng bị đọc lên rồi vứt đi; lớn nghĩa là đang quét lãng phí (ở đây 900.656 dòng bị lọc bỏ).
Sửa ước lượng sai do tương quan cột
Khi khoảng cách ước lượng/thực tế đến từ cột tương quan, công cụ là extended statistics:
CREATE STATISTICS st_khach (dependencies) ON thanh_pho, vung FROM khach;
ANALYZE khach;
dependencies dạy planner rằng biết thanh_pho là gần như biết vung, nên nó không nhân độ chọn lọc như hai biến độc lập nữa. Kết quả: ước lượng từ 29.651 nhảy lên 100.533, sát thực tế. (Ta sẽ đào sâu extended statistics ở bài riêng — ở đây chỉ để thấy cách sửa khi EXPLAIN ANALYZE phơi ra vấn đề.)
Ba ý mang về
EXPLAIN ANALYZEchạy thật và inrowsthực tế bên cạnh ước lượng — khoảng cách giữa hai con số là manh mối chẩn đoán số một. (Nó thực thi truy vấn: bọcUPDATE/DELETEtrongBEGIN; ... ROLLBACK;.)- Ước lượng lệch → chọn nhầm kế hoạch. Đã thấy 29.651 (đoán) vs 99.344 (thật) vì planner coi hai cột tương quan là độc lập; lệch lớn ở truy vấn phức tạp gây chậm gấp trăm lần.
- Đọc kèm
loops: tổng thời gian node ≈actual time×loops. Và khi lệch do tương quan cột,CREATE STATISTICSkéo ước lượng về sát thực tế (100.533 ≈ 99.344).
Ta đã biết một node đọc bao nhiêu dòng. Câu hỏi tiếp theo: nó đọc từ bộ nhớ hay từ đĩa? Phần sau thêm tuỳ chọn BUFFERS để thấy mỗi node chạm bao nhiêu trang cache (shared hit) so với đĩa (read) — chìa khoá hiểu vì sao cùng một kế hoạch lúc nhanh lúc chậm.
