Bạn chạy một truy vấn, lần đầu 12ms, lần sau 8ms — cùng câu lệnh, cùng dữ liệu, cùng kế hoạch. Vì sao? Câu trả lời không nằm trong kế hoạch, mà ở chỗ dữ liệu được lấy từ đâu: từ cache trong RAM hay phải đọc từ đĩa. Tuỳ chọn BUFFERS của EXPLAIN phơi bày chính xác điều đó, và nó là mảnh ghép cuối để đọc một kế hoạch cho trọn.
BUFFERS: đếm trang, và đếm ở đâu
Thêm BUFFERS vào EXPLAIN (ANALYZE, BUFFERS), mỗi node có thêm dòng Buffers: cho biết nó chạm bao nhiêu trang 8KB và những trang đó đến từ đâu.
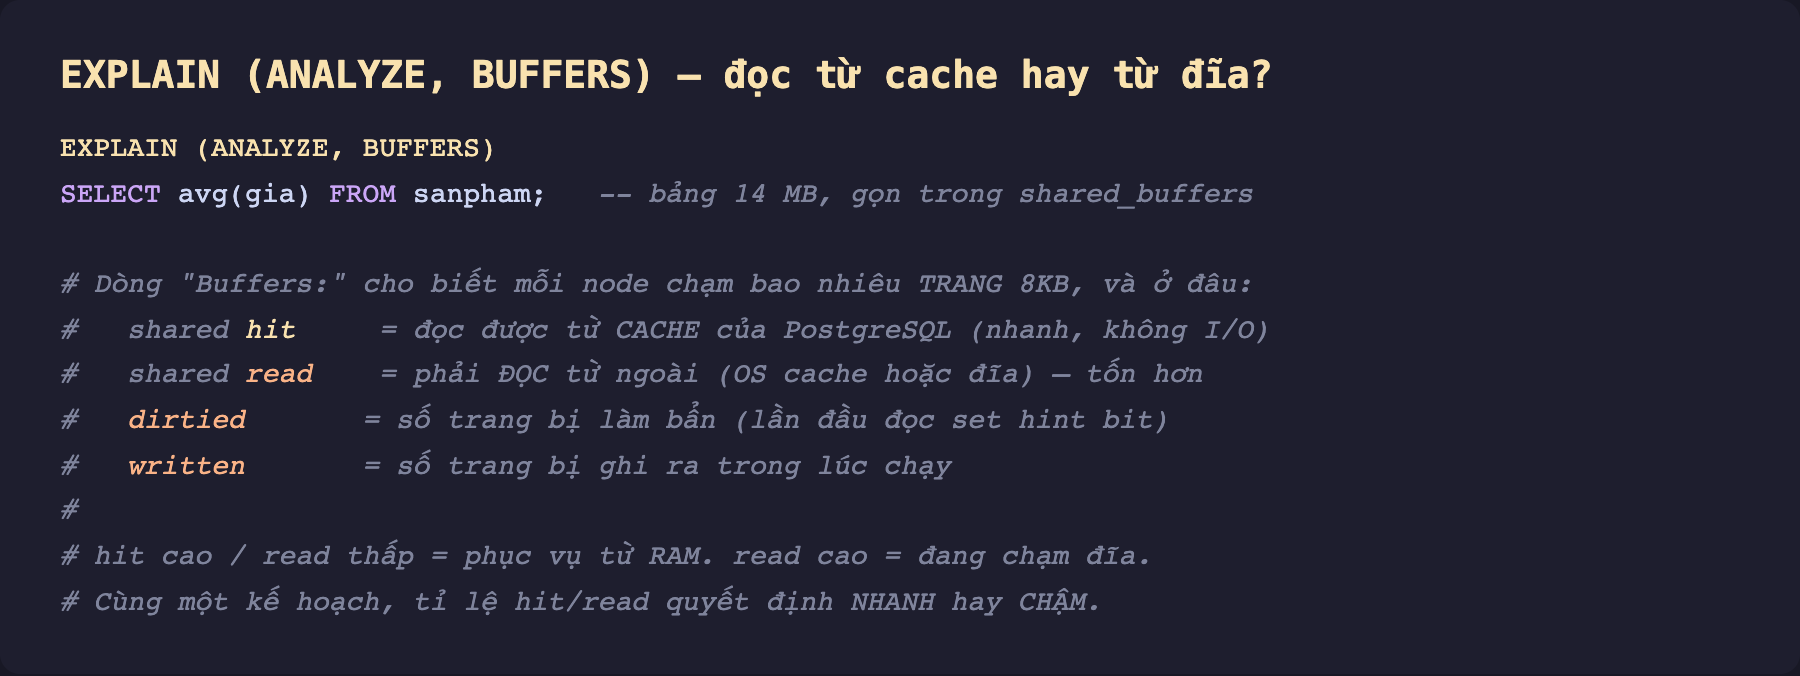
Hình 1: BUFFERS thêm dòng Buffers: vào mỗi node. Bốn con số cần biết: shared hit — trang đọc từ cache của PostgreSQL (nhanh, không I/O); shared read — trang phải đọc từ ngoài (OS cache hoặc đĩa); dirtied — trang bị làm bẩn (lần đọc đầu set hint bit); written — trang bị ghi ra trong lúc chạy. Đơn vị là trang 8KB, không phải dòng.
Cùng truy vấn, hai lần chạy: read → hit
Đây là bằng chứng. Khởi động lại PostgreSQL cho cache trống, rồi chạy cùng truy vấn hai lần:
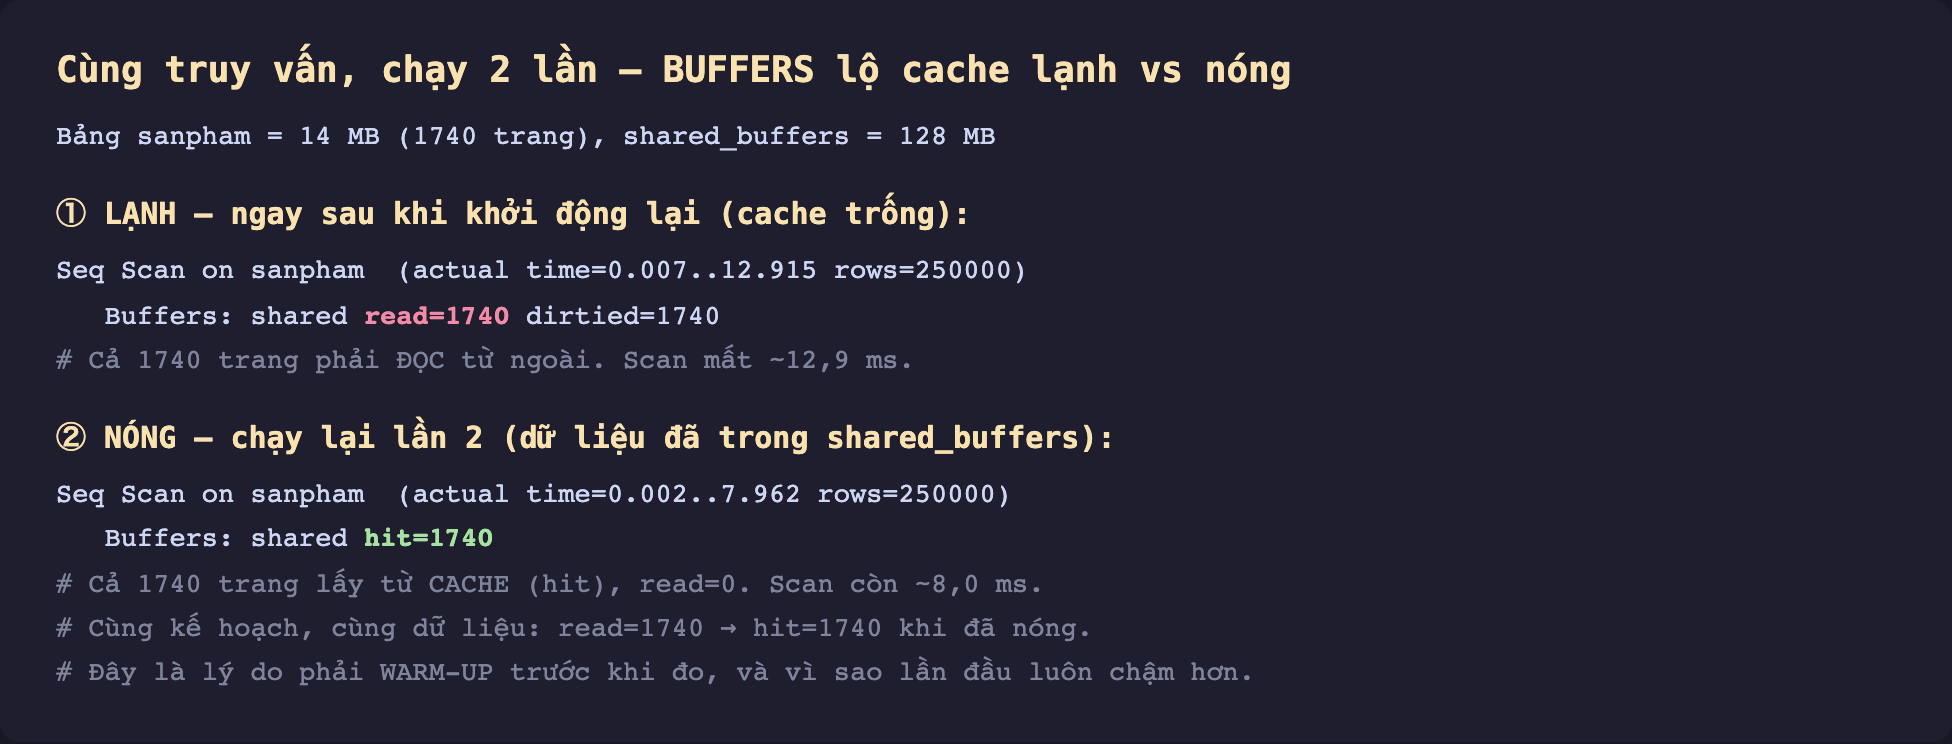
Hình 2: Thật. Bảng 14MB = 1740 trang. Lần đầu (cache lạnh): shared read=1740 — cả 1740 trang phải đọc từ ngoài, scan mất ~12,9ms. Lần hai (cache nóng): shared hit=1740, read=0 — cả 1740 trang lấy từ cache, scan còn ~8,0ms. Cùng kế hoạch, cùng dữ liệu, khác nhau chỉ ở chỗ dữ liệu đã nằm trong shared_buffers hay chưa.
Vì sao điều này quan trọng
- Giải thích "lúc nhanh lúc chậm". Một truy vấn đo lúc cache nóng cho số đẹp, nhưng người dùng thật gặp cache lạnh (dữ liệu ít truy cập) sẽ thấy chậm hơn nhiều.
BUFFERScho bạn thấy cả hai mặt. readcao = ứng viên tối ưu. Node đọc nhiều trang từ đĩa là nơi I/O đổ vào. Thêm index để đọc ít trang hơn, hoặc tăngshared_buffersđể giữ được nhiều dữ liệu nóng.- So
hit/readgiữa các kế hoạch. Khi so hai cách viết truy vấn, đừng chỉ nhìn thời gian (dao động theo cache) — nhìn tổng số trang chạm (hit + read), con số này ổn định hơn và phản ánh khối lượng công việc thật.
Một cái bẫy: quét lớn không nằm lại cache
Có một chi tiết dễ gây bối rối: nếu bảng lớn hơn ~1/4 shared_buffers, PostgreSQL dùng một vùng đệm vòng (ring buffer) nhỏ cho quét tuần tự, để một lần quét bảng khổng lồ không "đẩy" hết dữ liệu nóng khác ra khỏi cache. Hệ quả: quét lại một bảng lớn vẫn thấy read cao dù đã chạy trước đó — không phải lỗi, mà là cơ chế bảo vệ cache. (Ví dụ trên dùng bảng 14MB, nhỏ hơn ngưỡng đó, nên lần hai hit trọn vẹn.)
Vài lưu ý
hitlà hit trongshared_buffers, không tính OS cache. Một trangreadvẫn có thể nhanh nếu nằm trong OS page cache — nhưng PostgreSQL đếm nó làread. Vì vậyreadcao chưa chắc chạm đĩa vật lý, chỉ chắc là không ở cache của PostgreSQL.track_io_timing(bật riêng) còn cho thêm thời gian I/O thực (I/O Timings) — hữu ích khi muốn biếtreadtốn bao nhiêu mili-giây thật.- Luôn warm-up khi benchmark. Chạy vài lần bỏ lần đầu (như bài 2 đã nói) — giờ bạn thấy chính xác vì sao: lần đầu là
read, các lần sau mớihit.
Ba ý mang về
EXPLAIN (ANALYZE, BUFFERS)cho biết mỗi node đọc bao nhiêu trang 8KB và từ đâu:shared hit(cache PostgreSQL) vsshared read(ngoài cache). Đây là cách hiểu "vì sao cùng truy vấn lúc nhanh lúc chậm".- Đã thấy thật: cùng truy vấn, cache lạnh
read=1740(~12,9ms) → cache nónghit=1740,read=0(~8,0ms). Warm-up trước khi đo là bắt buộc. readcao là ứng viên tối ưu (thêm index, tăngshared_buffers); khi so kế hoạch, nhìn tổng trang chạm (hit + read) ổn định hơn nhìn thời gian. Lưu ý ring buffer khiến quét bảng lớn vẫnreadcao dù đã nóng.
Ta đã đọc trọn một kế hoạch: dòng, thời gian, và trang cache/đĩa. Nhưng những con số cost mà planner dùng để chọn kế hoạch từ đâu ra? Phần sau mổ xẻ cost model của planner — seq_page_cost, random_page_cost, cpu_tuple_cost và cách chúng ghép lại thành con số quyết định planner chọn Seq Scan hay Index Scan.
