Ở bài 3 ta gặp những con số cost=... và mình nói đó là "đơn vị trừu tượng để so sánh". Giờ mở hộp đen ra: con số đó không ngẫu nhiên — nó là kết quả của một công thức đơn giản mà bạn có thể tự tính lại. Hiểu cost model giúp bạn đoán được vì sao planner chọn kế hoạch này thay vì kế hoạch kia, và vì sao chỉnh vài tham số cấu hình có thể lật ngược quyết định đó.
Năm tham số, quy mọi thứ về một thang
Planner không đo mili-giây (nó chưa chạy gì cả). Thay vào đó nó ước lượng khối lượng công việc theo một thang tương đối, với seq_page_cost = 1 làm gốc:
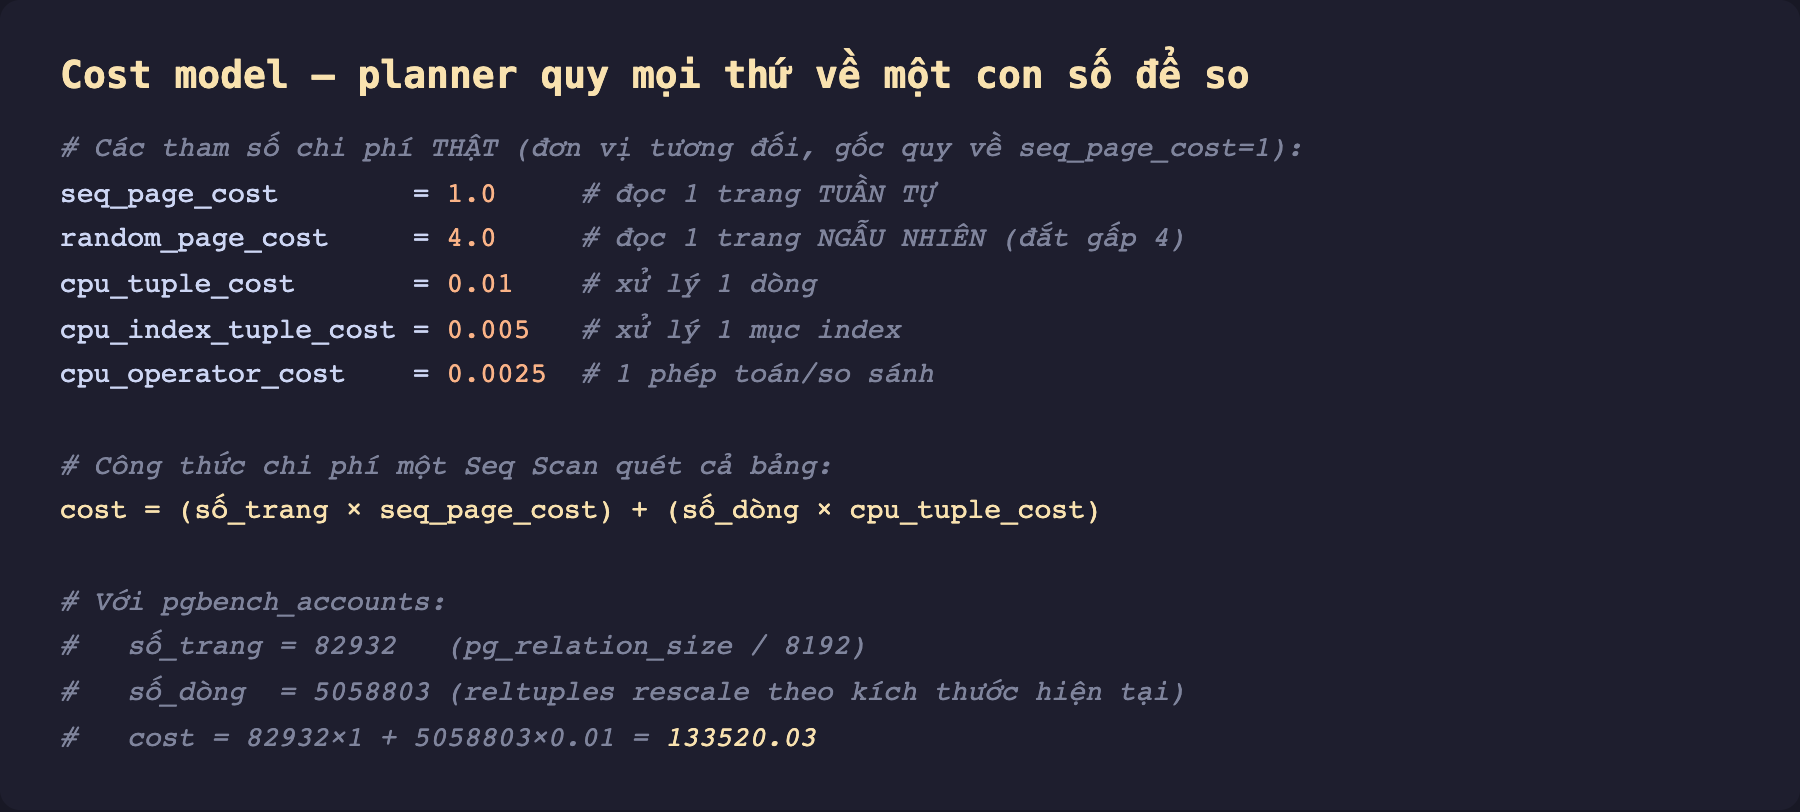
Hình 1: Năm tham số chi phí (giá trị mặc định thật). Điểm cốt: đọc trang ngẫu nhiên đắt gấp 4 lần đọc tuần tự (random_page_cost 4 vs seq_page_cost 1) — đây là lý do planner ngại index scan trên nhiều dòng. Công thức chi phí một Seq Scan quét cả bảng rất gọn: số_trang × seq_page_cost + số_dòng × cpu_tuple_cost.
Tự tay tính lại — và khớp đến từng số lẻ
Lý thuyết là vậy, giờ kiểm chứng. Lấy pgbench_accounts (5 triệu dòng):
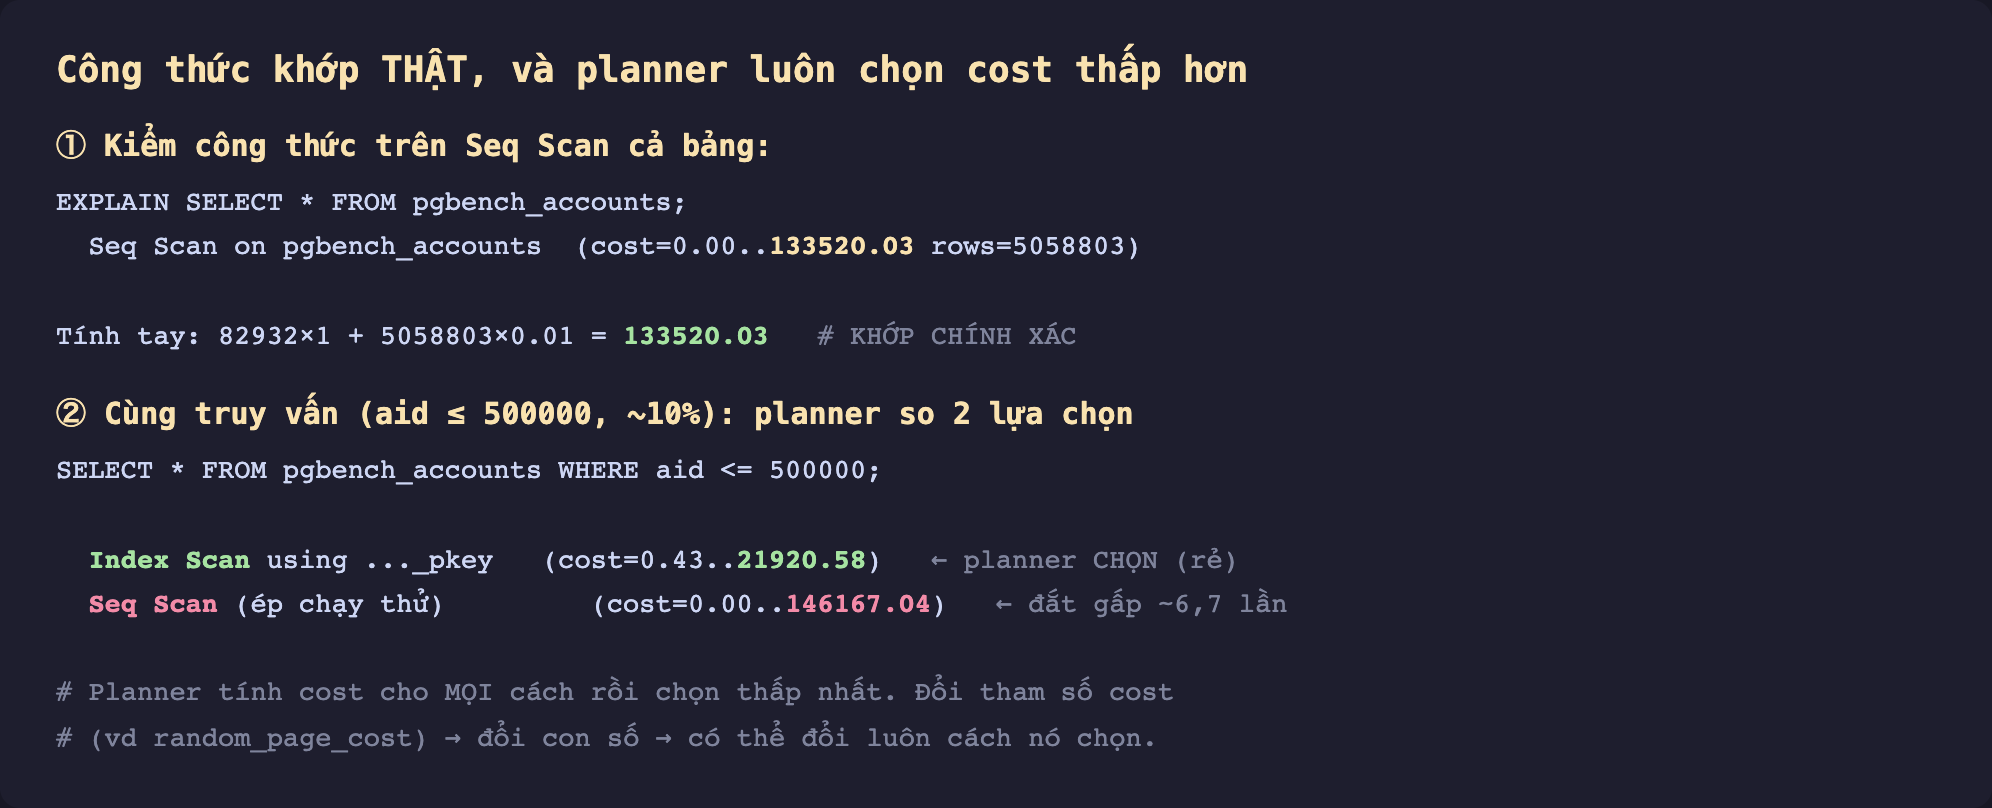
Hình 2: Thật, và khớp chính xác. EXPLAIN cho Seq Scan cost 133520.03. Tính tay: bảng có 82.932 trang (pg_relation_size/8192) và planner ước 5.058.803 dòng (rescale reltuples theo kích thước hiện tại). 82932 × 1 + 5058803 × 0.01 = 133520.03 — đúng đến hai số lẻ. Con số không phải phép thuật; nó là số học.
Planner luôn chọn cost thấp nhất
Đây là toàn bộ triết lý của planner: với mỗi truy vấn, nó liệt kê các cách thực thi, tính cost cho từng cách, và chọn cái thấp nhất. Nhìn phần ② của Hình 2 — cùng truy vấn aid <= 500000 (~10% bảng):
- Index Scan: cost
21920.58— planner chọn cái này. - Seq Scan (mình ép chạy thử bằng
enable_indexscan=off): cost146167.04— đắt gấp ~6,7 lần.
Với 10% dữ liệu và index trên khóa chính (dòng nằm gần nhau vật lý), index scan rẻ hơn nhiều nên thắng. Nhưng nếu truy vấn lấy 60% bảng, chi phí đọc ngẫu nhiên qua index sẽ vượt chi phí quét tuần tự, và cán cân lật sang Seq Scan.
Vì sao điều này hữu ích khi tối ưu
- Đoán được quyết định của planner. Biết công thức, bạn hiểu vì sao một truy vấn lấy nhiều dòng lại nên dùng Seq Scan (đọc tuần tự rẻ), còn lấy ít dòng thì Index Scan thắng.
- Giải thích "vì sao không dùng index của tôi". Thường không phải index hỏng, mà là planner tính ra Seq Scan rẻ hơn cho truy vấn đó — và nó thường đúng.
- Chỉnh cost cho đúng phần cứng.
random_page_cost = 4là giá trị cho đĩa quay (HDD), nơi seek ngẫu nhiên đắt thật. Trên SSD, seek ngẫu nhiên gần như rẻ ngang tuần tự — nên hạrandom_page_costxuống ~1.1 để planner mạnh dạn dùng index hơn. Đây là một trong những chỉnh config đáng giá nhất, ta sẽ đo kỹ ở bài về cấu hình I/O.
Vài lưu ý
costchỉ để so sánh, không phải thời gian. Cost thấp hơn không đảm bảo nhanh hơn tuyệt đối — chỉ nghĩa là planner tin nó rẻ hơn. Khi ước lượng dòng sai (bài 4), cost cũng sai theo.- Startup cost quan trọng với
LIMIT.cost=startup..total; vớiLIMITnhỏ, planner ưu tiên kế hoạch cóstartupthấp (trả dòng đầu nhanh) dùtotalcao hơn. - Đừng chỉnh cost params một cách bừa bãi. Chúng ảnh hưởng mọi truy vấn.
random_page_costcho SSD là chỉnh hợp lý; vặn lung tung các tham số khác thì dễ làm hại nhiều hơn lợi.
Ba ý mang về
- Cost là số học, không phải phép thuật.
Seq Scan=số_trang × seq_page_cost + số_dòng × cpu_tuple_cost; đã tính tay ra đúng133520.03nhưEXPLAIN. - Planner tính cost cho mọi phương án và chọn thấp nhất — đã thấy Index Scan (21.920) thắng Seq Scan (146.167) cho truy vấn 10% dữ liệu.
random_page_cost = 4là cho HDD; SSD nên hạ xuống ~1.1 để planner dùng index nhiều hơn — một chỉnh config đáng giá, nhưng cost chỉ để so sánh và phụ thuộc ước lượng dòng có đúng không.
Ta đã biết cách planner chọn và cách đọc một truy vấn. Nhưng trong hàng nghìn truy vấn của một hệ thống thật, tối ưu cái nào trước? Phần sau giới thiệu pg_stat_statements — extension xếp hạng mọi truy vấn theo tổng thời gian, để bạn đổ công sức vào đúng truy vấn thực sự tốn kém, không phải cái trông có vẻ chậm.
