Sáu bài đầu ta học cách mổ một truy vấn. Nhưng hệ thống thật có hàng nghìn truy vấn khác nhau chạy suốt ngày. Câu hỏi sống còn khi tối ưu không phải "câu này chậm bao nhiêu?" mà là "nên đổ công vào câu nào trước?". Trả lời sai câu này, bạn tối ưu cả ngày một truy vấn mà chẳng ai để ý, trong khi thủ phạm thật nằm chình ình. Công cụ trả lời đúng là pg_stat_statements.
Sổ ghi mọi truy vấn
pg_stat_statements là một extension gộp các truy vấn cùng khuôn (chỉ khác tham số) thành một dòng, và cộng dồn: số lần gọi, tổng thời gian, thời gian trung bình. Nó cần bật ở tầng preload nên phải khởi động lại một lần:
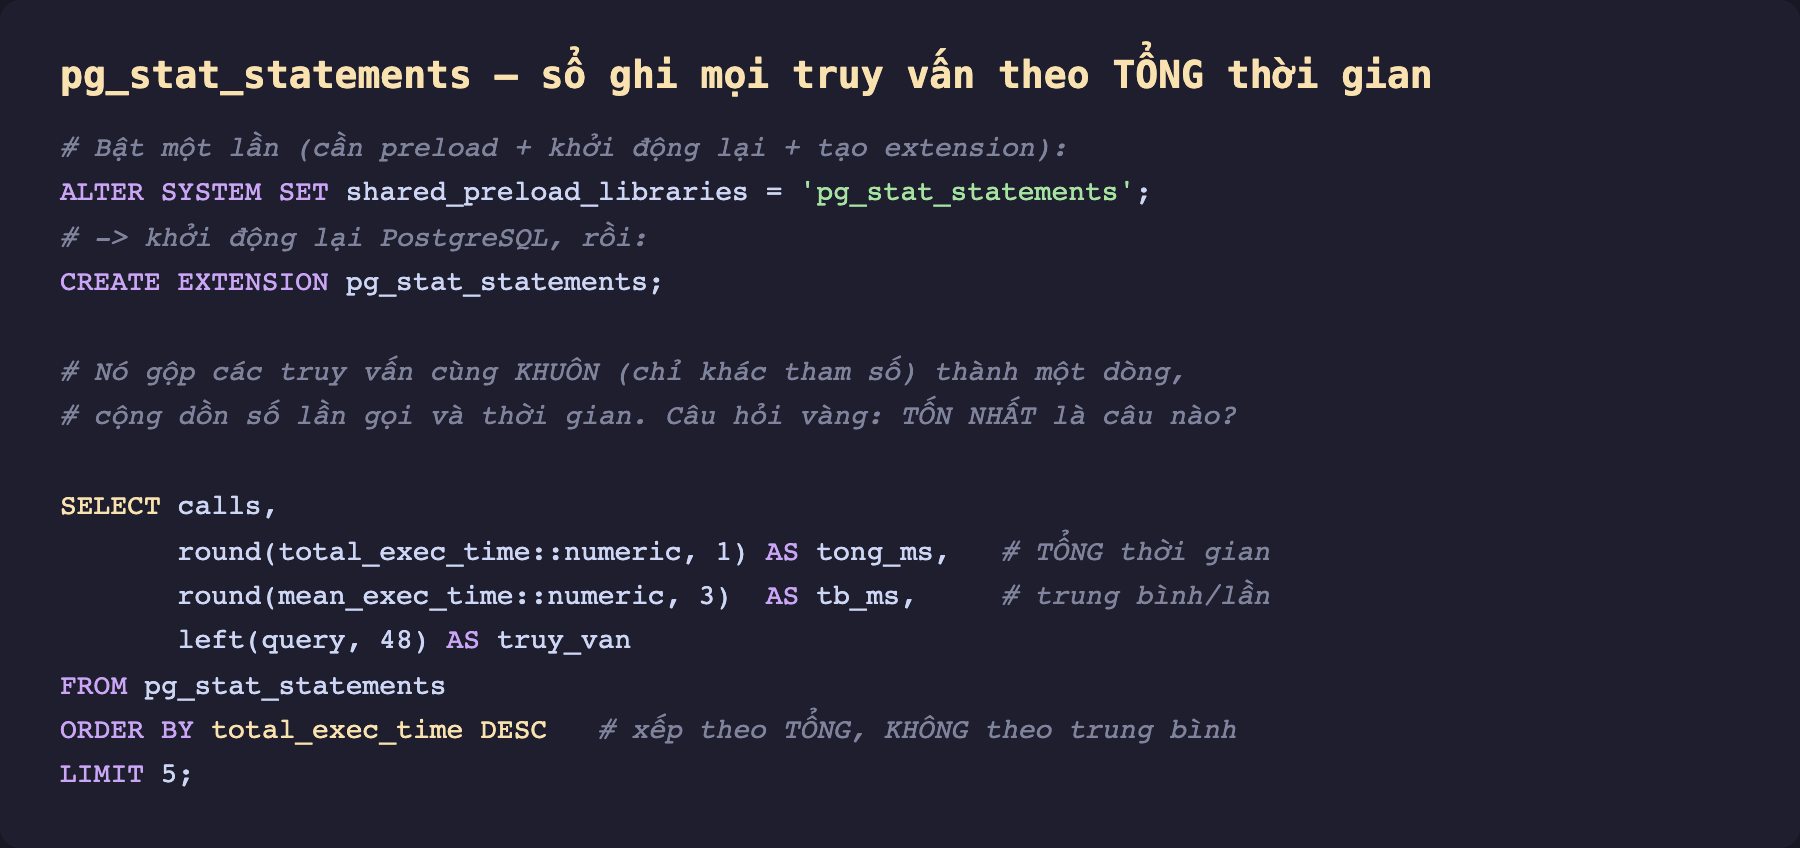
Hình 1: Bật pg_stat_statements (một lần, cần khởi động lại), rồi truy vấn nó. Chú ý mấu chốt: ORDER BY total_exec_time (tổng thời gian tích luỹ), không phải mean_exec_time (trung bình mỗi lần). Vì sao lại thế? Số liệu thật dưới đây trả lời.
Số liệu thật: kẻ thù không phải cái "chậm"
Mình tạo hai loại tải trên PostgreSQL 16: (A) một truy vấn tra cứu theo khóa chính, chạy hàng trăm nghìn lần bằng pgbench; (B) một truy vấn quét cả bảng, riêng lẻ rất chậm, nhưng chỉ chạy 5 lần. Rồi xếp hạng:
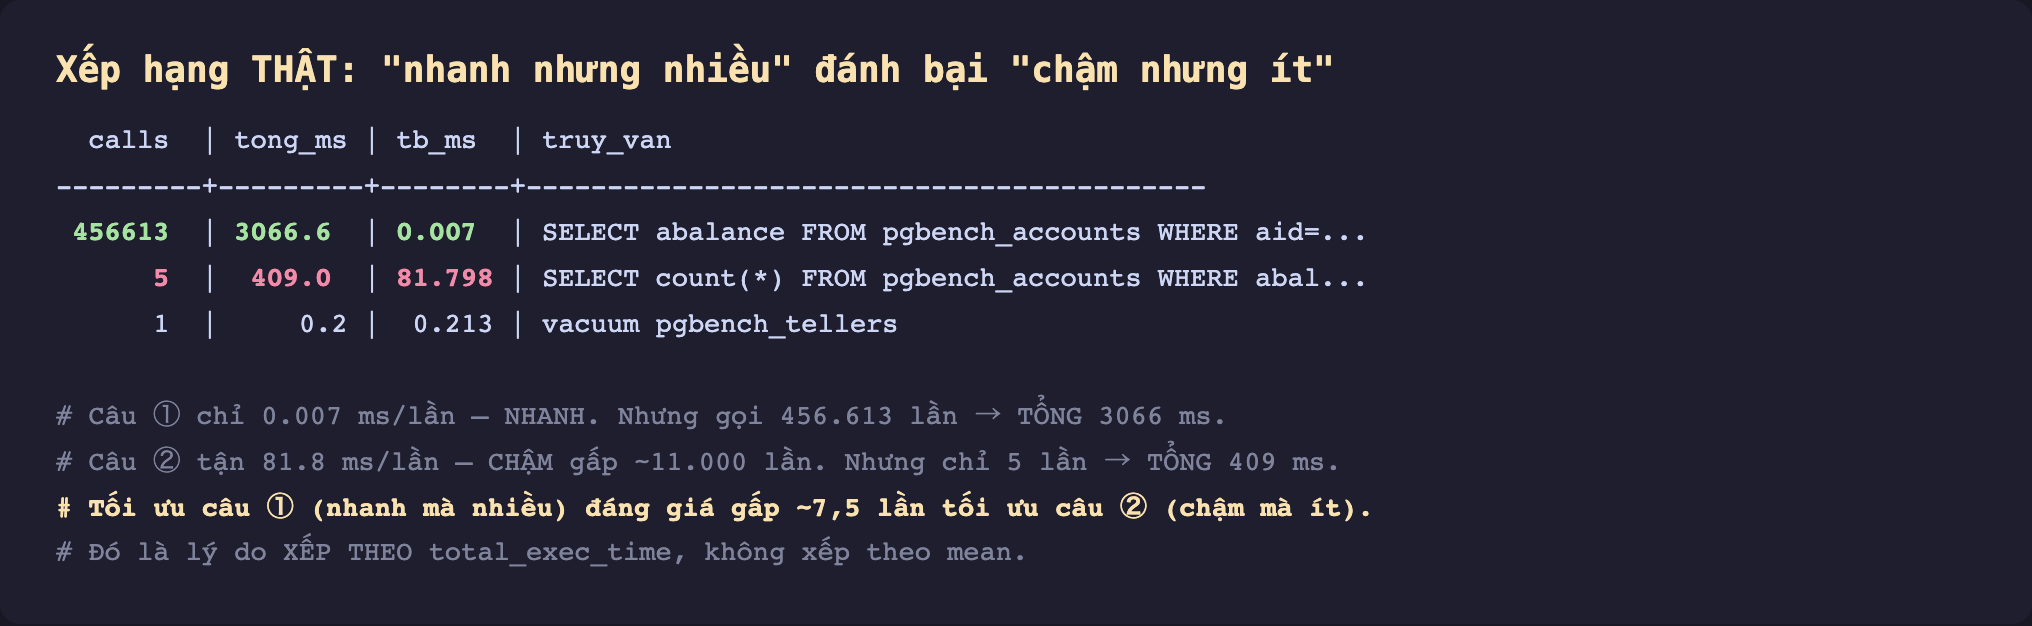
Hình 2: Thật, và phản trực giác. Truy vấn ① SELECT abalance ... WHERE aid=... chỉ 0,007 ms/lần — nhanh kinh khủng. Nhưng nó chạy 456.613 lần, nên tổng 3.066 ms. Truy vấn ② SELECT count(*) ... WHERE abalance>500 tốn 81,8 ms/lần — chậm gấp ~11.000 lần! Nhưng chỉ chạy 5 lần, nên tổng chỉ 409 ms. Kết luận: tối ưu câu ① đáng giá gấp ~7,5 lần tối ưu câu ②, dù câu ② mới là câu "trông chậm".
Vì sao xếp theo tổng, không theo trung bình
Đây là hiểu lầm phổ biến nhất về tối ưu. Nếu bạn xếp theo mean_exec_time, câu ② (81 ms) lên đầu và bạn lao vào tối ưu nó. Nhưng giảm nó từ 81 ms xuống 10 ms chỉ tiết kiệm 5 × 71 ms = 355 ms. Trong khi nếu câu ① (0,007 ms, 456k lần) giảm được chỉ một nửa, bạn tiết kiệm 1.500 ms — gấp 4 lần, với cùng công sức. Tác động = thời gian mỗi lần × số lần gọi, và total_exec_time chính là tích đó.
Quy tắc: tối ưu theo tổng tác động, không theo cảm giác chậm. Một truy vấn "nhanh" chạy trong vòng lặp nóng thường là mỏ vàng tối ưu bị bỏ quên.
Những cột hữu ích khác
pg_stat_statements còn nhiều cột đáng nhìn:
SELECT calls, total_exec_time, mean_exec_time,
       stddev_exec_time,          -- độ dao động: cao = lúc nhanh lúc chậm
       rows,                      -- tổng dòng trả về
       100.0*shared_blks_hit/nullif(shared_blks_hit+shared_blks_read,0) AS hit_pct
FROM pg_stat_statements
ORDER BY total_exec_time DESC LIMIT 20;
stddev_exec_timecao nghĩa là truy vấn lúc nhanh lúc chậm — thường do cache lạnh/nóng hoặc dữ liệu lệch, đáng điều tra.shared_blks_hit/readcho tỉ lệ cache của từng truy vấn — câu nào đọc đĩa nhiều là ứng viên thêm index.pg_stat_statements_reset()xoá số liệu để đo một khoảng thời gian sạch (ví dụ trước và sau một thay đổi).
Vài lưu ý
- Nó gộp theo khuôn, không theo tham số.
WHERE aid=1vàWHERE aid=2là một dòng. Tốt cho việc tìm truy vấn tốn nhất, nhưng nếu một tham số cụ thể mới gây chậm thì cần công cụ khác (auto_explain, bài sau). - Có chi phí nhỏ nhưng thường không đáng kể — hầu hết production đều bật sẵn.
pg_stat_statements.maxgiới hạn số khuôn theo dõi (mặc định 5.000). - Thời gian là tích luỹ từ lúc reset. Một truy vấn mới triển khai có thể chưa lên top chỉ vì chưa chạy đủ lâu — nhìn cả
callsđể hiểu bối cảnh.
Ba ý mang về
pg_stat_statementsxếp hạng mọi truy vấn theototal_exec_time— trả lời câu hỏi quan trọng nhất: nên tối ưu cái nào trước. Bật một lần bằngshared_preload_libraries+CREATE EXTENSION.- Tác động = thời gian/lần × số lần gọi. Đã thấy thật: câu 0,007 ms (456k lần, tổng 3.066 ms) ngốn gấp ~7,5 lần câu 81,8 ms (5 lần, tổng 409 ms). Đừng để bị cái "trông chậm" đánh lừa.
- Xếp theo tổng, không theo trung bình; và nhìn thêm
stddev(dao động),shared_blks_read(đọc đĩa) để khoanh vùng nguyên nhân.pg_stat_statements_reset()để đo sạch trước/sau thay đổi.
Giờ bạn biết truy vấn nào tốn nhất tổng thể. Nhưng đôi khi vấn đề là một truy vấn cá biệt thỉnh thoảng chậm bất thường. Phần sau dùng log_min_duration_statement để tự động ghi log mọi truy vấn vượt ngưỡng thời gian — bắt tận tay những câu chậm mà pg_stat_statements (chỉ thấy trung bình) có thể bỏ sót.
