Câu hỏi "sao lưu PostgreSQL thế nào" thường được trả lời bằng một lệnh pg_dump đặt trong cron. Lệnh đó đúng, và nó trả lời một câu khác với câu bạn sẽ hỏi lúc 3 giờ sáng: khôi phục được về thời điểm nào? PostgreSQL có hai kiểu sao lưu khác bản chất — logic và vật lý — và chúng khác nhau ở thứ không nhìn thấy trong kích thước tệp: thời điểm mà bản sao đại diện. Phần này dựng một cơ sở dữ liệu 613 MB rồi đo cả hai: thời gian, kích thước, ảnh hưởng lên tải đang chạy, và bản sao chứa gì khi có người ghi trong lúc sao lưu.
Hai kiểu sao lưu, hai cơ chế
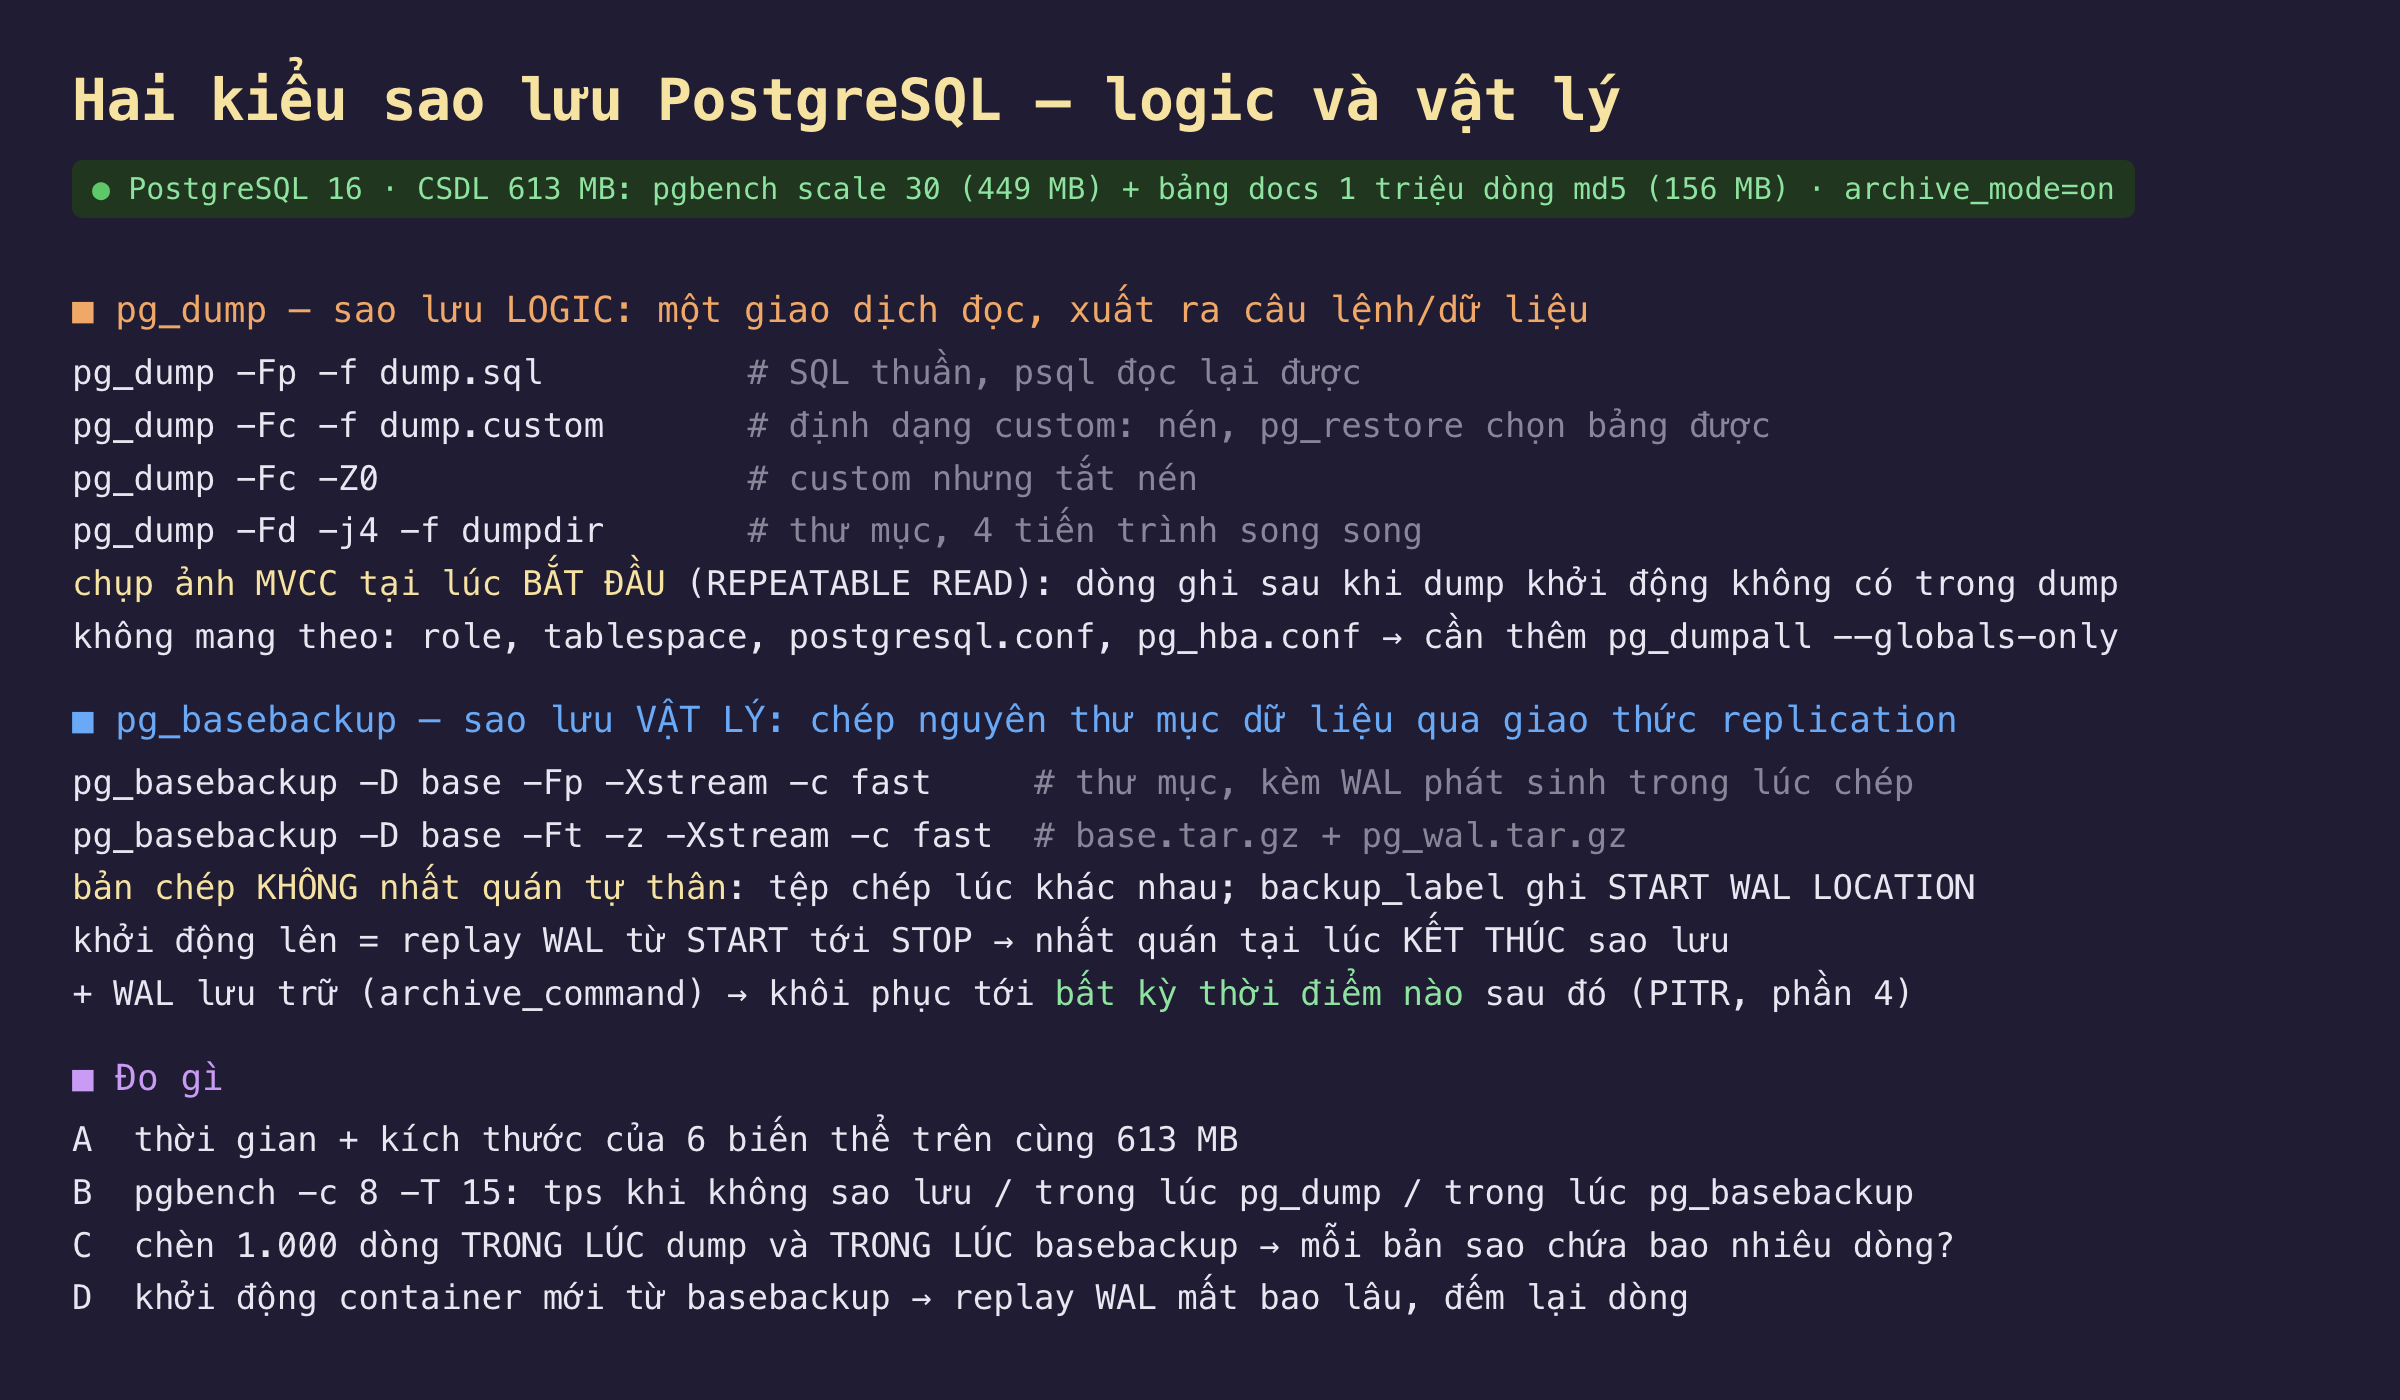
Hình 1: pg_dump đọc qua một giao dịch và xuất ra dữ liệu; pg_basebackup chép tệp qua giao thức replication và dựa vào WAL để nhất quán.
pg_dump là sao lưu logic. Nó mở một giao dịch REPEATABLE READ, đọc catalog và từng bảng, xuất ra câu lệnh CREATE và dữ liệu COPY. Vì là một giao dịch, bản dump là ảnh chụp MVCC tại lúc bắt đầu: mọi thứ commit sau thời điểm đó không có trong dump, dù dump chạy mười phút. Định dạng -Fc (custom) nén và cho pg_restore chọn từng bảng; -Fd -jN chia thành thư mục để chạy song song. Dump không mang theo role, tablespace, postgresql.conf, pg_hba.conf — thứ cần pg_dumpall --globals-only và một bản chép cấu hình riêng.
pg_basebackup là sao lưu vật lý. Nó nối vào máy chủ qua giao thức replication và chép nguyên thư mục dữ liệu: các tệp heap, index, catalog, đúng byte trên đĩa. Vì tệp được chép lần lượt trong khi máy chủ vẫn ghi, bản chép tự thân không nhất quán; tệp backup_label ghi vị trí WAL bắt đầu, và khi khởi động, PostgreSQL replay WAL từ đó tới điểm kết thúc sao lưu để đưa mọi tệp về cùng một thời điểm. -Xstream gói luôn phần WAL phát sinh trong lúc chép. Nếu WAL sau đó còn được lưu trữ (archive_command), bản basebackup này là điểm xuất phát để khôi phục tới bất kỳ thời điểm nào — đó là PITR, phần 4.
Môi trường: PostgreSQL 16 trong container, archive_mode=on, dữ liệu pgbench scale 30 (449 MB) cộng một bảng docs một triệu dòng chuỗi md5 ngẫu nhiên (156 MB) để không phải mọi thứ đều nén tốt như dữ liệu pgbench.
Đo thật: thời gian, kích thước, tải, và thời điểm
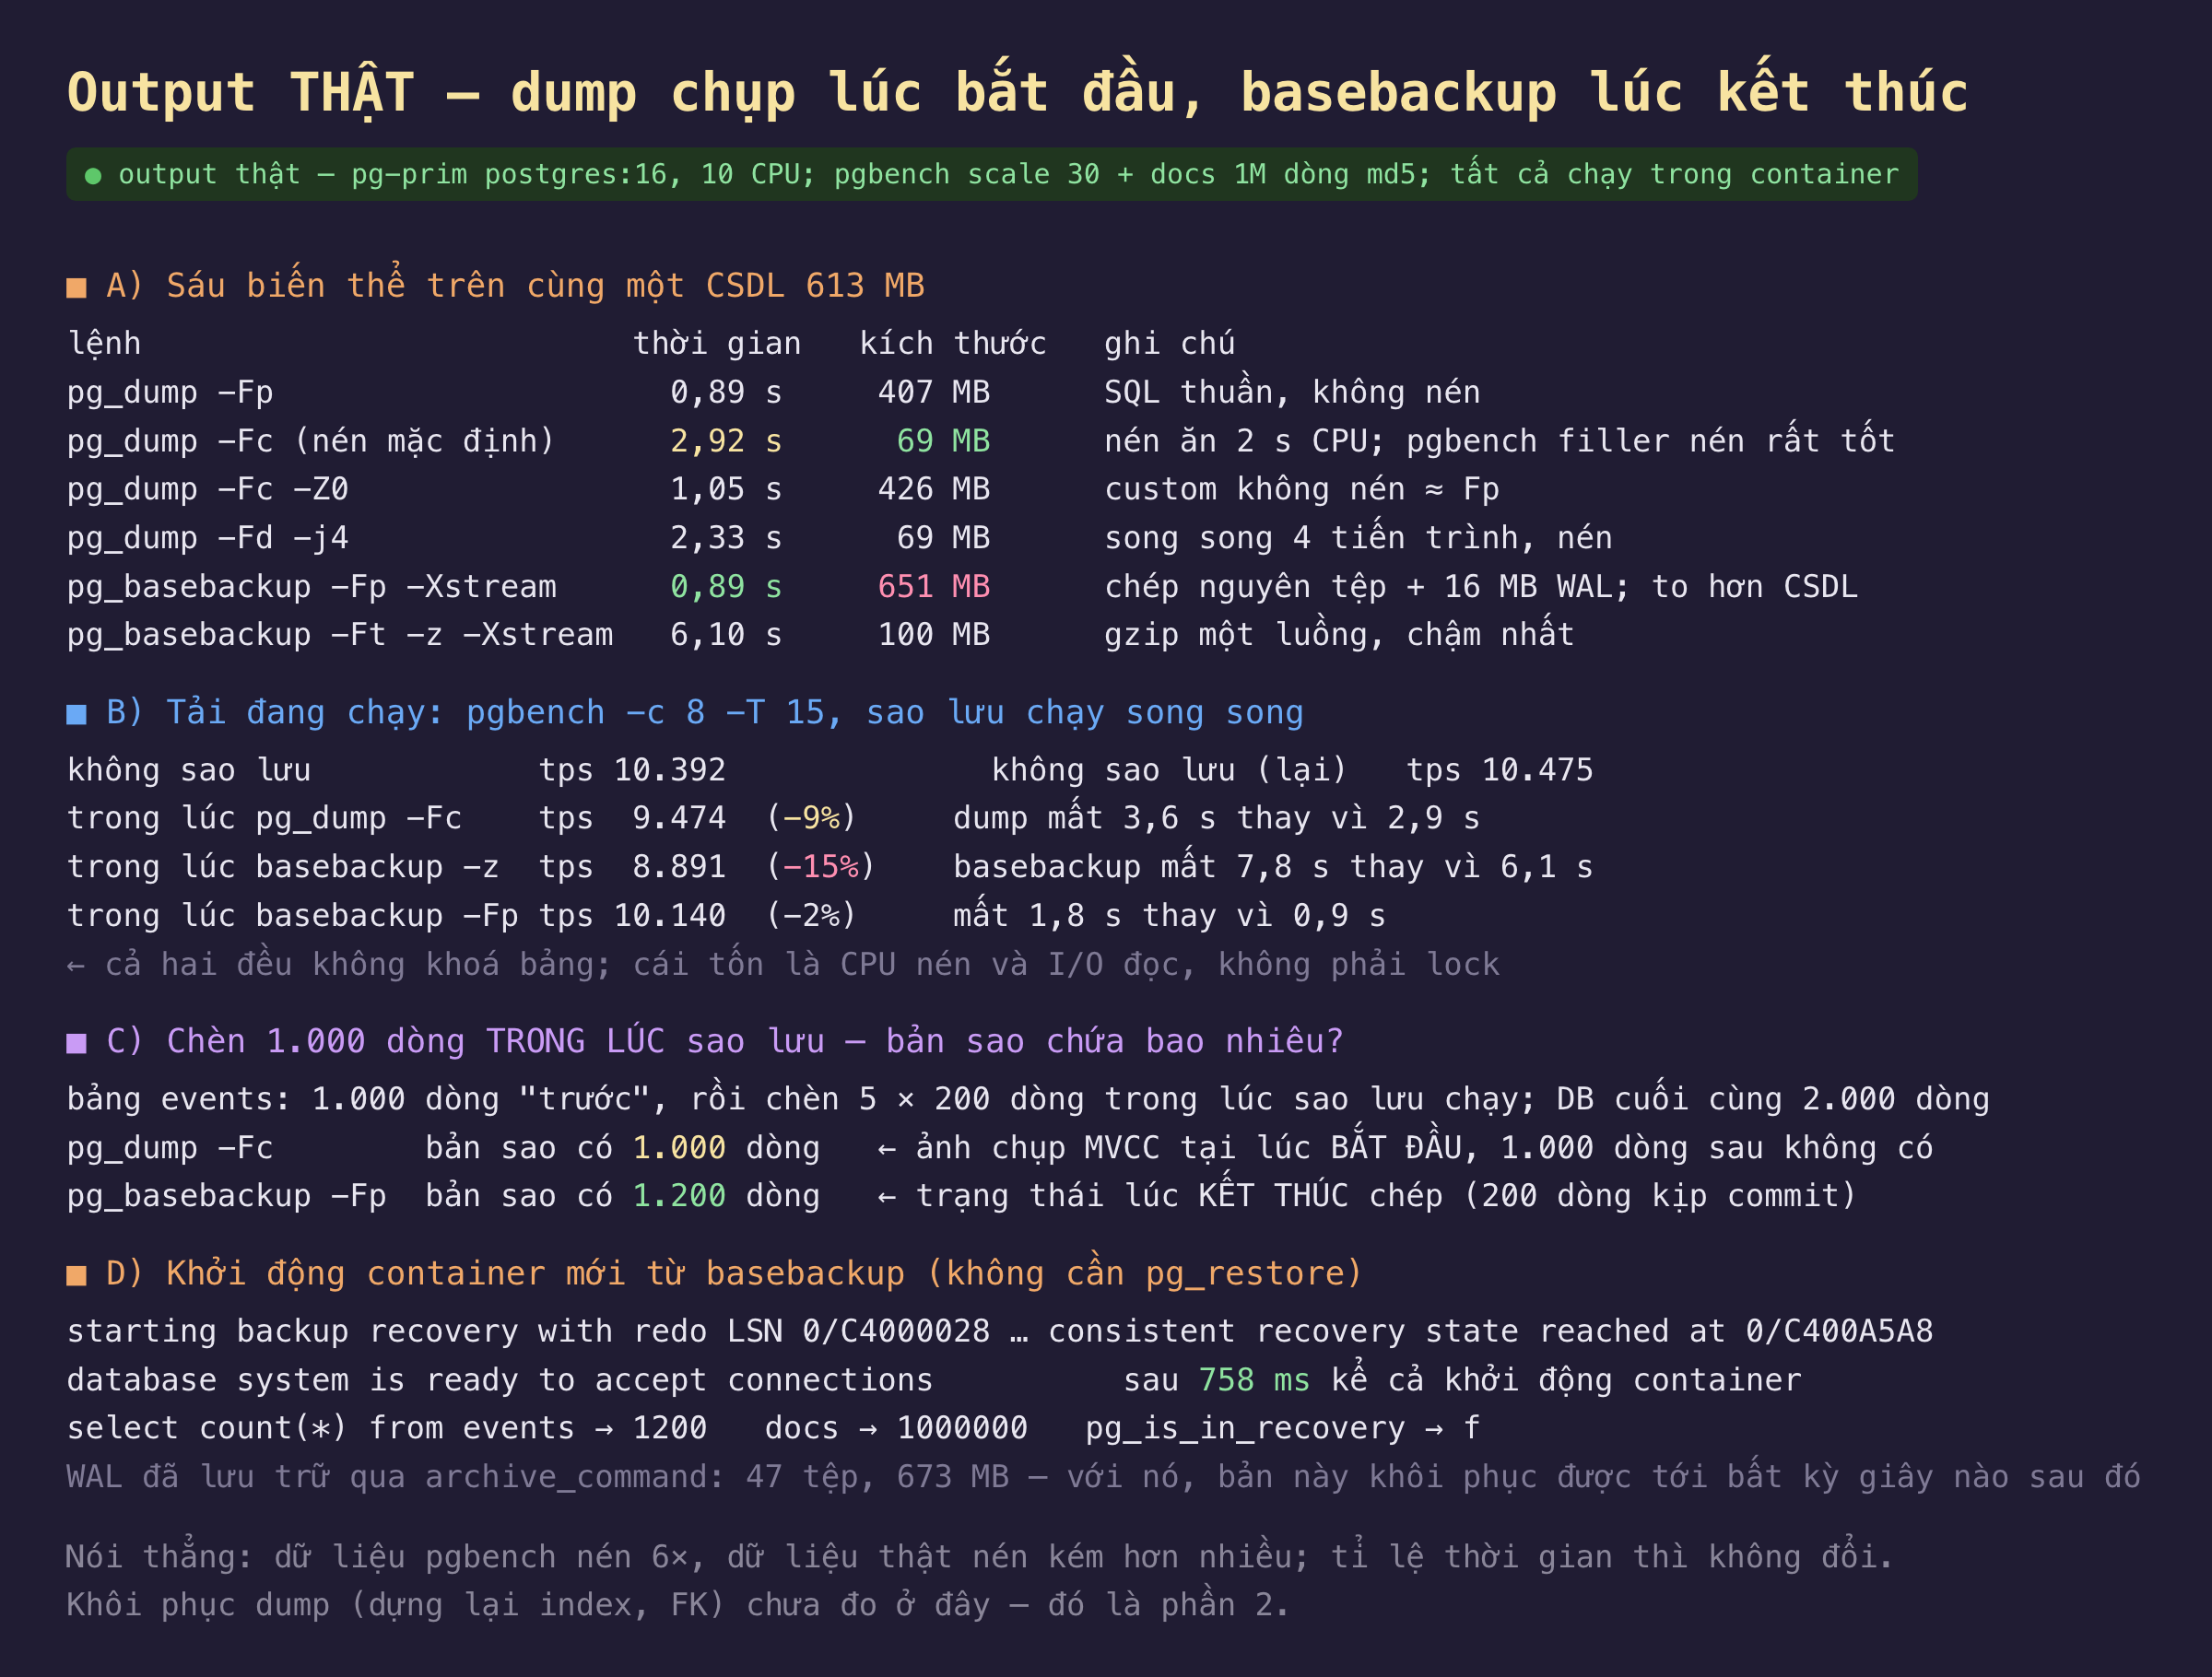
Hình 2: Cùng 613 MB, sáu bản sao từ 69 MB tới 651 MB; dưới tải TPS giảm 2% đến 15%; dump giữ 1.000 dòng, basebackup giữ 1.200.
| biến thể | thời gian | kích thước | TPS dưới tải |
|---|---|---|---|
pg_dump -Fp |
0,89 s | 407 MB | — |
pg_dump -Fc (nén) |
2,92 s | 69 MB | 9.474 (−9%) |
pg_dump -Fc -Z0 |
1,05 s | 426 MB | — |
pg_dump -Fd -j4 |
2,33 s | 69 MB | — |
pg_basebackup -Fp |
0,89 s | 651 MB | 10.140 (−2%) |
pg_basebackup -Ft -z |
6,10 s | 100 MB | 8.891 (−15%) |
| không sao lưu | 10.392 / 10.475 |
Nén là phần đắt, không phải đọc. Dump SQL thuần và basebackup thư mục cùng mất 0,89 giây cho 613 MB — đọc đĩa và chép là chuyện rẻ. Bật nén, dump lên 2,92 giây và basebackup gzip lên 6,10 giây: hai đến sáu giây CPU để đổi 400–650 MB lấy 69–100 MB. -Fd -j4 lấy lại một phần bằng cách nén trên bốn tiến trình (2,33 giây), còn pg_basebackup -z nén một luồng nên chậm nhất. Với CSDL lớn gấp trăm lần, con số này là phút và giờ; chọn nén ở đâu (trong pg_dump, ngoài bằng zstd -T, hay không nén rồi để hệ tệp lo) là quyết định có đo được, không phải mặc định.
Dữ liệu pgbench nén 6 lần, và đó là cảnh báo. Cột filler của pgbench toàn khoảng trắng, nên 449 MB thành vài MB. Bảng docs md5 ngẫu nhiên mới là đại diện cho dữ liệu thật: 156 MB gần như không nén. Kích thước 69 MB ở đây là kết quả của dữ liệu giả; tỉ lệ thời gian và mọi kết luận khác thì không phụ thuộc vào đó.
Không lệnh nào khoá bảng; cái mất là CPU và I/O. pgbench 8 client chạy 10.392 TPS khi yên; trong lúc dump nén còn 9.474 (−9%), basebackup gzip còn 8.891 (−15%), basebackup không nén 10.140 (−2%). Không có truy vấn nào bị chặn — pg_dump chỉ giữ ACCESS SHARE, basebackup không giữ khoá nào — chỉ có tranh CPU với tiến trình nén và tranh đĩa với tiến trình đọc. Đổi lại, sao lưu chạy chậm hơn dưới tải: dump 3,6 giây thay vì 2,9, basebackup gzip 7,8 thay vì 6,1. Trên máy chủ thật có pg_dump lúc 2 giờ sáng là vì CPU, không phải vì lock.
Dump chụp lúc bắt đầu, basebackup nhất quán lúc kết thúc. Thí nghiệm C: bảng events có 1.000 dòng, chèn thêm 5 × 200 dòng trong lúc sao lưu chạy, kết thúc với 2.000 dòng. Bản dump khôi phục ra đúng 1.000 — ảnh chụp MVCC tại thời điểm pg_dump mở giao dịch, 1.000 dòng sau không tồn tại với nó. Bản basebackup khởi động lên có 1.200 — 200 dòng kịp commit trước khi chép xong được WAL replay mang vào, 800 dòng sau điểm kết thúc thì không. Hai con số này là định nghĩa thực dụng của "logic" và "vật lý": dump trả lời "lúc bắt đầu có gì", basebackup trả lời "lúc kết thúc có gì" và, kèm WAL lưu trữ, "lúc bất kỳ có gì".
Khôi phục basebackup là khởi động, không phải nhập lại. Container mới chạy trên thư mục basebackup: starting backup recovery … consistent recovery state reached … ready to accept connections sau 758 ms, kể cả thời gian khởi động container, với đủ một triệu dòng docs. Không có CREATE INDEX, không dựng lại khoá ngoại, không COPY — tệp đã là tệp. Khôi phục dump thì ngược lại: phải chạy lại mọi COPY và dựng lại mọi index, và đó là thứ phần 2 đo.
Đánh đổi cần cân nhắc
Dump nhỏ, di động, chọn lọc được; basebackup to, gắn với phiên bản và kiến trúc. Dump 69 MB khôi phục được vào PostgreSQL 17 trên máy khác, hoặc chỉ một bảng. Basebackup 651 MB chỉ khởi động được trên cùng phiên bản lớn, cùng kiến trúc CPU, cùng bố cục tablespace — nhưng nó là thứ duy nhất khôi phục được "về 10:47:12" thay vì "về lúc cron chạy".
Basebackup lớn hơn chính CSDL. 651 MB cho CSDL 613 MB: cộng WAL stream và tệp trống chưa bị VACUUM thu hồi. Nén gzip đưa về 100 MB nhưng tốn 6 giây đơn luồng; PostgreSQL 15+ có --compress=zstd song song, không đo ở đây.
Phạm vi đo. 613 MB trên SSD cùng máy, không có mạng giữa máy chủ và nơi lưu; CSDL thật đi qua mạng và đĩa chậm hơn sẽ dịch mọi con số, nhưng không đổi thứ tự. Khôi phục dump, kiểm tra tính toàn vẹn (pg_verifybackup), và tự động hoá đều chưa chạm — phần 2 và phần 4.
Ba ý mang về
- Hai lệnh trả lời hai câu khác nhau: dump là ảnh chụp lúc bắt đầu (1.000/2.000 dòng), basebackup là trạng thái lúc kết thúc (1.200) và kèm WAL lưu trữ là bất kỳ lúc nào. Chọn theo câu hỏi "khôi phục về khi nào", không theo kích thước tệp.
- Đọc rẻ, nén đắt: 0,89 giây cho cả 613 MB dù dump hay basebackup; nén thêm 2–6 giây CPU và chính CPU đó làm TPS giảm 9–15%. Không lệnh nào khoá bảng.
- Khôi phục vật lý là khởi động (758 ms), khôi phục logic là nhập lại — và kích thước 69 MB của dump đến từ dữ liệu pgbench nén 6 lần, đừng đem con số đó đi ước lượng cho dữ liệu thật.
Nguồn
- PostgreSQL 16 — Backup and Restore (chương 26): https://www.postgresql.org/docs/16/backup.html
- PostgreSQL 16 — pg_dump: https://www.postgresql.org/docs/16/app-pgdump.html
- PostgreSQL 16 — pg_basebackup: https://www.postgresql.org/docs/16/app-pgbasebackup.html
- PostgreSQL 16 — Continuous Archiving and Point-in-Time Recovery: https://www.postgresql.org/docs/16/continuous-archiving.html
- PostgreSQL 16 — pgbench: https://www.postgresql.org/docs/16/pgbench.html
Phần sau khôi phục bản dump 69 MB này và đo thứ không nằm trong kích thước tệp: thứ tự dựng lại, pg_restore -j song song giúp được bao nhiêu, khi nào index và khoá ngoại được dựng, và những thứ dump không mang theo.
