Phần 1 đo xong việc tạo bản dump: 75 MB, vài giây. Bản dump nằm đó rất yên tâm cho tới ngày phải dùng, và lúc đó câu hỏi không còn là "tệp bao nhiêu MB" mà là "bao lâu thì có lại cơ sở dữ liệu, và nó có giống cái cũ không". Phần này khôi phục bản dump đó vào cơ sở dữ liệu trống và đo từng khúc: thời gian đi đâu, -j giúp được bao nhiêu và khi nào, và những thứ bản dump không mang theo — mỗi thứ một bằng chứng cụ thể.
Ba section, song song theo bảng, và phần thiếu
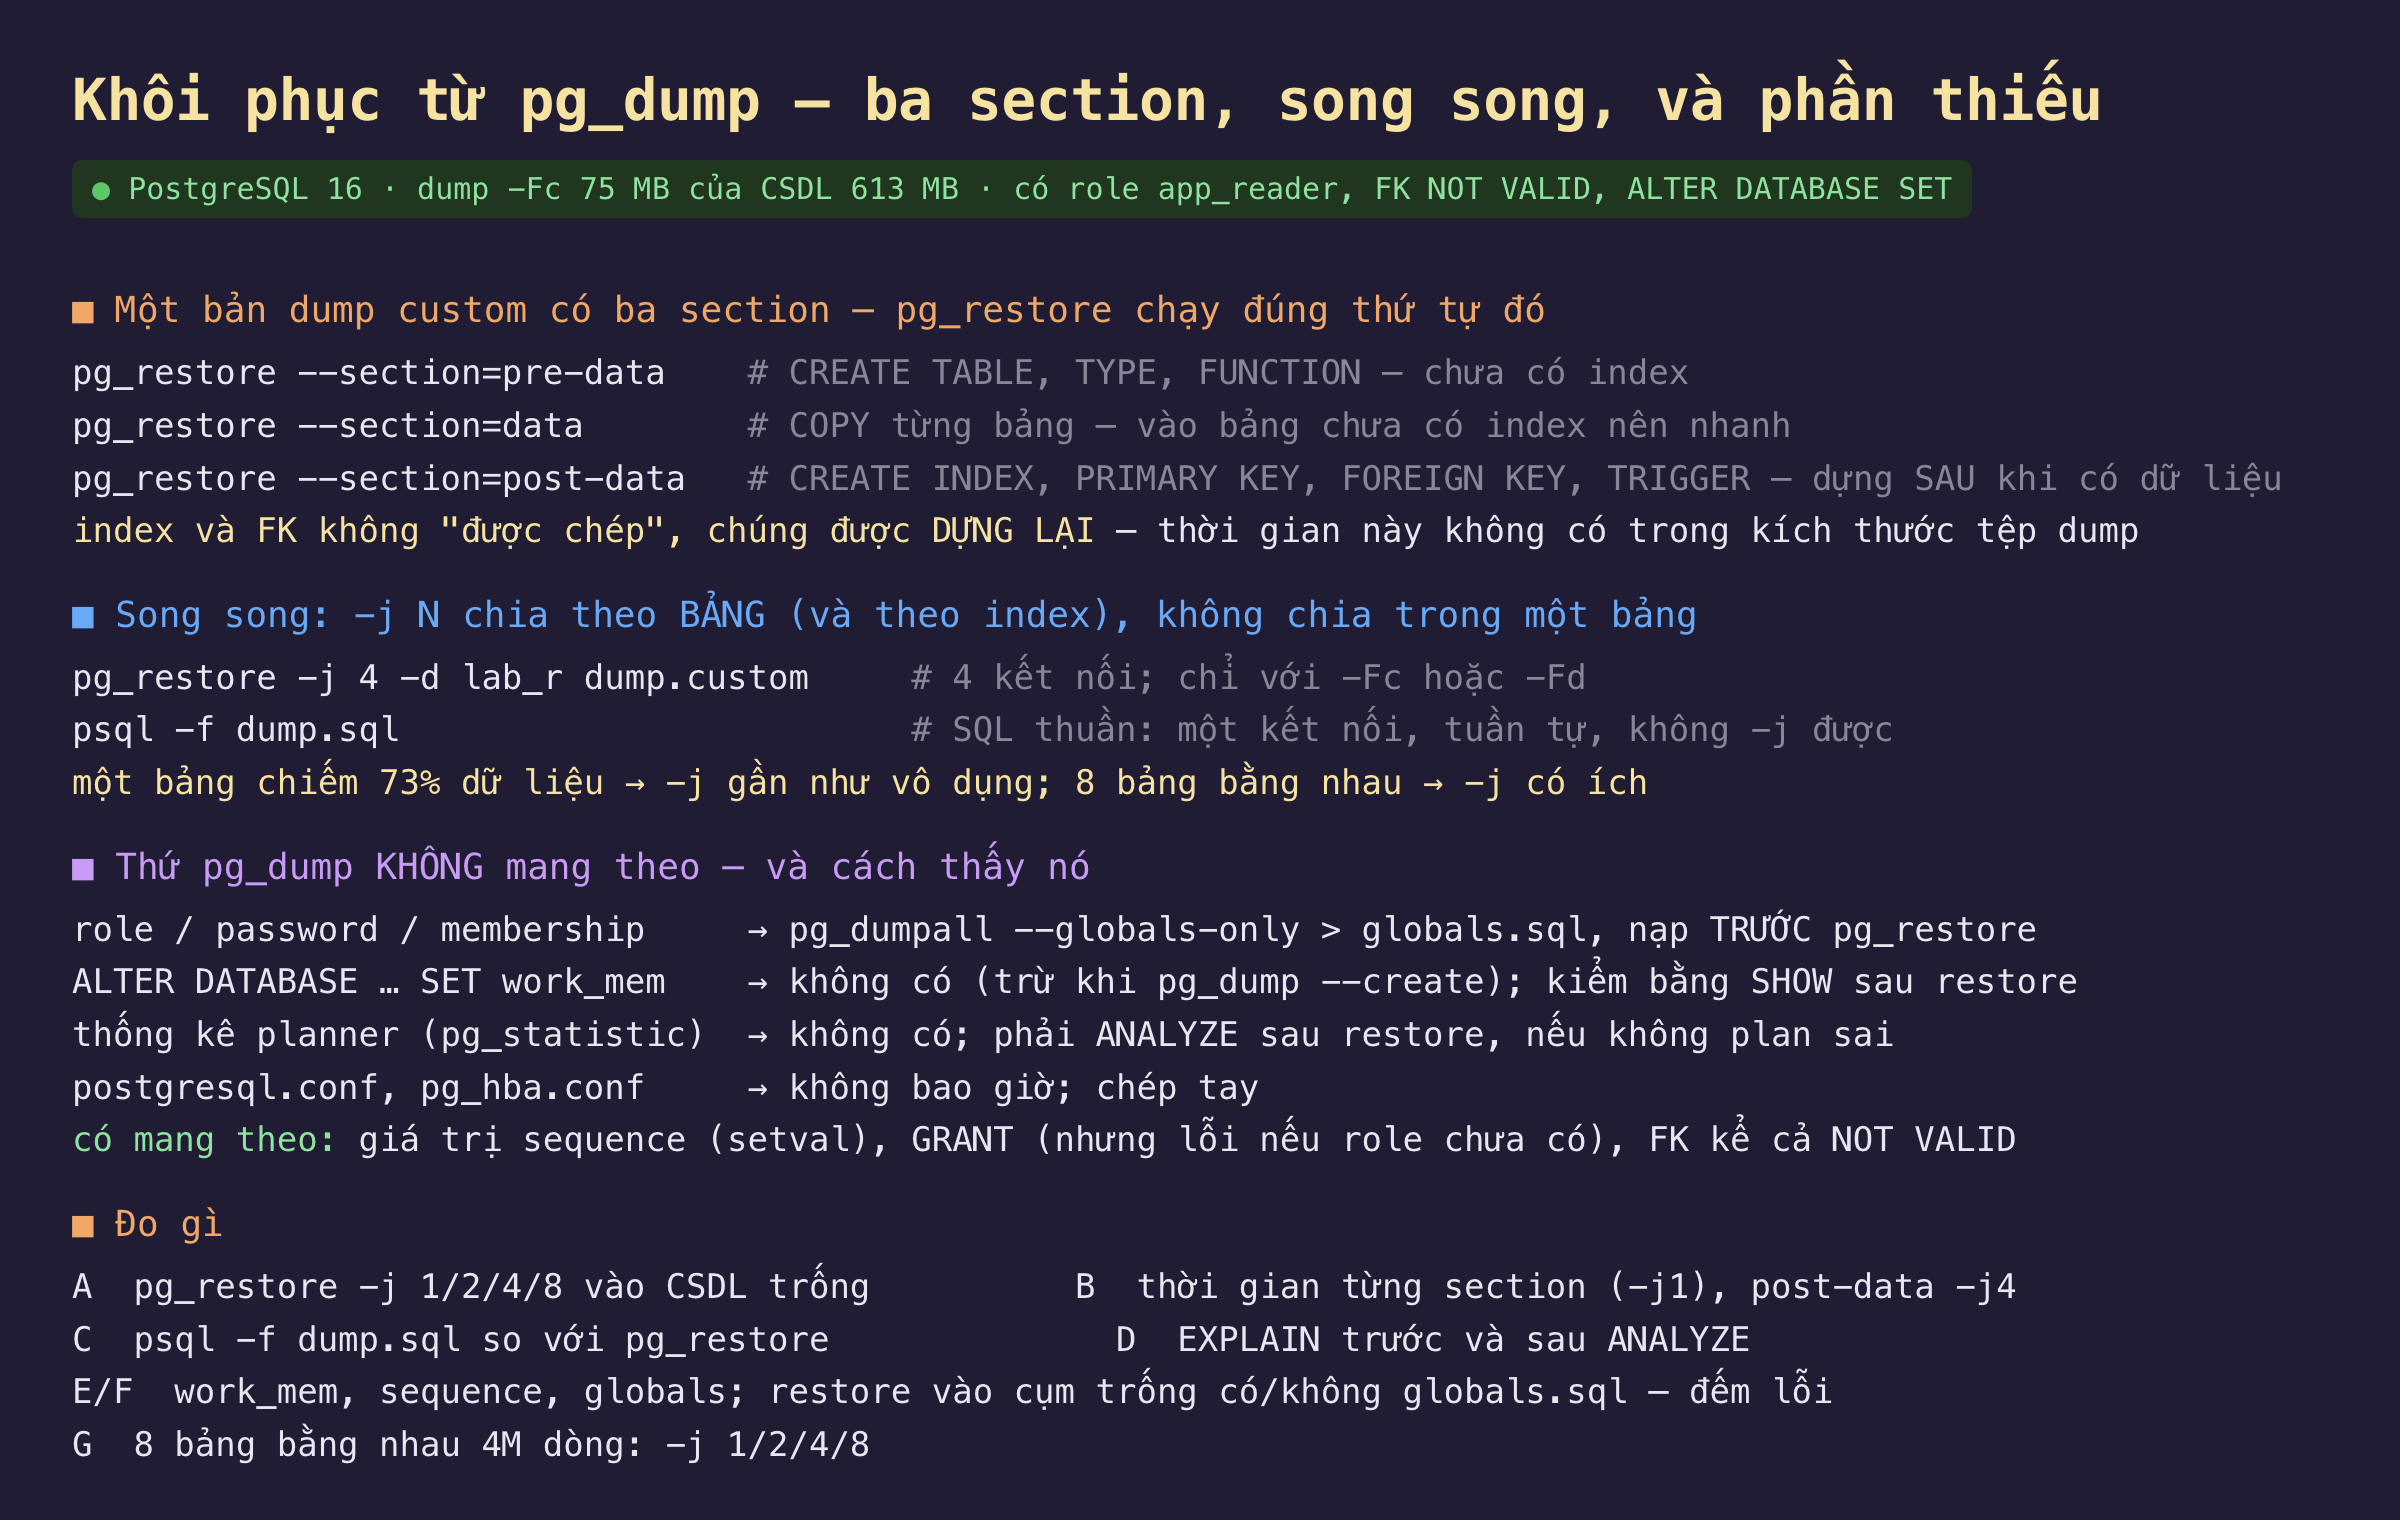
Hình 1: Bản dump custom có ba section và pg_restore dựng lại index sau khi nạp dữ liệu. Song song chia theo bảng, không chia trong một bảng.
Một bản dump định dạng custom không phải một khối: nó có ba section và pg_restore chạy đúng thứ tự đó. pre-data tạo bảng, kiểu, hàm — chưa có index. data là COPY từng bảng, vào bảng còn trống index nên nhanh nhất có thể. post-data dựng index, khoá chính, khoá ngoại, trigger — sau khi dữ liệu đã nằm trong bảng. Điểm quan trọng: index và khoá ngoại không được chép, chúng được dựng lại từ đầu, và thời gian đó không có mặt trong kích thước tệp dump.
Song song với -j N mở N kết nối và chia việc theo bảng (và theo từng index ở post-data); một bảng không bao giờ được chia nhỏ. Định dạng SQL thuần (-Fp) không có khái niệm section tách rời hay -j: psql -f chạy một kết nối, tuần tự từ đầu tới cuối.
Những thứ pg_dump không mang theo: role và mật khẩu (thuộc cụm, không thuộc database), ALTER DATABASE … SET, thống kê planner, và mọi tệp cấu hình. Thứ nó có mang: giá trị hiện tại của sequence, GRANT (nhưng chỉ chạy được nếu role đã tồn tại), và khoá ngoại kể cả trạng thái NOT VALID.
Dữ liệu đo: bản dump của CSDL 613 MB từ phần 1, thêm role app_reader có GRANT SELECT, một khoá ngoại NOT VALID, và ALTER DATABASE lab SET work_mem = '32MB' để có thứ mà kiểm.
Đo thật
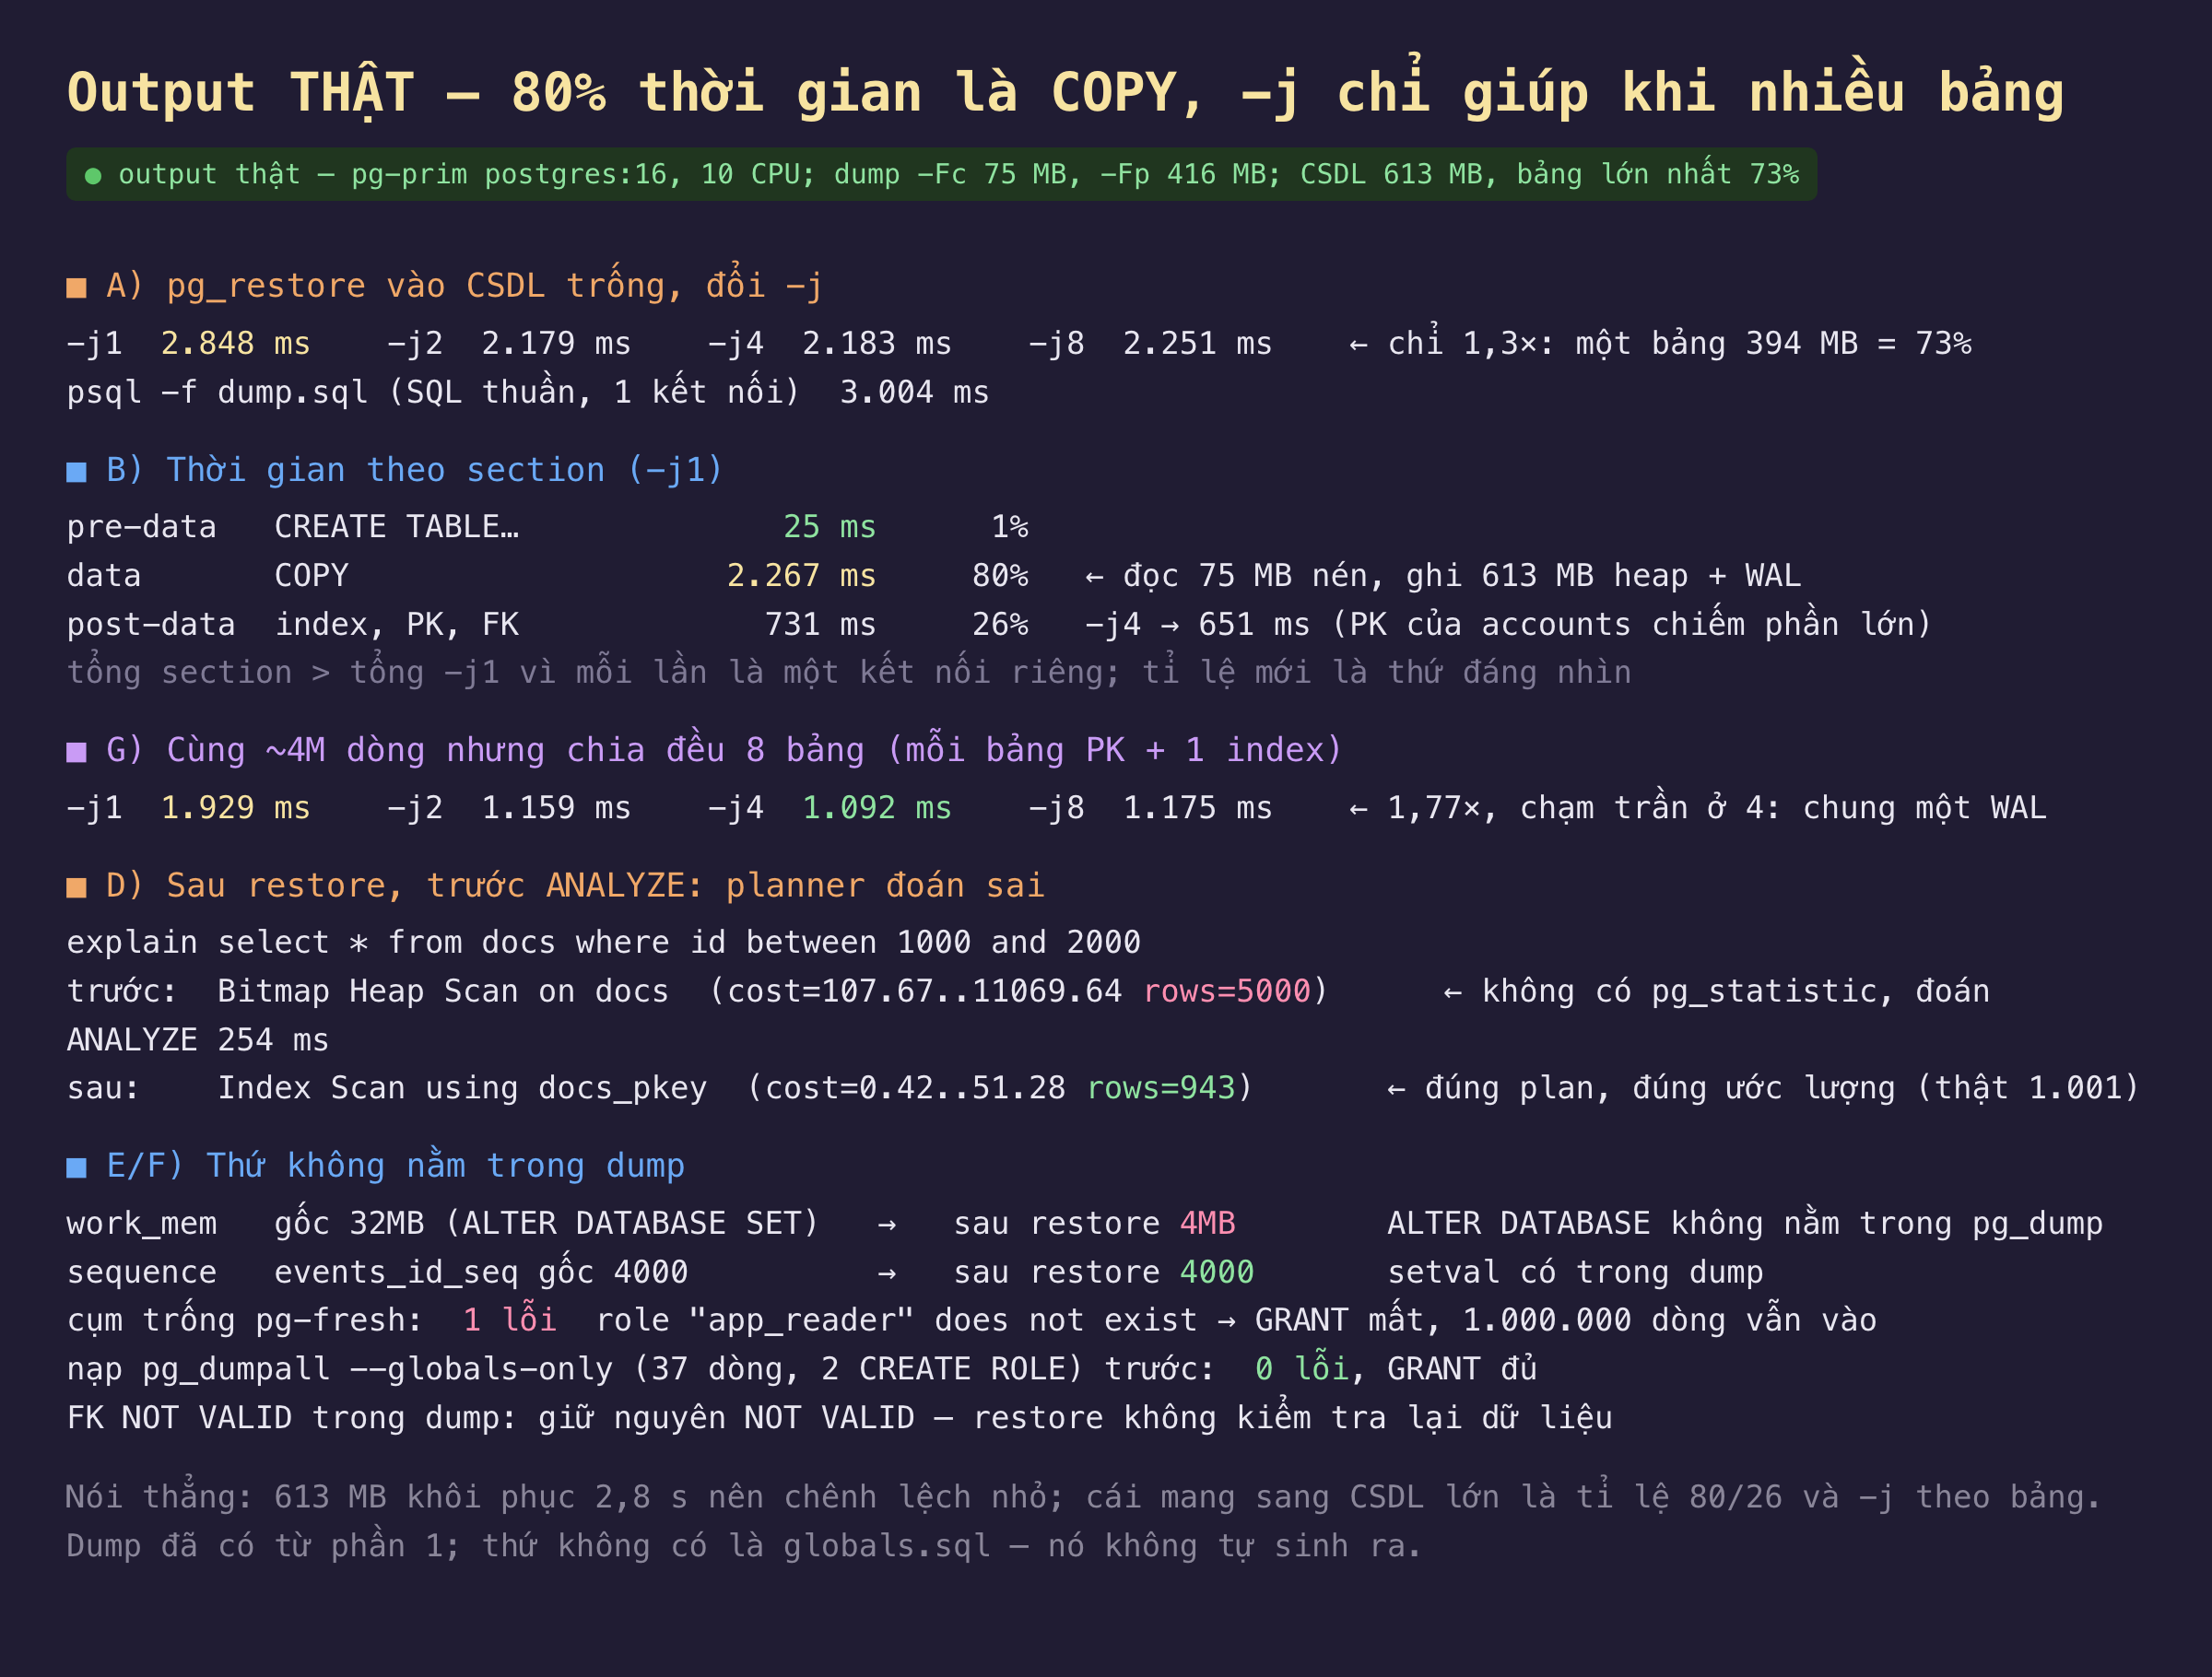
Hình 2: COPY chiếm 80%, dựng index 26%; -j chỉ giúp khi dữ liệu chia đều nhiều bảng; planner đoán sai cho tới khi ANALYZE; thiếu role là một lỗi.
| phép đo | kết quả |
|---|---|
pg_restore -j1 / -j2 / -j4 / -j8 (CSDL 613 MB, bảng lớn nhất 73%) |
2.848 / 2.179 / 2.183 / 2.251 ms |
psql -f dump.sql |
3.004 ms |
| section pre-data / data / post-data | 25 / 2.267 / 731 ms |
post-data -j4 |
651 ms |
8 bảng bằng nhau, -j1 / -j2 / -j4 / -j8 |
1.929 / 1.159 / 1.092 / 1.175 ms |
| EXPLAIN trước / sau ANALYZE (254 ms) | rows=5000 Bitmap Scan / rows=943 Index Scan |
| restore vào cụm trống, không / có globals.sql | 1 lỗi / 0 lỗi |
80% là COPY, 26% là dựng lại, và tỉ lệ đó mới là thứ mang về. pre-data 25 ms — tạo bảng gần như miễn phí. data 2.267 ms — đọc 75 MB nén và ghi 613 MB heap cộng WAL. post-data 731 ms — dựng ba index lớn và khoá ngoại. Hai section sau cộng lại hơn tổng -j1 vì mỗi lần là một kết nối riêng, nên nhìn tỉ lệ chứ đừng cộng: với CSDL lớn gấp trăm, COPY là hàng chục phút và dựng index là hàng phút nữa không có trong kích thước tệp. Đây là lý do "dump 75 MB" không nói gì về RTO.
-j chia theo bảng, nên một bảng 73% là một trần. -j2 xuống 2.179 ms rồi -j4, -j8 không thêm gì — pgbench_accounts chiếm 394 MB trong 613 MB và một kết nối phải nạp hết nó dù có bao nhiêu kết nối khác rỗi. Chia cùng lượng dữ liệu thành tám bảng bằng nhau: -j1 1.929 ms, -j2 1.159, -j4 1.092 — 1,77 lần — rồi -j8 chậm hơn một chút. Trần thứ hai không phải bảng mà là WAL: tám kết nối cùng ghi vào một nhật ký, cùng fsync. Muốn -j có ích thật thì bảng phải chia đều và đĩa WAL phải theo kịp; muốn nhanh hơn nữa là chuyện của wal_level=minimal lúc khôi phục, không đo ở đây.
SQL thuần chậm hơn 5% và không có nút nào để vặn. psql -f dump.sql 3.004 ms so với pg_restore -j1 2.848 ms — gần nhau vì cùng là một kết nối. Khác biệt là -Fp không bao giờ có -j, không chọn được bảng, không tách được section. Dùng -Fp khi cần đọc bằng mắt hoặc grep; mọi lúc khác là -Fc.
Sau restore, planner đoán sai 5 lần cho tới khi ANALYZE. COPY không cập nhật pg_statistic. Truy vấn khoảng id between 1000 and 2000 trên docs một triệu dòng: planner ước lượng 5.000 dòng (không có thống kê, lấy mặc định) và chọn Bitmap Heap Scan; ANALYZE mất 254 ms, sau đó ước lượng 943 (thật 1.001) và chọn Index Scan. Một CSDL vừa khôi phục mà chưa ANALYZE chạy đúng nhưng chạy chậm, và không có lỗi nào để nhìn. pg_restore không làm bước này thay bạn.
Thiếu role là một lỗi — và chỉ một. Khôi phục vào cụm trống pg-fresh: pg_restore báo đúng một lỗi, role "app_reader" does not exist, bỏ qua câu GRANT và vẫn nạp đủ một triệu dòng. Nghĩa là CSDL "khôi phục xong" nhưng ứng dụng dùng app_reader sẽ không đăng nhập được, và pg_restore kết thúc với mã lỗi dễ bị script bỏ qua. Nạp pg_dumpall --globals-only (37 dòng, 2 CREATE ROLE, kèm mật khẩu đã băm SCRAM) trước rồi restore: 0 lỗi, quyền đầy đủ. Tệp globals này không tự sinh ra từ pg_dump; nó là bước riêng trong lịch sao lưu.
work_mem biến mất, sequence ở lại, NOT VALID giữ nguyên. ALTER DATABASE lab SET work_mem = '32MB' không có trong dump: CSDL khôi phục chạy 4MB mặc định — truy vấn nào từng nhờ 32MB mà sort trong RAM giờ tràn ra đĩa, lặng lẽ. Sequence events_id_seq khôi phục đúng 4000 nhờ setval trong dump — không có chuyện INSERT đầu tiên trùng khoá. Khoá ngoại NOT VALID được dựng lại nguyên trạng NOT VALID: pg_restore không kiểm tra lại dữ liệu cũ, cũng không tự VALIDATE.
Đánh đổi cần cân nhắc
Khôi phục logic trả giá bằng thời gian dựng lại, đổi lấy tự do. 2,85 giây cho 613 MB, so với 758 ms khởi động từ basebackup ở phần 1 — gấp gần bốn lần, và tỉ lệ này tăng theo số index. Đổi lại, dump khôi phục được sang phiên bản khác, chỉ một bảng, hoặc một schema sạch không mang theo bloat. Chọn theo câu hỏi: "cần lại đúng cụm này nhanh nhất" là basebackup; "cần dữ liệu ở chỗ khác" là dump.
-j không phải nút tăng tốc chung. Nó giúp khi dữ liệu chia đều nhiều bảng và đĩa WAL còn dư; với một bảng lớn thống trị, -j8 chỉ tốn thêm kết nối. Đo trên chính CSDL của bạn với --section=data để biết bảng nào chiếm bao nhiêu trước khi tin vào một con số từ bài này.
Phạm vi đo. CSDL 613 MB trên SSD cùng máy, mọi thời gian dưới ba giây nên sai số vài phần trăm; chỉ tỉ lệ và các hiện tượng (role, work_mem, ANALYZE, NOT VALID) là thứ mang sang CSDL lớn. Chưa đo: --data-only vào bảng có sẵn index (chậm hơn nhiều), --disable-triggers, và khôi phục chọn lọc bằng -L.
Ba ý mang về
- Kích thước dump không nói gì về thời gian khôi phục: 75 MB thành 613 MB heap qua COPY (80%) rồi dựng lại mọi index và khoá ngoại (26%) — hai khúc đó mới là RTO, và chúng tỉ lệ với dữ liệu lẫn số index.
-jchia theo bảng, chạm trần ở WAL: 1,3 lần khi một bảng chiếm 73%, 1,77 lần với tám bảng đều, không hơn ở-j8. Đo bằng section trên CSDL thật trước khi đặt con số vào runbook.- "Khôi phục xong" còn bốn việc dump không làm: nạp
globals.sqltrước (thiếu role = GRANT mất, 1 lỗi dễ bị bỏ qua), đặt lạiALTER DATABASE SET,ANALYZEngay (planner đoán sai 5 lần), và chép cấu hình bằng tay.
Nguồn
- PostgreSQL 16 — pg_restore: https://www.postgresql.org/docs/16/app-pgrestore.html
- PostgreSQL 16 — pg_dumpall: https://www.postgresql.org/docs/16/app-pg-dumpall.html
- PostgreSQL 16 — Backup and Restore, mục 26.1 SQL Dump: https://www.postgresql.org/docs/16/backup-dump.html
- PostgreSQL 16 — ANALYZE và Planner Statistics: https://www.postgresql.org/docs/16/planner-stats.html
- PostgreSQL 16 — Populating a Database (tối ưu nạp dữ liệu): https://www.postgresql.org/docs/16/populate.html
Phần sau xuống dưới cả hai kiểu sao lưu: WAL. Ghi một dòng sinh bao nhiêu byte nhật ký, vì sao dòng đầu tiên sau checkpoint đắt gấp nhiều lần, và checkpoint_timeout với max_wal_size đổi hình dạng I/O của máy chủ ra sao — đo bằng chính cụm này.
