Hai phần trước nhắc tới WAL như một thứ "kèm theo": basebackup cần nó để nhất quán, PITR cần nó để quay về một giây bất kỳ. Nhưng WAL không phải phụ kiện của sao lưu; nó là cách PostgreSQL ghi mọi thứ, và kích thước của nó, nhịp checkpoint cắt nó, quyết định cả hiệu năng ghi lẫn thời gian phục hồi sau crash. Phần này đo WAL ở ba độ phóng đại: byte cho mỗi dòng theo từng loại lệnh, byte cho một dòng ngay sau checkpoint so với lần hai, và hình dạng TPS từng giây khi đổi ba tham số checkpoint dưới cùng một tải.
Nhật ký trước, dữ liệu sau
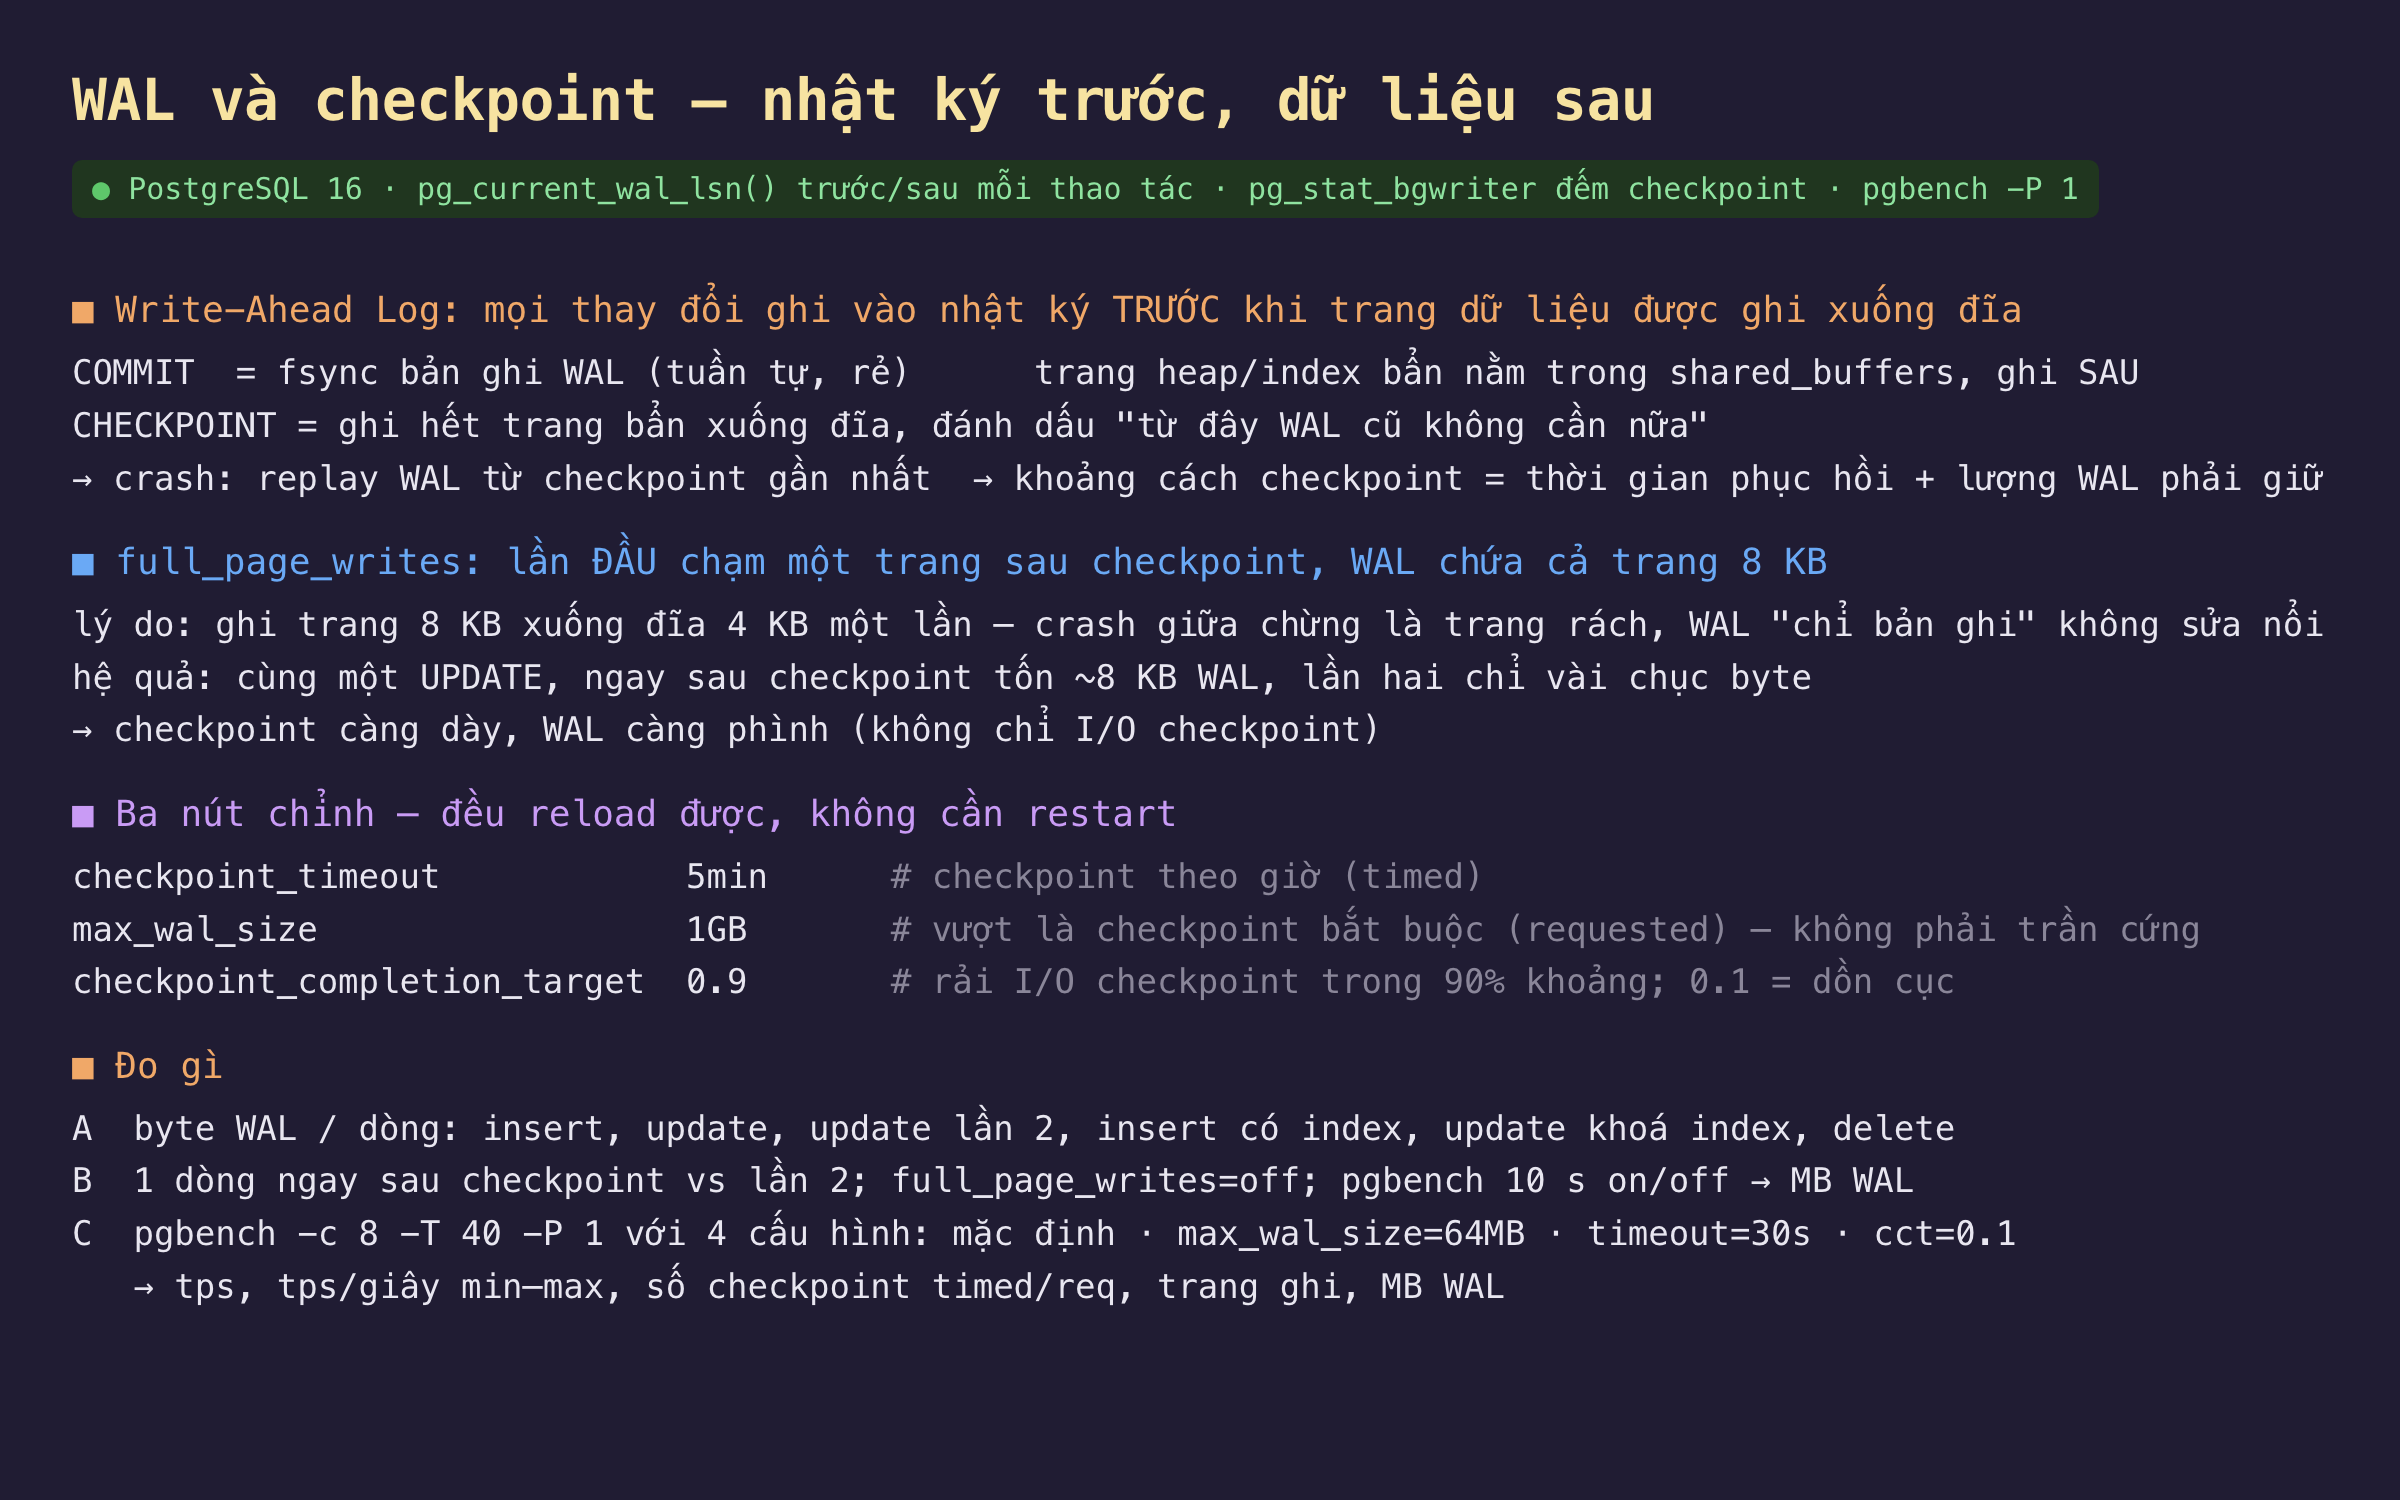
Hình 1: COMMIT chỉ fsync nhật ký; trang dữ liệu bẩn ghi sau, ở checkpoint. Lần đầu chạm một trang sau checkpoint, WAL chụp cả trang.
PostgreSQL không ghi trang dữ liệu khi bạn COMMIT. Nó ghi một bản ghi WAL mô tả thay đổi, fsync tệp nhật ký (ghi tuần tự, rẻ), và để trang heap hay index bẩn nằm trong shared_buffers. Trang bẩn xuống đĩa sau, theo hai đường: checkpoint ghi tất cả trang bẩn và đánh dấu "từ đây trở về trước WAL không cần nữa", hoặc backend tự ghi khi cần chỗ trong shared_buffers. Crash thì replay WAL từ checkpoint gần nhất — nên khoảng cách giữa hai checkpoint là thời gian phục hồi tối đa và lượng WAL phải giữ trong pg_wal.
full_page_writes là chi tiết mà hầu hết người vận hành gặp lần đầu khi thấy WAL phình bất thường. Đĩa ghi theo khối 4 KB, trang PostgreSQL 8 KB; crash giữa hai nửa là một trang rách mà bản ghi WAL "đổi 100 byte ở offset X" không sửa nổi. Nên lần đầu tiên một trang bị chạm sau checkpoint, WAL chứa nguyên ảnh trang; những lần sau trong cùng khoảng checkpoint chỉ ghi bản ghi nhỏ. Hệ quả: checkpoint càng dày thì không chỉ I/O checkpoint tăng mà WAL cũng phình, vì "lần đầu chạm" xảy ra thường xuyên hơn.
Ba tham số điều khiển nhịp checkpoint đều đổi được bằng ALTER SYSTEM cộng pg_reload_conf(): checkpoint_timeout (tối thiểu 30 giây), max_wal_size (vượt là checkpoint bắt buộc — một mục tiêu mềm, không phải trần cứng), và checkpoint_completion_target (rải I/O của checkpoint trong bao nhiêu phần khoảng thời gian).
Đo thật ở ba độ phóng đại
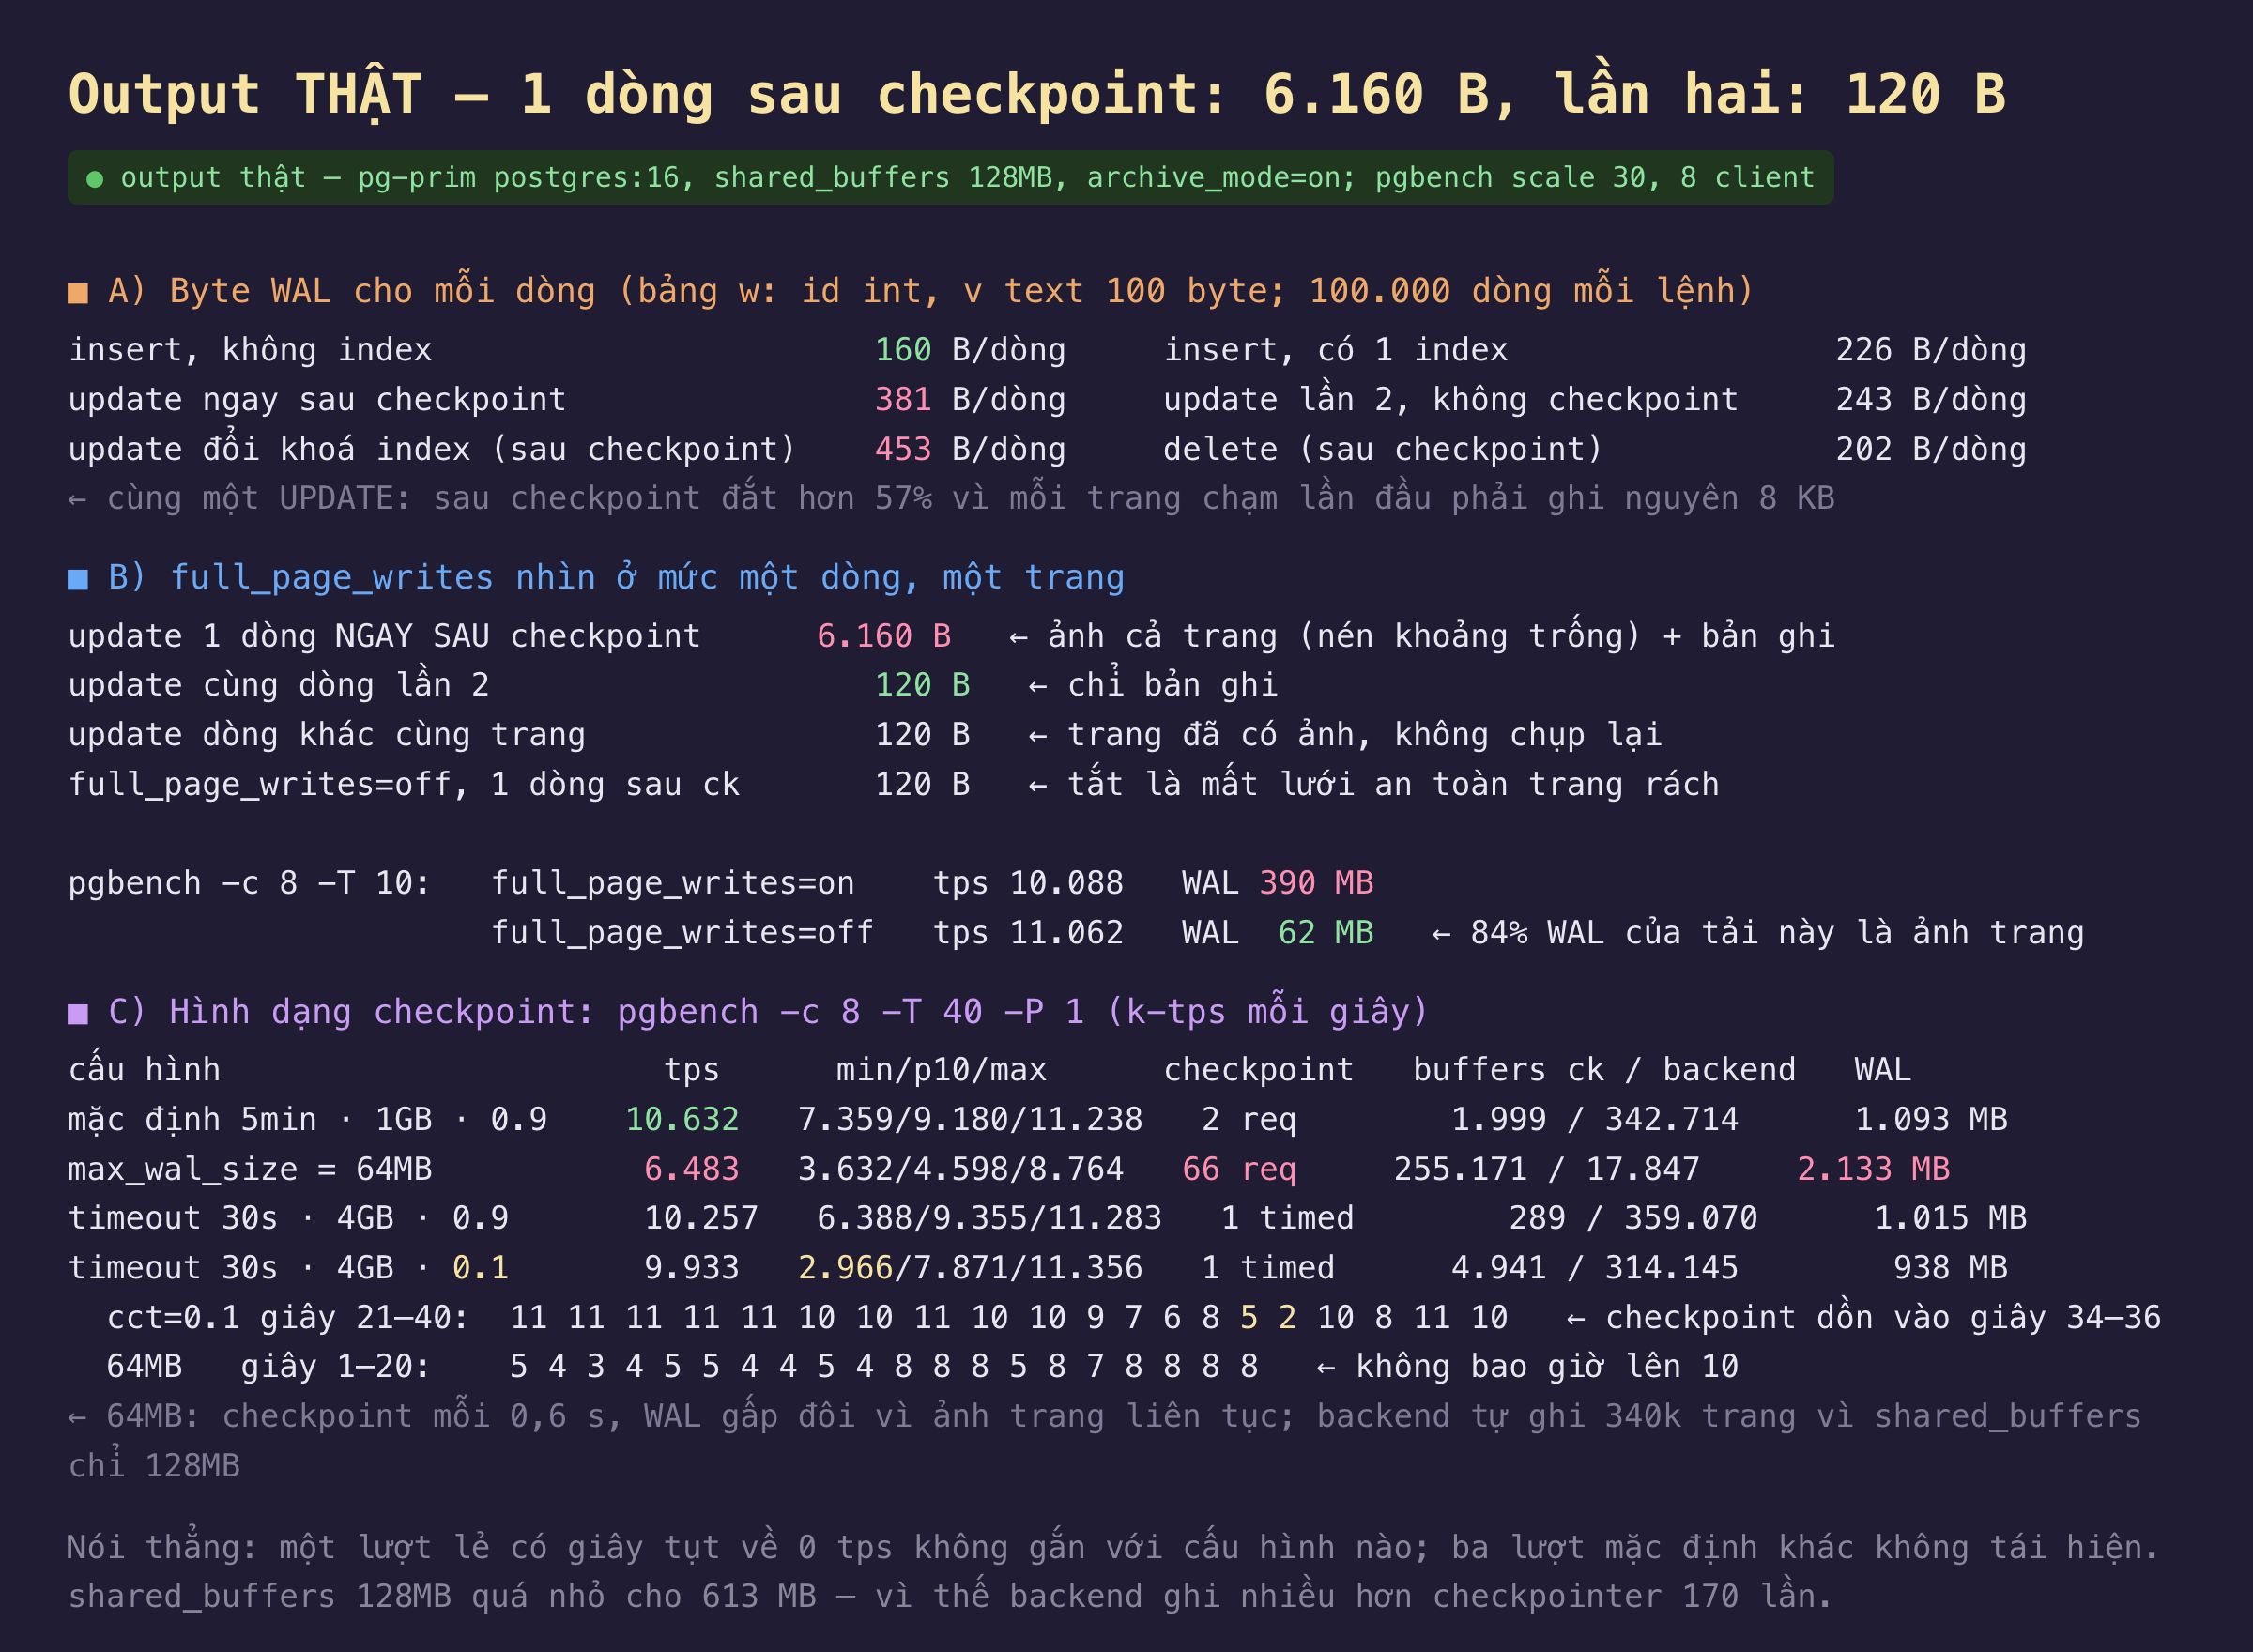
Hình 2: Cùng một UPDATE tốn 6.160 byte hay 120 byte tuỳ có checkpoint vừa xảy ra; 84% WAL của pgbench là ảnh trang; 66 checkpoint trong 40 giây làm TPS giảm 39%.
| phép đo | kết quả |
|---|---|
| insert / insert có index / delete (byte mỗi dòng) | 160 / 226 / 202 |
| update sau checkpoint / lần 2 / đổi khoá index | 381 / 243 / 453 |
| 1 dòng update ngay sau checkpoint / lần 2 / dòng khác cùng trang | 6.160 / 120 / 120 B |
pgbench 10 s, full_page_writes on / off |
390 MB / 62 MB WAL, 10.088 / 11.062 TPS |
| mặc định (5min, 1GB, 0.9) | 10.632 TPS, 2 checkpoint, 1.093 MB WAL |
max_wal_size = 64MB |
6.483 TPS, 66 checkpoint, 2.133 MB WAL |
| timeout 30 s, cct 0.9 / cct 0.1 | 10.257 / 9.933 TPS, giây thấp nhất 6.388 / 2.966 |
Mỗi dòng ghi tốn 160–453 byte nhật ký, và index là phần lớn khoản chênh. Insert 100 byte dữ liệu sinh 160 byte WAL không index, 226 byte với một index B-tree. Update thường 243 byte; update đổi khoá index 453 byte — vì nó là xoá cộng chèn trên index, không phải sửa tại chỗ. Delete 202 byte dù "không mang dữ liệu": bản ghi xoá cộng ảnh trang sau checkpoint. Một bảng có năm index thì mỗi UPDATE đổi cột có index là năm lần phần index này — đó là chi phí thật của "cứ thêm index cho chắc".
Một dòng sau checkpoint: 6.160 byte; cùng dòng đó lần hai: 120 byte. Đây là full_page_writes nhìn ở độ phóng đại cao nhất. Update đầu tiên sau CHECKPOINT ghi nguyên ảnh trang (8 KB nén bớt khoảng trống thành ~6 KB) cộng bản ghi; update thứ hai, hay update dòng khác trên cùng trang, chỉ 120 byte — trang đã có ảnh trong khoảng checkpoint này. Tắt full_page_writes thì 120 byte ngay lần đầu, nhưng tắt là bỏ lưới an toàn cho trang rách; chỉ hợp lệ trên hệ tệp hoặc đĩa đảm bảo ghi nguyên tử 8 KB (ZFS, một số NVMe doanh nghiệp). Ở mức tải: pgbench 10 giây sinh 390 MB WAL với FPW bật và 62 MB khi tắt — 84% WAL của tải này là ảnh trang, vì pgbench chạm ngẫu nhiên hàng chục nghìn trang và mỗi khoảng checkpoint lại chụp chúng từ đầu.
max_wal_size 64 MB: 66 checkpoint trong 40 giây, TPS giảm 39%, WAL gấp đôi. Tải sinh ~25 MB WAL mỗi giây nên 64 MB bị vượt mỗi 0,6 giây, mỗi lần là một checkpoint bắt buộc ghi hết trang bẩn (255.171 trang trong 40 giây). TPS 6.483 so với 10.632, và WAL 2.133 MB so với 1.093 — gấp đôi dù số giao dịch ít hơn, vì mỗi checkpoint làm mọi trang bị chạm sau đó phải chụp ảnh lại. Đây là vòng xoáy kinh điển: max_wal_size nhỏ để "tiết kiệm đĩa" lại sinh gấp đôi WAL. Log của máy chủ có 135 dòng checkpoints are occurring too frequently — nó nói đúng.
completion_target 0.1 không đổi TPS trung bình, nhưng đổi giây tệ nhất. Cùng checkpoint_timeout 30 giây: với 0.9, checkpoint rải I/O trong 27 giây và giây thấp nhất là 6.388; với 0.1, nó dồn vào 3 giây và chuỗi từng giây cho thấy rõ cú tụt … 7 6 8 5 2 10 … — 2.966 TPS ở giây 36, bằng 28% bình thường. Trung bình 9.933 so với 10.257 che hết chuyện này; chỉ -P 1 mới thấy. Người dùng cảm nhận giây tệ nhất, không cảm nhận trung bình.
shared_buffers 128 MB làm backend ghi nhiều hơn checkpointer 170 lần. Ở cấu hình mặc định, checkpointer ghi 1.999 trang còn backend tự ghi 342.714 trang để lấy chỗ trong bộ đệm 128 MB cho CSDL 613 MB. Nghĩa là trên cụm này, hình dạng checkpoint chỉ là một phần của I/O ghi; phần lớn là backend tự đẩy trang bẩn xuống đĩa ngay trên đường đi của giao dịch. Tăng shared_buffers lên 25% RAM là việc làm trước khi chỉnh checkpoint — không có nó, mọi tinh chỉnh ở đây chỉ chạm 1% I/O ghi.
Đánh đổi cần cân nhắc
Checkpoint thưa: ít I/O, ít WAL, nhưng phục hồi lâu và pg_wal to. Mỗi khoảng checkpoint là lượng WAL phải replay sau crash; 5 phút ở 25 MB/giây là 7,5 GB WAL phải giữ trong pg_wal và phải đọc lại khi khởi động. Chọn checkpoint_timeout theo thời gian phục hồi chấp nhận được, rồi đặt max_wal_size đủ lớn để checkpoint không bao giờ bị kích bởi kích thước trong tải bình thường — dòng too frequently trong log là chỉ báo.
Tắt full_page_writes tiết kiệm 84% WAL — và chỉ an toàn khi đĩa hứa ghi nguyên tử. Con số 390 → 62 MB rất hấp dẫn; cái giá là một lần mất điện với trang rách là CSDL hỏng mà không có WAL nào sửa được. Giảm WAL đúng cách là checkpoint thưa hơn, wal_compression = on (nén chính ảnh trang), và bớt index không dùng.
Phạm vi đo. Tải pgbench chạm ngẫu nhiên nên tỉ lệ ảnh trang cao bất thường; tải ghi tuần tự (log, time-series) có FPW nhỏ hơn nhiều. shared_buffers 128 MB mặc định của image Docker làm backend-write lấn át; máy chủ thật với 25% RAM sẽ thấy checkpoint rõ hơn. Một lượt chạy có giây tụt về 0 TPS không gắn với cấu hình nào và không tái hiện trong ba lượt mặc định khác (giây thấp nhất 6.090–8.087) — nhiễu I/O của máy ảo, ghi ra chứ không cắt.
Ba ý mang về
- WAL là giá thật của mỗi lần ghi: 160–453 byte mỗi dòng, index chiếm phần chênh, và lần đầu chạm một trang sau checkpoint là 6.160 byte thay vì 120. Với pgbench, 84% WAL là ảnh trang.
max_wal_sizenhỏ không tiết kiệm gì: 64 MB cho 66 checkpoint trong 40 giây, TPS −39%, WAL ×2. Đặt nó đủ lớn để checkpoint chỉ đến theocheckpoint_timeout, và chọn timeout theo thời gian phục hồi chấp nhận được.- Nhìn từng giây, không nhìn trung bình:
completion_target0.1 giữ nguyên TPS trung bình và tạo cú tụt xuống 2.966. Và trước khi chỉnh checkpoint, kiểmbuffers_backend: ở 128 MBshared_buffers, backend ghi 170 lần nhiều hơn checkpointer.
Nguồn
- PostgreSQL 16 — WAL Configuration (checkpoint, full_page_writes): https://www.postgresql.org/docs/16/wal-configuration.html
- PostgreSQL 16 — Reliability and the Write-Ahead Log: https://www.postgresql.org/docs/16/wal-reliability.html
- PostgreSQL 16 — The Statistics Collector,
pg_stat_bgwriter: https://www.postgresql.org/docs/16/monitoring-stats.html - PostgreSQL 16 — Write Ahead Log tham số (
wal_compression,max_wal_size): https://www.postgresql.org/docs/16/runtime-config-wal.html - Tomas Vondra — On the impact of full-page writes (2ndQuadrant blog): https://www.2ndquadrant.com/en/blog/on-the-impact-of-full-page-writes/
Phần sau dùng chính dòng WAL này cho việc nó sinh ra để làm: khôi phục về một giây trước câu DELETE nhầm. Dựng thật: xoá nhầm một bảng, lấy basebackup cộng WAL lưu trữ, recovery_target_time, và đếm số dòng trước — sau.
