Phần 3 đo WAL như một chi phí. Phần này dùng nó như một cỗ máy thời gian. Tình huống là thứ ai vận hành cơ sở dữ liệu cũng gặp ít nhất một lần: một câu DELETE thiếu WHERE chạy lúc 08:22:48, ứng dụng vẫn ghi tiếp, và mười phút sau có người hỏi "lấy lại được không". Bản dump đêm qua trả lời "được, nhưng mất cả ngày hôm nay". Basebackup cộng WAL lưu trữ trả lời "được, về đúng 08:22:47". Phần này dựng đúng tình huống đó, khôi phục năm lần với năm đích khác nhau, và đếm dòng.
Cỗ máy thời gian: basebackup, kho WAL, và một đích dừng
Hình 1: Basebackup là điểm xuất phát, kho WAL là đường đi, recovery_target là chỗ dừng. Dừng xong thì promote sang timeline mới.
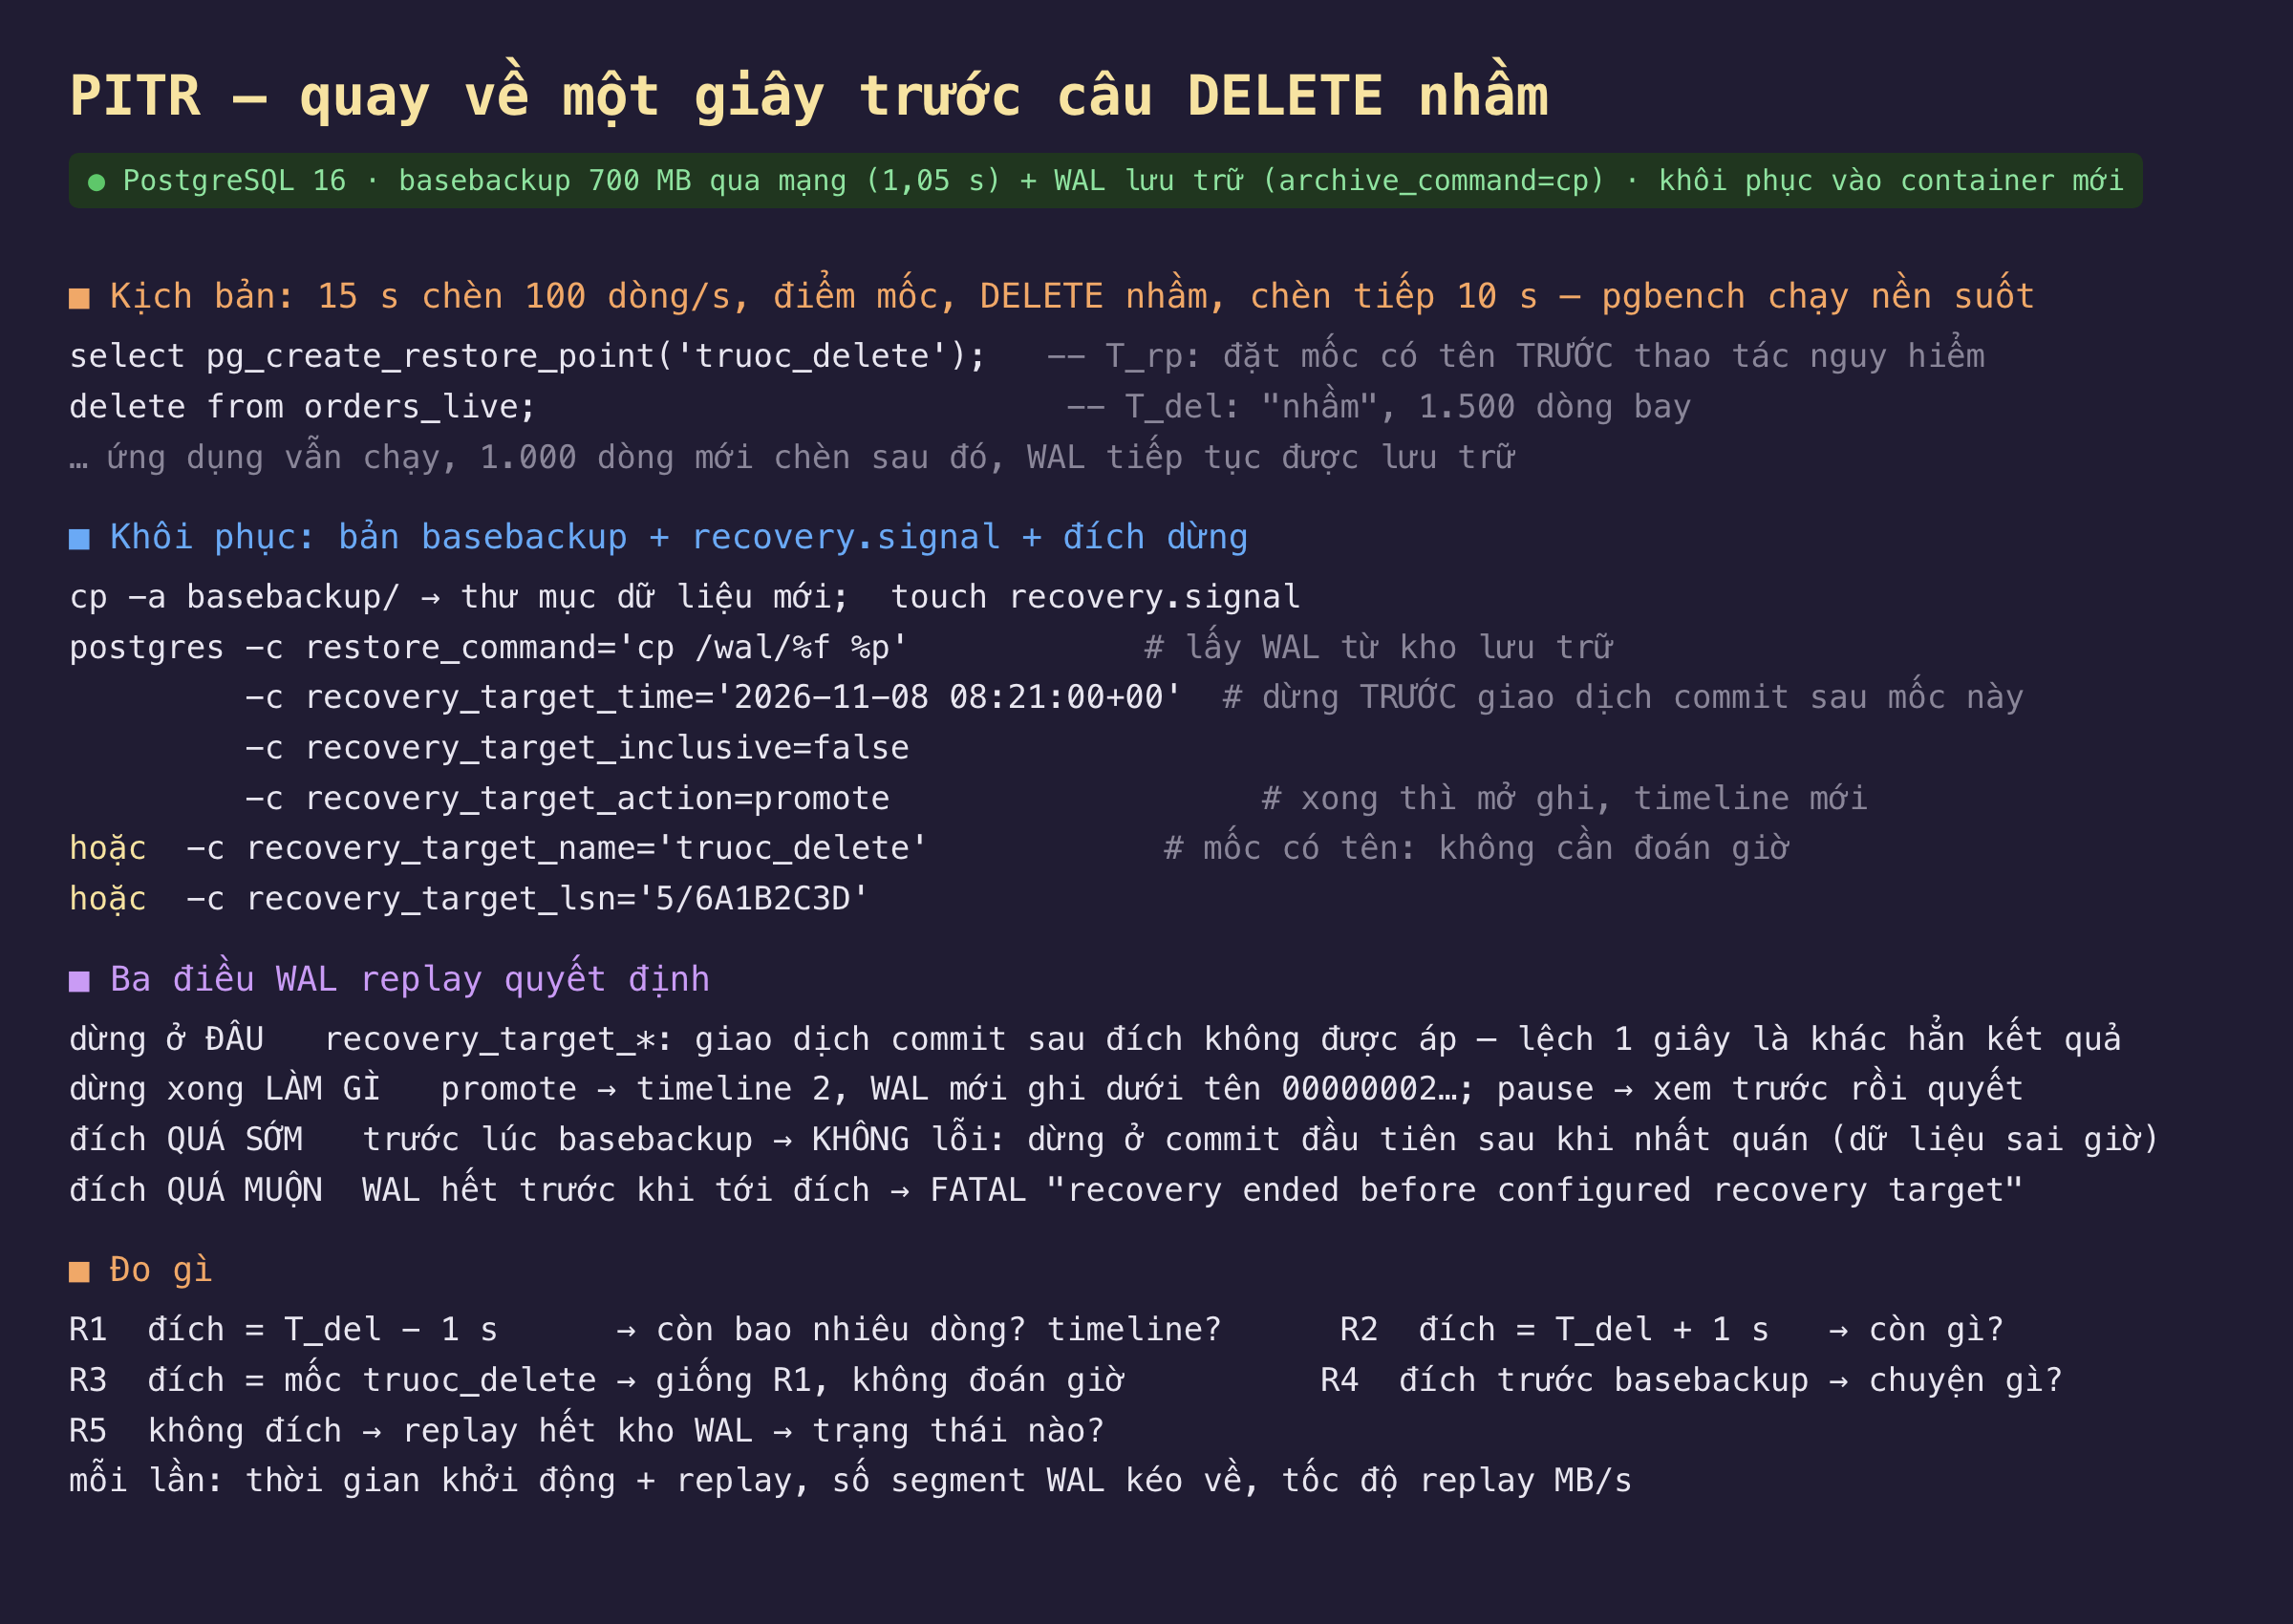
PITR (point-in-time recovery) cần ba thứ. Một basebackup làm điểm xuất phát — phần 1 đã đo: 700 MB chép qua mạng trong 1,05 giây, tự thân chưa nhất quán. Kho WAL liên tục từ lúc basebackup tới hiện tại — archive_command của phần 3 đã đẩy từng segment 16 MB vào /wal. Và một đích dừng: recovery_target_time, recovery_target_name (mốc đặt trước bằng pg_create_restore_point), hoặc recovery_target_lsn.
Quy trình khôi phục: chép basebackup vào thư mục dữ liệu mới, tạo tệp recovery.signal, khai restore_command để máy chủ tự kéo WAL từ kho, và khai đích. Máy chủ replay WAL từ đầu basebackup; khi gặp bản ghi commit có thời điểm sau đích (với recovery_target_inclusive=false), nó dừng, không áp giao dịch đó, và làm theo recovery_target_action: promote mở ghi trên một timeline mới, pause giữ ở chế độ chỉ đọc để bạn kiểm tra trước. Timeline mới là cách PostgreSQL tách lịch sử "đã quay lại" khỏi lịch sử cũ — WAL sinh ra sau promote mang tên 00000002…, không đè lên segment cũ trong kho.
Kịch bản dựng thật: bảng orders_live nhận 100 dòng mỗi giây trong 15 giây, pgbench 4 client chạy nền để WAL có khối lượng thật; lúc 08:22:47,40 đặt mốc truoc_delete; lúc 08:22:48,63 chạy DELETE FROM orders_live — 1.500 dòng bay; rồi chèn tiếp 10 giây nữa, 1.000 dòng mới. Production kết thúc với 1.000 dòng và 50 segment WAL (785 MB) trong kho.
Năm lần khôi phục, năm kết quả

Hình 2: Cùng basebackup, cùng kho WAL; đích lệch một giây cho 1.500 dòng hay 100 dòng. Mốc có tên dừng đúng chỗ. Replay 250–440 MB/s.
| lần | đích | thời gian | segment | kết quả |
|---|---|---|---|---|
| R1 | time = T_del − 1 s | 1.878 ms | 29 | 1.500 dòng, timeline 2 |
| R2 | time = T_del + 1 s | 1.886 ms | 30 | 100 dòng (chỉ dòng chèn sau DELETE) |
| R3 | name = truoc_delete |
2.955 ms | 29 | 1.500 dòng, dừng đúng mốc |
| R4 | time trước basebackup | 538 ms | 2 | không lỗi; dừng ở commit đầu sau khi nhất quán, bảng chưa tồn tại |
| R5 | không đích | 3.763 ms | 48 | 1.000 dòng = production, DELETE vẫn còn |
Một giây trước: đủ 1.500 dòng; một giây sau: 100 dòng. R1 dừng tại recovery stopping before commit of transaction 5054799, time 08:22:47.630039 — giao dịch đầu tiên có commit sau đích — và orders_live có đúng 1.500 dòng, dòng mới nhất lúc 08:22:46. R2 với đích chỉ lệch hai giây sang bên kia câu DELETE: 100 dòng, toàn bộ là dòng chèn sau khi xoá. Cùng một basebackup, cùng kho WAL, cùng lệnh; thứ khác nhau là một con số trên dòng lệnh. Đây là lý do PITR cần biết chính xác lúc nào tai nạn xảy ra — từ log ứng dụng, từ log_statement, hay từ pg_stat_statements — trước khi chạy bất cứ thứ gì.
Mốc có tên bỏ việc đoán giờ. R3 dùng recovery_target_name = 'truoc_delete': dừng tại recovery stopping at restore point "truoc_delete", 1.500 dòng, không cần biết DELETE xảy ra lúc mấy giờ mấy phút mấy giây. pg_create_restore_point tốn một bản ghi WAL và không tốn gì khác; đặt nó trước mỗi migration, mỗi lần chạy script xoá, mỗi lần "chỉ sửa nhanh trên production" — và đích khôi phục có sẵn tên, không phải hẹn giờ.
Đích trước basebackup không báo lỗi — và đó là cái bẫy. R4 nhắm 08:19:00, trước cả lúc basebackup bắt đầu (08:20:11). Không có FATAL. Máy chủ replay tới điểm nhất quán (bắt buộc), gặp commit đầu tiên sau đó lúc 08:22:32, thấy nó muộn hơn đích, dừng và promote. Kết quả là trạng thái lúc kết thúc basebackup: orders_live chưa tồn tại vì bảng được tạo sau đó. Nếu runbook chỉ kiểm "máy chủ lên chưa" thì nó đã lên, trên timeline 2, với dữ liệu của một thời điểm không ai yêu cầu. Muốn về trước basebackup này thì phải dùng basebackup cũ hơn — đó là lý do giữ nhiều hơn một bản.
Không đích thì về đúng hiện tại, kể cả câu DELETE. R5 bỏ recovery_target_*: replay hết 48 segment, promote, 1.000 dòng — y hệt production. Đây không phải PITR, đây là khôi phục sau crash dùng kho WAL; nó trả lời câu "máy chủ cháy" chứ không trả lời câu "xoá nhầm".
Replay 250–440 MB/s, và RTO là phép cộng. R1 kéo 29 segment (464 MB) và redo mất 1,06 giây; R5 kéo 48 segment (768 MB) trong 3,03 giây. Thời gian khôi phục bằng chép basebackup cộng WAL từ basebackup tới đích chia tốc độ replay cộng khởi động. Basebackup càng cũ, đoạn WAL càng dài; với 25 MB/s WAL của tải này, basebackup một ngày tuổi là 2 TB WAL phải replay — hàng giờ. Lịch basebackup vì thế không phải "hằng tuần cho đỡ tốn", mà là hàm của tốc độ sinh WAL và RTO chấp nhận được.
Bẫy khi đo — và khi vận hành. Lần chạy đầu của script đọc số liệu ngay khi pg_isready trả lời, và thấy 500 dòng, in_recovery = true. database system is ready to accept read-only connections xuất hiện lúc máy chủ vừa nhất quán và còn đang replay (hot standby). "Xong" là khi pg_is_in_recovery() trả về false sau promote. Một runbook chờ cổng 5432 mở rồi báo "đã khôi phục" sẽ sai đúng theo cách này.
Đánh đổi cần cân nhắc
PITR đổi dung lượng lấy độ chính xác. Kho WAL của hai mươi phút thí nghiệm là 785 MB; phần 3 đã thấy một tải pgbench sinh 25 MB WAL mỗi giây. Lưu trữ WAL là chi phí liên tục và nó phải liên tục — thiếu một segment là chuỗi đứt, mọi đích sau chỗ đứt đều không tới được. pg_stat_archiver.failed_count khác 0 là chuông báo cấp một.
Promote là một chiều. Sau promote, timeline 2 tách khỏi lịch sử cũ; muốn thử đích khác phải khôi phục lại từ basebackup — như năm lần ở đây, mỗi lần một bản chép. recovery_target_action = pause cho phép nhìn dữ liệu ở chế độ chỉ đọc rồi mới quyết định pg_wal_replay_resume() hay thử lại; với CSDL lớn, pause rẻ hơn rất nhiều so với chép lại 700 GB.
Phạm vi đo. 700 MB và 785 MB WAL trên SSD cùng máy, không có mạng giữa kho WAL và máy khôi phục — restore_command kéo từ S3 qua mạng sẽ chậm hơn redo nhiều lần và trở thành nút cổ chai. Chưa chạm: pg_receivewal thay cho archive_command để không mất segment đang viết dở, và kiểm tra tính toàn vẹn bằng pg_verifybackup.
Ba ý mang về
- Basebackup + WAL liên tục + một đích = về bất kỳ giây nào: lệch một giây là khác biệt giữa 1.500 dòng và 100 dòng, nên đặt
pg_create_restore_pointtrước thao tác nguy hiểm thay vì đoán giờ sau tai nạn. - Hai bẫy im lặng: đích trước basebackup không lỗi mà dừng ở điểm nhất quán với dữ liệu sai thời điểm; và "ready to accept read-only connections" không phải xong — chờ
pg_is_in_recovery() = false. - RTO là phép cộng của chép basebackup và WAL phải replay (250–440 MB/s ở đây): lịch basebackup phải tính từ tốc độ sinh WAL, và
failed_countcủa archiver phải bằng 0 mọi lúc.
Nguồn
- PostgreSQL 16 — Continuous Archiving and Point-in-Time Recovery: https://www.postgresql.org/docs/16/continuous-archiving.html
- PostgreSQL 16 — Recovery Target (recovery_target_time, _name, _lsn, _action): https://www.postgresql.org/docs/16/runtime-config-wal.html#RUNTIME-CONFIG-WAL-RECOVERY-TARGET
- PostgreSQL 16 — Timelines: https://www.postgresql.org/docs/16/continuous-archiving.html#BACKUP-TIMELINES
- PostgreSQL 16 — pg_create_restore_point: https://www.postgresql.org/docs/16/functions-admin.html#FUNCTIONS-ADMIN-BACKUP
- PostgreSQL 16 — pg_receivewal: https://www.postgresql.org/docs/16/app-pgreceivewal.html
Phần sau dùng cùng cơ chế WAL cho mục đích khác: không quay về quá khứ mà theo kịp hiện tại. Dựng một replica từ basebackup, cho nó bám primary qua streaming replication, đo độ trễ bằng byte và bằng giây dưới tải ghi, và xem điều gì xảy ra khi replica tắt một lúc rồi quay lại.
