Phần 4 dùng WAL để quay về quá khứ. Streaming replication dùng cùng dòng WAL đó để một máy chủ thứ hai bám theo hiện tại: primary gửi từng bản ghi ngay khi ghi, replica nhận, ghi, fsync và replay. Nghe như một đường ống đơn giản, và nó đúng là đơn giản — cho tới khi phải trả lời "replica đang trễ bao nhiêu", "nếu nó tắt mười phút thì sao", và "vì sao bảng cảnh báo báo trễ 20 giây lúc nửa đêm không ai ghi gì". Phần này dựng replica thật, đo lag từng giây dưới tải, rồi tắt nó giữa chừng hai lần: một lần có replication slot, một lần không.
Replica bám primary bằng chính WAL
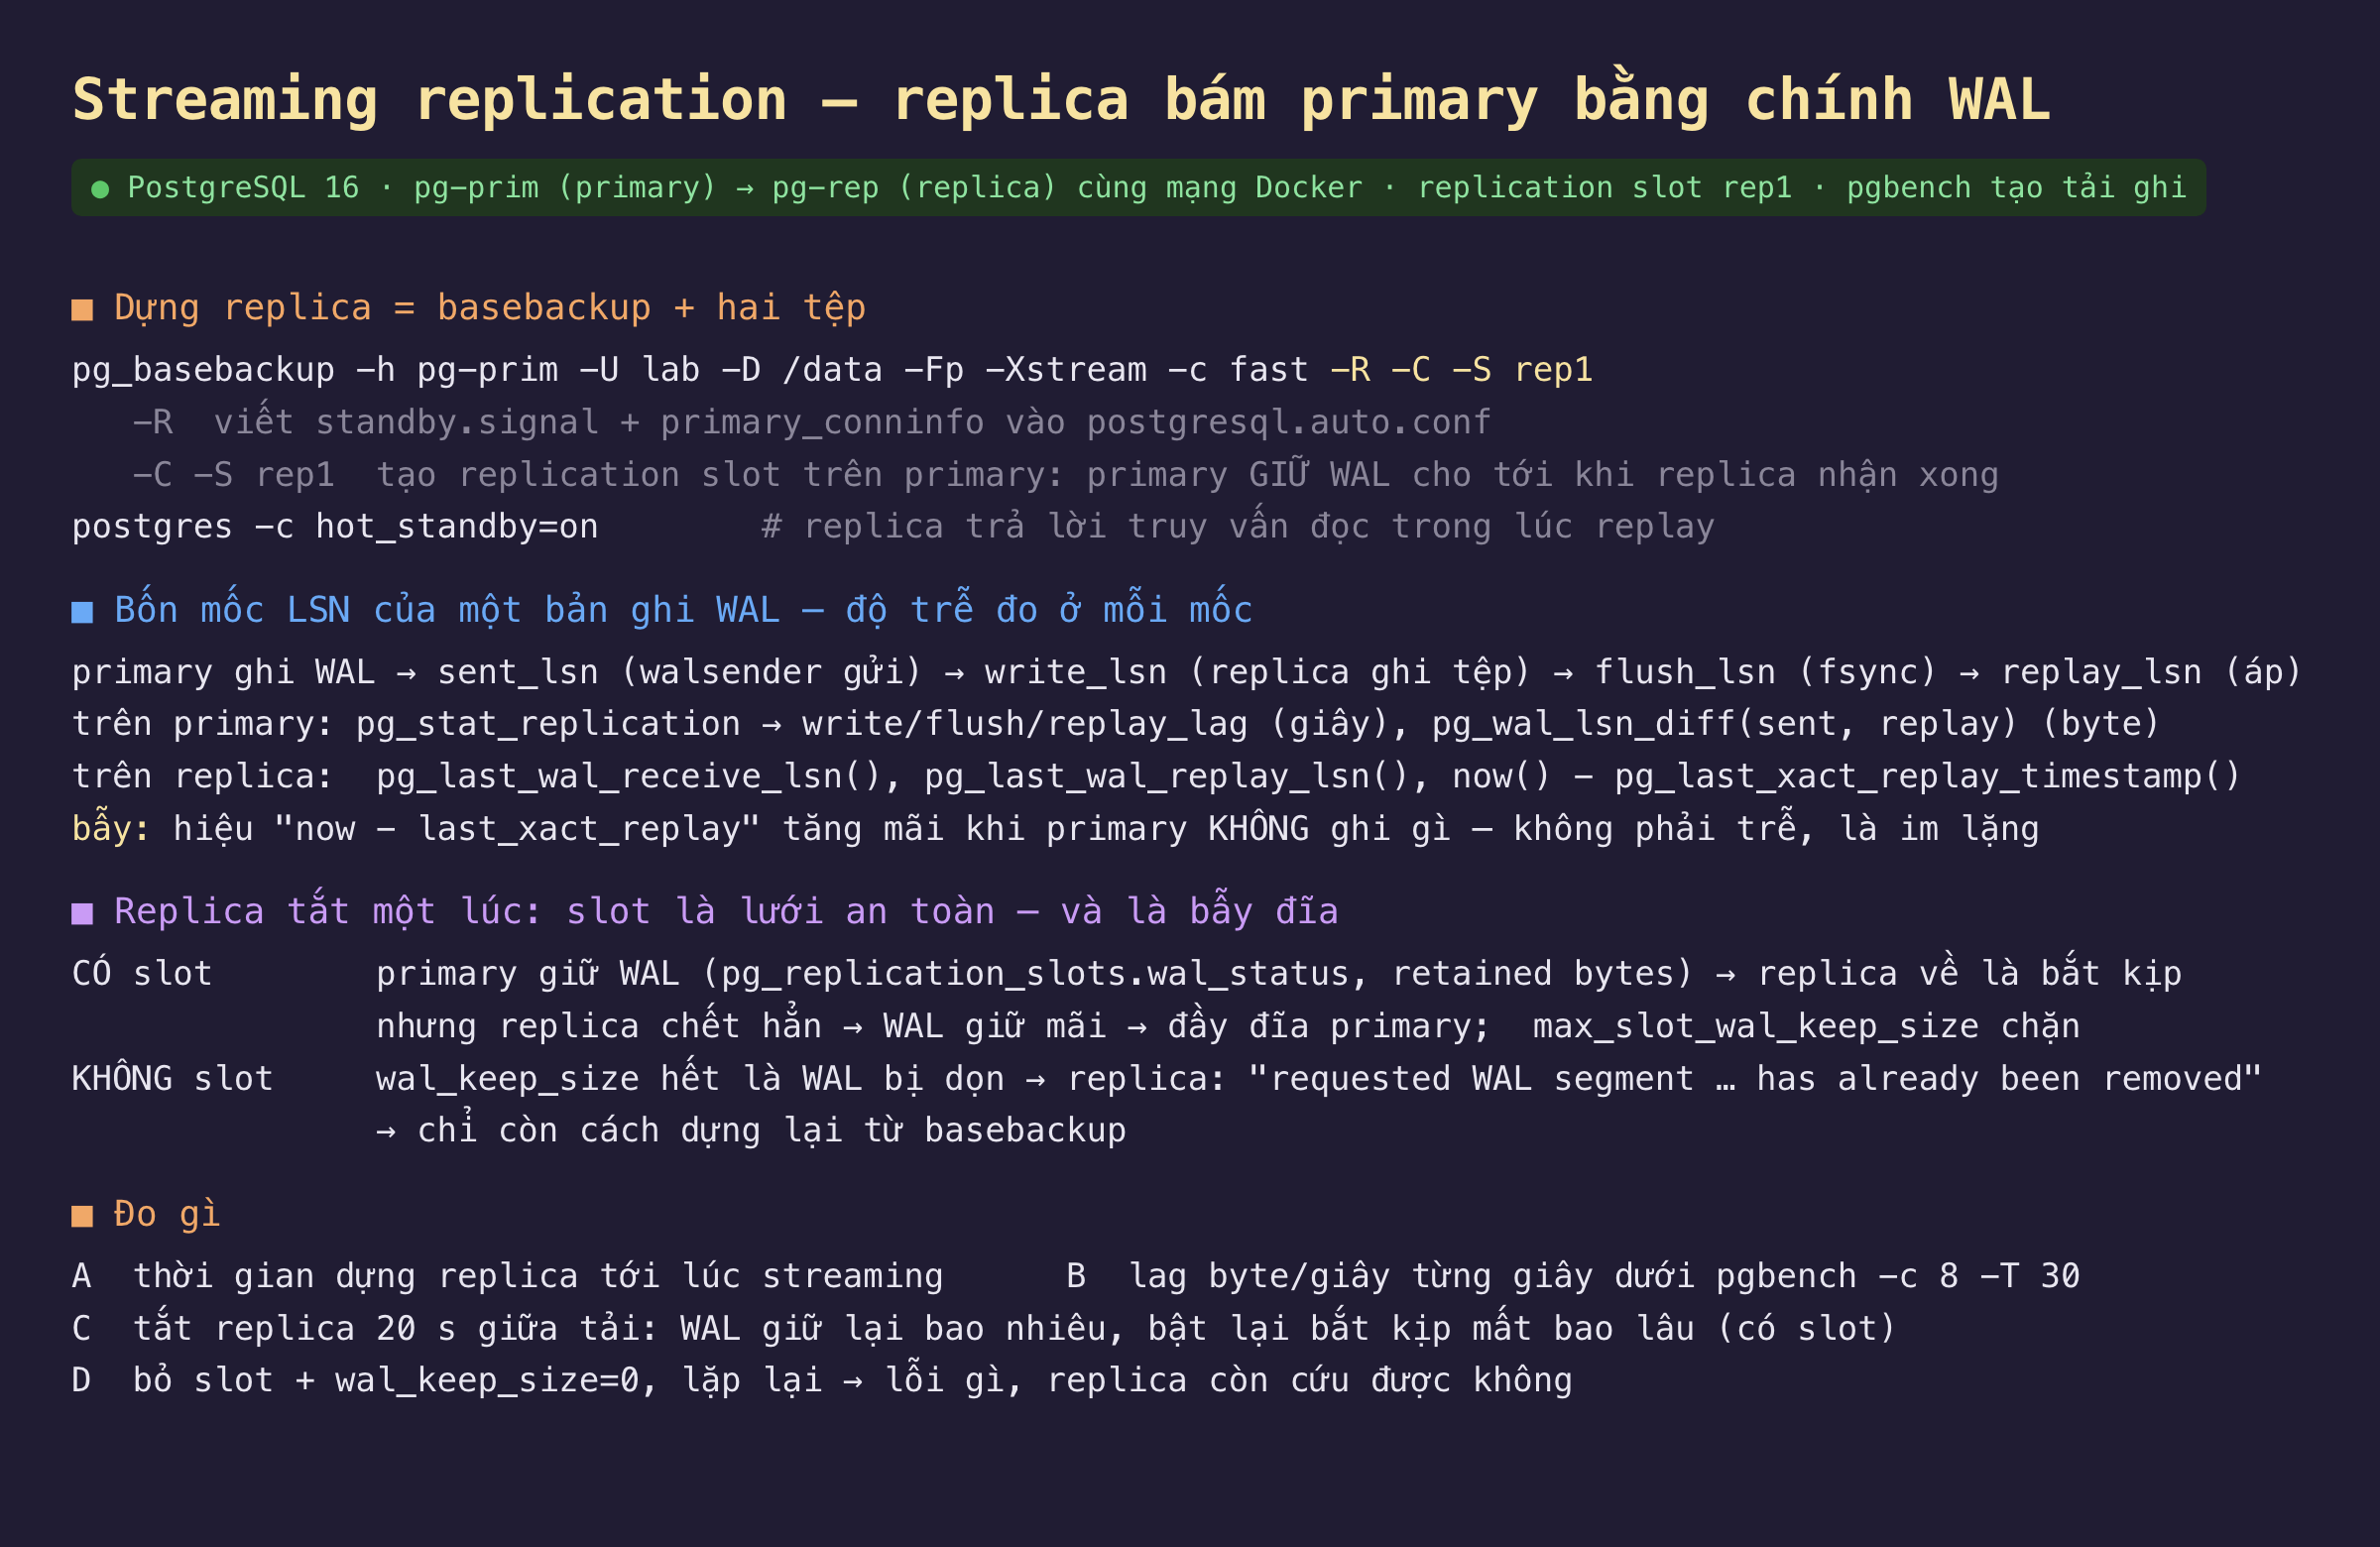
Hình 1: Một lệnh pg_basebackup với -R và -C dựng xong replica. Lag đo ở bốn mốc LSN; slot quyết định WAL được giữ hay bị dọn khi replica vắng mặt.
Dựng replica là một lệnh: pg_basebackup … -R -C -S rep1. -R viết standby.signal và primary_conninfo vào postgresql.auto.conf; -C -S rep1 tạo một replication slot trên primary. Slot là lời hứa của primary: "tôi sẽ giữ WAL từ vị trí replica này đã nhận cho tới khi nó nhận tiếp", bất kể checkpoint hay wal_keep_size. Không có slot, primary dọn WAL theo nhịp checkpoint của nó và chỉ giữ thêm wal_keep_size; replica vắng mặt lâu hơn thế là mất dấu.
Một bản ghi WAL đi qua bốn mốc: sent (walsender đẩy đi), write (replica ghi vào tệp), flush (fsync), replay (áp vào trang dữ liệu). pg_stat_replication trên primary cho cả bốn LSN lẫn ba độ trễ theo giây; trên replica, pg_last_wal_replay_lsn() cho biết đã áp tới đâu. Có một cách đo phổ biến và sai: now() − pg_last_xact_replay_timestamp() trên replica — nó là khoảng cách tới giao dịch cuối cùng đã replay, nên khi primary không ghi gì, con số này tăng đều mà không có byte nào trễ.
Môi trường: pg-prim (613 MB dữ liệu, archive_mode=on từ các phần trước) và pg-rep cùng mạng Docker; pgbench 8 client tạo khoảng 25 MB WAL mỗi giây.
Đo thật: lag, im lặng, và hai lần tắt máy
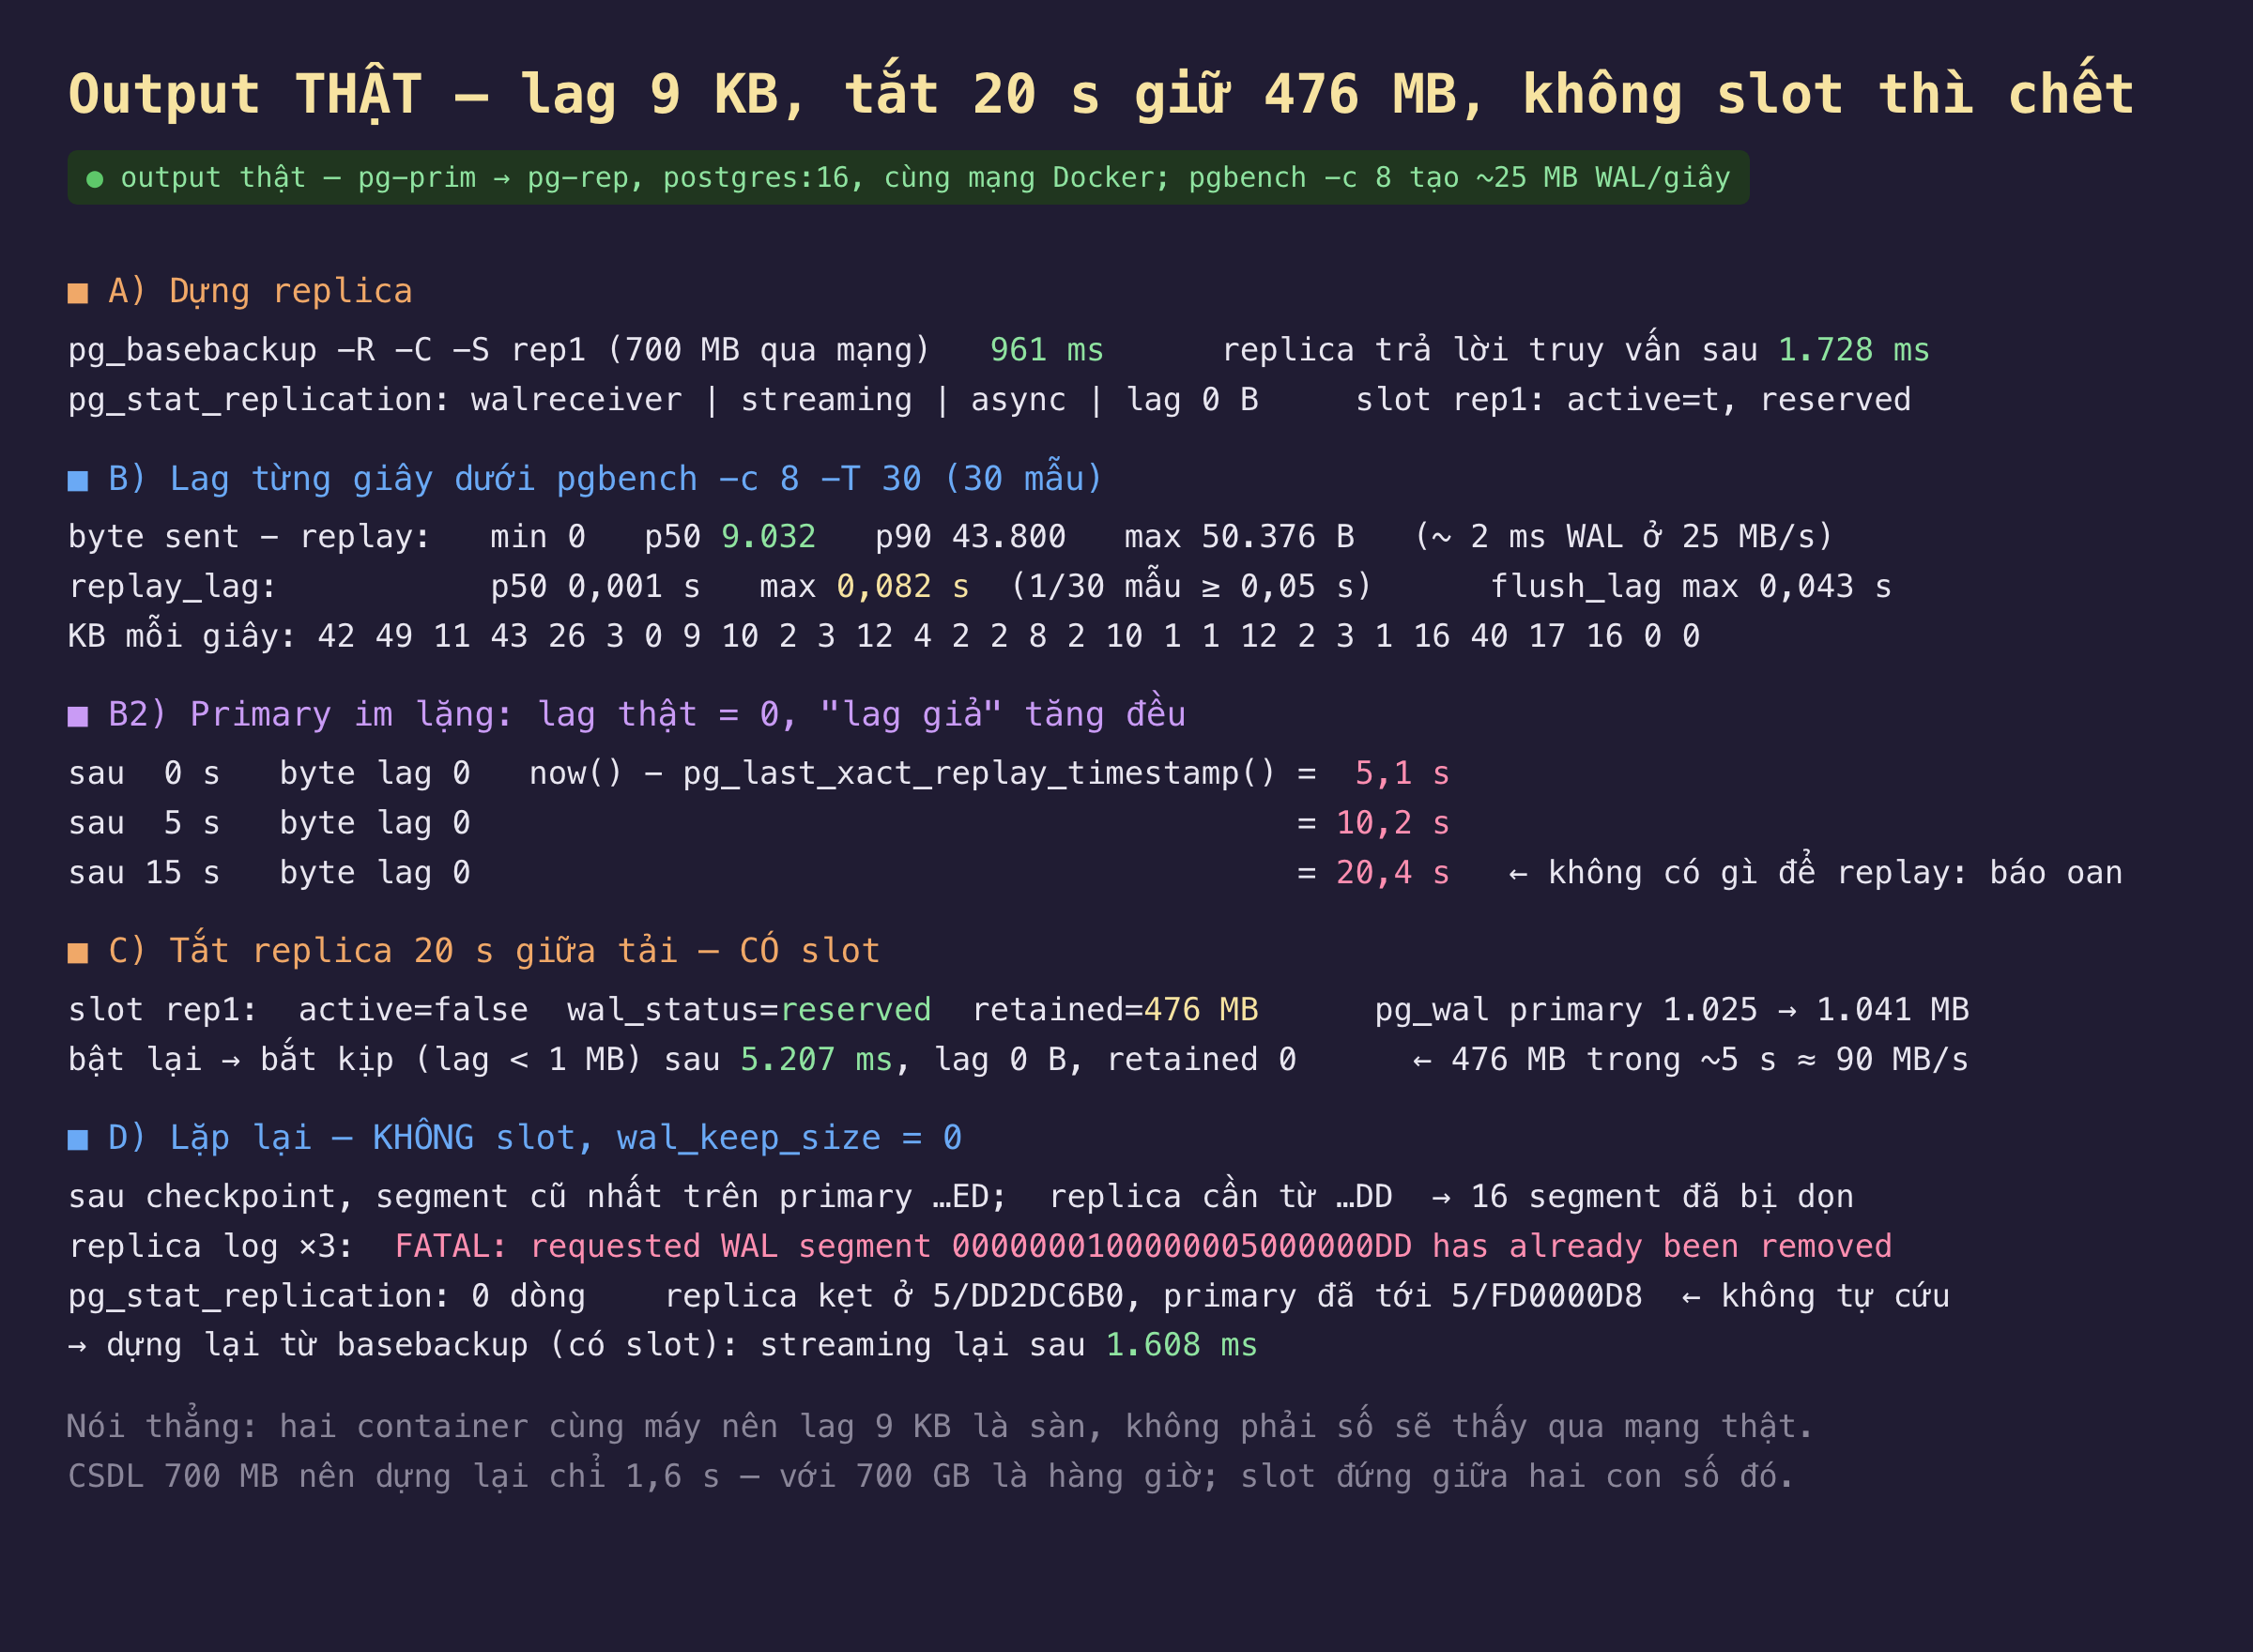
Hình 2: Lag dưới tải tính bằng KB và mili giây; "lag" khi im lặng tăng tới 20 giây mà không có byte nào trễ; slot giữ 476 MB cho replica vắng 20 giây; không slot thì 16 segment bị dọn và replica phải dựng lại.
| phép đo | kết quả |
|---|---|
| dựng replica 700 MB tới lúc trả lời truy vấn | 1.728 ms (basebackup 961 ms) |
| lag byte dưới pgbench, 30 mẫu | min 0, p50 9.032, p90 43.800, max 50.376 B |
| replay_lag | p50 0,001 s, max 0,082 s |
| "lag" trên replica khi primary im lặng 0 / 5 / 15 s | 5,1 / 10,2 / 20,4 s, byte lag = 0 |
| tắt 20 s giữa tải, có slot | giữ 476 MB, bắt kịp sau 5.207 ms |
tắt 20 s, không slot, wal_keep_size=0 |
16 segment bị dọn, FATAL … already been removed, phải dựng lại (1.608 ms) |
Dựng replica: 1,7 giây, và từ đó nó tự bám. pg_basebackup -R -C -S rep1 chép 700 MB trong 961 ms, container khởi động, và 1.728 ms sau lệnh đầu tiên replica đã trả lời select count(*) from docs với đủ một triệu dòng, pg_stat_replication báo streaming, lag 0 byte. Không có bước cấu hình tay nào — hai tệp mà -R viết ra là toàn bộ "cấu hình replica".
Dưới 25 MB WAL mỗi giây, lag trung vị 9 KB và 1 ms. Ba mươi mẫu mỗi giây trong khi pgbench 8 client chạy: khoảng cách sent − replay trung vị 9 KB, phân vị 90 là 44 KB, tối đa 50 KB — ở tốc độ 25 MB/s đó là khoảng 2 ms WAL. replay_lag trung vị 1 ms, một mẫu duy nhất chạm 82 ms (flush_lag 43 ms cùng lúc — fsync trên replica). Hai container cùng máy nên đây là sàn; qua mạng thật mỗi mốc cộng thêm RTT và độ trễ đĩa, nhưng hình dạng không đổi: lag byte dao động theo nhịp ghi, còn replay_lag chỉ nhảy khi replica bận fsync hoặc replay một bản ghi lớn.
Primary im lặng: lag thật bằng 0, số đo trên replica tăng tới 20 giây. Sau khi pgbench dừng, pg_wal_lsn_diff(sent_lsn, replay_lsn) là 0 suốt, nhưng now() − pg_last_xact_replay_timestamp() trên replica đọc 5,1 → 10,2 → 20,4 giây — nó đo khoảng cách tới giao dịch cuối cùng đã có để replay, và khi không ai ghi thì giao dịch cuối cùng cứ lùi xa dần. Bảng cảnh báo dùng con số này sẽ kêu lúc nửa đêm vì hệ thống rảnh. Đo lag đúng là so LSN (trên primary, hoặc pg_last_wal_receive_lsn() với pg_last_wal_replay_lsn() trên replica); muốn số giây thì đọc replay_lag từ pg_stat_replication, nó là NULL khi không có gì để đo thay vì tăng vô nghĩa.
Tắt 20 giây giữa tải, có slot: primary giữ 476 MB, replica về và bắt kịp sau 5,2 giây. Trong lúc replica tắt, slot rep1 chuyển active=false nhưng wal_status=reserved và retained leo lên 476 MB — primary không dọn một byte nào trong khoảng đó. pg_wal chỉ tăng 1.025 → 1.041 MB vì segment được tái dùng chứ không phải cấp mới; khi khoảng giữ vượt max_wal_size thì thư mục mới thật sự phình. Bật lại: 476 MB replay trong 5,2 giây (khoảng 90 MB/s qua mạng Docker, chậm hơn 250–440 MB/s của PITR cục bộ ở phần 4 vì có thêm khâu nhận), lag về 0, retained về 0. Không có bước nào của người vận hành.
Cùng kịch bản, không slot, wal_keep_size=0: replica chết. Sau checkpoint, segment cũ nhất còn trên primary là …ED; replica cần nối tiếp từ …DD — mười sáu segment đã bị dọn. Replica khởi động, nối vào primary, nhận FATAL: requested WAL segment 0000000100000005000000DD has already been removed, ngắt, thử lại, lặp ba lần trong tám giây; pg_stat_replication trên primary trống; replay_lsn đứng yên ở 5/DD2DC6B0 trong khi primary đã tới 5/FD…. Không có cách tự cứu: dữ liệu giữa hai LSN đó không còn ở đâu để kéo về (trừ kho WAL lưu trữ của phần 4, nếu restore_command được khai — ở đây cố tình không). Cách duy nhất là dựng lại từ basebackup: 1,6 giây với 700 MB, và sẽ là hàng giờ với 700 GB.
Đánh đổi cần cân nhắc
Slot bảo vệ replica bằng đĩa của primary. Đó là một đổi chác đúng khi replica vắng mặt vài phút; nó là thảm hoạ khi replica chết hẳn mà slot còn đó — primary giữ WAL mãi tới khi đầy đĩa và dừng. max_slot_wal_keep_size đặt trần: vượt là slot chuyển wal_status=lost và replica phải dựng lại, nhưng primary sống. Đặt nó, và giám sát pg_replication_slots cho slot active=false lâu hơn một ngưỡng.
Lag byte hay lag giây: hỏi câu gì thì đo cái đó. Byte cho biết replica còn phải xử lý bao nhiêu — thứ quyết định failover mất bao nhiêu dữ liệu ở chế độ async (phần 7). Giây cho biết người đọc trên replica thấy dữ liệu cũ bao lâu (phần 6). Và now() − pg_last_xact_replay_timestamp() không trả lời câu nào trong hai câu đó khi primary rảnh.
Phạm vi đo. Hai container trên một máy: lag 9 KB và 1 ms là giới hạn dưới của chính cơ chế, không phải của mạng; catch-up 90 MB/s bị giới hạn bởi CPU replay đơn luồng và đĩa chung. Chưa chạm: synchronous_commit và replica đồng bộ (phần 7), cascading replica, và pg_rewind.
Ba ý mang về
- Replica là một lệnh và hai tệp: 1,7 giây tới lúc trả lời truy vấn; dưới 25 MB WAL/giây lag trung vị 9 KB và 1 ms, tối đa 82 ms — đo bằng LSN hoặc
replay_lag, không bằngnow() − last_xact_replay(tăng tới 20 giây khi primary rảnh). - Slot là khác biệt giữa "bắt kịp sau 5 giây" và "dựng lại từ đầu": cùng 20 giây vắng mặt, có slot giữ 476 MB và tự hồi; không slot thì 16 segment bị dọn và replica không có đường về.
- Slot giữ WAL bằng đĩa của primary: đặt
max_slot_wal_keep_sizevà giám sát slotactive=false, nếu không replica chết sẽ kéo primary chết theo.
Nguồn
- PostgreSQL 16 — Log-Shipping Standby Servers và Streaming Replication: https://www.postgresql.org/docs/16/warm-standby.html
- PostgreSQL 16 — Replication Slots: https://www.postgresql.org/docs/16/warm-standby.html#STREAMING-REPLICATION-SLOTS
- PostgreSQL 16 —
pg_stat_replication(write_lag, flush_lag, replay_lag): https://www.postgresql.org/docs/16/monitoring-stats.html#MONITORING-PG-STAT-REPLICATION-VIEW - PostgreSQL 16 —
pg_basebackup(-R,-C,-S): https://www.postgresql.org/docs/16/app-pgbasebackup.html - PostgreSQL 16 —
max_slot_wal_keep_size,wal_keep_size: https://www.postgresql.org/docs/16/runtime-config-replication.html
Phần sau cho ứng dụng đọc trên chính replica này: truy vấn dài bị huỷ vì xung đột với WAL replay, max_standby_streaming_delay và hot_standby_feedback đổi điều đó ra sao, và đo xem đọc ngay sau khi ghi thất bại bao nhiêu phần trăm.
