Phần 5 dựng replica và đo lag tính bằng kilobyte. Bước tiếp theo mà mọi đội đều làm là trỏ báo cáo và truy vấn đọc sang replica để primary rảnh. Rồi hai loại phiếu lỗi xuất hiện: "báo cáo chạy 20 phút bị huỷ với lỗi conflict with recovery", và "người dùng vừa lưu xong tải lại trang không thấy". Hai lỗi này không phải bug, chúng là hai mặt của cùng một thiết kế: replica áp WAL của primary và phục vụ snapshot của riêng nó. Phần này đo cả hai, bằng một truy vấn dài gặp VACUUM, và một vòng lặp ghi-rồi-đọc-ngay ba trăm lần.
Replica chỉ đọc có hai kẻ thù
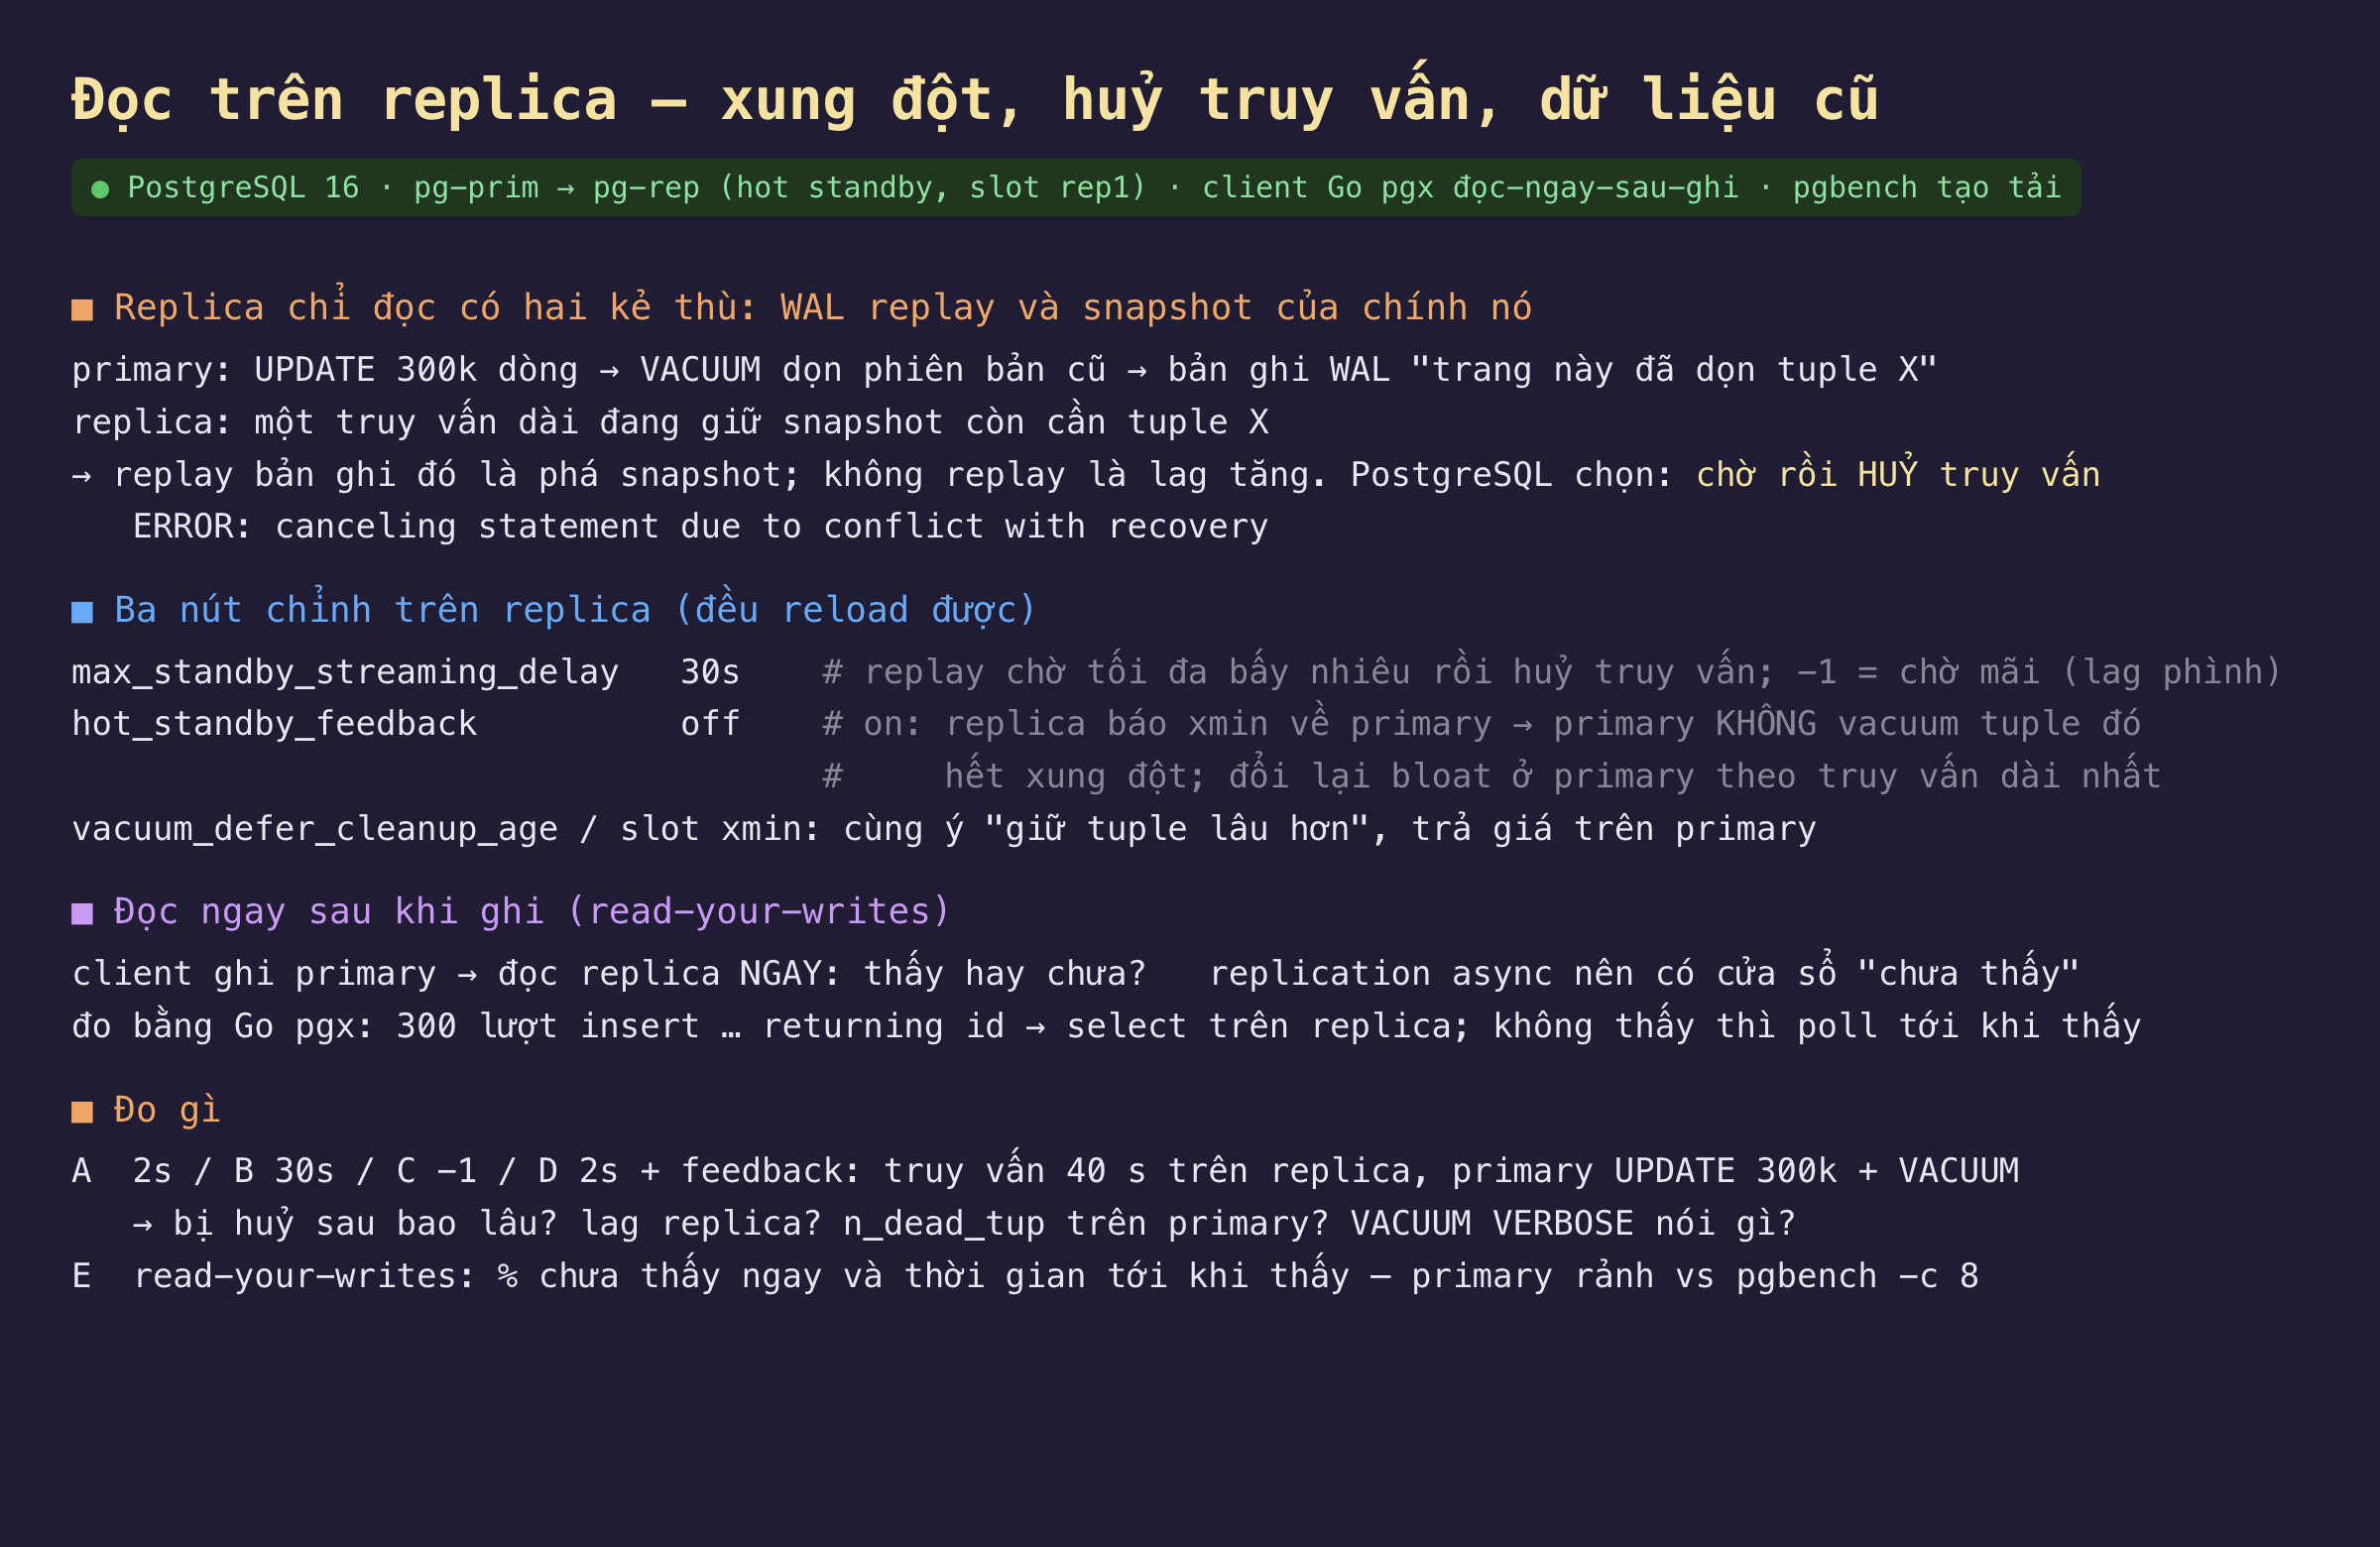
Hình 1: Replay WAL và snapshot của truy vấn dài không thể cùng đúng; PostgreSQL chờ rồi huỷ truy vấn, hoặc nếu bật feedback thì primary giữ tuple lại.
Khi primary UPDATE rồi VACUUM, WAL chứa bản ghi "trang này đã dọn các tuple cũ". Replica phải áp bản ghi đó để bám kịp, nhưng nếu một truy vấn trên replica đang giữ snapshot còn cần những tuple đó, áp vào là trả về kết quả sai. PostgreSQL không chọn sai: nó chờ tối đa max_standby_streaming_delay rồi huỷ truy vấn với canceling statement due to conflict with recovery. Đặt -1 là chờ mãi — truy vấn sống, lag phình.
Cách thứ hai là hot_standby_feedback = on: replica gửi xmin của snapshot cũ nhất về primary, primary không vacuum những tuple đó nữa. Hết xung đột, nhưng bloat chuyển sang primary — và chuyển theo thời gian của truy vấn dài nhất đang chạy trên replica.
Còn "vừa lưu xong không thấy" là chuyện khác: replication bất đồng bộ nên giữa commit trên primary và replay trên replica luôn có một cửa sổ. Câu hỏi không phải "có cửa sổ không" mà là "rộng bao nhiêu và trượt bao nhiêu phần trăm" — đo bằng Go pgx: insert … returning id trên primary rồi select trên replica ngay lập tức, lặp 300 lần.
Đo thật: bốn cấu hình và ba trăm lượt đọc
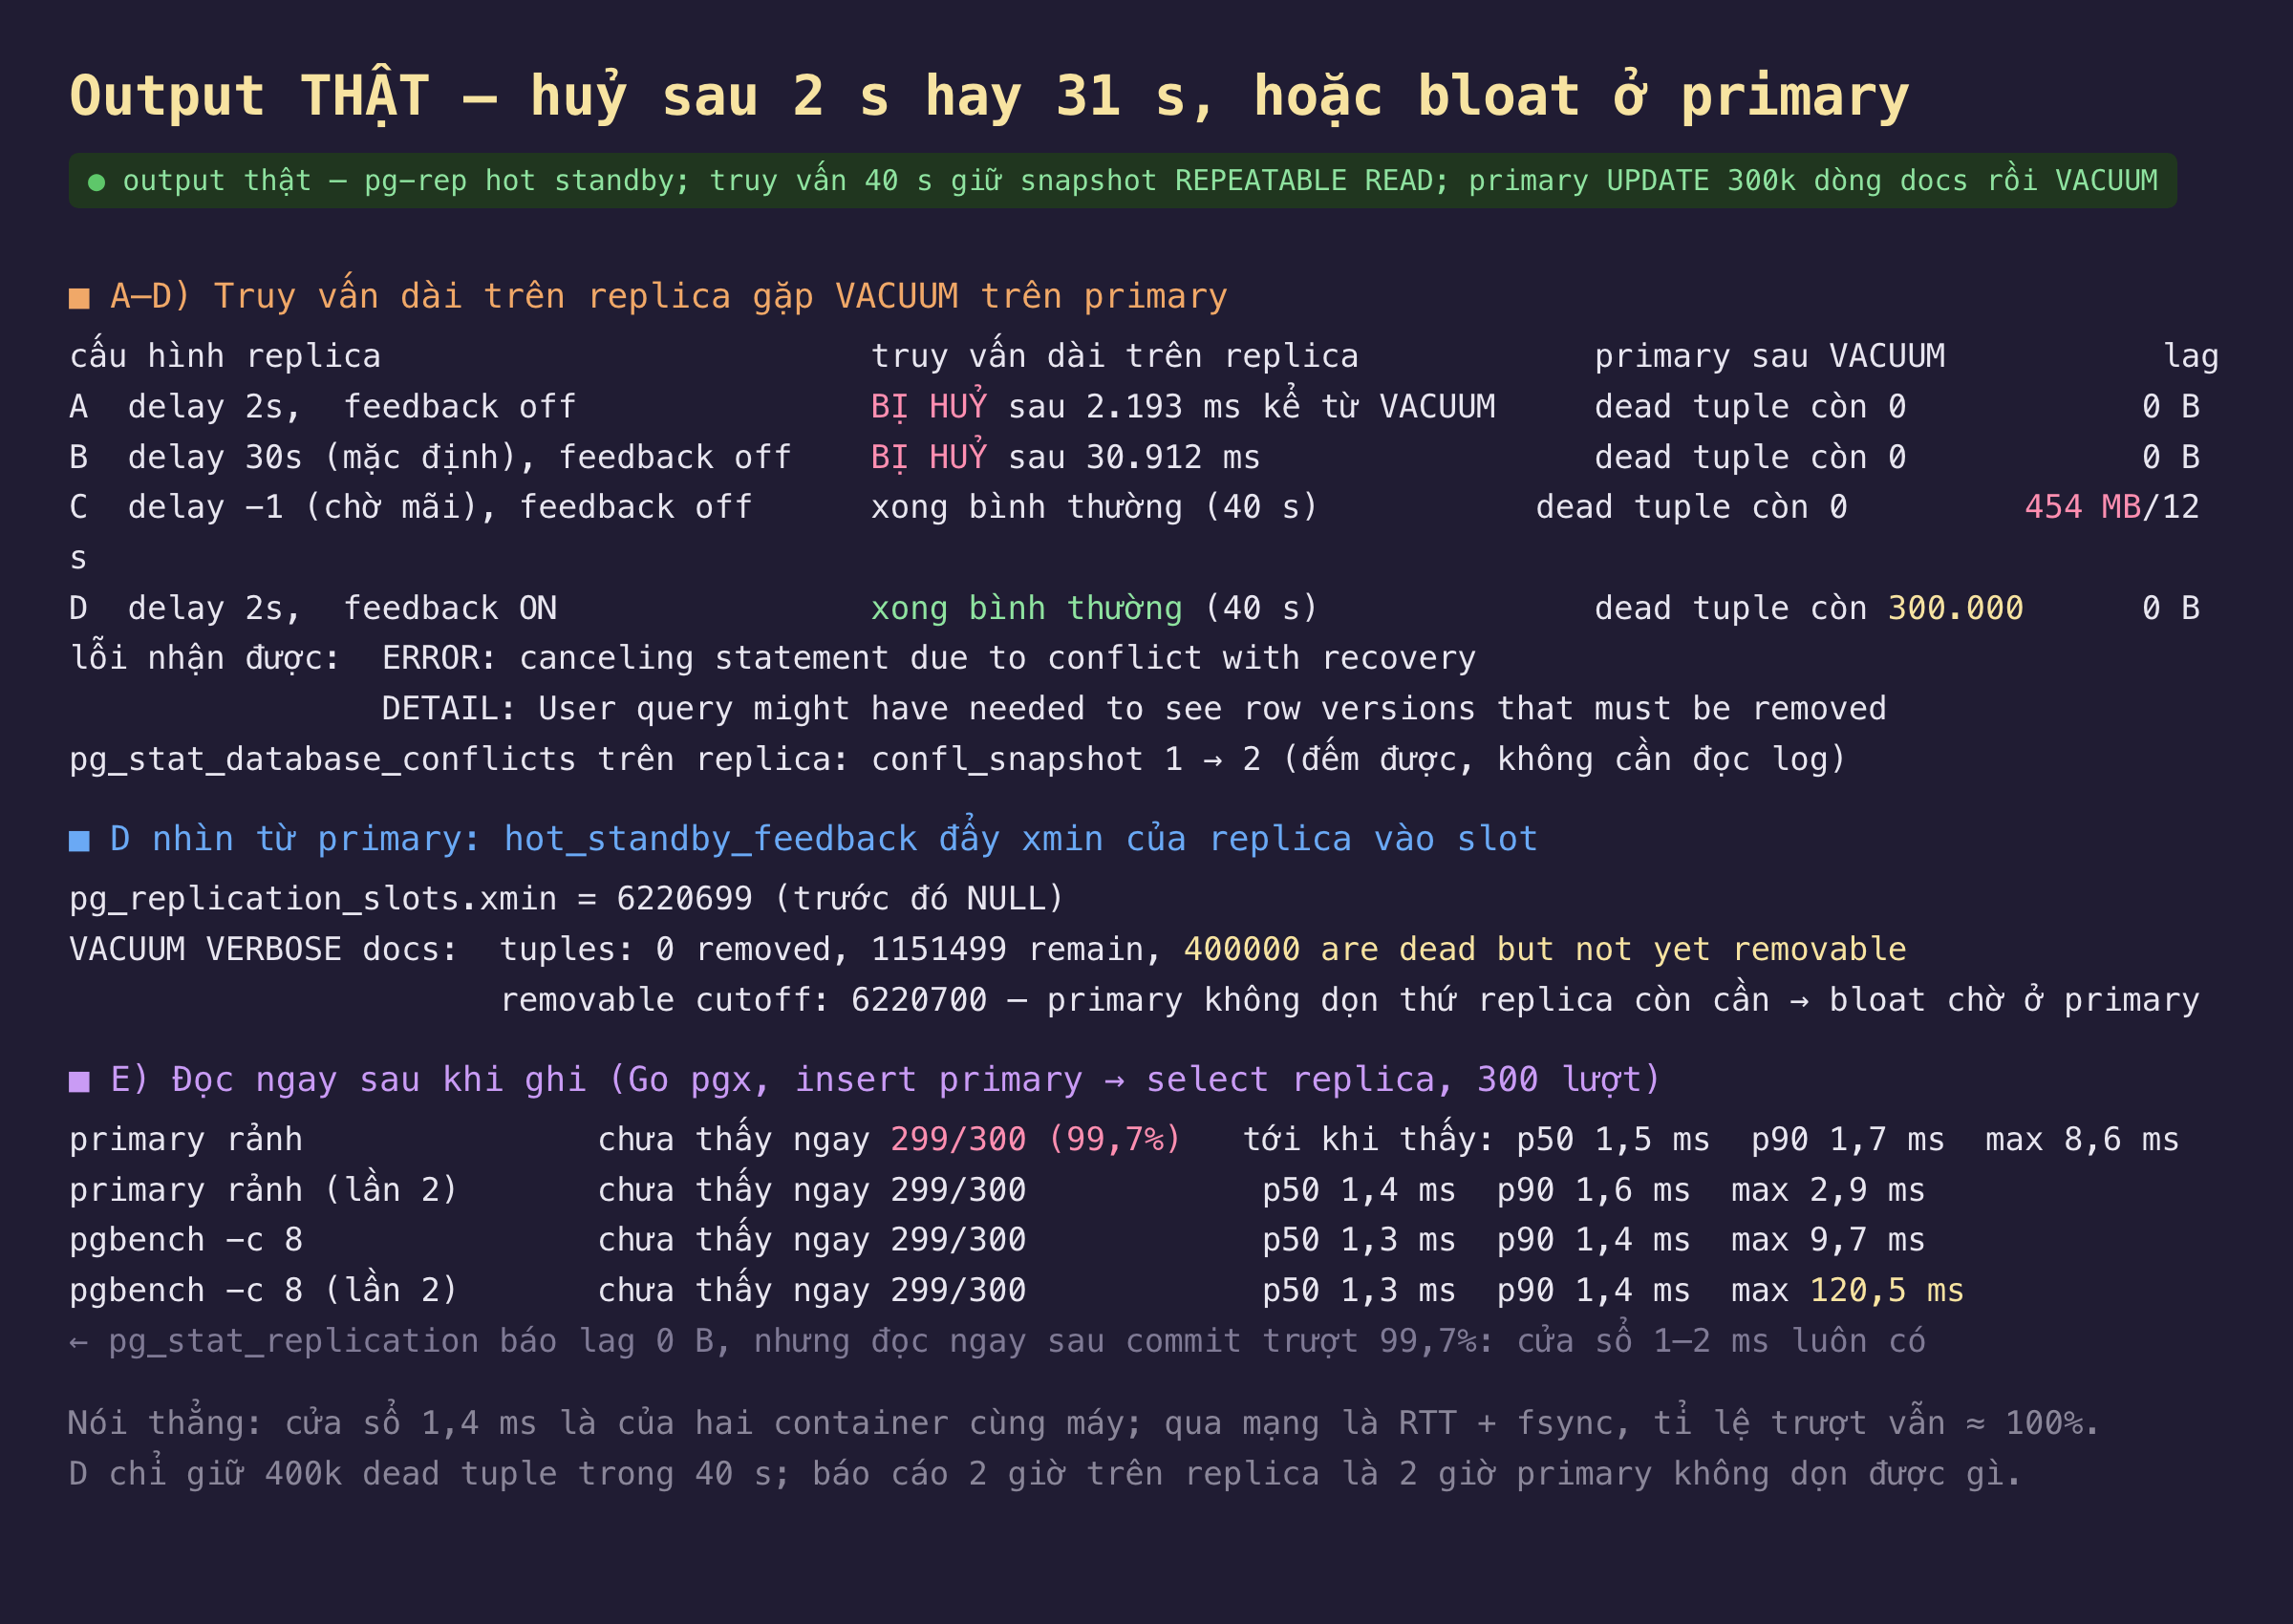
Hình 2: Huỷ sau 2,2 s hay 30,9 s tuỳ cấu hình; chờ mãi thì lag 454 MB; feedback thì 400.000 dead tuple ở primary. Đọc ngay sau ghi trượt 299/300.
| cấu hình replica | truy vấn 40 s trên replica | primary | lag |
|---|---|---|---|
| A: delay 2 s, feedback off | huỷ sau 2.193 ms | dead tuple 0 | 0 |
| B: delay 30 s (mặc định) | huỷ sau 30.912 ms | dead tuple 0 | 0 |
| C: delay −1 | chạy xong | dead tuple 0 | 454 MB, 12 s |
| D: delay 2 s, feedback on | chạy xong | 300.000 dead tuple chờ | 0 |
| E: đọc ngay sau ghi, 300 lượt | trượt 299 (99,7%), thấy sau p50 1,4 ms, max 120 ms | "0 B" |
Huỷ đúng sau max_standby_streaming_delay, không sớm hơn một giây nào. Với 2 giây, truy vấn bị huỷ 2.193 ms sau khi VACUUM trên primary kết thúc; với 30 giây mặc định, 30.912 ms. Lỗi ghi rõ User query might have needed to see row versions that must be removed, và pg_stat_database_conflicts.confl_snapshot tăng 1 mỗi lần — đây là chỉ số nên vẽ lên bảng, vì nó đếm chính xác số truy vấn bị hy sinh mà không cần đọc log. Lưu ý điều gì không xảy ra: lag vẫn 0 byte. PostgreSQL ưu tiên bám primary; truy vấn đọc là bên nhường.
Chờ mãi (−1) đổi huỷ lấy lag: 454 MB sau 12 giây. Đặt -1, truy vấn 40 giây chạy xong, nhưng trong lúc đó replay dừng hẳn: dưới pgbench 4 client, lag lên 454 MB và replay_lag 12 giây, đúng bằng thời gian chờ. Mọi truy vấn khác trên replica trong 40 giây đó đều thấy dữ liệu cũ dần — một báo cáo giữ cả cụm replica ở quá khứ. Khi truy vấn xong, replica bắt kịp trong vài giây (phần 5 đo 90 MB/s), nhưng nếu truy vấn dài là 2 giờ thì lag là 2 giờ.
Feedback hết huỷ, và chuyển hoá đơn sang primary: 400.000 dead tuple không dọn được. Bật hot_standby_feedback, slot rep1 trên primary có xmin = 6220699 (trước đó NULL) — replica đang nói "đừng dọn gì mới hơn mốc này". Truy vấn chạy xong, lag 0, không lỗi. Nhưng n_dead_tup của docs trên primary đứng ở 300.000 sau VACUUM, và VACUUM VERBOSE nói thẳng: 400000 are dead but not yet removable, removable cutoff: 6220700. Trong 40 giây thì không sao; với báo cáo 2 giờ mỗi sáng trên replica, đó là 2 giờ mỗi sáng primary không dọn được bảng bận nhất — bloat của phần 9 bắt đầu từ đây.
Đọc ngay sau khi ghi trượt 299/300, dù lag báo 0. Đây là con số đáng ngạc nhiên nhất. Primary rảnh, pg_stat_replication báo 0 byte lag, vậy mà select trên replica ngay sau insert … returning trên primary không thấy dòng ở 299 trong 300 lượt — hai lần lặp đều vậy. Dòng xuất hiện sau 1,4 ms trung vị, 1,7 ms ở phân vị 90; dưới pgbench 8 client, trung vị vẫn 1,3 ms nhưng tối đa 120 ms. "Lag 0" là giá trị lấy mẫu giữa hai lần ghi; cửa sổ commit → send → write → flush → replay luôn tồn tại và một client đủ nhanh sẽ rơi vào đó mọi lần. Ứng dụng cần read-your-writes thì phải đọc trên primary sau khi ghi, hoặc chờ pg_last_wal_replay_lsn() trên replica vượt LSN của commit, hoặc dùng synchronous_commit = remote_apply — thứ phần 7 đo giá.
Đánh đổi cần cân nhắc
Ba lựa chọn, ba chỗ trả tiền. Huỷ truy vấn (mặc định): replica luôn mới, người chạy báo cáo trả giá. Chờ mãi: báo cáo xong, mọi người đọc khác trả giá bằng dữ liệu cũ. Feedback: ai cũng vui ở replica, primary trả giá bằng bloat tỉ lệ với truy vấn dài nhất. Không có cấu hình "đúng" — có cấu hình khớp với việc replica này dùng để làm gì: replica cho báo cáo thì feedback on và chấp nhận bloat (kèm statement_timeout để chặn truy vấn vô hạn); replica cho đọc của ứng dụng thì delay ngắn và không feedback.
Replica không cho read-your-writes, bất kể lag. 99,7% trượt ở lag "0" nghĩa là không có ngưỡng lag nào làm chuyện này an toàn. Định tuyến đọc sau ghi về primary (theo phiên, trong vài giây), hoặc truyền LSN của commit cho client và chờ replica replay tới đó. Cả hai đều là mã ứng dụng; không có tham số nào thay được.
Phạm vi đo. Cửa sổ 1,4 ms là của hai container trên một máy; qua mạng thật nó là RTT cộng fsync của replica, lớn hơn nhưng tỉ lệ trượt không đổi. Truy vấn dài ở đây là pg_sleep trong REPEATABLE READ để giữ snapshot ổn định; READ COMMITTED lấy snapshot mới mỗi câu nên ít xung đột hơn, nhưng một câu SELECT 20 phút vẫn là một snapshot 20 phút. Chưa chạm: xung đột khoá (confl_lock, do DDL trên primary) và max_standby_archive_delay.
Ba ý mang về
- Replica huỷ truy vấn đúng sau
max_standby_streaming_delay(2,2 s hay 30,9 s) vàconfl_snapshotđếm từng lần;-1đổi huỷ lấy lag (454 MB/12 s) cho mọi người đọc khác. hot_standby_feedbackkhông xoá chi phí, nó chuyển chi phí: 400.000 dead tuple "not yet removable" trên primary trong suốt thời gian truy vấn dài nhất ở replica chạy. Bật nó cho replica báo cáo, kèmstatement_timeout.- Replica không cho read-your-writes ở bất kỳ lag nào: 299/300 trượt với lag báo 0, thấy sau 1,4 ms tới 120 ms. Đọc sau ghi về primary, hoặc chờ LSN.
Nguồn
- PostgreSQL 16 — Hot Standby, mục Handling Query Conflicts: https://www.postgresql.org/docs/16/hot-standby.html#HOT-STANDBY-CONFLICT
- PostgreSQL 16 —
max_standby_streaming_delay,hot_standby_feedback: https://www.postgresql.org/docs/16/runtime-config-replication.html#RUNTIME-CONFIG-REPLICATION-STANDBY - PostgreSQL 16 —
pg_stat_database_conflicts: https://www.postgresql.org/docs/16/monitoring-stats.html#MONITORING-PG-STAT-DATABASE-CONFLICTS-VIEW - PostgreSQL 16 — VACUUM và
removable cutoff: https://www.postgresql.org/docs/16/sql-vacuum.html - PostgreSQL 16 —
synchronous_commit(remote_apply): https://www.postgresql.org/docs/16/runtime-config-wal.html#GUC-SYNCHRONOUS-COMMIT
Phần sau cho primary chết thật: promote replica, đếm dòng mất khi replication bất đồng bộ, xem synchronous_commit đổi con số đó và giá của nó ra sao, và đưa primary cũ quay lại làm replica bằng pg_rewind thay vì chép lại từ đầu.
