Hai phần trước dựng replica và đọc trên nó. Replica tồn tại vì một lý do lớn hơn: khi primary chết, nó lên thay. Nghe đơn giản — một lệnh pg_promote — và đúng là đơn giản về mặt thao tác. Cái không đơn giản là ba câu hỏi đi kèm: mất bao nhiêu giao dịch đã báo "xong" cho khách hàng, giá của việc không mất là gì, và primary cũ tỉnh dậy thì làm gì với nó. Phần này giết primary bằng SIGKILL giữa tải, hai lần — một lần bất đồng bộ, một lần đồng bộ — với một writer đếm từng commit được xác nhận, rồi đưa primary cũ quay về bằng pg_rewind.
Promote, timeline, và lịch sử rẽ nhánh
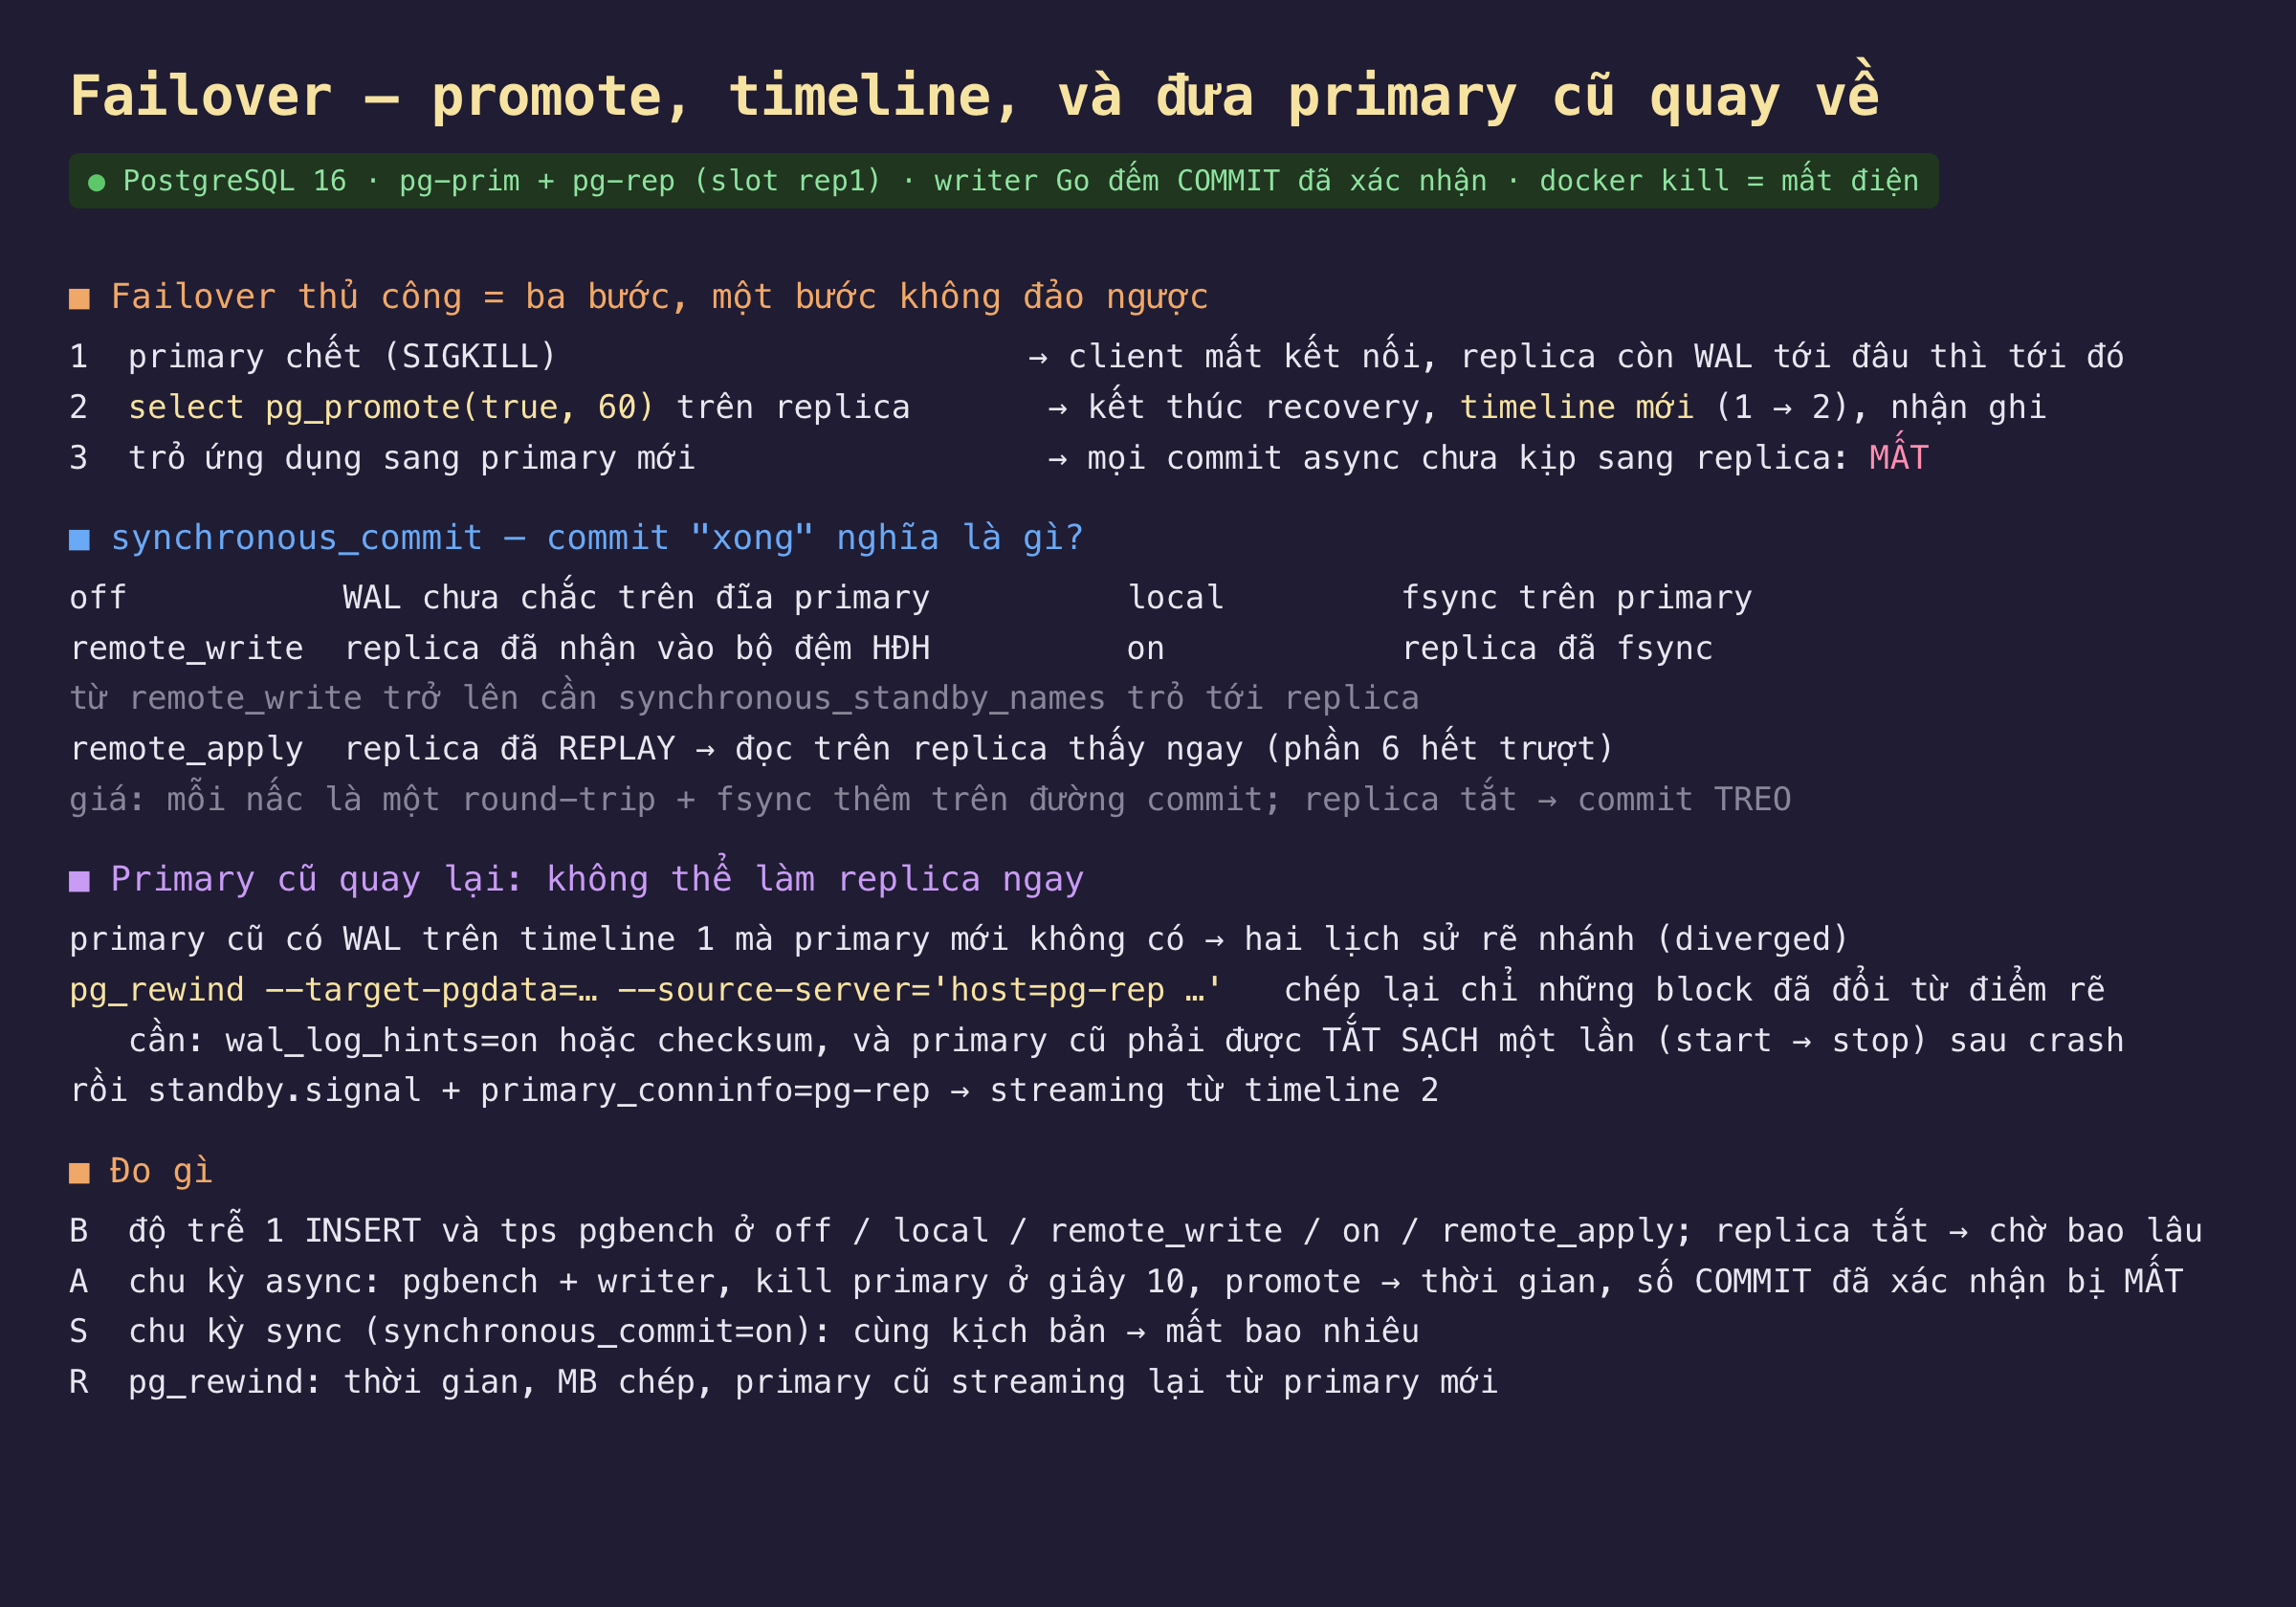
Hình 1: Promote là một lệnh và một timeline mới. Mất bao nhiêu phụ thuộc vào synchronous_commit; primary cũ quay về cần pg_rewind vì lịch sử đã rẽ nhánh.
Failover thủ công là ba bước. Primary chết; replica nhận được WAL tới đâu thì có tới đó. pg_promote() trên replica kết thúc recovery, mở ghi, và bắt đầu một timeline mới — số timeline là cách PostgreSQL đánh dấu "lịch sử từ đây là của tôi", để WAL mới không trùng tên với WAL cũ. Ứng dụng trỏ sang primary mới. Bước hai không đảo ngược: sau promote, mọi giao dịch primary cũ đã commit mà chưa kịp gửi sang replica không tồn tại ở primary mới.
Bao nhiêu giao dịch như thế là chuyện của synchronous_commit. off: commit trả về khi WAL còn trong bộ đệm primary. local: sau fsync trên primary. remote_write: replica đã nhận. on: replica đã fsync. remote_apply: replica đã replay — chính là thứ làm read-your-writes của phần 6 hết trượt. Mỗi nấc là thêm một round-trip hoặc một fsync trên đường commit, và từ remote_write trở lên cần synchronous_standby_names — kèm một hệ quả: replica tắt thì commit chờ.
Primary cũ tỉnh dậy thì không thể làm replica ngay: nó có WAL trên timeline cũ mà primary mới chưa từng thấy — hai lịch sử rẽ nhánh. pg_rewind tìm checkpoint chung cuối cùng, chép lại từ primary mới chỉ những block đã đổi từ đó, và viết lại control file. Nó cần wal_log_hints = on (hoặc data checksums) trên primary cũ, và primary cũ phải được tắt sạch một lần — sau crash, tức là start rồi stop.
Môi trường: pg-prim được dựng lại với wal_log_hints=on, pg-rep là replica với slot; pgbench 8 client tạo tải; một writer Go dùng một kết nối, chèn liên tục và đếm số INSERT nhận được xác nhận cho tới khi mất kết nối.
Đo thật: giá của từng nấc, hai lần giết, một lần quay về
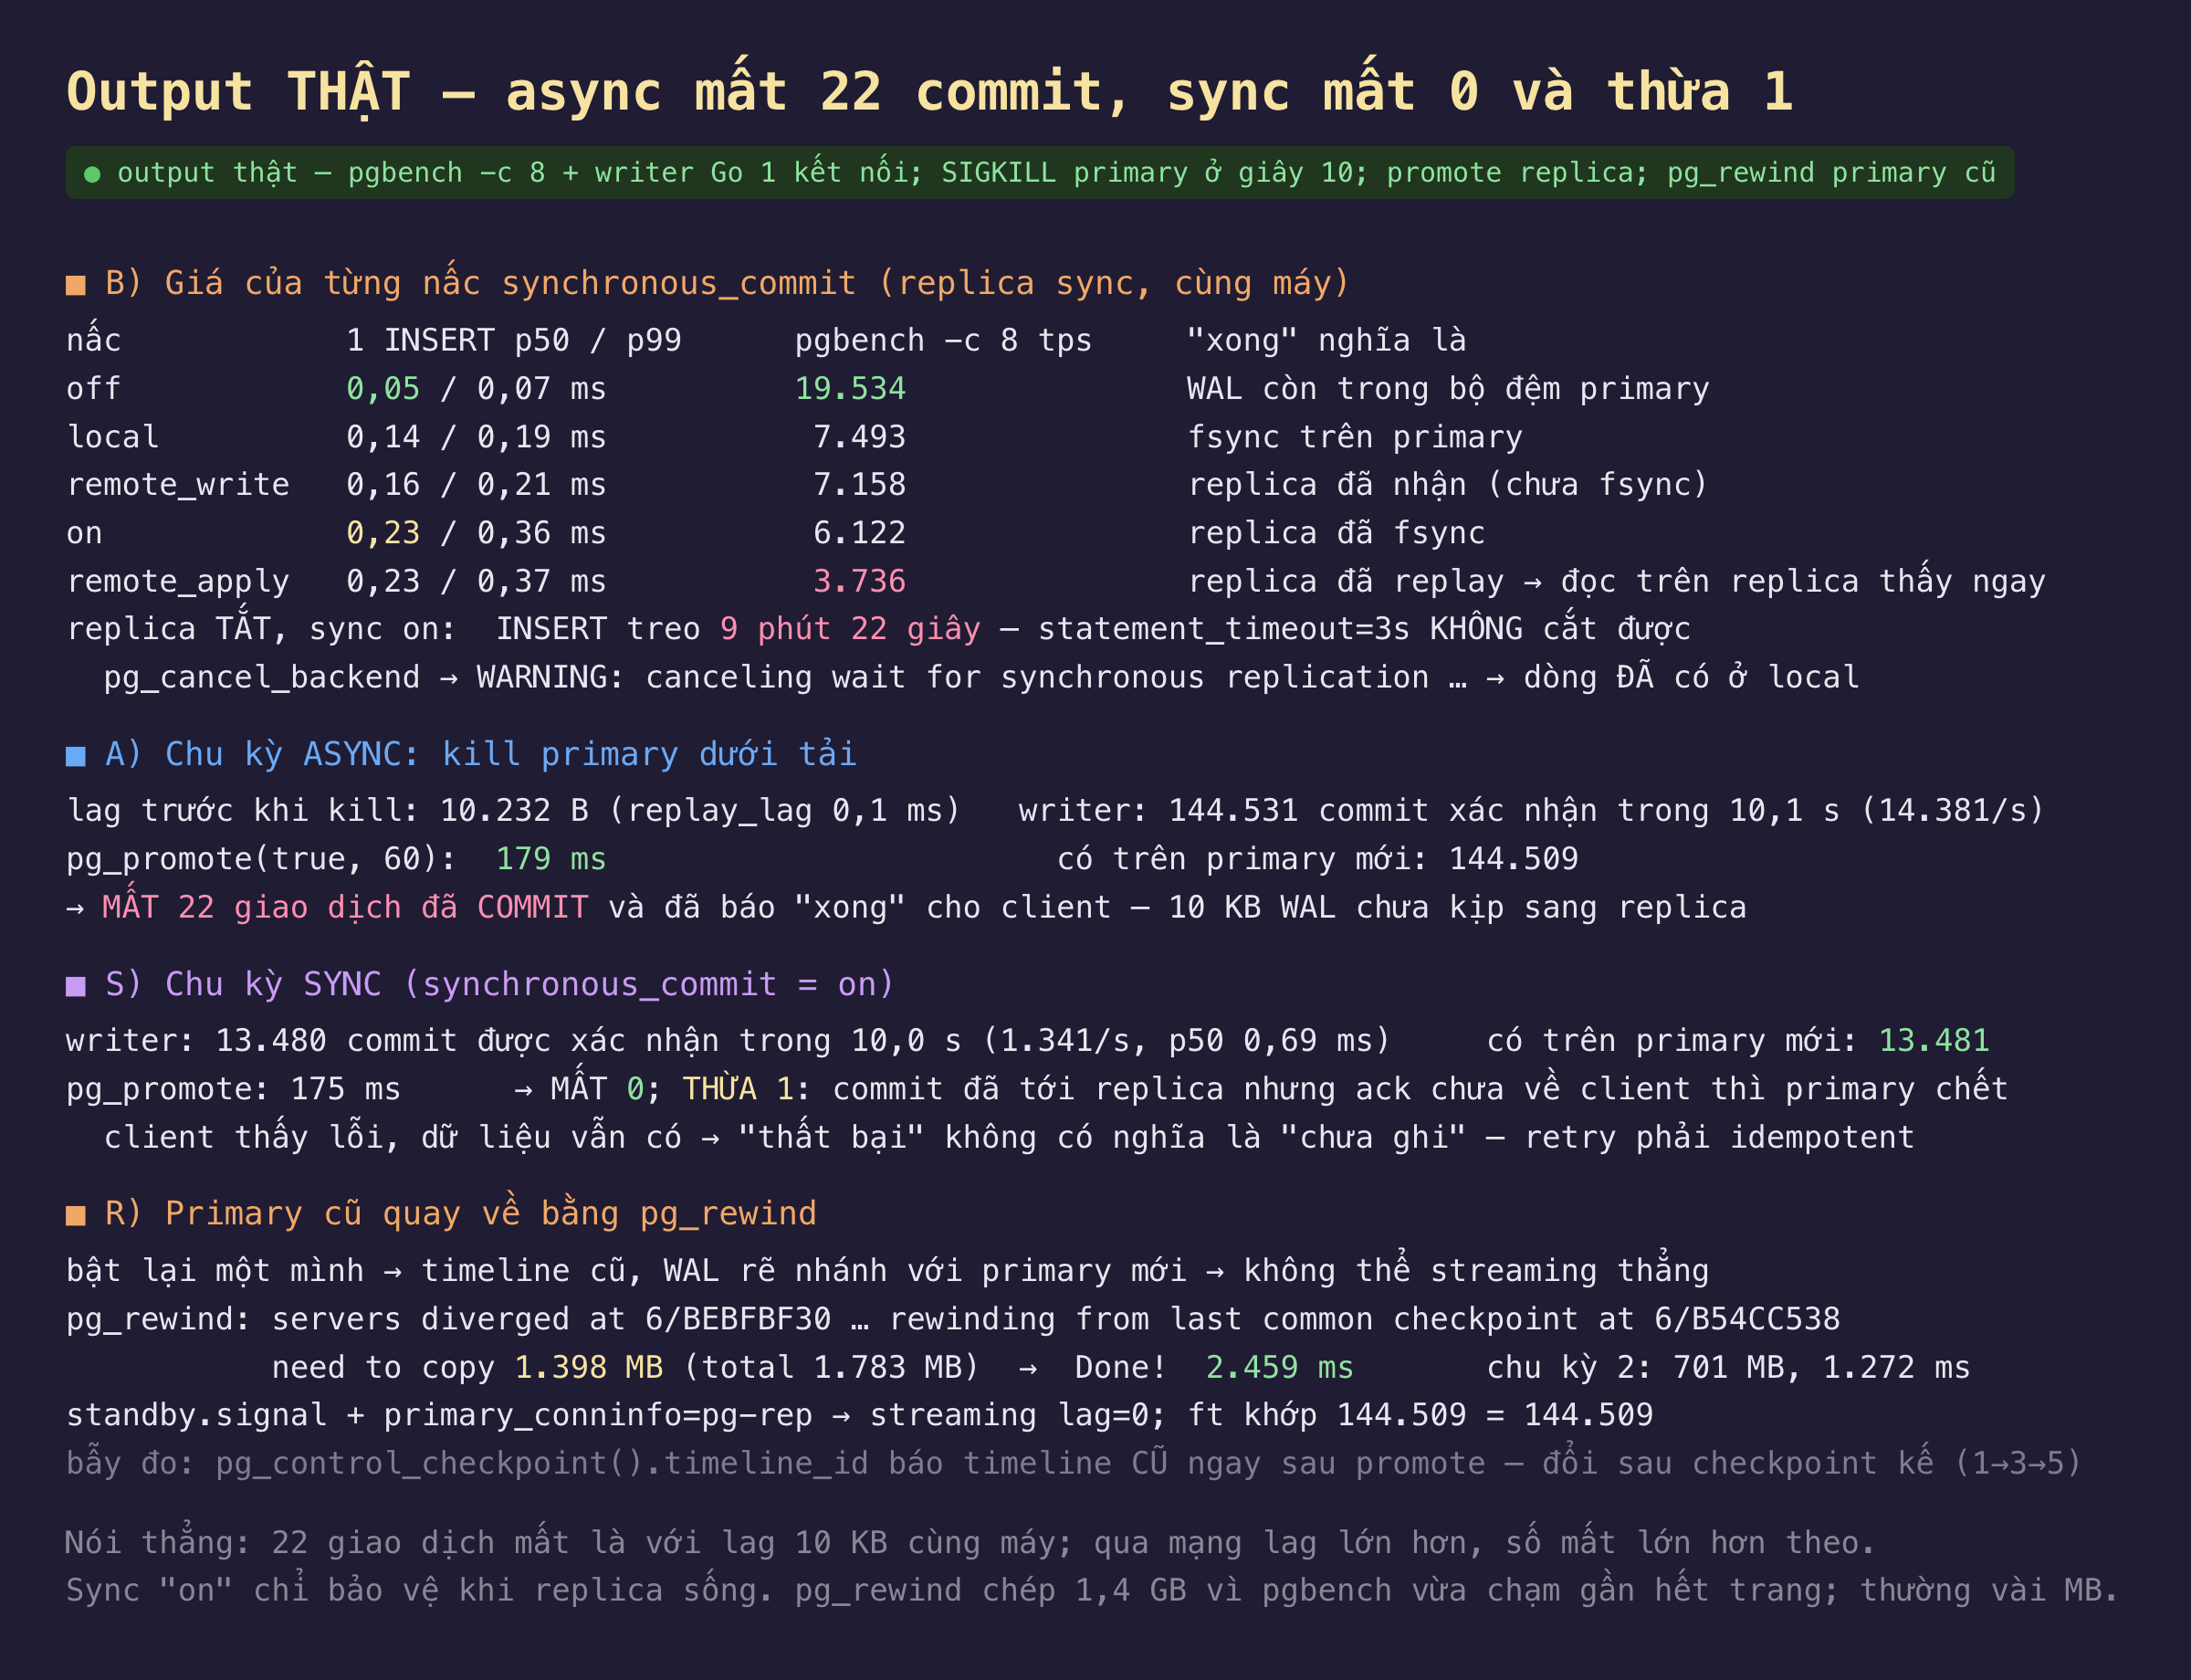
Hình 2: Off tới remote_apply là 0,05 tới 0,23 ms mỗi INSERT và 19.534 xuống 3.736 TPS. Async mất 22 commit đã xác nhận; sync mất 0 và thừa 1. pg_rewind 2,5 giây.
| phép đo | kết quả |
|---|---|
| INSERT p50: off / local / remote_write / on / remote_apply | 0,05 / 0,14 / 0,16 / 0,23 / 0,23 ms |
| pgbench -c 8 TPS theo cùng thứ tự | 19.534 / 7.493 / 7.158 / 6.122 / 3.736 |
replica tắt, sync on, statement_timeout=3s |
INSERT treo 9 phút 22 giây, phải pg_cancel_backend |
| async: xác nhận / có mặt sau promote | 144.531 / 144.509 → mất 22 |
| sync: xác nhận / có mặt sau promote | 13.480 / 13.481 → mất 0, thừa 1 |
pg_promote |
179 ms / 175 ms |
pg_rewind |
1.398 MB trong 2.459 ms; chu kỳ 2: 701 MB trong 1.272 ms |
Mỗi nấc synchronous_commit có giá riêng, và nấc đắt nhất không phải nấc an toàn nhất. INSERT đơn luồng: off 0,05 ms, local 0,14, remote_write 0,16, on và remote_apply cùng 0,23 ms — trên hai container cùng máy, round-trip gần như miễn phí nên khoảng cách giữa local và on chỉ 0,09 ms. Dưới pgbench 8 client, hình dạng khác hẳn: 19.534 TPS ở off, 7.493 ở local (fsync là nút thắt), 6.122 ở on, và 3.736 ở remote_apply — replay đơn luồng trên replica trở thành trần của cả cụm. remote_apply mua được read-your-writes trên replica với giá 39% thông lượng so với on, dù độ trễ một INSERT không khác.
Replica tắt, sync on: INSERT treo 9 phút 22 giây, và statement_timeout không cứu. Đây là mặt tối của đồng bộ. Tắt replica, chạy INSERT với synchronous_commit=on và statement_timeout=3s: câu lệnh không bị huỷ sau 3 giây — nó chờ cho tới khi được huỷ bằng tay sau hơn chín phút. Giao dịch đã commit cục bộ (WAL đã fsync trên primary); nó chỉ chờ xác nhận từ một replica không còn tồn tại, và pha chờ này nằm sau điểm mà statement_timeout còn tác dụng. pg_cancel_backend cắt được, với WARNING: canceling wait for synchronous replication due to user request — và dòng dữ liệu có trong bảng. Một replica đồng bộ duy nhất là một điểm chết chung: nó chết thì primary ngừng nhận ghi. Thực tế dùng ANY 1 (rep1, rep2) với ít nhất hai replica, hoặc chấp nhận async.
Async: mất 22 giao dịch đã COMMIT, với lag chỉ 10 KB. Writer nhận 144.531 xác nhận trong 10 giây rồi unexpected EOF. Promote xong sau 179 ms. Primary mới có 144.509 dòng. 22 giao dịch đã trả về thành công cho client không còn ở đâu — chúng nằm trong 10 KB WAL mà walsender chưa kịp gửi lúc SIGKILL. Đây là định nghĩa thực dụng của "bất đồng bộ": mất một cửa sổ bằng lag tại thời điểm chết. Lag ở đây là của hai container cùng máy; qua mạng thật với replica ở vùng khác, cửa sổ đó là hàng trăm ms và hàng nghìn giao dịch.
Sync: mất 0 — và thừa 1. Cùng kịch bản với synchronous_commit=on: writer được xác nhận 13.480 (chậm hơn 10 lần vì mỗi commit chờ replica), primary mới có 13.481. Không mất gì, và có một dòng nhiều hơn số client được báo: giao dịch cuối cùng đã tới replica, replica đã fsync, nhưng primary chết trước khi gửi xác nhận về. Client thấy lỗi kết nối, coi như thất bại, nhưng dữ liệu đã ở primary mới. Đồng bộ chuyển vấn đề từ "mất dữ liệu đã báo thành công" sang "có dữ liệu đã báo thất bại" — và cái sau chỉ vô hại khi retry của ứng dụng là idempotent. Một lệnh "trừ tiền" retry sau lỗi kết nối là trừ hai lần.
pg_rewind: 1,4 GB trong 2,5 giây, thay vì chép lại toàn bộ. Primary cũ bật lại một mình, nhận crash recovery, rồi tắt sạch. pg_rewind tìm thấy điểm rẽ 6/BEBFBF30, checkpoint chung cuối 6/B54CC538, và chép 1.398 MB trong 1.783 MB — nhiều bất thường vì wal_log_hints vừa bật và pgbench vừa chạm gần hết trang của pgbench_accounts kể từ checkpoint chung; chu kỳ hai chỉ 701 MB. Với cụm bình thường, số này là vài MB tới vài trăm MB, và lợi thế so với basebackup toàn bộ (phần 5: 700 MB cho CSDL này, hàng giờ cho CSDL lớn) mới rõ. Sau rewind, thêm standby.signal và primary_conninfo trỏ sang primary mới: streaming, lag 0, ft khớp 144.509 cả hai bên.
Bẫy đo: timeline trong pg_control_checkpoint() đổi muộn. Ngay sau pg_promote, pg_control_checkpoint().timeline_id vẫn báo timeline cũ — nó là timeline của checkpoint gần nhất, và promote không tạo checkpoint ngay. Sau checkpoint kế tiếp nó mới nhảy: 1 → 3 → 5 qua hai chu kỳ (mỗi chu kỳ promote hai lần). Muốn biết timeline hiện tại tức thì thì đọc tên WAL (pg_walfile_name(pg_current_wal_lsn()), tám ký tự đầu) hoặc log selected new timeline ID.
Đánh đổi cần cân nhắc
Mất 22 hay chậm 10 lần — đó là câu hỏi, không phải "có an toàn không". Async: 14.381 commit/giây một kết nối, mất một cửa sổ bằng lag khi chết. Sync on: 1.341/giây, không mất, nhưng replica chết thì primary treo và ứng dụng phải idempotent. Không có cấu hình đúng chung; có cấu hình đúng theo bảng: synchronous_commit đặt được theo giao dịch, nên bảng thanh toán chạy on và bảng log chạy off trên cùng một cụm.
Promote tự động cần một trọng tài, không phải một script. pg_promote mất 179 ms; phần khó là quyết định promote: primary chết thật hay chỉ mạng đứt? Promote khi primary còn sống là hai primary cùng nhận ghi (split brain), và pg_rewind lúc đó phải vứt một bên. Patroni, repmgr hay Pacemaker tồn tại cho câu hỏi này; phần này cố ý làm tay để thấy từng bước.
Phạm vi đo. Hai container cùng máy nên round-trip gần 0 và lag 10 KB; mọi khoảng cách giữa các nấc synchronous_commit và số giao dịch mất đều là cận dưới. pg_rewind chép nhiều bất thường vì tải pgbench chạm toàn bộ bảng lớn. Chưa chạm: nhiều replica với ANY/FIRST, cascading, và failover có trọng tài.
Ba ý mang về
- Async mất đúng bằng lag lúc chết: 22 commit đã báo thành công biến mất với lag 10 KB; promote chỉ 179 ms nhưng không lấy lại được gì. Sync mất 0 nhưng thừa 1 — client thấy lỗi mà dữ liệu đã ghi, nên retry phải idempotent.
- Giá đồng bộ đo bằng TPS, không bằng độ trễ một lệnh: 0,23 ms so với 0,05 ms nghe nhỏ; 6.122 so với 19.534 TPS và 3.736 ở
remote_applymới là hoá đơn. Và một replica sync duy nhất chết là primary treo 9 phút,statement_timeoutkhông cắt. - Primary cũ quay về bằng
pg_rewind, không chép lại: cầnwal_log_hintsbật trước, tắt sạch một lần sau crash, rồi 2,5 giây; và đừng đọc timeline từpg_control_checkpoint()ngay sau promote.
Nguồn
- PostgreSQL 16 — Synchronous Replication: https://www.postgresql.org/docs/16/warm-standby.html#SYNCHRONOUS-REPLICATION
- PostgreSQL 16 —
synchronous_commit: https://www.postgresql.org/docs/16/runtime-config-wal.html#GUC-SYNCHRONOUS-COMMIT - PostgreSQL 16 — pg_rewind: https://www.postgresql.org/docs/16/app-pgrewind.html
- PostgreSQL 16 —
pg_promotevà Failover: https://www.postgresql.org/docs/16/warm-standby-failover.html - Patroni — Replication modes (synchronous_mode, maximum_lag_on_failover): https://patroni.readthedocs.io/en/latest/replication_modes.html
Phần sau đổi sang kiểu sao chép thứ hai: logical replication. Thay vì chép byte WAL sang một bản sao y hệt, nó chép dòng của một bảng sang một cụm khác đang chạy việc khác — đo lag, và đo những thứ nó không chép: DDL, sequence, và xung đột khi hai bên cùng ghi.
