Khi một service production gặp sự cố lúc 2 giờ sáng, thứ quyết định bạn tìm ra nguyên nhân trong 5 phút hay 5 giờ là observability — khả năng quan sát hệ thống từ bên ngoài. Và observability dựng trên ba trụ cột: metrics, logs, traces. Người mới thường nghĩ chúng là ba cách làm cùng một việc, rồi chọn một cái. Sai lầm: chúng trả lời ba câu hỏi khác nhau, và một hệ thống quan sát tốt cần cả ba, phối hợp với nhau.
Đây là bài mở đầu loạt "Observability thực chiến cho backend". Thay vì định nghĩa trừu tượng, mình dựng một Go app thật được instrument, cho Prometheus scrape, rồi nhìn cùng một request qua cả ba lăng kính trên pg... trên obs-prom.
Ba lăng kính, ba câu hỏi
- Metrics: số tổng hợp theo thời gian (counter, gauge, histogram). Trả lời "hệ thống có khỏe không? xu hướng ra sao?". Rẻ (đã gộp sẵn), giữ lâu — nền của dashboard và cảnh báo.
- Logs: sự kiện rời rạc, lý tưởng là có cấu trúc (JSON). Trả lời "chuyện gì đã xảy ra chính xác?". Chi tiết nhất về một sự kiện đơn lẻ.
- Traces: hành trình của một request qua các service (chuỗi span). Trả lời "request này chậm/lỗi ở bước nào?". Đắt (mỗi request), nhưng vô giá để định vị trong hệ phân tán.
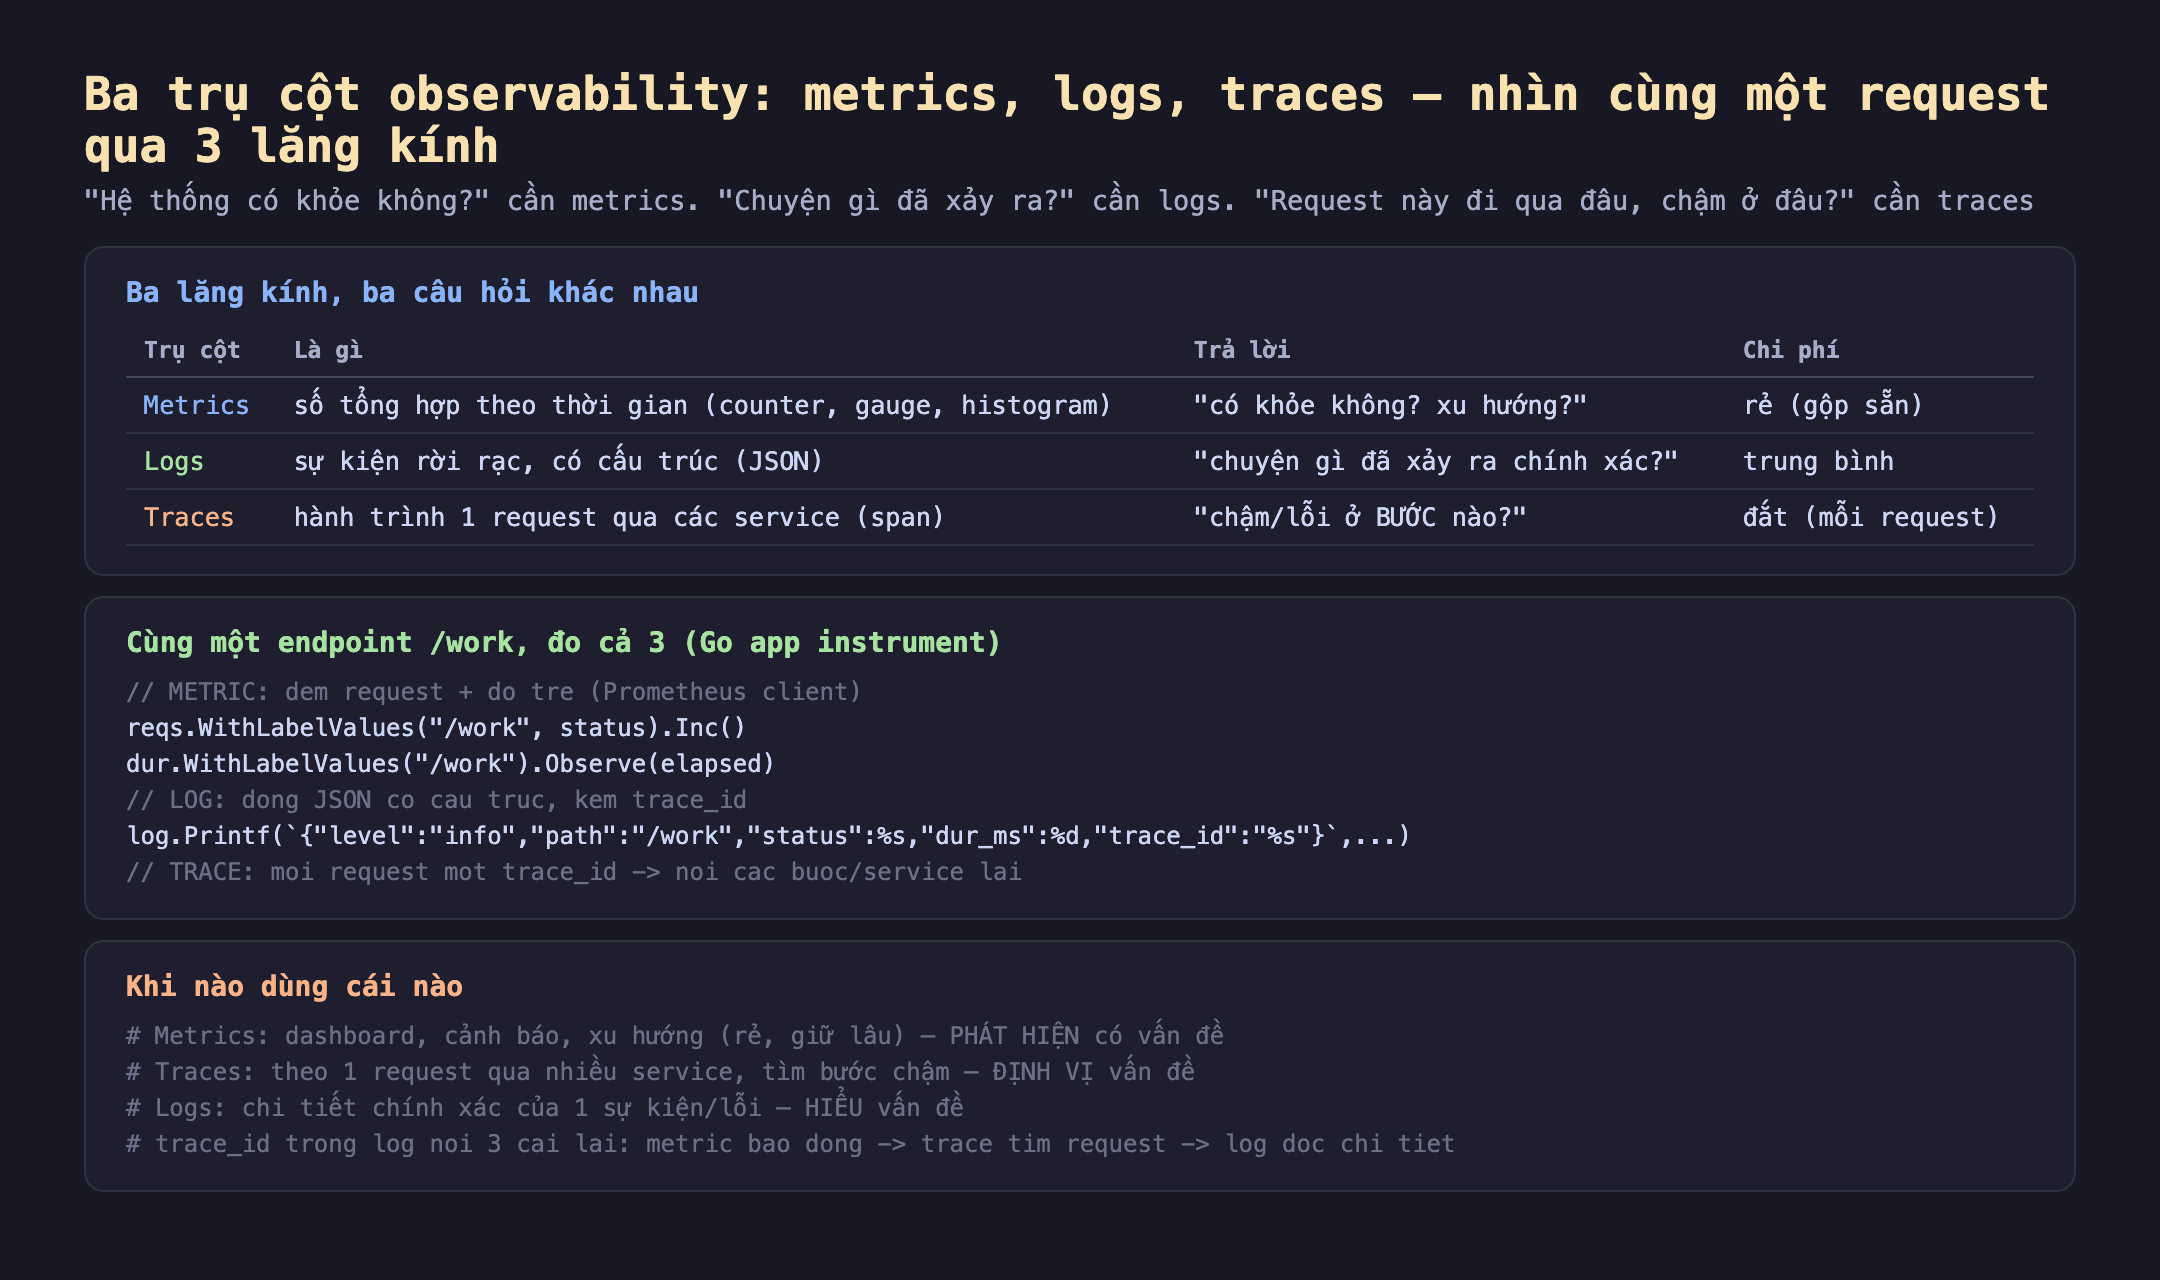
Hình 1: Ba trụ cột trả lời ba câu hỏi. Metrics (tổng hợp, rẻ) phát hiện vấn đề; traces (hành trình request, đắt) định vị; logs (chi tiết sự kiện) hiểu. trace_id nối cả ba: metric báo động → trace tìm request → log đọc chi tiết.
// Cung endpoint /work, do ca 3:
reqs.WithLabelValues("/work", status).Inc()          // METRIC: dem
dur.WithLabelValues("/work").Observe(elapsed)        // METRIC: do tre
log.Printf(`{"path":"/work","status":%s,"dur_ms":%d,"trace_id":"%s"}`,...)  // LOG co trace_id
// TRACE: moi request mot trace_id, noi cac buoc/service lai
Đo thật: cùng một endpoint qua ba trụ cột
Mình chạy một Go app instrument (Prometheus client) trên go-lab, cho obs-prom scrape, gửi 100 request tới /work (ngẫu nhiên ~10% trả lỗi 500). Rồi nhìn qua ba lăng kính. Kết quả thật:
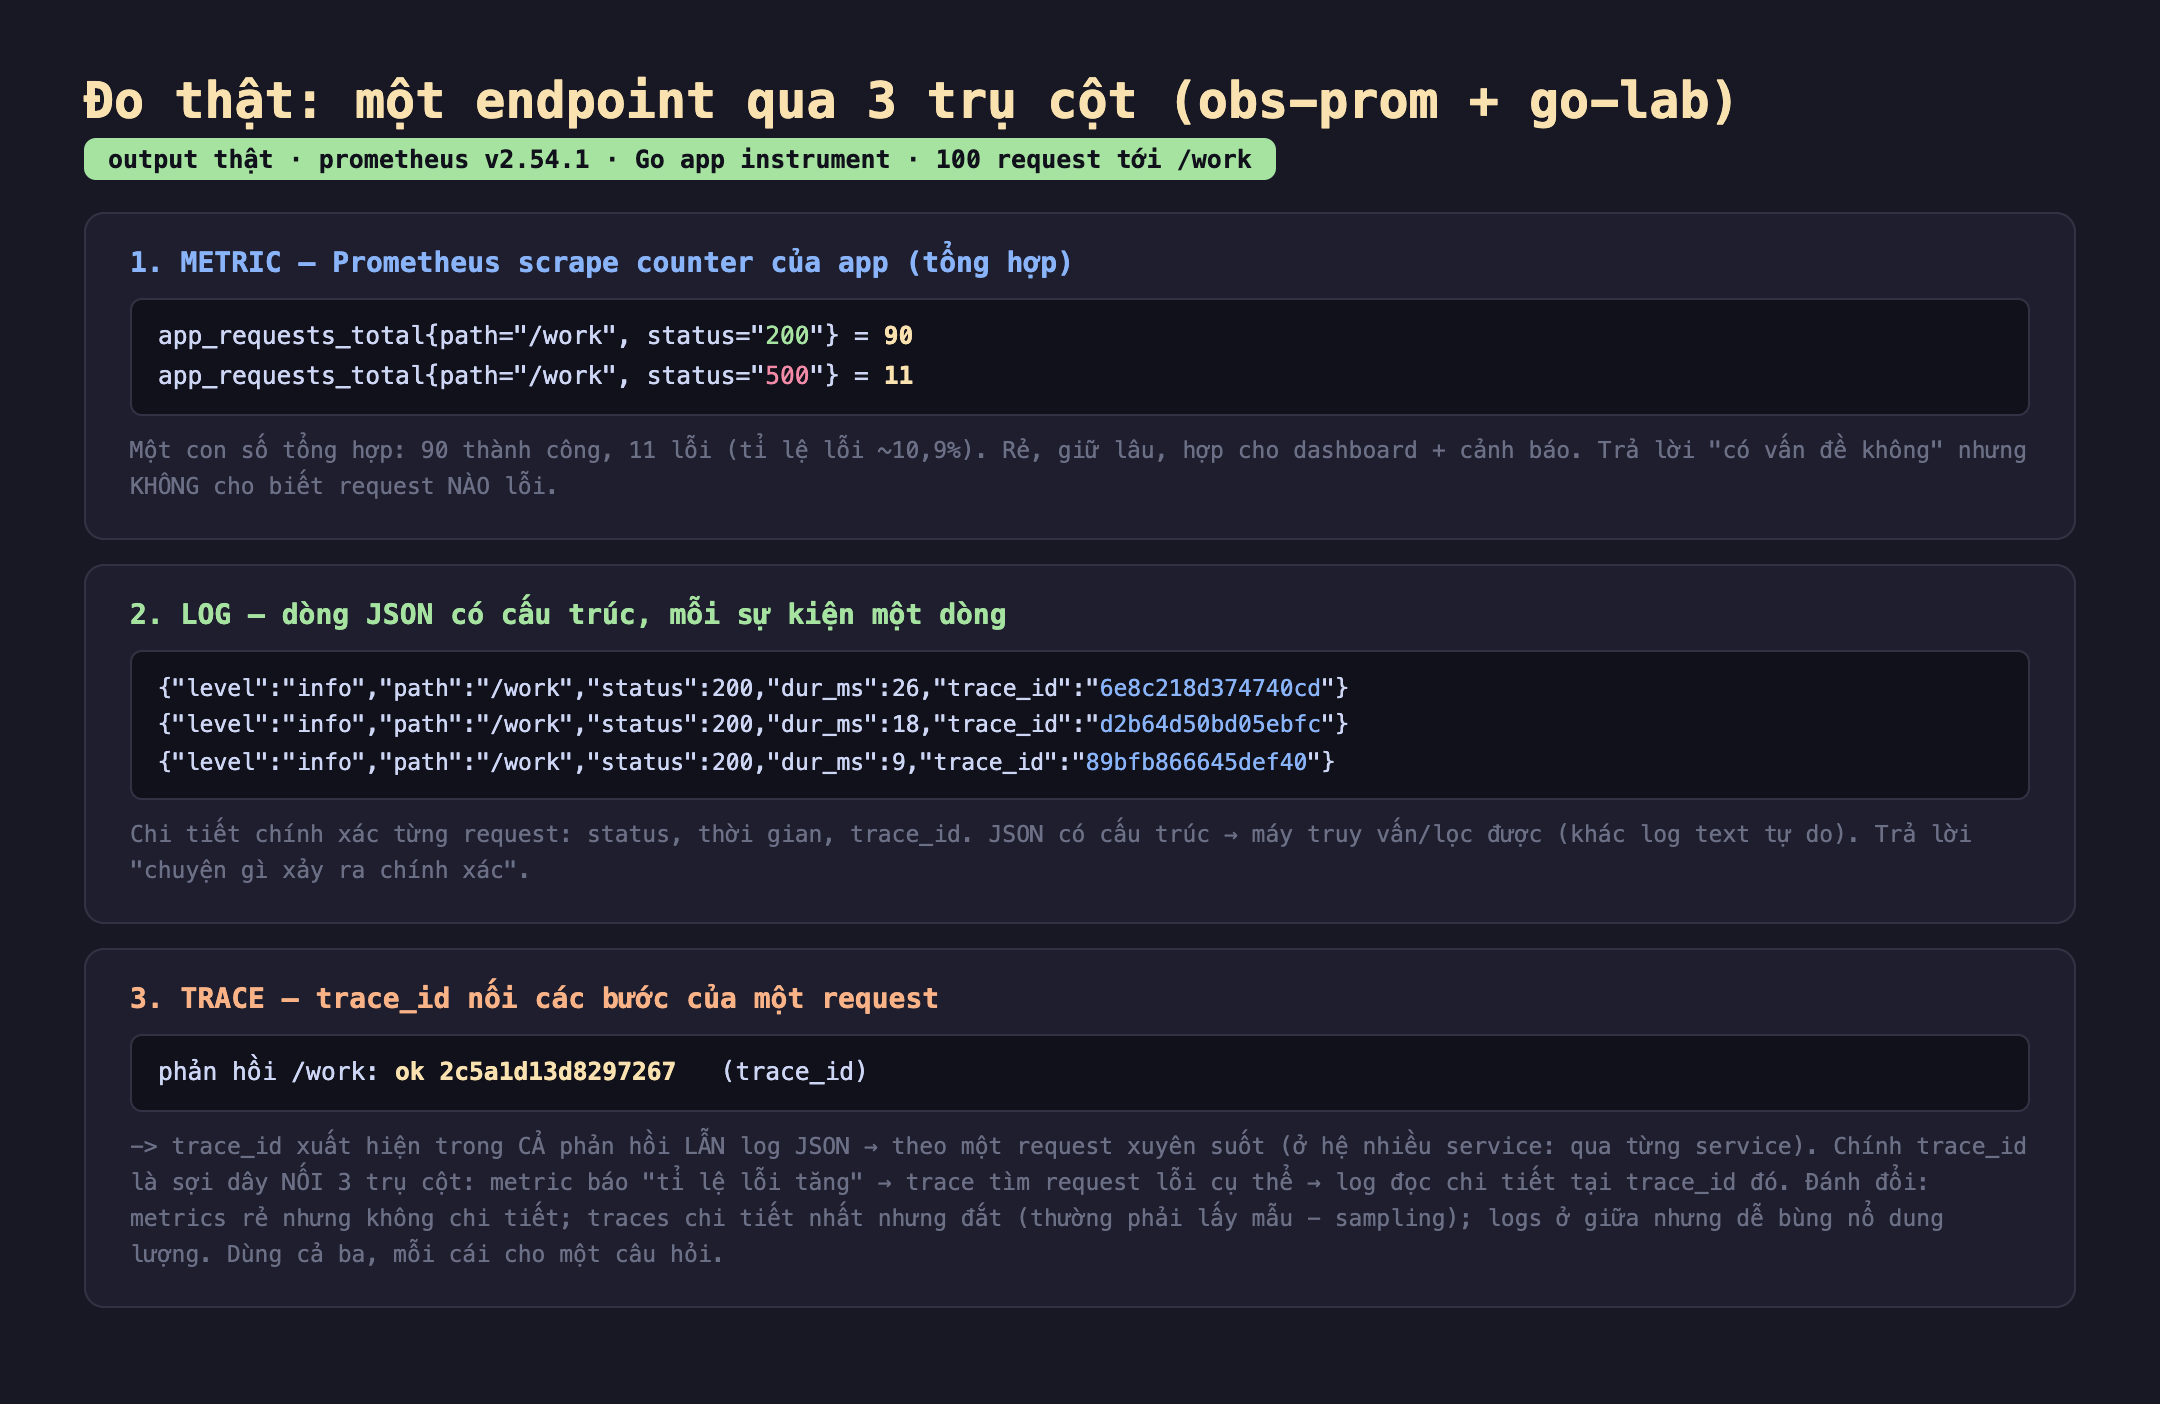
Hình 2: Kết quả thật. Metric: 90 thành công / 11 lỗi (tổng hợp). Log: dòng JSON chi tiết từng request kèm trace_id. Trace: trace_id nối phản hồi với log của cùng request. Ba câu trả lời cho ba câu hỏi.
- 1. METRIC (từ Prometheus):
app_requests_total{status="200"} = 90,{status="500"} = 11. Một con số tổng hợp: 90 thành công, 11 lỗi (tỉ lệ lỗi ~10,9%). Rẻ, giữ lâu, hợp cho dashboard và cảnh báo. Nhưng nó không cho biết request nào lỗi. - 2. LOG (JSON có cấu trúc): mỗi request một dòng JSON với
status,dur_ms,trace_id. Chi tiết chính xác từng request; vì là JSON (không phải text tự do), máy có thể truy vấn và lọc được. Trả lời "chuyện gì xảy ra chính xác". - 3. TRACE (trace_id): mỗi request có một
trace_idxuất hiện trong cả phản hồi lẫn log. Đây là sợi dây theo một request xuyên suốt — trong hệ nhiều service, trace_id đi qua từng service để ghép lại thành hành trình đầy đủ.
Mấu chốt: trace_id là sợi dây nối ba trụ cột. Quy trình điều tra sự cố thực tế là: metric báo "tỉ lệ lỗi tăng" (phát hiện) → trace tìm một request lỗi cụ thể và xem nó chậm/hỏng ở service nào (định vị) → log đọc chi tiết chính xác tại trace_id đó (hiểu). Thiếu một trụ cột, bạn mất một bước trong chuỗi này.
Đánh đổi cần cân nhắc
Ba trụ cột khác nhau về chi phí — chọn độ phủ hợp lý cho từng cái. Metrics rẻ nhất (gộp sẵn thành vài time series, giữ được hàng tháng) nhưng mất chi tiết — bạn biết "10% lỗi" chứ không biết request nào. Traces chi tiết nhất nhưng đắt nhất (mỗi request một trace, tốn lưu trữ và overhead), nên production thường lấy mẫu (sampling — chỉ giữ 1% traces, hoặc giữ 100% traces lỗi). Logs ở giữa nhưng dễ bùng nổ dung lượng (một service bận ghi hàng GB log/ngày). Chiến lược đúng: metrics cho mọi thứ (rẻ), logs có cấu trúc + giữ ngắn hạn, traces lấy mẫu + giữ 100% khi lỗi.
Structured logging (JSON) đáng giá hơn log text tự do nhiều. Log "xu ly request /work mat 26ms" đẹp cho mắt người nhưng máy khó truy vấn: muốn "tìm mọi request /work chậm >100ms" phải regex mong manh. Log JSON {"path":"/work","dur_ms":26} cho phép truy vấn có cấu trúc (lọc theo trường, gộp, cảnh báo). Chi phí: hơi khó đọc bằng mắt thô, và tốn byte hơn chút. Nhưng ở quy mô mà bạn cần observability, truy vấn được là bắt buộc — luôn log có cấu trúc.
Observability không miễn phí — instrument có overhead và cần kỷ luật. Mỗi metric, log, span đều tốn CPU/bộ nhớ/mạng để tạo và gửi. Instrument quá tay (quá nhiều metric cardinality cao — bài 7, log mọi thứ, trace 100% không sampling) có thể làm chính observability trở thành gánh nặng hiệu năng và chi phí lớn hơn cả ứng dụng. Mục tiêu không phải "đo mọi thứ" mà "đo đúng thứ cần để trả lời câu hỏi vận hành". Các bài sau sẽ đo cụ thể chi phí này.
Ba ý mang về
- Metrics, logs, traces trả lời ba câu hỏi khác nhau, cần cả ba. Đo thật cùng endpoint /work: metric cho 90 thành công/11 lỗi (có vấn đề không?), log JSON cho chi tiết từng request (chuyện gì xảy ra?), trace_id nối các bước (lỗi ở đâu?). Đừng chọn một — mỗi cái cho một câu hỏi.
- trace_id là sợi dây nối ba trụ cột. Quy trình điều tra: metric phát hiện → trace định vị request → log hiểu chi tiết. trace_id xuất hiện trong cả log và trace giúp nhảy từ "có lỗi" tới "chính xác request này hỏng ở đây".
- Ba trụ cột khác nhau về chi phí — phối hợp thông minh. Metrics rẻ (dùng cho mọi thứ, cảnh báo); traces đắt (lấy mẫu, giữ 100% khi lỗi); logs dễ bùng nổ (có cấu trúc, giữ ngắn hạn). Observability có overhead — đo đúng thứ cần, không đo mọi thứ.
Nguồn
- Prometheus docs — Overview & data model: https://prometheus.io/docs/introduction/overview/
- OpenTelemetry — Observability primer (metrics, logs, traces): https://opentelemetry.io/docs/concepts/observability-primer/
- Google SRE Book — Monitoring Distributed Systems: https://sre.google/sre-book/monitoring-distributed-systems/
Phần sau ta đi sâu vào bốn loại metric của Prometheus — counter, gauge, histogram, summary — khi nào dùng cái nào, và đo thật chúng trên một Go app được instrument.
