Ở các bài trước ta xây khối cho hệ thống phân tán: circuit breaker, retry, idempotency. Nhưng khi một request thật đi qua năm dịch vụ và trả về chậm, câu hỏi đầu tiên là: thời gian nằm ở đâu? Log rời rạc không trả lời được — mỗi dịch vụ ghi log riêng, không có sợi chỉ nối chúng lại, và bạn không biết dòng log ở dịch vụ A ứng với request nào ở dịch vụ C.
Distributed tracing là câu trả lời. Nó gán cho mỗi request một trace_id chung, chia công việc thành các span (đoạn công việc có tên và thời gian), và nối chúng bằng quan hệ cha-con. OpenTelemetry là chuẩn mở để làm việc này, và Go có SDK chính thức. Bài này dựng một cây trace thật, giải thích cơ chế context truyền quan hệ cha-con, và đo thẳng chi phí của việc gắn trace — vì tracing không miễn phí.
Vấn đề: log rời rạc không dựng lại được dòng thời gian
Một request GET /donhang gọi database rồi gọi cache. Ba nơi này log riêng. Khi request tốn 9ms, bạn không biết DB chiếm bao nhiêu, cache bao nhiêu, hay phần nào là mạng. Trace giải quyết bằng cách coi mỗi đoạn là một span, tất cả mang cùng trace_id, và mỗi span con ghi rõ span cha của nó — từ đó dựng lại được cây thời gian đầy đủ.
Dựng tracer và một cây span
OpenTelemetry Go tách bạch: TracerProvider (nhà máy tracer, gắn với exporter đẩy span đi đâu đó), Tracer (tạo span), và Span (đoạn công việc). Ở đây tôi viết một exporter tự chụp span vào bộ nhớ để in ra — production sẽ đẩy tới Jaeger/Tempo/OTLP collector.
tp := sdktrace.NewTracerProvider(sdktrace.WithSyncer(exp))
otel.SetTracerProvider(tp)
tracer := otel.Tracer("shop")

// span gốc; ctx MANG span hiện tại đi theo
ctx, root := tracer.Start(context.Background(), "GET /donhang")
root.SetAttributes(attribute.String("http.method", "GET"))
truyVanDB(ctx, tracer) // truyền ctx -> span con của root
goiCache(ctx, tracer)
root.End()
Mỗi dịch vụ con tạo span của nó bằng cách nhận ctx và gọi tracer.Start:
func truyVanDB(ctx context.Context, tr trace.Tracer) {
	_, sp := tr.Start(ctx, "db.query") // cha = span trong ctx
	defer sp.End()
	sp.SetAttributes(attribute.String("db.system", "postgresql"))
	time.Sleep(5 * time.Millisecond) // giả lập truy vấn
}
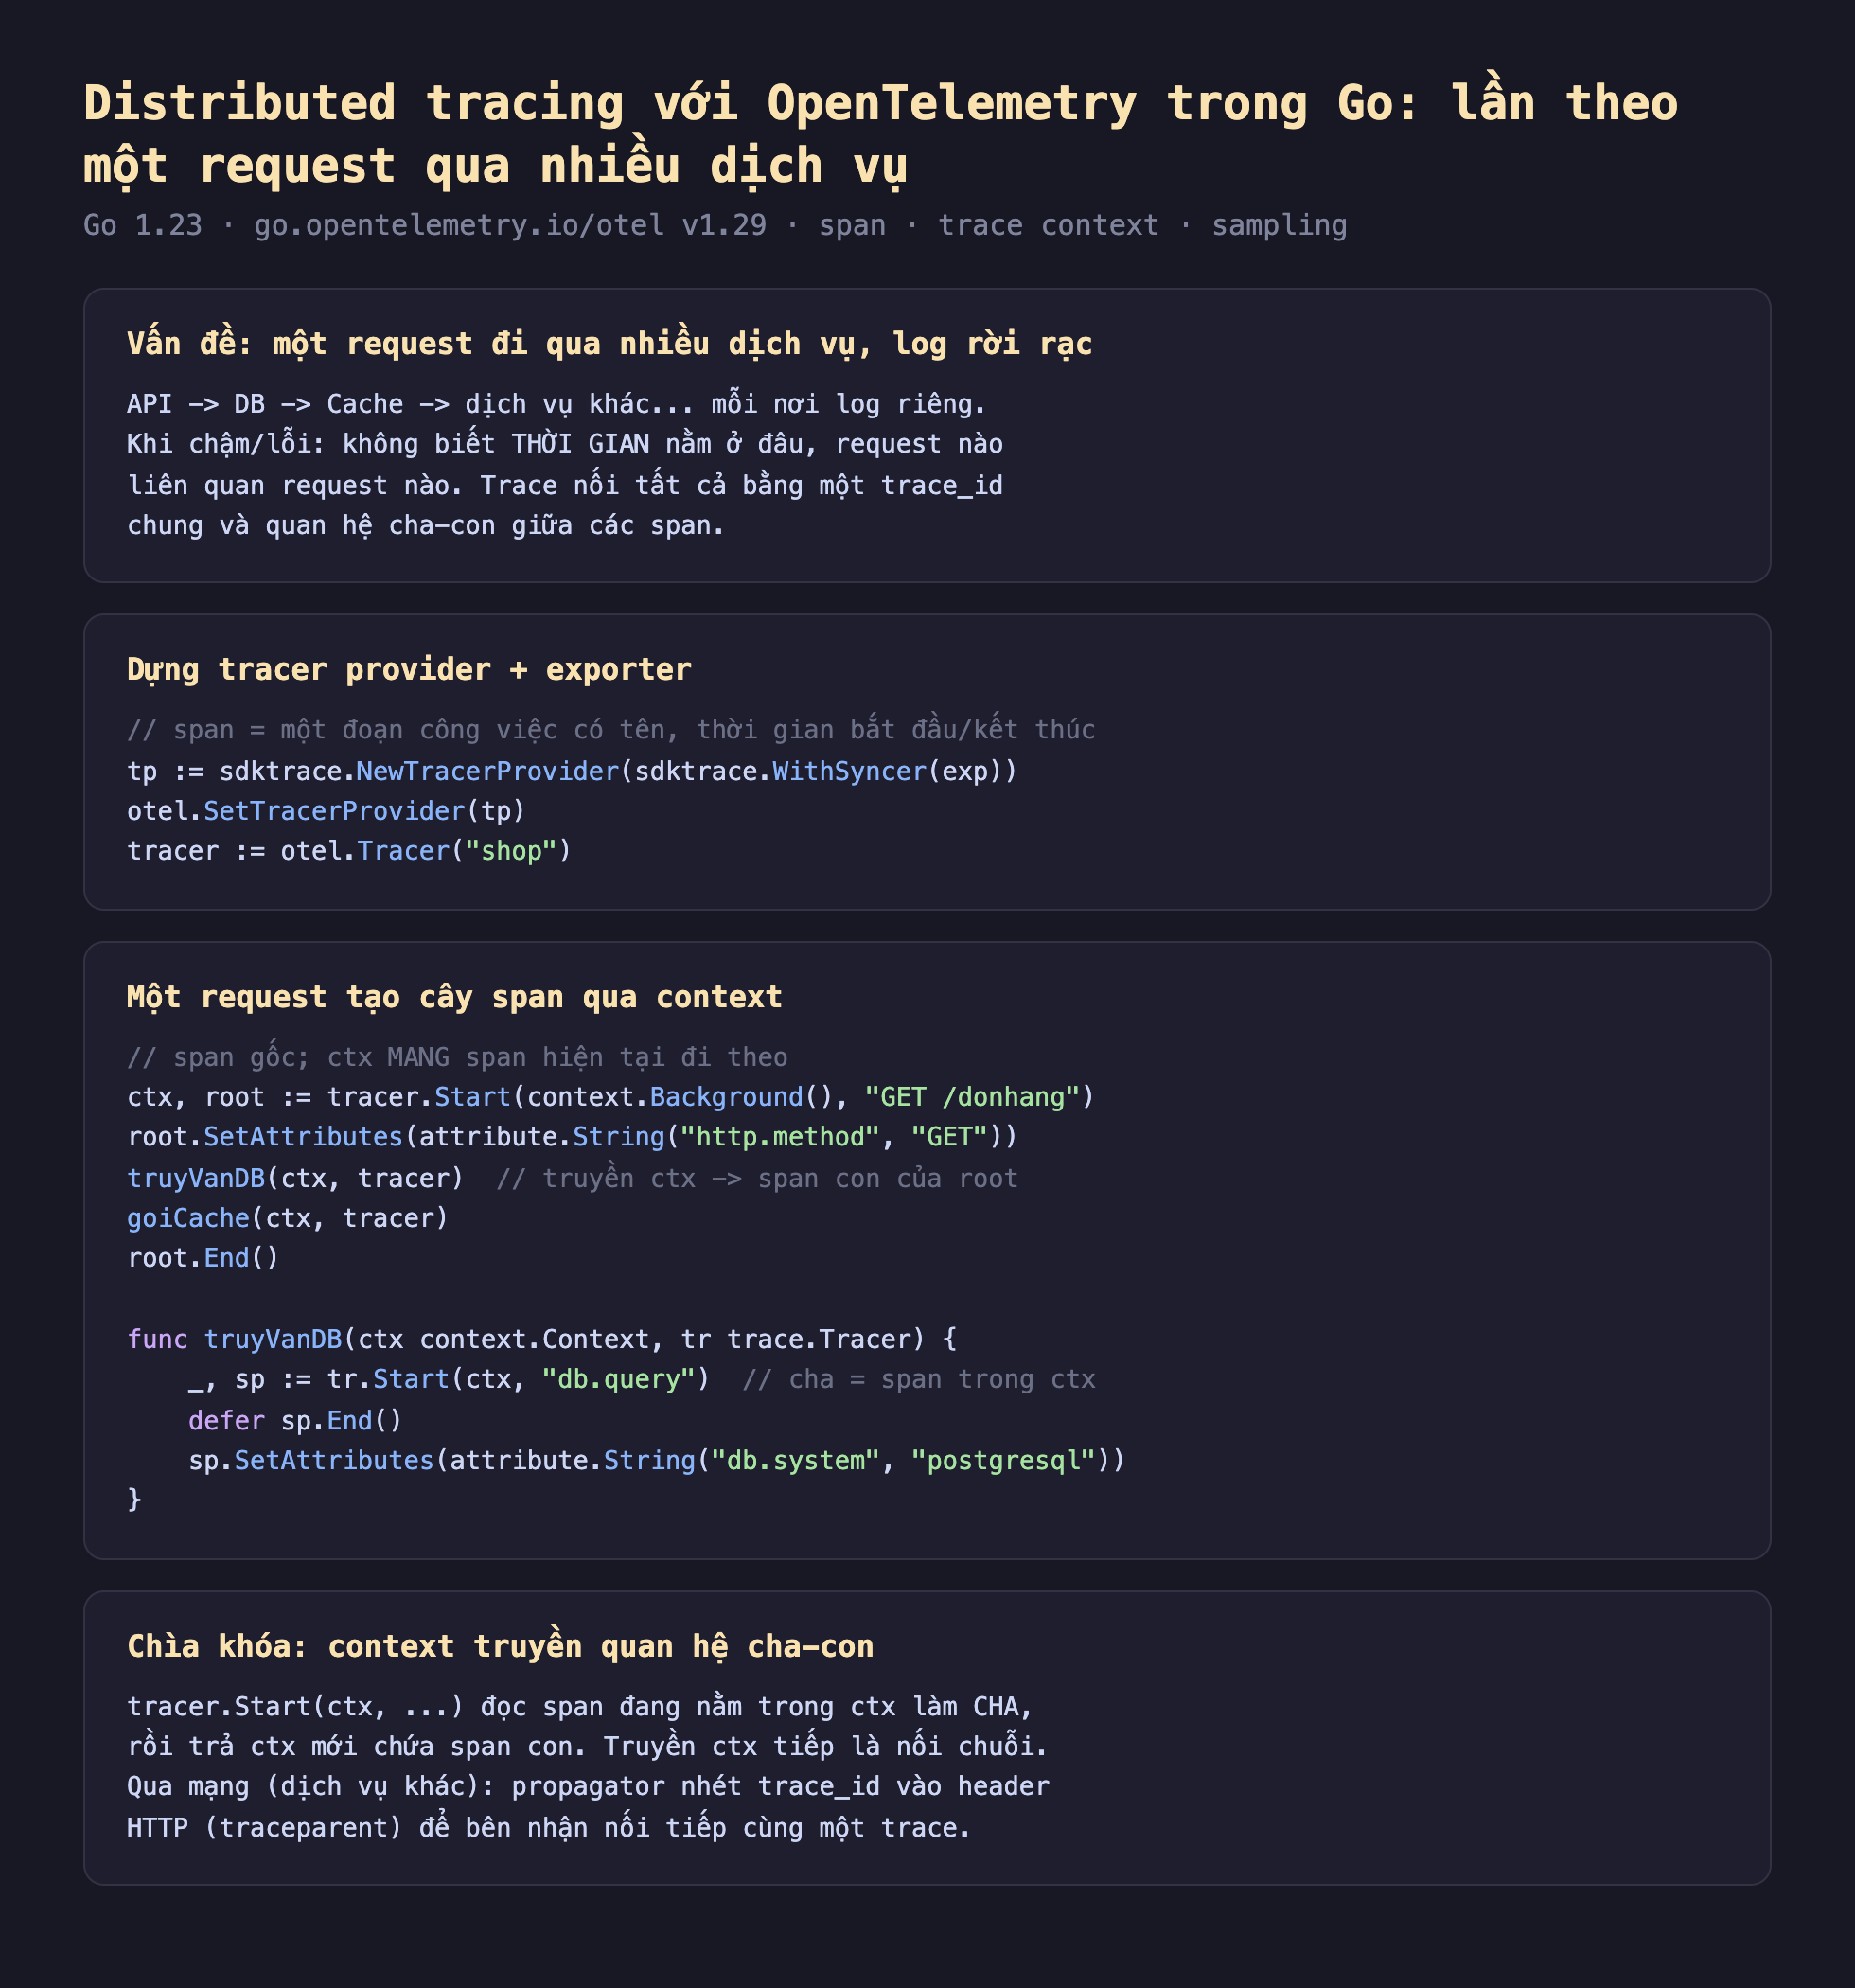
Hình 1: Cơ chế OpenTelemetry trong Go: TracerProvider gắn exporter, tracer.Start tạo span, và context.Context truyền span hiện tại làm cha cho span kế tiếp — sợi chỉ nối cả cây trace.
Chìa khóa: context truyền quan hệ cha-con
Điểm cốt lõi khiến tracing hoạt động là context.Context. Khi bạn gọi tracer.Start(ctx, ...), nó đọc span đang nằm trong ctx làm cha, tạo span con, và trả về một ctx mới chứa span con đó. Truyền ctx mới này xuống hàm tiếp theo là cách chuỗi cha-con được nối tự động — không cần truyền span thủ công qua mọi tầng.
Đây cũng là lý do quy ước Go "context là tham số đầu tiên" quan trọng đến vậy trong dịch vụ thật: ctx không chỉ mang deadline và cancel (như các bài context trước đã đo), nó còn mang cả span hiện tại. Khi request đi qua mạng sang một dịch vụ khác, một propagator nhét trace_id và span cha vào header HTTP (traceparent theo chuẩn W3C), để dịch vụ bên nhận đọc ra và nối tiếp cùng một trace. Đó chính là chữ "distributed".
Đo thật: cây trace nối bằng trace_id
Chạy demo, ta bắt được ba span thật:
Trace bắt được: 3 span
  span=28786179  tên=GET /donhang  cha=(gốc)     thời_gian=9.065ms
  span=a6d58e18  tên=db.query      cha=28786179  thời_gian=5.586ms
  span=acce8203  tên=cache.get     cha=28786179  thời_gian=1.14ms
Tất cả cùng 1 trace_id: 4b98575c034ae3ec ...
Đọc được ngay: db.query và cache.get đều có cha = 28786179 — chính là span gốc GET /donhang. Cả ba mang cùng trace_id. Từ đây công cụ trace dựng lại toàn bộ dòng thời gian: request tốn 9ms, trong đó DB chiếm 5,6ms (nghi phạm chính), cache chỉ 1,1ms. Đây là thứ log rời rạc không bao giờ cho được — một bức tranh nhân-quả có cấu trúc.
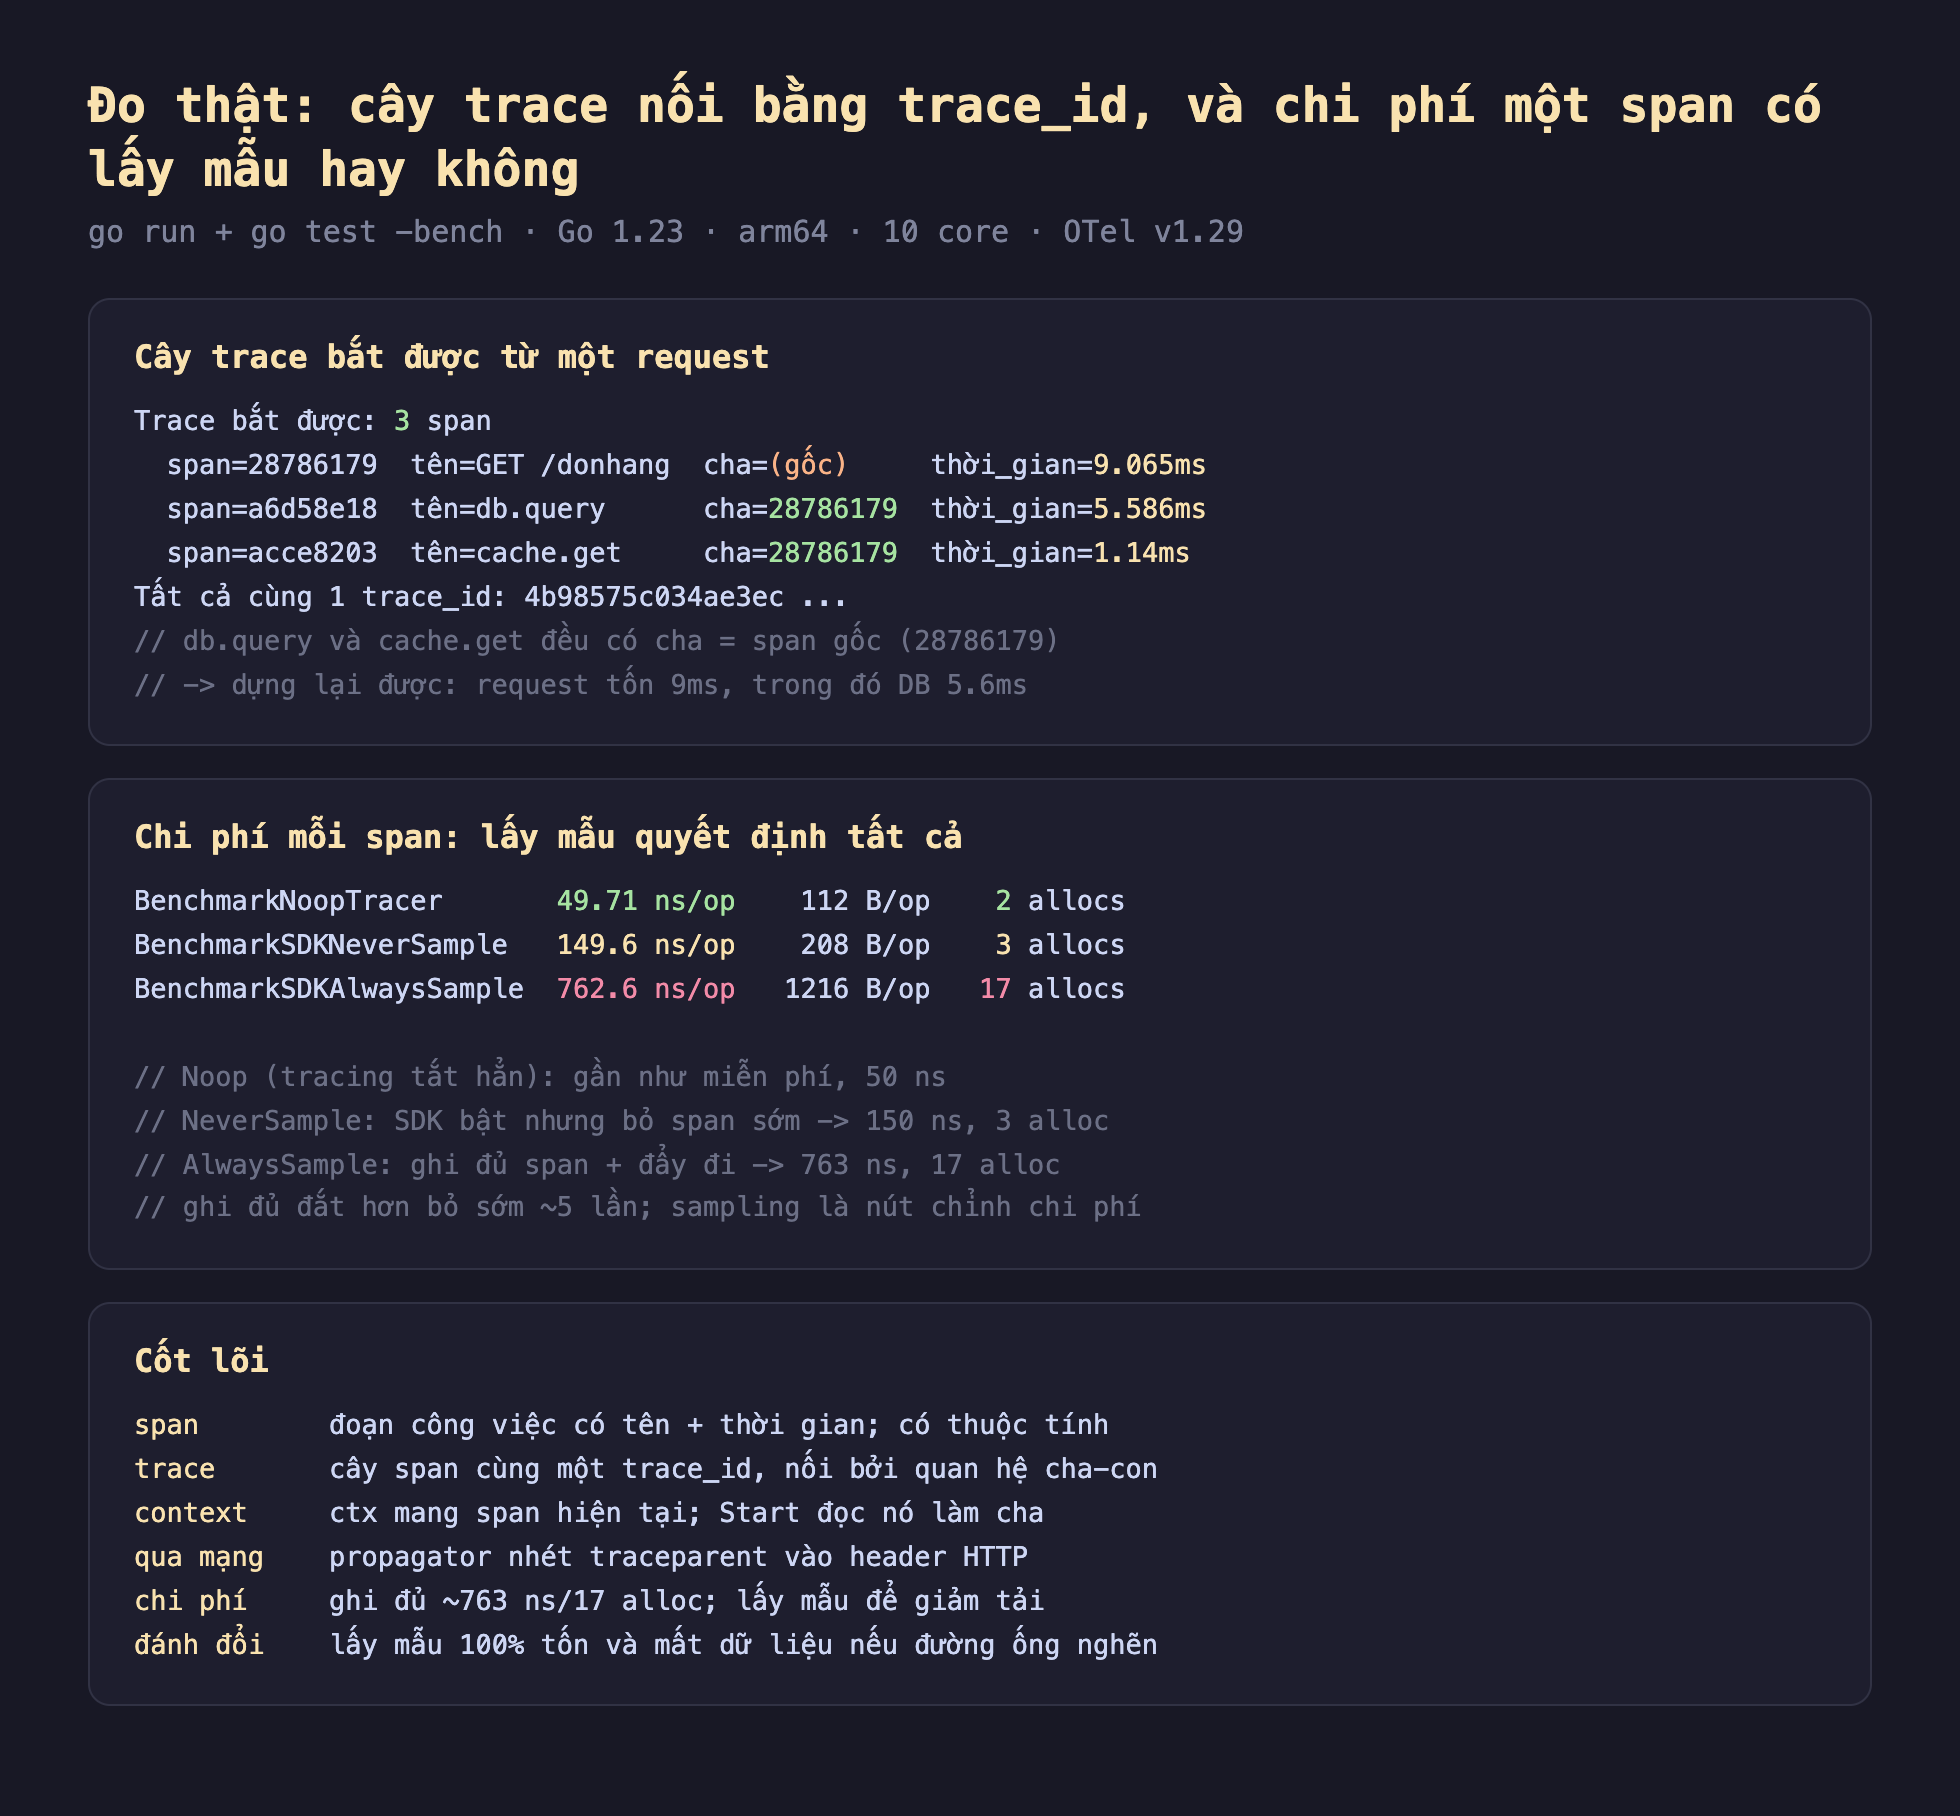
Hình 2: Cây trace thật (3 span cùng trace_id, hai span con trỏ về span gốc) và chi phí mỗi span đo bằng benchmark: 50 ns khi tắt, 150 ns khi bỏ mẫu sớm, 763 ns và 17 cấp phát khi ghi đủ.
Đo thật: chi phí một span, và vai trò của sampling
Tracing không miễn phí. Mỗi span tốn CPU và cấp phát bộ nhớ. Tôi benchmark ba trường hợp: tracer no-op (tracing tắt hẳn), SDK với NeverSample (bật nhưng bỏ span sớm), và SDK với AlwaysSample (ghi đủ span rồi đẩy đi):
BenchmarkNoopTracer       49.71 ns/op    112 B/op    2 allocs
BenchmarkSDKNeverSample   149.6 ns/op    208 B/op    3 allocs
BenchmarkSDKAlwaysSample  762.6 ns/op   1216 B/op   17 allocs
Con số kể một câu chuyện rõ ràng:
- Noop (50 ns, 2 alloc): khi không cắm SDK, span gần như miễn phí — chỉ là vài thao tác con trỏ. Bạn có thể để lời gọi tracing trong code mà không lo gì khi tắt.
- NeverSample (150 ns, 3 alloc): SDK bật nhưng bộ lấy mẫu quyết định không ghi span này, nên nó bỏ sớm phần đắt tiền (không cấp phát cấu trúc span đầy đủ, không đẩy đi).
- AlwaysSample (763 ns, 17 alloc): ghi đủ — tạo cấu trúc span, lưu thuộc tính, đưa vào hàng đợi xuất. Đắt hơn NeverSample khoảng 5 lần về thời gian và gấp 5-6 lần về cấp phát.
Bài học: sampling là nút chỉnh chi phí tracing. Trên dịch vụ lưu lượng cao, ghi đủ 100% span vừa tốn CPU/bộ nhớ vừa tạo khối lượng dữ liệu khổng lồ ở backend. Lấy mẫu (ví dụ 1-10%, hoặc lấy mẫu theo lỗi/độ trễ) giữ được khả năng quan sát ở chi phí chấp nhận được.
Đánh đổi cần cân nhắc
Lấy mẫu là đánh đổi giữa chi phí và độ phủ. Lấy mẫu ít thì rẻ nhưng có thể bỏ lỡ đúng cái request lỗi bạn cần điều tra. Chiến lược thực tế thường là "tail-based sampling": quyết định giữ trace sau khi biết nó có lỗi hay chậm bất thường, thay vì quyết định mù ngay từ đầu (head-based). Đổi lại, tail-based cần buffer toàn bộ span của một trace ở collector — phức tạp hơn.
Instrument thủ công tốn công; dùng thư viện có sẵn. Demo này tạo span bằng tay để thấy cơ chế. Thực tế, otelhttp, otelgrpc và các gói contrib tự động tạo span ở ranh giới HTTP/gRPC/DB — bạn chỉ cần wrap handler. Chỉ instrument thủ công cho những đoạn nghiệp vụ mà thư viện không thấy.
Đường ống xuất là điểm nghẽn tiềm tàng. Span phải được đẩy tới collector. Nếu collector chậm hoặc chết, BatchSpanProcessor (dùng hàng đợi có giới hạn) sẽ rớt span khi đầy thay vì làm nghẽn ứng dụng — đúng thiết kế, nhưng nghĩa là dữ liệu trace không được đảm bảo đầy đủ. Đừng dùng trace làm nguồn số liệu chính xác tuyệt đối (đó là việc của metrics — bài sau); trace là để chẩn đoán.
Ba ý mang về
- Distributed tracing nối một request qua nhiều dịch vụ bằng
trace_idchung và quan hệ cha-con giữa span — đo thật, ba span cùng một trace dựng lại được request 9ms trong đó DB chiếm 5,6ms, thứ log rời rạc không cho được. context.Contextlà sợi chỉ:tracer.Start(ctx, ...)đọc span trong ctx làm cha và trả ctx mới chứa span con; qua mạng thì propagator nhéttraceparentvào header HTTP để bên nhận nối tiếp cùng trace.- Tracing không miễn phí — sampling là nút chỉnh: đo thật một span tốn 50 ns khi tắt, 150 ns khi bỏ mẫu sớm, 763 ns và 17 cấp phát khi ghi đủ; lưu lượng cao phải lấy mẫu để cân bằng chi phí với độ phủ.
Bài tập làm thử
Bài 1 (đọc hiểu). Trong đoạn mã dựng cây span của bài, truyVanDB(ctx, tracer) và goiCache(ctx, tracer) đều nhận cùng một ctx xuất phát từ tracer.Start(context.Background(), "GET /donhang"). Hai span db.query và cache.get sẽ có quan hệ cha-con thế nào với span GET /donhang, và chúng có phải cha-con của nhau không?
Đáp án
Cả db.query và cache.get đều là con trực tiếp của span gốc GET /donhang (vì cả hai đều gọi tr.Start(ctx, ...) trên cùng ctx chứa span gốc làm cha). Chúng không phải cha-con của nhau — là hai anh em (sibling) cùng chung một cha, đúng như số liệu đo thật: cả db.query và cache.get đều có cha=28786179.
Bài 2 (sửa lỗi). Đoạn mã sau viết sai khiến span con không nối được vào cây trace. Chỉ ra lỗi và sửa lại.
func truyVanDB(ctx context.Context, tr trace.Tracer) {
	_, sp := tr.Start(context.Background(), "db.query")
	defer sp.End()
	time.Sleep(5 * time.Millisecond)
}
Đáp án
Lỗi: gọi tr.Start(context.Background(), ...) thay vì tr.Start(ctx, ...). Dùng context.Background() tạo một context mới tinh, không mang theo span cha nào, nên db.query sẽ trở thành một span gốc mới (không có cha), tách rời khỏi cây trace của request. Sửa lại: _, sp := tr.Start(ctx, "db.query") — phải dùng ctx được truyền vào từ hàm gọi, vì đó là nơi span cha đang được mang theo.
Bài 3 (vận dụng thực tế). Dịch vụ của bạn có lưu lượng rất cao. Dựa trên số đo trong bài (Noop 50 ns/2 alloc, NeverSample 150 ns/3 alloc, AlwaysSample 763 ns/17 alloc), hãy giải thích vì sao chọn AlwaysSample cho toàn bộ traffic là một quyết định tốn kém, và đề xuất một hướng khắc phục được nêu trong bài.
Đáp án
AlwaysSample ghi đủ mọi span (tạo cấu trúc đầy đủ, lưu thuộc tính, đẩy vào hàng đợi xuất) nên tốn 763 ns và 17 cấp phát mỗi span — đắt gấp khoảng 5 lần NeverSample về thời gian và 5-6 lần về cấp phát. Với lưu lượng cao, nhân số này lên hàng triệu request/giây sẽ tốn CPU/bộ nhớ đáng kể và tạo khối lượng dữ liệu khổng lồ ở backend trace. Hướng khắc phục: dùng sampling (ví dụ 1-10% head-based, hoặc tail-based sampling giữ trace khi phát hiện lỗi/chậm bất thường sau khi đã xảy ra) để giữ khả năng quan sát ở chi phí chấp nhận được.
Bài 4 (bẫy/đánh đổi). Một đồng nghiệp đề xuất dùng dữ liệu trace để tính chính xác tổng số request lỗi trong ngày, vì "trace đã ghi hết mọi request rồi". Theo bài, vì sao cách này không đáng tin, và công cụ nào nên dùng thay thế cho việc đếm chính xác này?
Đáp án
Không đáng tin, vì hai lý do trong bài: (1) tracing thường chạy sampling nên không phải 100% request được ghi trace; (2) BatchSpanProcessor dùng hàng đợi có giới hạn — khi collector chậm hoặc chết, nó rớt span khi đầy thay vì làm nghẽn ứng dụng, nên dữ liệu trace không đảm bảo đầy đủ. Trace là để chẩn đoán, không phải nguồn số liệu chính xác tuyệt đối. Công cụ đúng cho việc đếm chính xác là metrics (ví dụ counter Prometheus, chủ đề bài sau).
Bài 5 (đọc hiểu số liệu). Từ kết quả đo thật span=28786179 tên=GET /donhang cha=(gốc) thời_gian=9.065ms và span=a6d58e18 tên=db.query cha=28786179 thời_gian=5.586ms, hãy tính tỉ lệ phần trăm thời gian span gốc dành cho truy vấn DB, và giải thích vì sao dữ liệu này hữu ích hơn một dòng log đơn lẻ ghi "request mất 9ms".
Đáp án
5.586 / 9.065 ≈ 61,6% thời gian của request nằm ở truy vấn DB. Một dòng log "request mất 9ms" không cho biết thời gian phân bổ ở đâu; nhờ cây trace với quan hệ cha-con và cùng trace_id, ta thấy ngay DB là nghi phạm chính (5,6ms) trong khi cache chỉ chiếm 1,14ms — điều mà log rời rạc từ ba nơi khác nhau không thể dựng lại được.
Phần sau ta chuyển sang trụ cột quan sát thứ hai: metrics với Prometheus client trong Go — counter, gauge, histogram, và chi phí thật của việc đo.
