Bài trước ta dùng distributed tracing để trả lời "thời gian của một request cụ thể nằm ở đâu". Nhưng để trả lời "hệ thống nói chung có khỏe không, tốc độ lỗi bao nhiêu, độ trễ p99 đang tăng chứ", trace là công cụ sai — nó quá đắt và quá chi tiết. Câu trả lời là trụ cột quan sát thứ hai: metrics.
Metrics là những con số tổng hợp, rẻ, và hằng bộ nhớ — chúng không phình theo lưu lượng như log hay trace. Prometheus là chuẩn de facto cho metrics, và client_golang là thư viện chính thức. Bài này mổ xẻ ba loại metric cốt lõi, giải thích vì sao histogram thắng "giá trị trung bình", và đo thẳng chi phí của việc đo — bao gồm một cái bẫy hiệu năng phổ biến với nhãn.
Ba loại metric cốt lõi
Prometheus có ba loại metric bạn sẽ dùng 95% thời gian:
// Counter: CHỈ tăng — đếm tổng số sự kiện (request, lỗi)
reqTotal := prometheus.NewCounterVec(
	prometheus.CounterOpts{Name: "http_requests_total"},
	[]string{"method", "code"}, // nhãn: tách theo chiều
)
// Gauge: lên xuống tự do — giá trị tức thời (đang xử lý, RAM)
inFlight := prometheus.NewGauge(prometheus.GaugeOpts{Name: "http_in_flight"})
// Histogram: phân bố vào các khoảng (bucket) — độ trễ, kích thước
latency := prometheus.NewHistogram(prometheus.HistogramOpts{
	Name:    "http_latency_seconds",
	Buckets: []float64{0.005, 0.01, 0.025, 0.05, 0.1, 0.25},
})
- Counter chỉ tăng, không bao giờ giảm. Đếm những thứ tích lũy: tổng request, tổng lỗi, tổng byte. Bạn không đọc giá trị tuyệt đối của counter — bạn dùng
rate()trên nó để ra tốc độ (request/giây). - Gauge lên xuống tự do. Đo giá trị tức thời: số request đang xử lý, độ sâu hàng đợi, bộ nhớ đang dùng, nhiệt độ.
- Histogram đặt mỗi quan sát vào một hoặc nhiều bucket, để tính phân bố — độ trễ, kích thước payload.
Ghi metric trong đường xử lý
Việc ghi metric nằm rải trong đường xử lý request:
inFlight.Inc()                          // +1 khi bắt đầu
// ... xử lý request, đo d là độ trễ ...
reqTotal.WithLabelValues("GET", code).Inc()  // đếm theo (method, code)
latency.Observe(d.Seconds())            // đưa vào histogram
inFlight.Dec()                          // -1 khi xong
Nhãn (label) là chiều để cắt lát metric: reqTotal với nhãn method và code cho phép hỏi "tốc độ lỗi 5xx của POST" mà không cần metric riêng cho mỗi tổ hợp. Nhưng nhãn là con dao hai lưỡi — ta sẽ thấy ở phần đánh đổi.
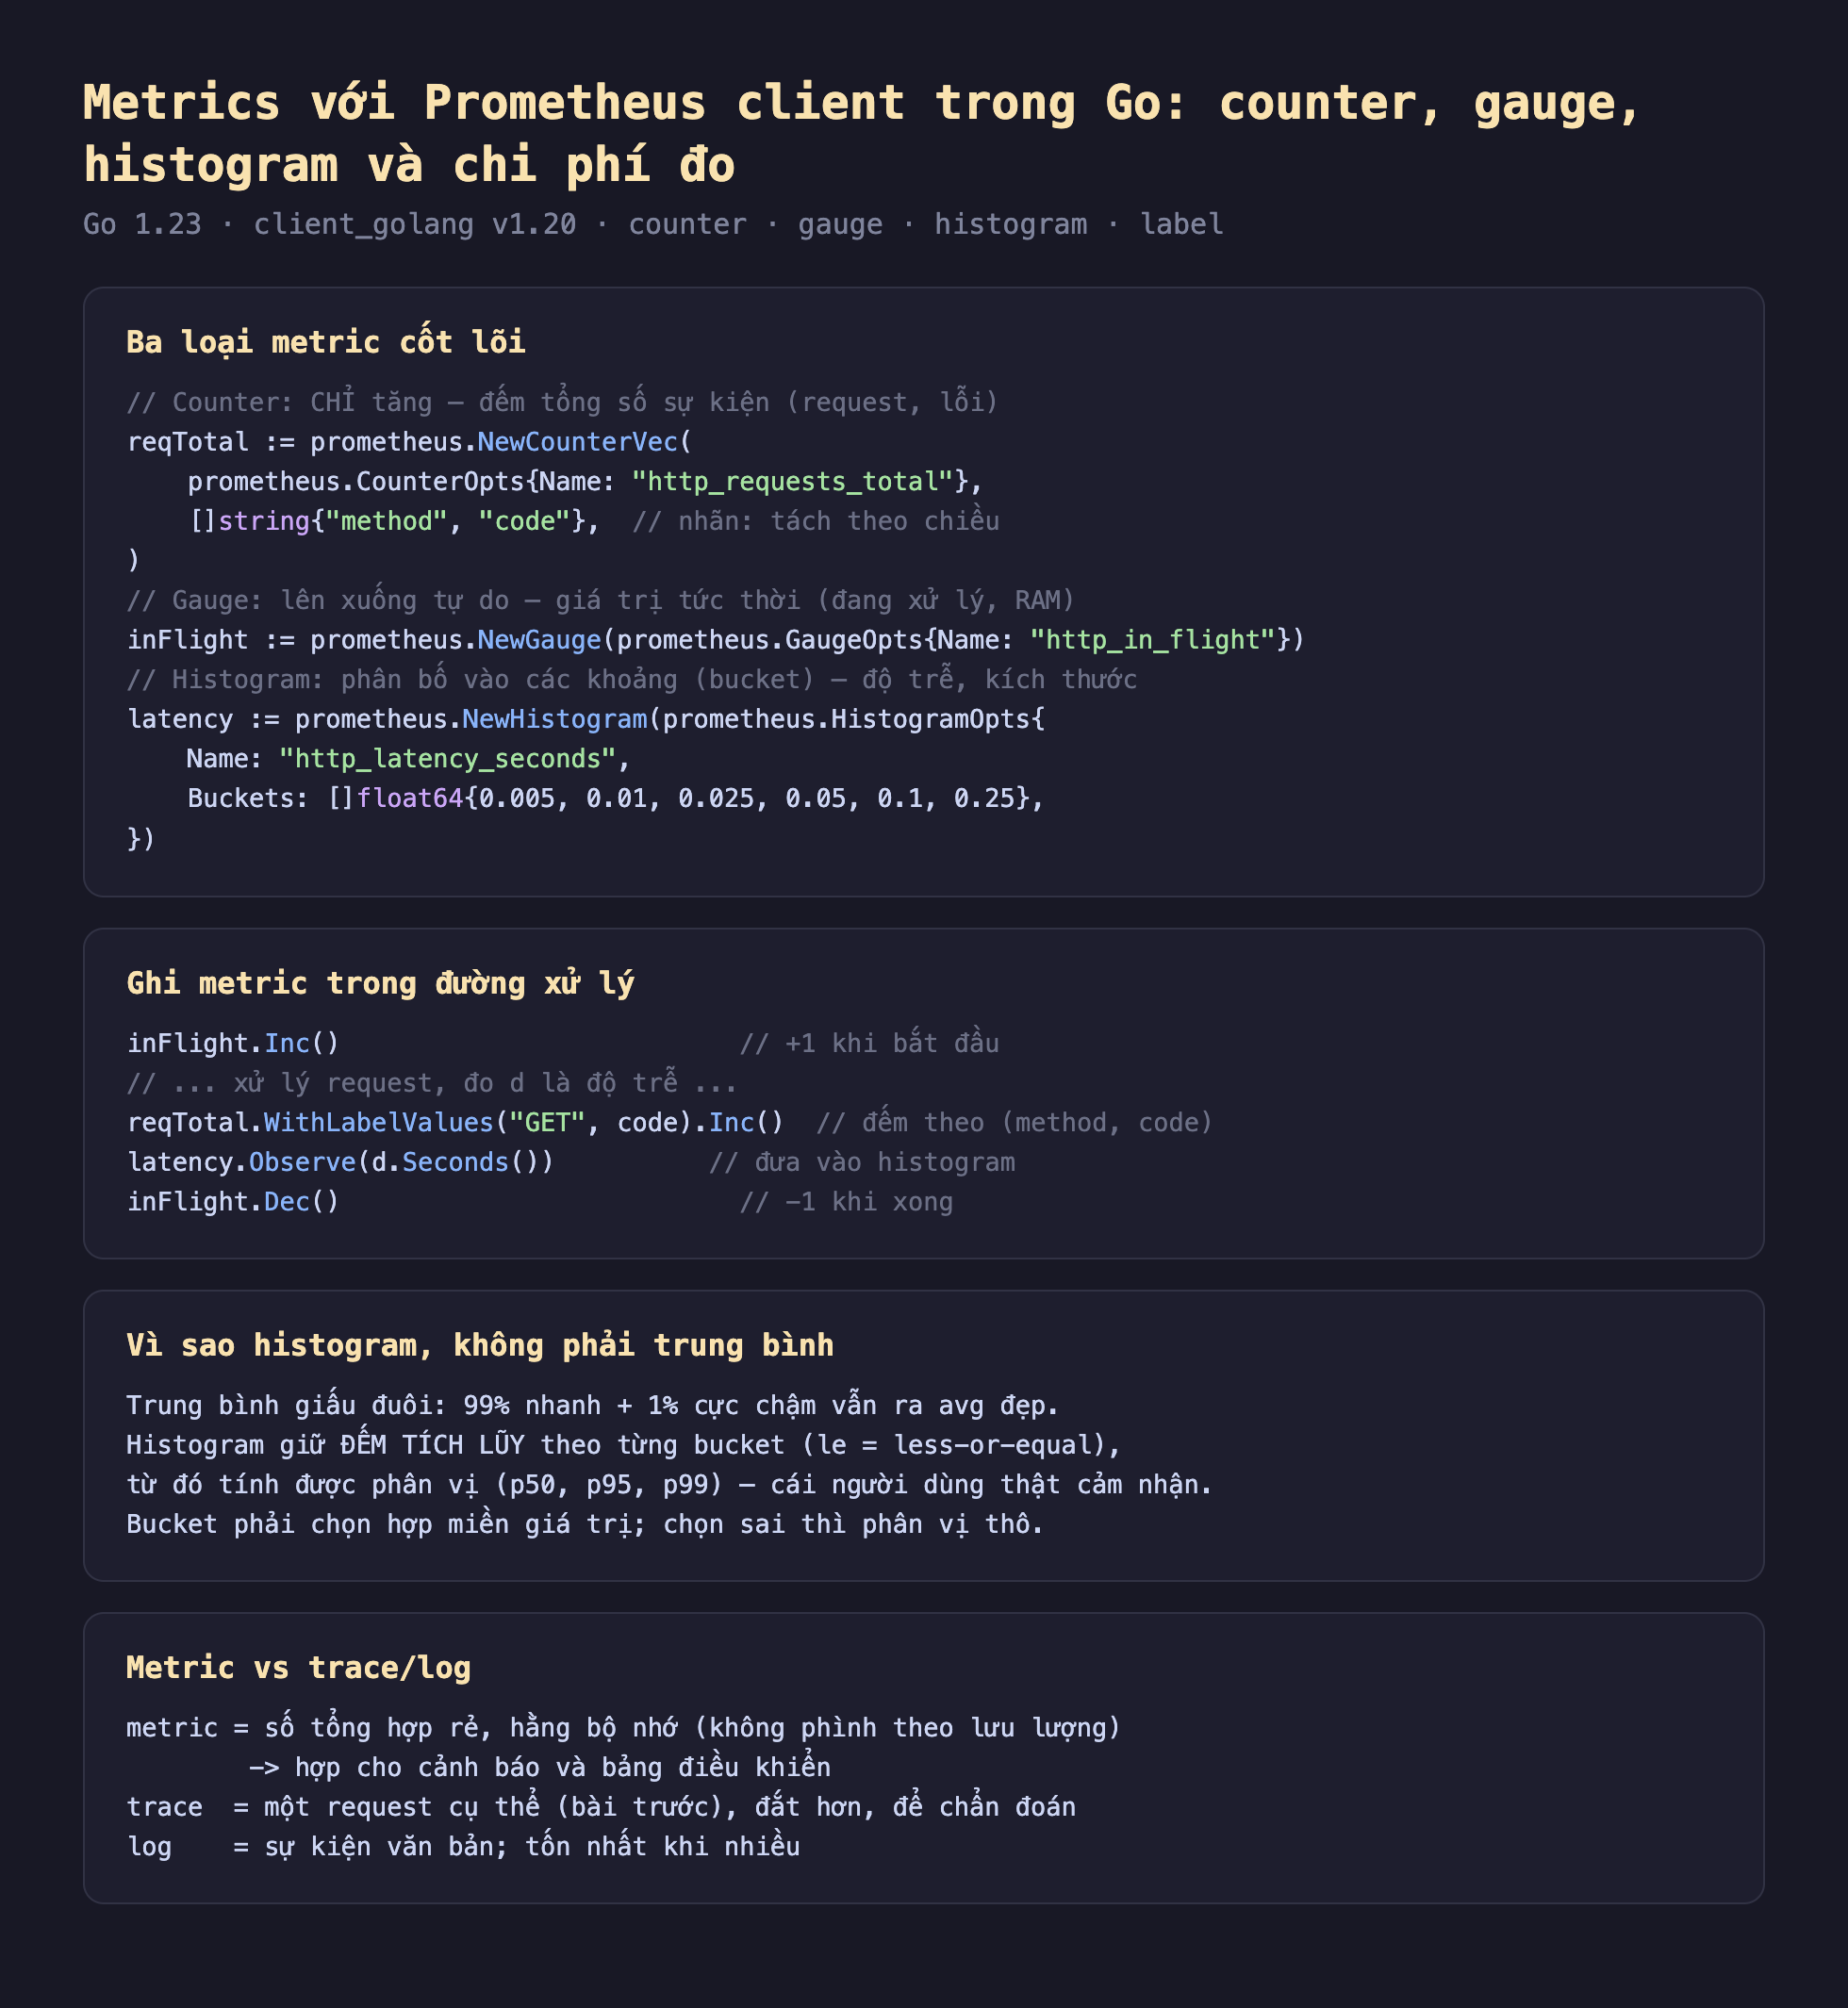
Hình 1: Ba loại metric Prometheus trong Go — counter (chỉ tăng), gauge (lên xuống), histogram (phân bố theo bucket) — cách ghi trong đường xử lý, và vì sao histogram hơn giá trị trung bình.
Đo thật: /metrics sau 1000 request
Chạy demo giả lập 1000 request rồi kết xuất theo đúng định dạng văn bản mà endpoint /metrics trả ra cho Prometheus:
http_in_flight         => 0            // gauge: đã xử lý xong hết
http_requests_total  code="200" => 948   // counter theo nhãn
http_requests_total  code="500" => 52    // ~5% lỗi
http_latency_seconds  count=1000 sum=39.763s avg=39.8ms
    le<=0.005  count=67       le<=0.050  count=632
    le<=0.010  count=130      le<=0.100  count=1000
    le<=0.025  count=323      le<=0.250  count=1000
Đọc được: counter tách 948 request thành công và 52 lỗi (đúng ~5% tôi cấy vào). Gauge http_in_flight về 0 vì mọi request đã xong. Và histogram — phần thú vị nhất — cho biết phân bố độ trễ.
Vì sao histogram, không phải trung bình
Giá trị trung bình (avg=39.8ms) là một cái bẫy. Nó giấu cái đuôi: một dịch vụ mà 99% request trả trong 10ms nhưng 1% mất 5 giây vẫn có thể ra trung bình đẹp — trong khi đúng cái 1% đó là trải nghiệm tệ khiến người dùng bỏ đi. Bạn không quan tâm request trung bình; bạn quan tâm request tệ nhất mà đa số vẫn gặp — tức phân vị p95, p99.
Histogram giữ đếm tích lũy theo từng bucket (le = less-or-equal). Từ output: 632/1000 request dưới 50ms, và toàn bộ 1000 dưới 100ms. Từ những con số này Prometheus nội suy ra phân vị: p50 nằm đâu đó trong khoảng 25–50ms (vì 323 dưới 25ms, 632 dưới 50ms), còn p95 và p99 đều dưới 100ms. Đây chính là cách histogram_quantile() trong Prometheus hoạt động — và là lý do bạn gần như luôn muốn histogram cho độ trễ, không phải một gauge trung bình.
Cái giá: bucket phải chọn hợp miền giá trị. Nếu mọi request rơi vào cùng một bucket (chọn bucket quá thô), phân vị tính ra rất thô. Chọn bucket bao trùm dải độ trễ thực tế của dịch vụ bạn.
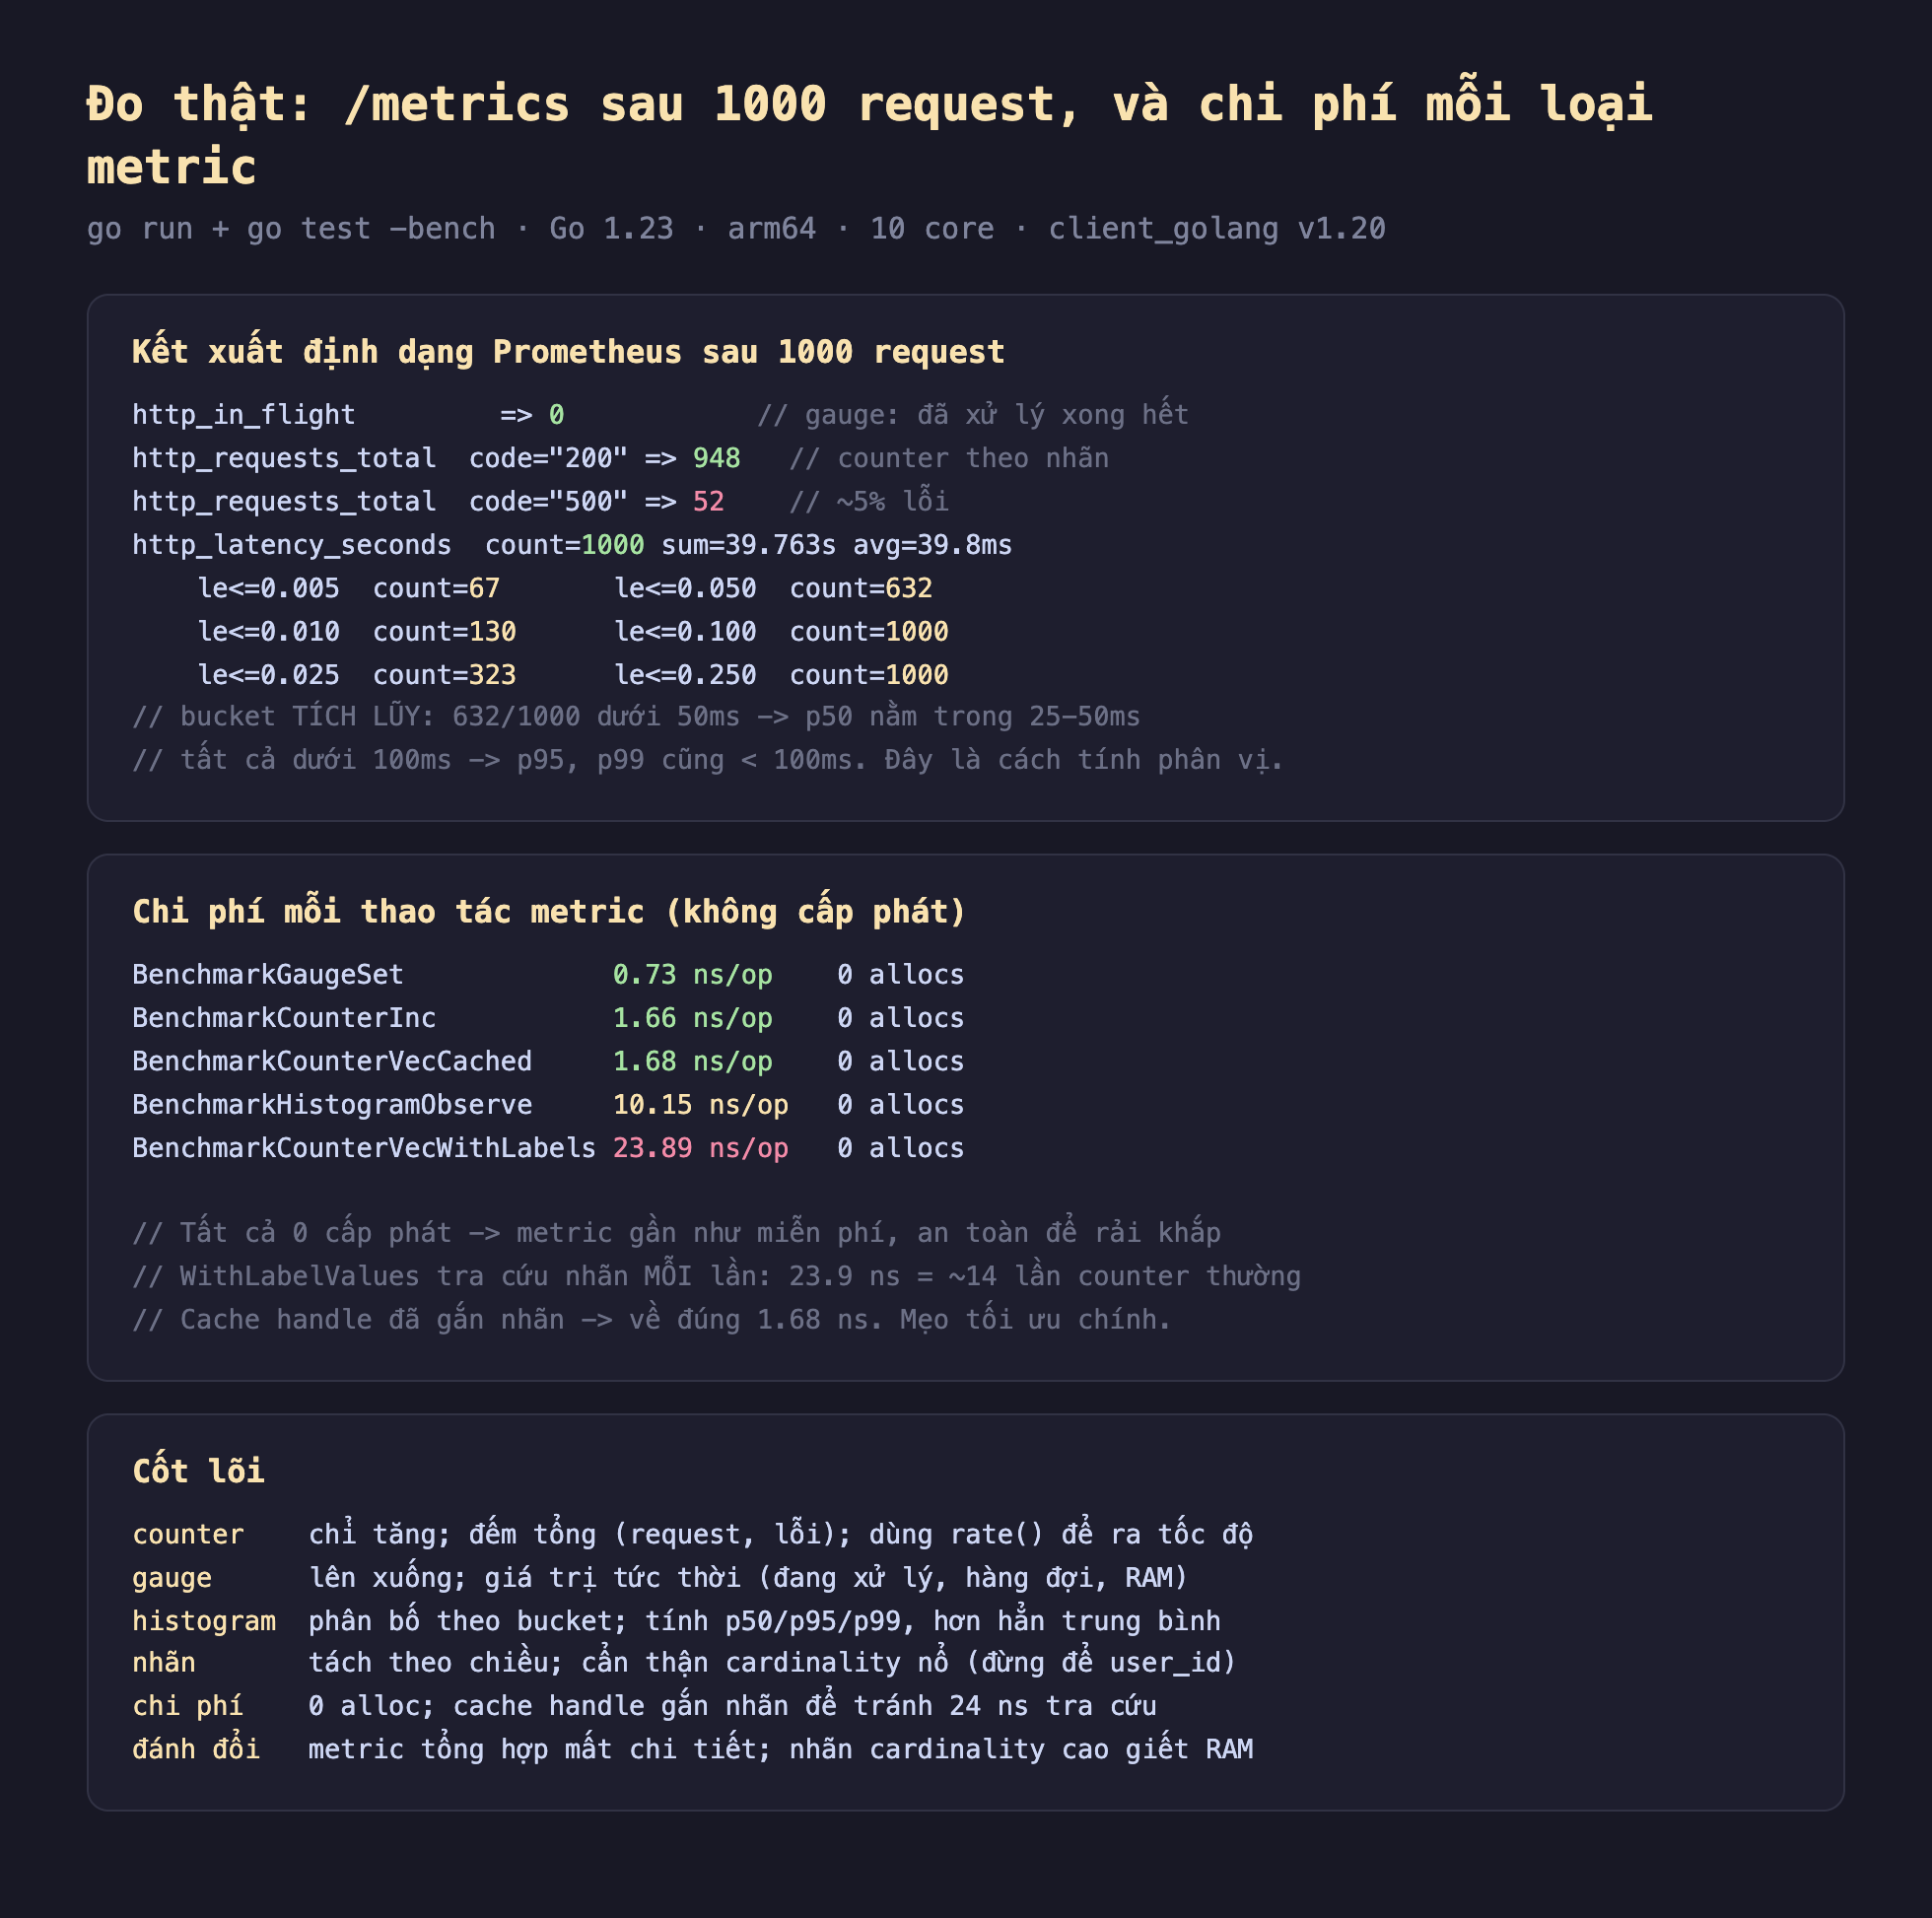
Hình 2: Kết xuất /metrics thật sau 1000 request (counter 948/52, histogram với bucket tích lũy để tính phân vị) và chi phí mỗi thao tác đo bằng benchmark — mọi thao tác 0 cấp phát, nhưng WithLabelValues tốn 24 ns so với 1,7 ns khi cache handle.
Đo thật: chi phí mỗi thao tác metric
Metric được ghi trong đường nóng (hot path) của mọi request, nên chi phí của nó quan trọng. Benchmark từng loại:
BenchmarkGaugeSet             0.73 ns/op    0 allocs
BenchmarkCounterInc           1.66 ns/op    0 allocs
BenchmarkCounterVecCached     1.68 ns/op    0 allocs
BenchmarkHistogramObserve     10.15 ns/op   0 allocs
BenchmarkCounterVecWithLabels 23.89 ns/op   0 allocs
Tin tốt trước: mọi thao tác đều 0 cấp phát. Bên trong, các metric dùng atomic (đã đo ở các bài đồng thời trước) chứ không phải mutex cho counter/gauge, nên chúng gần như miễn phí và an toàn để rải khắp code. Gauge set 0,73 ns, counter inc 1,66 ns, histogram observe 10 ns — không đáng kể so với việc xử lý một request thật.
Nhưng có một cái bẫy: WithLabelValues("GET", "200") tốn 23,89 ns mỗi lần gọi — gấp ~14 lần một counter thường. Lý do: mỗi lần gọi nó phải băm các giá trị nhãn và tra cứu đúng đối tượng counter trong map. Nếu bạn gọi WithLabelValues trong hot path cho mỗi request, bạn trả cái giá tra cứu này mỗi lần.
Cách sửa: cache lại handle đã gắn nhãn. BenchmarkCounterVecCached tra cứu một lần rồi tái sử dụng đối tượng counter — và nó về đúng 1,68 ns, ngang counter thường. Khi biết trước tổ hợp nhãn (ví dụ một handler cố định method), lấy handle một lần lúc khởi tạo thay vì tra cứu mỗi request.
Đánh đổi cần cân nhắc
Metric mất chi tiết — đó là điểm mạnh lẫn điểm yếu. Metric là số tổng hợp: bạn biết tốc độ lỗi 5% nhưng không biết request nào lỗi hay vì sao. Để trả lời "vì sao", bạn cần trace (bài trước) hoặc log. Đúng chiến lược quan sát là dùng cả ba: metric để phát hiện và cảnh báo (rẻ, luôn bật), trace để chẩn đoán ca cụ thể, log để chi tiết.
Cardinality nhãn là kẻ giết bộ nhớ số một. Mỗi tổ hợp giá trị nhãn tạo một chuỗi thời gian (time series) riêng trong Prometheus. Nhãn method (vài giá trị) và code (chục giá trị) thì ổn. Nhưng đặt user_id hay request_id làm nhãn — với hàng triệu giá trị — tạo hàng triệu time series, và giết cả ứng dụng lẫn Prometheus server bằng bộ nhớ. Quy tắc: nhãn chỉ dùng cho các chiều có tập giá trị nhỏ, đóng.
Histogram tốn bộ nhớ theo số bucket × số tổ hợp nhãn. Một histogram nhiều bucket nhân với nhiều nhãn có thể nổ số series. Nếu cần phân vị chính xác trên cardinality cao, cân nhắc summary (tính phân vị phía client) hoặc giảm bucket — mỗi lựa chọn có đánh đổi riêng về độ chính xác và khả năng tổng hợp.
Ba ý mang về
- Ba loại metric cho ba câu hỏi khác nhau: counter (chỉ tăng, đếm tổng — dùng
rate()ra tốc độ), gauge (lên xuống, giá trị tức thời), histogram (phân bố theo bucket) — đo thật 1000 request cho counter 948/52 và histogram dựng được phân vị. - Histogram hơn hẳn giá trị trung bình vì trung bình giấu cái đuôi: đo thật, đếm tích lũy theo bucket (632/1000 dưới 50ms, tất cả dưới 100ms) cho phép tính p50/p95/p99 — cái người dùng thật cảm nhận, không phải request trung bình.
- Metric gần như miễn phí (0 cấp phát) nhưng
WithLabelValuestra cứu tốn 24 ns mỗi lần (gấp ~14 lần counter thường); cache handle đã gắn nhãn đưa về 1,7 ns — và cẩn thận cardinality nhãn, đừng bao giờ đặt user_id/request_id làm nhãn.
Phần sau ta quay lại điều phối hệ thống phân tán: distributed lock với Redis trong Go — cách nhiều tiến trình giành quyền độc chiếm một tài nguyên, và những cái bẫy của khóa phân tán.
