Bài trước ta thấy goroutine (G) ghép lên OS thread (M) qua processor (P), mỗi P giữ một hàng đợi goroutine cục bộ. Nhưng nảy sinh vấn đề: nếu bạn tạo cả trăm goroutine từ một chỗ (ví dụ một vòng lặp trong main), chúng dồn vào hàng đợi của một P. Vậy 9 P kia ngồi không sao? Không — nhờ work-stealing. Bài này mổ xẻ cơ chế đó và đo thật hiệu quả của nó.
P rảnh đi cướp việc
Nguyên tắc cốt lõi: không P nào được ngồi không khi còn việc. Khi một P chạy hết hàng đợi cục bộ của mình, nó không nghỉ mà đi tìm việc theo thứ tự:
- Hàng đợi cục bộ của chính nó (local run queue) — nhanh nhất, không cần đồng bộ với P khác.
- Hàng đợi toàn cục (global run queue) — thỉnh thoảng P ưu tiên lấy từ đây để tránh bỏ đói goroutine cũ.
- Netpoller — goroutine vừa hoàn tất I/O (chi tiết ở bài netpoller).
- Đánh cắp (steal): lấy một nửa hàng đợi của một P ngẫu nhiên khác.
Chính bước 4 khiến việc dồn vào một P vẫn lan ra mọi core. P nào hết việc sẽ tự động cướp từ P đang bận.
func burn() int { x := 0; for i := 0; i < 200_000_000; i++ { x ^= i * 3 }; return x }

for i := 0; i < 40; i++ {           // TẤT CẢ goroutine tạo từ main
    go func() { defer wg.Done(); burn() }()
}
wg.Wait()
// GOMAXPROCS=1 -> chạy tuần tự; GOMAXPROCS=10 -> scheduler trải ra 10 core
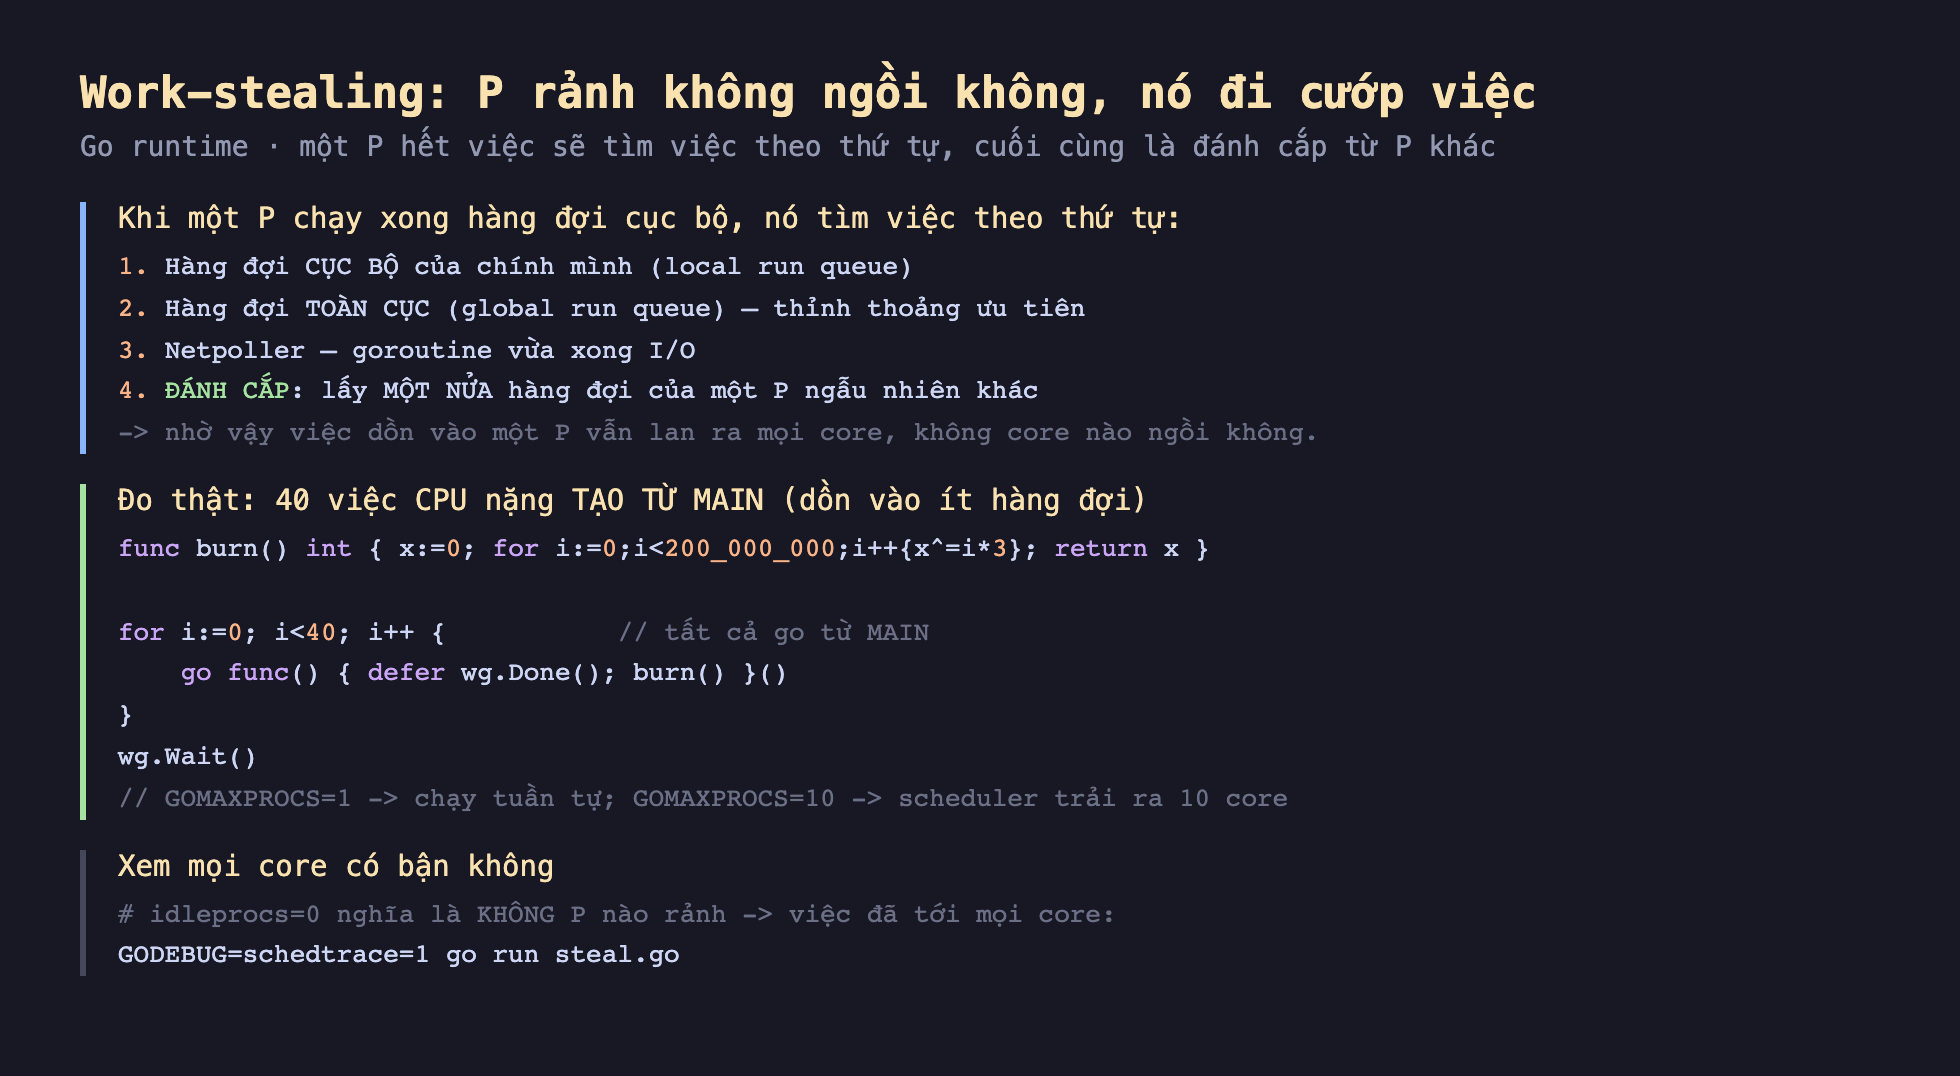
Hình 1: Thứ tự một P đi tìm việc — cục bộ → toàn cục → netpoller → đánh cắp nửa hàng đợi của P khác. Và đoạn mã đo: 40 việc CPU tạo từ main.
Đo thật: nhanh 6,5 lần dù tạo từ một chỗ
Tôi tạo 40 goroutine nặng CPU (mỗi cái lặp 200 triệu vòng), tất cả từ vòng lặp trong main, rồi so thời gian với GOMAXPROCS=1 và =10:
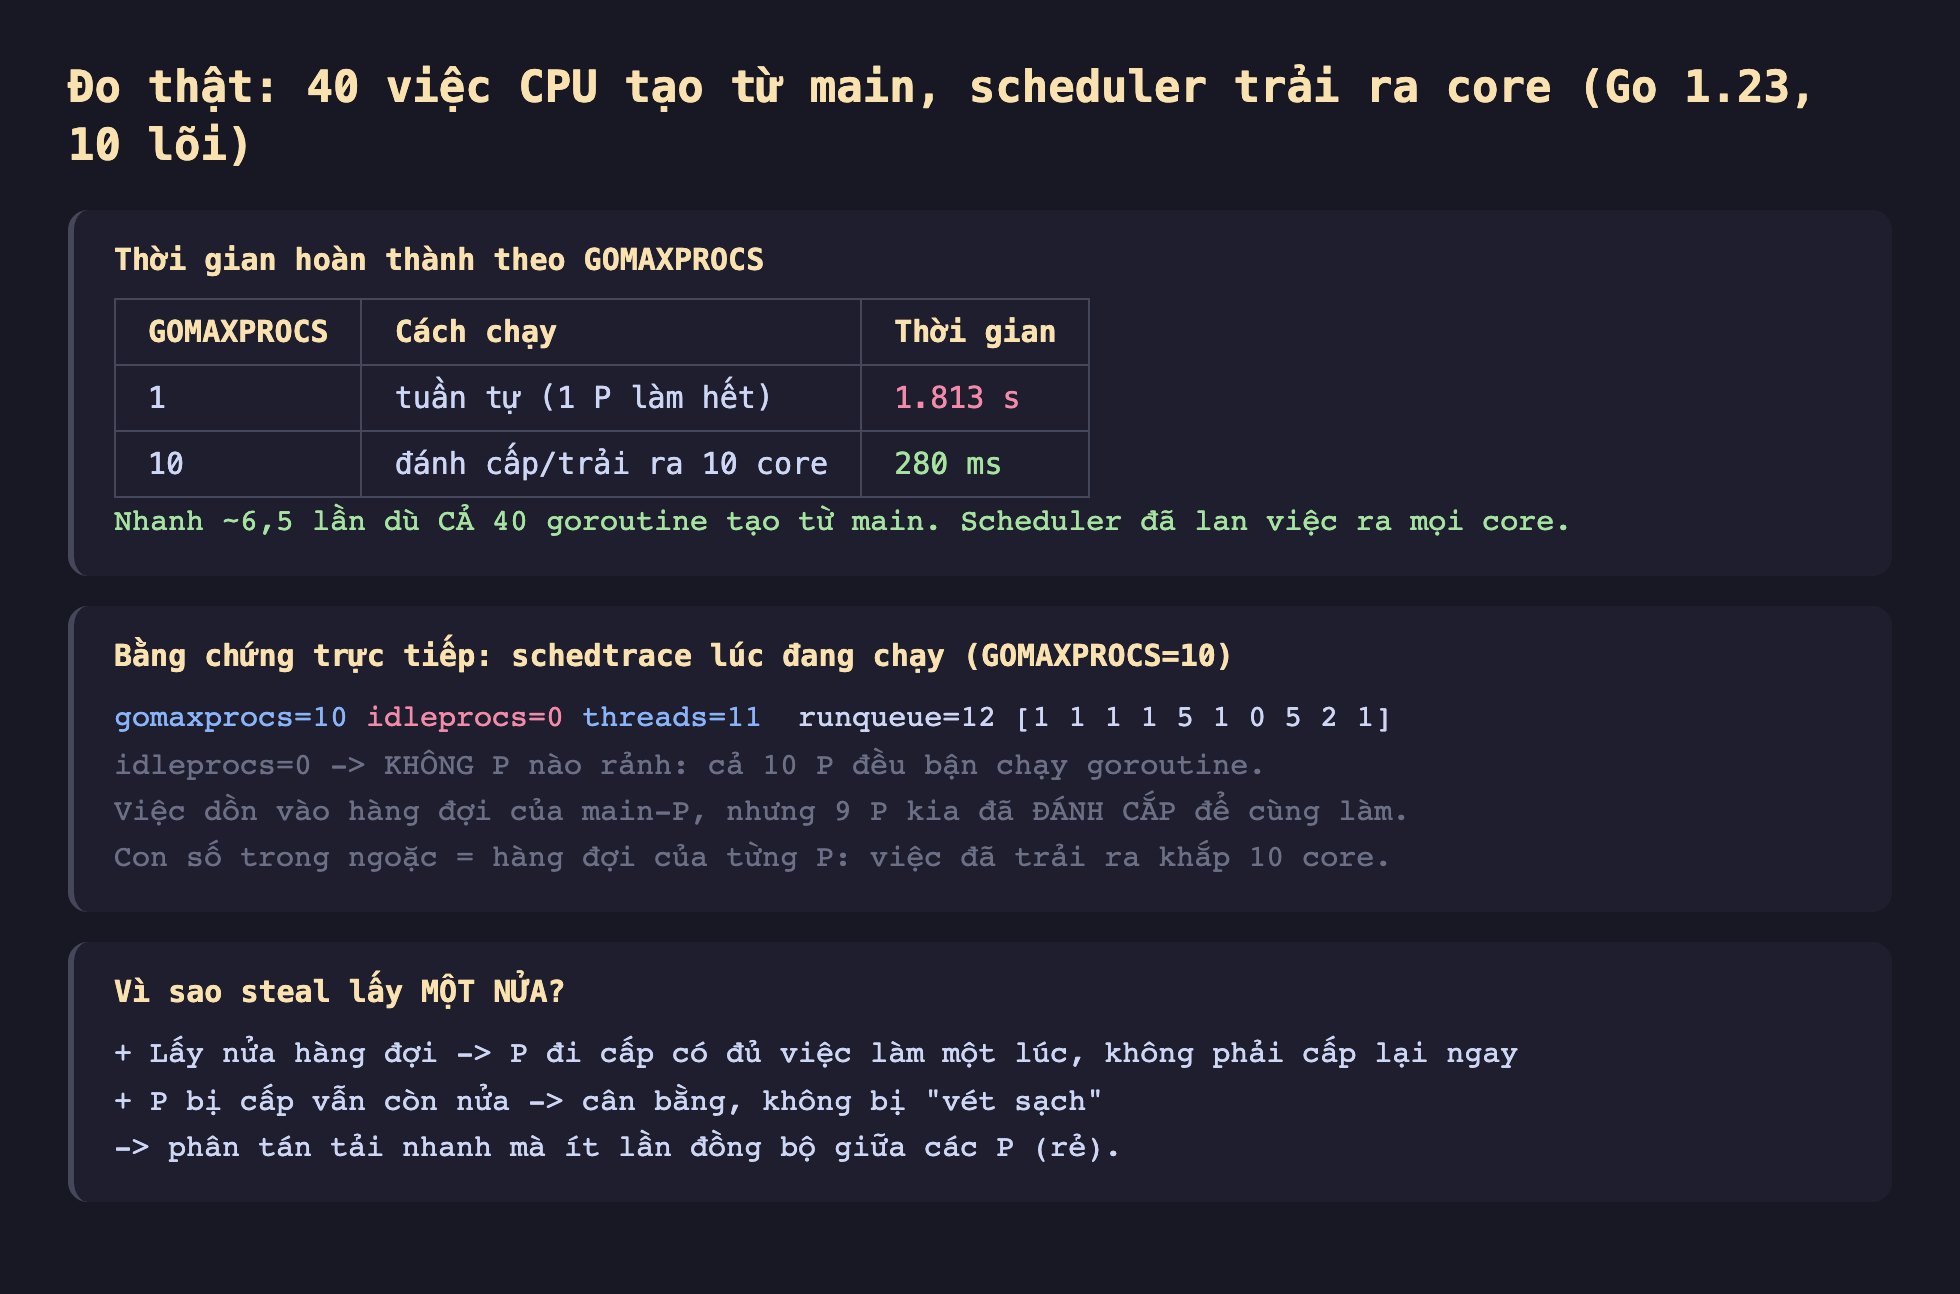
Hình 2: GOMAXPROCS=1 chạy 1,813 s; GOMAXPROCS=10 chỉ 280 ms — nhanh ~6,5 lần. schedtrace lúc chạy cho idleprocs=0: mọi P đều bận, chứng tỏ việc đã bị đánh cắp và trải ra khắp core.
Con số thật:
- GOMAXPROCS=1: 1,813 s — một P làm tuần tự cả 40 việc.
- GOMAXPROCS=10: 280 ms — nhanh hơn ~6,5 lần.
Dù cả 40 goroutine sinh ra từ cùng một vòng lặp trong main (nên ban đầu dồn vào hàng đợi của P chạy main), chúng vẫn được phân ra 10 core. Bằng chứng trực tiếp là dòng schedtrace lúc đang chạy: gomaxprocs=10 idleprocs=0 — idleprocs=0 nghĩa là không P nào rảnh, cả 10 P đều đang chạy goroutine. Các P không được giao việc trực tiếp đã tự đi đánh cắp từ hàng đợi của main-P để cùng làm.
(Không đạt đúng 10× vì chỉ 40 việc trên 10 core, cộng chi phí đồng bộ khi đánh cắp và cạnh tranh bộ nhớ — nhưng 6,5× cho thấy scheduler tận dụng gần hết số core.)
Vì sao đánh cắp một nửa, không phải một cái
Chi tiết tưởng nhỏ nhưng quan trọng: khi P đánh cắp, nó lấy một nửa hàng đợi của nạn nhân, không phải một goroutine:
- Lấy nửa để P đi cắp có đủ việc làm một lúc lâu, không phải quay lại cắp liên tục — mỗi lần cắp cần đồng bộ (khoá) với P bị cắp, mà đồng bộ thì tốn.
- Để lại nửa cho P bị cắp để nó vẫn còn việc, tránh bị "vét sạch" rồi lại phải đi cắp ngược.
Kết quả là tải được phân tán nhanh mà số lần đồng bộ giữa các P ít — đây là lý do work-stealing vừa cân bằng tốt vừa rẻ, và là thuật toán lập lịch được nhiều runtime hiện đại (Go, Rust Tokio, Java ForkJoinPool) dùng.
Đánh đổi cần cân nhắc
Work-stealing chỉ giúp khi có việc để trải. Nó phân phối goroutine sẵn sàng chạy ra các core. Nếu workload của bạn thực chất tuần tự (goroutine sau phụ thuộc kết quả goroutine trước), không có gì để cắp và thêm core không giúp. 6,5× ở trên có được vì 40 việc độc lập, chạy song song thật.
Đánh cắp có chi phí (đồng bộ + cache). Mỗi lần cắp phải khoá hàng đợi nạn nhân, và goroutine bị cắp chạy trên core mới sẽ "lạnh cache" (dữ liệu nó cần không còn trong cache của core đó). Với workload nhiều goroutine cực ngắn, chi phí cắp + cache miss có thể ăn mòn lợi ích — lúc đó gộp việc thành ít goroutine lớn hơn lại tốt hơn.
Bạn hiếm khi phải can thiệp. Work-stealing tự động và gần như luôn làm đúng. Điều thực dụng cần nhớ: cứ tạo goroutine cho các việc độc lập và để scheduler lo phân phối; đừng tự viết cơ chế chia việc ra từng core (thường tệ hơn). Chỉ khi đo thấy scheduler là nút thắt mới đào sâu.
Ba ý mang về
- Work-stealing đảm bảo không P nào ngồi không: một P hết hàng đợi cục bộ sẽ tìm việc theo thứ tự cục bộ → toàn cục → netpoller → đánh cắp một nửa hàng đợi của một P khác, nên goroutine dồn vào một chỗ vẫn lan ra mọi core.
- Đo thật 40 việc CPU tạo từ main chạy nhanh ~6,5 lần khi bật 10 core (1,813 s → 280 ms), và
schedtracechoidleprocs=0chứng tỏ mọi P đều bận — việc đã bị đánh cắp và trải đều. - Đánh cắp lấy một nửa để cân bằng nhanh mà ít đồng bộ, nhưng chỉ hiệu quả với việc độc lập; workload tuần tự hoặc goroutine cực ngắn có thể không hưởng lợi (chi phí cắp + cache miss) — cứ tạo goroutine cho việc độc lập và để scheduler lo, đừng tự chia core.
Bài tập làm thử
Bài 1 (đọc hiểu). Theo bài viết, khi một P đã chạy hết hàng đợi cục bộ của mình, nó tìm việc theo đúng thứ tự nào (4 bước)? Nếu bước 1 và bước 2 đều không có việc, và cũng không có goroutine nào vừa hoàn tất I/O, P sẽ làm gì tiếp theo?
Đáp án
Thứ tự: (1) hàng đợi cục bộ của chính nó, (2) hàng đợi toàn cục, (3) netpoller (goroutine vừa xong I/O), (4) đánh cắp (steal) một nửa hàng đợi của một P ngẫu nhiên khác. Nếu (1), (2), (3) đều trống, P sẽ đi đánh cắp một nửa hàng đợi cục bộ của một P khác đang bận.
Bài 2 (sửa lỗi). Đoạn code dưới định đo thời gian 40 goroutine tính toán nặng chạy song song, nhưng khi chạy sẽ panic với thông báo "sync: negative WaitGroup counter":
func burn() int {
    x := 0
    for i := 0; i < 200_000_000; i++ {
        x ^= i * 3
    }
    return x
}

func main() {
    var wg sync.WaitGroup
    for i := 0; i < 40; i++ {
        go func() {
            defer wg.Done()
            burn()
        }()
    }
    wg.Wait()
    fmt.Println("hoàn tất")
}
Lỗi ở đâu và sửa thế nào?
Đáp án
Thiếu wg.Add(1) trước khi tạo mỗi goroutine (hoặc wg.Add(40) trước vòng lặp). Bộ đếm của wg bắt đầu ở 0, nên defer wg.Done() trong 40 goroutine kéo bộ đếm xuống âm, gây panic. Sửa: thêm wg.Add(1) ngay trong vòng lặp for, trước dòng go func() {...}().
Bài 3 (vận dụng). Bài đo được: GOMAXPROCS=1 chạy 40 việc CPU nặng mất 1,813 giây; GOMAXPROCS=10 chỉ mất 280 ms. Tính tỉ lệ tăng tốc, và giải thích vì sao con số đó không phải đúng 10 lần dù dùng 10 core thay vì 1.
Đáp án
Tỉ lệ tăng tốc ≈ 1813 / 280 ≈ 6,5 lần. Không đạt 10× vì: chỉ có 40 việc chia cho 10 core (không chia hết đều tuyệt đối), cộng thêm chi phí đồng bộ khi đánh cắp (mỗi lần steal cần khoá hàng đợi nạn nhân) và cạnh tranh bộ nhớ/cache giữa các core — đúng như bài đã nêu.
Bài 4 (bẫy/đánh đổi). Vì sao khi một P đi đánh cắp, nó lấy một nửa hàng đợi của nạn nhân thay vì chỉ lấy một goroutine duy nhất? Nêu cả hai lý do được nêu trong bài.
Đáp án
(1) Lấy nửa để P đi cắp có đủ việc làm trong một thời gian dài, không phải quay lại cắp liên tục — mỗi lần cắp cần đồng bộ (khoá) với P bị cắp, mà đồng bộ thì tốn chi phí. (2) Để lại nửa cho P bị cắp để nó vẫn còn việc, tránh bị "vét sạch" rồi lại phải tự đi cắp ngược lại. Kết quả là tải được phân tán nhanh mà số lần đồng bộ giữa các P ít.
Bài 5 (bẫy/đánh đổi). Một đội phát triển có một pipeline gồm 40 goroutine, nhưng goroutine thứ n phải đợi kết quả của goroutine thứ n-1 mới chạy được (xử lý tuần tự qua channel). Họ tăng GOMAXPROCS từ 1 lên 10 kỳ vọng được tốc độ tương tự 6,5× như trong bài, nhưng không thấy cải thiện gì. Dựa vào phần "Đánh đổi cần cân nhắc" của bài, giải thích vì sao.
Đáp án
Work-stealing chỉ phân phối được goroutine sẵn sàng chạy ra các core khác nhau. Vì đây là workload tuần tự (mỗi goroutine phụ thuộc kết quả goroutine trước), tại một thời điểm chỉ có tối đa một goroutine sẵn sàng chạy — không có gì để "cắp" sang các P khác, nên thêm core không giúp gì. 6,5× trong bài đạt được vì 40 việc độc lập, có thể chạy song song thật.
Phần sau ta học đọc trực tiếp trạng thái bộ lập lịch: Phần sau giải mã từng trường trong dòng GODEBUG=schedtrace — runqueue, spinning threads, idle — để chẩn đoán khi nào scheduler là nút thắt.
