Bạn viết go f() và một goroutine ra đời. Nhưng nó chạy ở đâu? Máy chỉ có 10 lõi CPU, vậy 100.000 goroutine chen chúc thế nào? Câu trả lời là mô hình GMP — trái tim của bộ lập lịch Go, thứ khiến goroutine rẻ tới mức bạn tạo hàng trăm nghìn cái mà không nghĩ ngợi. Series "Golang: Zero to Hero" đã dạy cách dùng goroutine; series này mở nắp capô xem cách nó chạy. Bài mở đầu: GMP là gì, và đo thật bao nhiêu OS thread thật sự được dùng.
G, M, P là ba thứ gì
Bộ lập lịch Go xoay quanh ba trụ cột:
- G (goroutine): đơn vị công việc bạn tạo bằng
go. Cực nhẹ — stack khởi đầu chỉ ~2 KB (tăng động khi cần). Một chương trình có thể có hàng triệu G. - M (machine): một OS thread thật, do kernel lập lịch. Tạo M tốn kém (mỗi thread ngốn bộ nhớ stack cỡ MB và tài nguyên kernel), nên Go cố giữ số M nhỏ.
- P (processor): một ngữ cảnh lập lịch — không phải CPU vật lý, mà một "chỗ" để chạy G. Số P =
GOMAXPROCS(mặc định bằng số lõi CPU). Mỗi P giữ một hàng đợi goroutine cục bộ.
Quy tắc cốt lõi: một M phải gắn với một P mới chạy được G. Vì số P cố định (= số lõi) và số M được giữ nhỏ, cả một biển goroutine được ghép (multiplex) lên một nhúm thread. G nhiều ≫ M ≈ P.
const N = 100000
release := make(chan struct{})
for i := 0; i < N; i++ {
    go func() { ready.Done(); <-release }() // chặn tới khi release
}
ready.Wait()
fmt.Println("G:", runtime.NumGoroutine()) // đếm goroutine sống
fmt.Println("P:", runtime.GOMAXPROCS(0))  // đếm processor
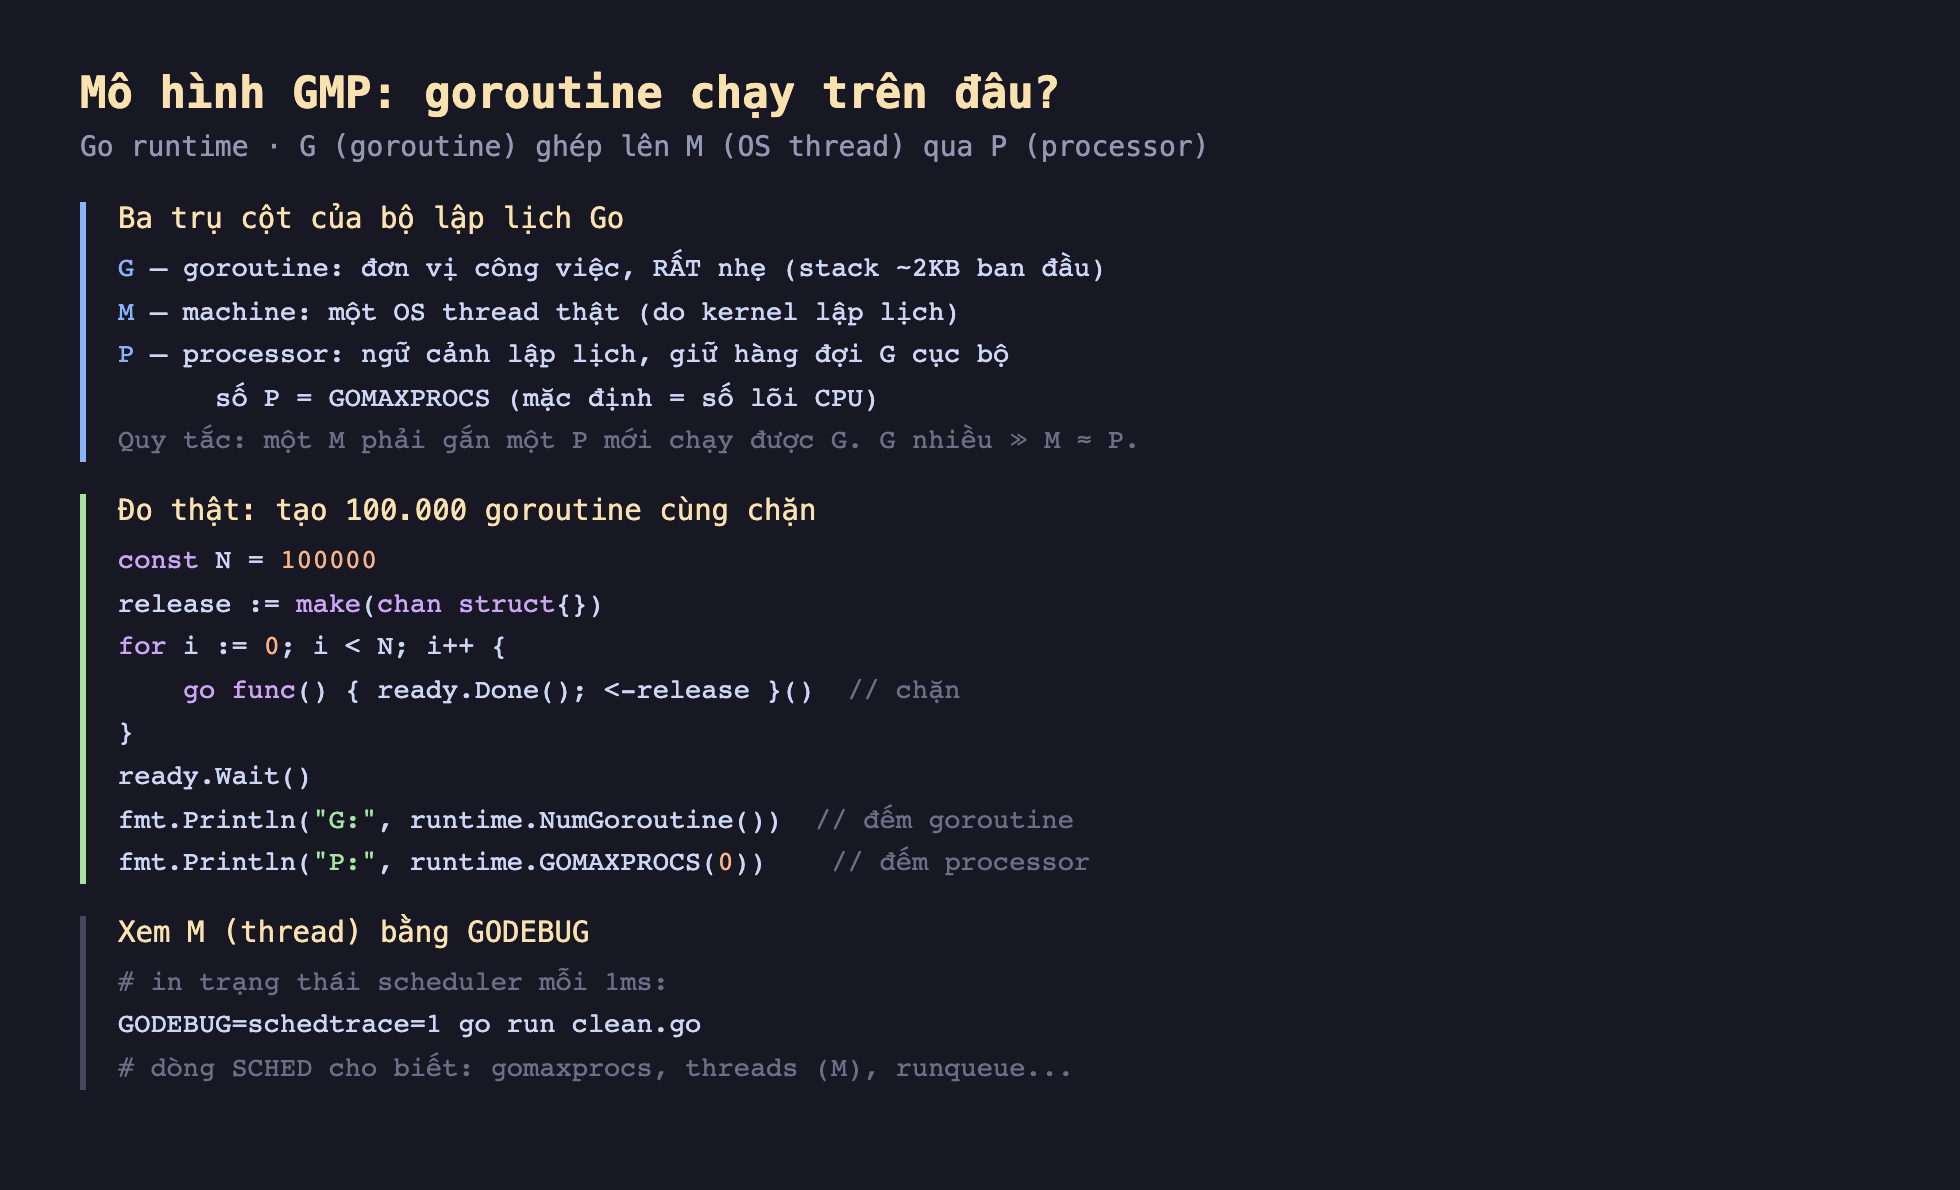
Hình 1: Ba trụ cột GMP và đoạn mã đo — tạo 100.000 goroutine cùng chặn để đếm G, P; dùng GODEBUG=schedtrace để thấy M.
Đo thật: 100.001 goroutine, 5 thread
Tôi tạo 100.000 goroutine, mỗi cái lập tức chặn trên một channel (nên tất cả sống cùng lúc), rồi đếm. Kèm GODEBUG=schedtrace=1 để in trạng thái scheduler:
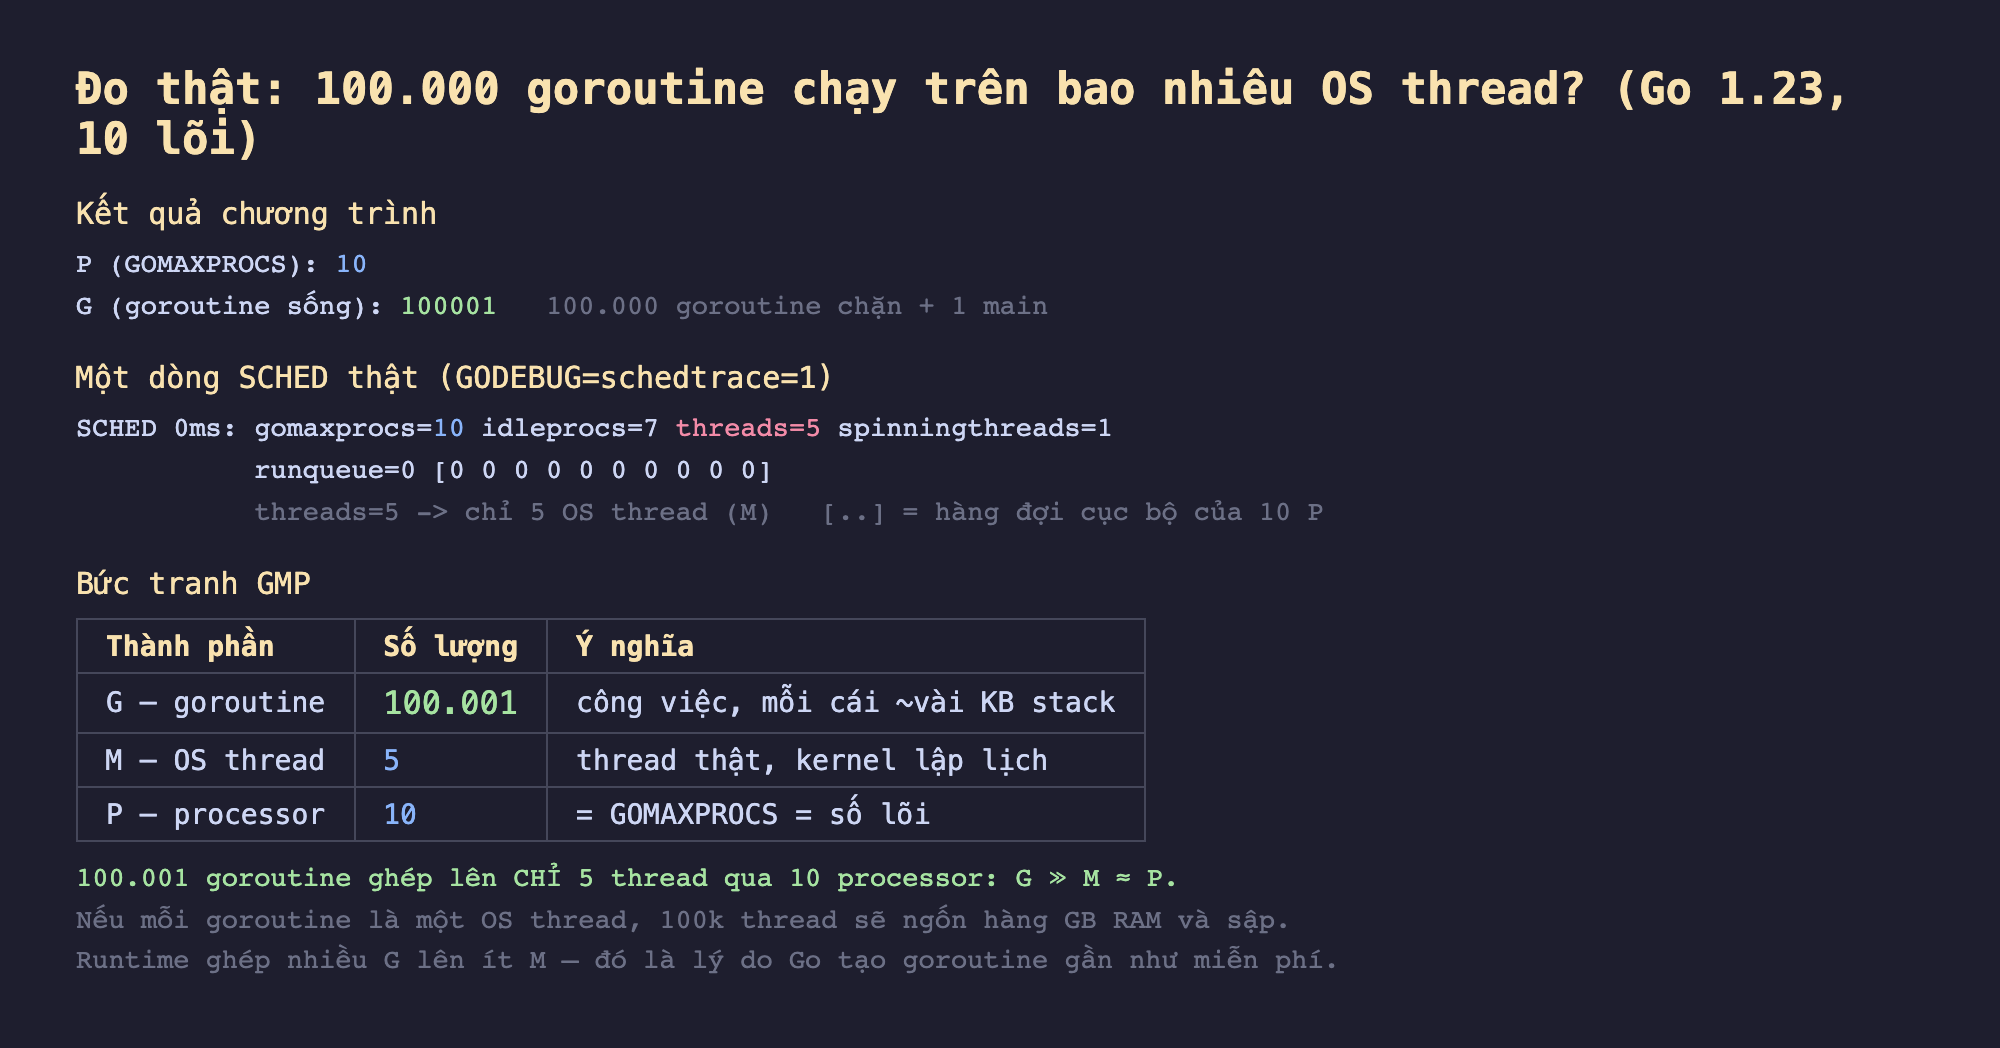
Hình 2: Đo thật — 100.001 goroutine (G) chạy trên chỉ 5 OS thread (M) qua 10 processor (P). Dòng SCHED cho thấy threads=5, và [0 0 ...] là độ dài hàng đợi cục bộ của 10 P.
Con số thật:
- P = 10 (
GOMAXPROCS, bằng số lõi). - G = 100.001 goroutine sống (100.000 goroutine chặn + goroutine
main). - M = 5 OS thread (từ dòng
SCHED ... threads=5).
Một trăm nghìn goroutine chạy trên chỉ 5 thread. Nếu Go tạo một OS thread cho mỗi goroutine (như mô hình 1:1 của nhiều ngôn ngữ), 100.000 thread sẽ ngốn hàng GB RAM (mỗi thread ~1-8 MB stack) và làm sập máy — chưa kể chi phí kernel lập lịch từng ấy thread. Thay vào đó, runtime ghép nhiều G lên ít M: khi một G chặn (chờ channel, I/O, khoá), M được thả ra chạy G khác. Đây chính là lý do goroutine gần như miễn phí — bạn tạo nó thoải mái vì nó không phải là thread.
Đọc một dòng SCHED
Dòng GODEBUG=schedtrace là công cụ chẩn đoán scheduler quan trọng nhất. Giải mã dòng thật ở trên:
gomaxprocs=10— số P.idleprocs=7— 7 P đang rảnh (không có G để chạy tại thời điểm chụp).threads=5— tổng số M runtime đang giữ.spinningthreads=1— M đang "quay" tìm việc (chi tiết ở bài scheduler).runqueue=0— hàng đợi G toàn cục rỗng.[0 0 0 0 0 0 0 0 0 0]— độ dài hàng đợi cục bộ của từng P (10 số cho 10 P).
Ở snapshot này, các goroutine đã chặn nên hàng đợi rỗng và nhiều P rảnh — đúng như mong đợi khi chúng đang chờ channel.
Đánh đổi cần cân nhắc
Goroutine rẻ nhưng không phải miễn phí tuyệt đối. Mỗi G vẫn tốn stack (khởi đầu ~2 KB, tăng động) và một chút metadata. 100.000 goroutine chặn chiếm bộ nhớ thật — chỉ là ít hơn 100.000 thread hàng nghìn lần. Tạo hàng triệu goroutine vẫn có thể hết RAM; goroutine rẻ không có nghĩa là vô hạn.
Số M có thể tăng khi G chặn trong syscall. Ở ví dụ này G chặn trên channel (do runtime quản lý), nên M ít. Nhưng khi G chặn trong một syscall thật (đọc file, gọi mạng blocking), M đó bị "mắc kẹt" trong kernel, và runtime tạo M mới để giữ P bận. Với nhiều syscall blocking đồng thời, số M có thể tăng vọt — chủ đề bài về netpoller và syscall.
GOMAXPROCS mặc định = số lõi máy, không phải quota container. Trong container giới hạn CPU, GOMAXPROCS vẫn lấy số lõi vật lý của host, dễ tạo quá nhiều P so với CPU thật được cấp — gây tranh chấp. Đây là một cạm bẫy production, xử lý ở bài GOMAXPROCS và container.
Ba ý mang về
- GMP là ba trụ cột: G (goroutine, rất nhẹ) ghép lên M (OS thread thật, giữ ít) qua P (processor = GOMAXPROCS = số lõi) — một M phải gắn một P mới chạy được G, nên cả biển goroutine được multiplex lên một nhúm thread.
- Đo thật cho thấy 100.001 goroutine chạy trên chỉ 5 OS thread qua 10 processor — nếu mỗi goroutine là một thread thì 100k thread ngốn hàng GB RAM và sập; việc ghép nhiều G lên ít M chính là lý do goroutine gần như miễn phí.
GODEBUG=schedtrace=1là cửa sổ nhìn vào scheduler — đọc được số P (gomaxprocs), số M (threads), hàng đợi toàn cục (runqueue) và hàng đợi cục bộ của từng P; nhưng nhớ số M có thể tăng khi G chặn trong syscall thật, và GOMAXPROCS mặc định không biết quota container.
Bài tập làm thử
Bài 1 (đọc hiểu). Cho đoạn code sau chạy trên máy 4 lõi (GOMAXPROCS mặc định = 4):
var wg sync.WaitGroup
release := make(chan struct{})
wg.Add(5)
for i := 0; i < 5; i++ {
    go func() {
        wg.Done()
        <-release // chặn tới khi release đóng
    }()
}
wg.Wait()
fmt.Println("G:", runtime.NumGoroutine())
fmt.Println("P:", runtime.GOMAXPROCS(0))
close(release)
wg.Wait() chỉ trả về khi cả 5 goroutine đã gọi wg.Done(), tức là cả 5 đều đang chặn ở <-release. Hai dòng fmt.Println in ra giá trị gì?
Đáp án
G: 6 (5 goroutine con đang chặn + goroutine main đang chạy dòng in) và P: 4. Giống hệt cách bài viết đếm G=100.001 (100.000 goroutine chặn + main) khi đo với N=100.000 — runtime.NumGoroutine() luôn tính cả main.
Bài 2 (sửa lỗi). Đoạn code này định đếm xem 100.000 goroutine có khởi động xong chưa rồi mới in kết quả, nhưng chạy sẽ panic gần như ngay lập tức:
var wg sync.WaitGroup
for i := 0; i < 100000; i++ {
    go func() {
        wg.Add(1) // BUG
        wg.Done()
    }()
}
wg.Wait()
fmt.Println("xong")
Lỗi nằm ở đâu và sửa thế nào?
Đáp án
wg.Add(1) bị gọi bên trong goroutine thay vì trước khi go func() chạy, nên wg.Wait() ở main có thể chạy khi bộ đếm còn đang là 0 (goroutine chưa kịp Add) — Wait() trả về ngay lập tức, không đợi gì cả; tệ hơn, nếu một số goroutine Done() sau khi Wait() đã thoát và bộ đếm về âm, sync.WaitGroup panic "negative WaitGroup counter". Sửa: gọi wg.Add(1) ở main, ngay trong vòng for, trước khi gọi go func().
Bài 3 (vận dụng). Một dòng GODEBUG=schedtrace thật trên máy 10 lõi:
SCHED 0ms: gomaxprocs=10 idleprocs=7 threads=5 spinningthreads=1 runqueue=0 [0 0 0 0 0 0 0 0 0 0]
Có bao nhiêu processor (P) đang rảnh tại thời điểm chụp? Có bao nhiêu OS thread (M) mà runtime đang giữ? Vì sao hàng đợi cục bộ của cả 10 P đều là 0 dù có 100.000 goroutine đang sống?
Đáp án
7 P đang rảnh (idleprocs=7), runtime đang giữ 5 thread (threads=5). Hàng đợi cục bộ toàn 0 vì tại thời điểm này, cả 100.000 goroutine đều đang chặn trên channel release (không sẵn sàng chạy) chứ không nằm chờ trong hàng đợi run — hàng đợi chỉ chứa goroutine sẵn sàng chạy, không chứa goroutine đang bị chặn.
Bài 4 (bẫy/đánh đổi). Ứng dụng chạy trong container bị giới hạn cpus: "2" (2 lõi) nhưng deploy trên một máy chủ vật lý có 32 lõi. Đội vận hành thắc mắc vì sao ứng dụng vẫn tạo tới 32 P và có dấu hiệu tranh chấp CPU dù container chỉ được cấp 2 lõi. Giải thích nguyên nhân dựa trên nội dung bài, và nêu một hướng khắc phục.
Đáp án
GOMAXPROCS mặc định lấy số lõi CPU vật lý của host, không biết gì về quota CPU mà container bị giới hạn (đây là cạm bẫy nêu rõ trong bài). Kết quả là ứng dụng tạo 32 P trong khi chỉ có 2 lõi thật được cấp, gây tranh chấp lập lịch. Khắc phục: đặt GOMAXPROCS thủ công bằng số lõi container thực (ví dụ runtime.GOMAXPROCS(2) hoặc biến môi trường tương ứng khi khởi động), hoặc dùng thư viện tự dò quota cgroup để set đúng giá trị.
Bài 5 (bẫy/đánh đổi). Bài viết đo được rằng 100.000 goroutine chặn trên channel chỉ cần 5 OS thread (M). Nếu thay vì chặn trên channel, cả 100.000 goroutine đó gọi một syscall blocking thật (ví dụ đọc file đồng bộ) cùng lúc, số M có xu hướng thay đổi ra sao so với con số 5 đó? Vì sao?
Đáp án
Số M có xu hướng tăng vọt, có thể tiệm cận tới hàng chục nghìn (chứ không còn giữ ở mức 5). Lý do: goroutine chặn trên channel do chính runtime Go quản lý nên không giữ M — M được thả ngay để chạy goroutine khác; nhưng goroutine chặn trong syscall thật khiến M đó bị "mắc kẹt" trong kernel, runtime không lấy lại được nên phải tạo M mới để giữ P bận. Đây chính là cạm bẫy được nêu ở cuối bài, dẫn tới chủ đề netpoller ở phần sau.
Phần sau ta xem P lấy việc cho nhau thế nào khi hàng đợi lệch tải: Phần sau mổ xẻ bộ lập lịch work-stealing — cách một P rảnh "đánh cắp" goroutine từ hàng đợi của P khác để không lõi nào ngồi không.
