Hai bài trước đã thấy GODEBUG=schedtrace xuất hiện, nhưng ta mới lướt qua vài trường. Đây là công cụ chẩn đoán scheduler quan trọng nhất — một biến môi trường có sẵn, không cần thư viện, cho bạn nhìn trực tiếp bộ lập lịch đang làm gì: bao nhiêu processor rảnh, bao nhiêu thread, goroutine xếp hàng ở đâu. Bài này giải mã từng trường của một dòng SCHED, và theo dõi cả vòng đời một chương trình qua các snapshot để bạn biết đọc nó chẩn đoán vấn đề.
Bật và đọc một dòng
GODEBUG=schedtrace=1 go run main.go     # in một dòng SCHED mỗi 1 mili giây
GODEBUG=schedtrace=1000 go run main.go  # mỗi 1 giây (nhẹ hơn, dùng được trên sản xuất)
Mỗi dòng là một snapshot trạng thái scheduler. Giải nghĩa từng trường của một dòng thật:
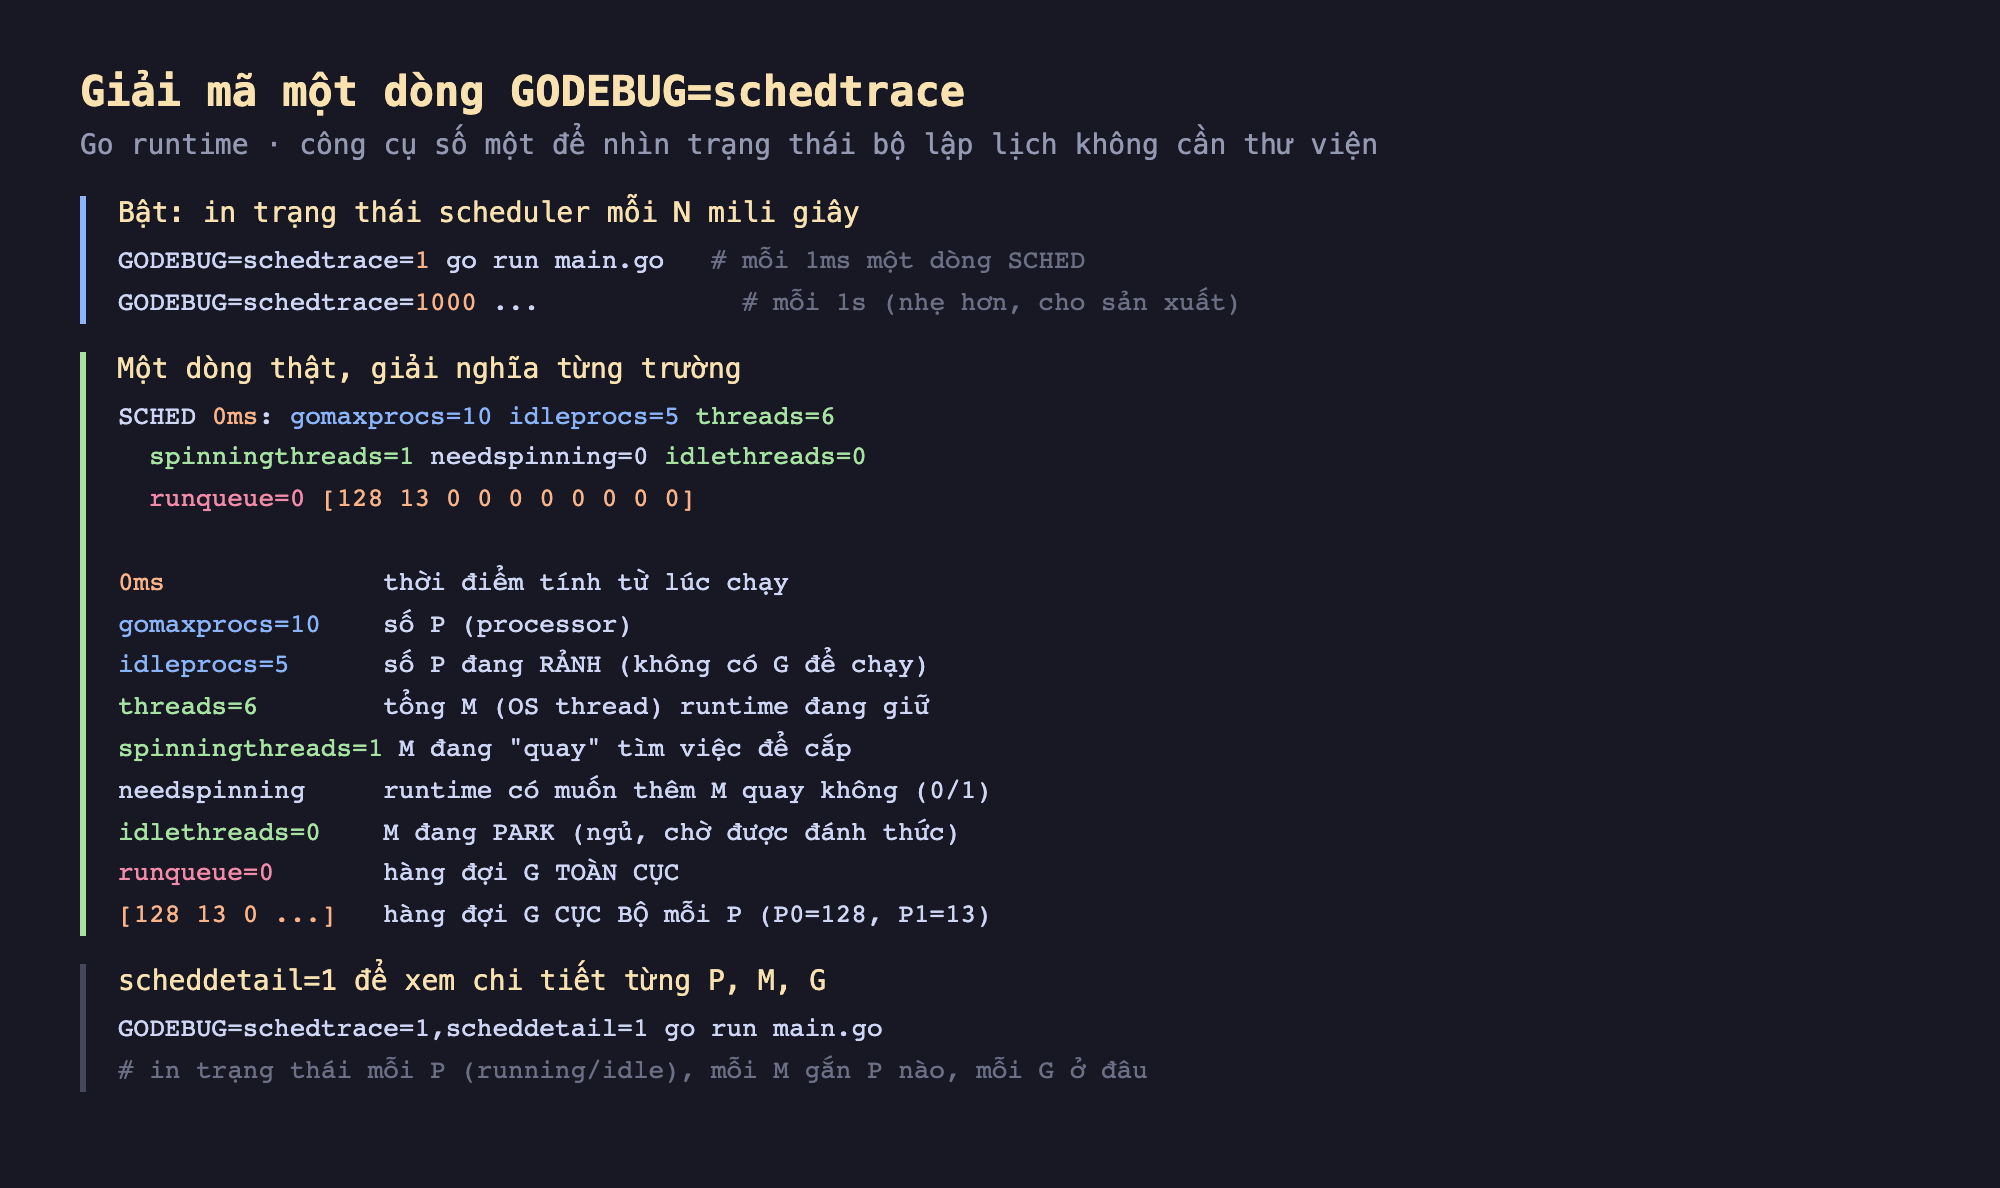
Hình 1: Giải nghĩa từng trường của dòng SCHED — gomaxprocs (P), idleprocs (P rảnh), threads (M), spinningthreads (M đang quay tìm việc), runqueue (hàng đợi toàn cục), và mảng hàng đợi cục bộ mỗi P.
Từng trường:
0ms— thời điểm tính từ lúc chương trình chạy.gomaxprocs=10— số P (=GOMAXPROCS).idleprocs=5— số P đang rảnh (không có goroutine để chạy tại thời điểm chụp).threads=6— tổng số M (OS thread) runtime đang giữ.spinningthreads=1— số M đang "quay" (spinning) tìm việc để đánh cắp — chúng chưa có việc nhưng chưa ngủ, để sẵn sàng nhận việc ngay.needspinning— cờ báo runtime có muốn thêm M quay không.idlethreads=0— số M đang park (ngủ), chờ được đánh thức khi có việc.runqueue=0— độ dài hàng đợi goroutine toàn cục.[128 13 0 ...]— độ dài hàng đợi goroutine cục bộ của từng P (P0 giữ 128, P1 giữ 13).
Muốn chi tiết hơn nữa (trạng thái từng P, từng M gắn P nào, từng G ở đâu), thêm scheddetail=1.
Đo thật: vòng đời một run qua bốn snapshot
Tôi chạy 300 goroutine nặng CPU và bắt các dòng SCHED tại những thời điểm khác nhau — chúng kể trọn vòng đời:
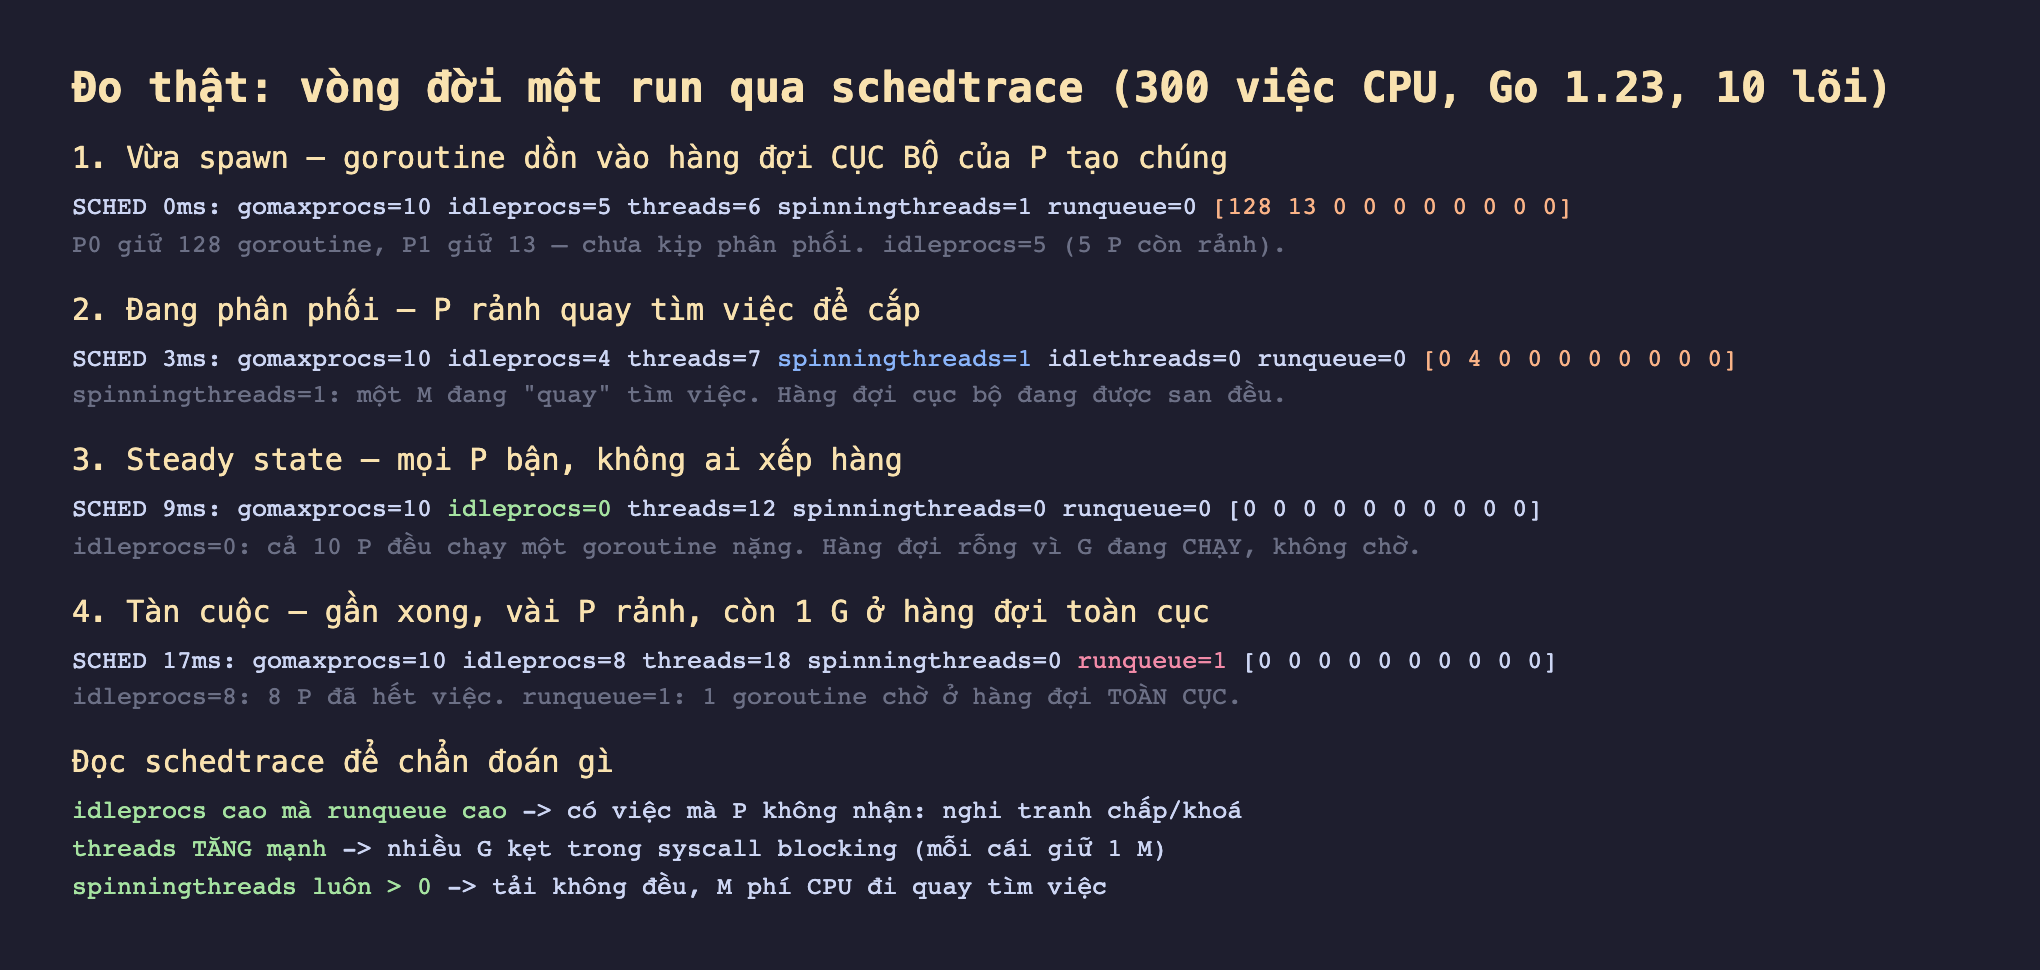
Hình 2: Bốn snapshot thật — (1) vừa spawn: P0 giữ 128 goroutine trong hàng đợi cục bộ; (2) phân phối: spinningthreads=1 đi tìm việc; (3) steady: idleprocs=0, mọi P bận; (4) tàn: idleprocs=8, còn 1 G ở runqueue toàn cục.
Đọc theo dòng thời gian:
0ms— vừa spawn:[128 13 0 ...]. Cả 300 goroutine vừa tạo từ main, dồn vào hàng đợi cục bộ của P chạy main (128) và tràn một ít sang P khác (13). Chúng chưa kịp được phân phối, nênidleprocs=5— 5 P vẫn rảnh.3ms— đang phân phối:spinningthreads=1,[0 4 0 ...]. Một M đang quay tìm việc để đánh cắp; hàng đợi cục bộ đang được san đều ra các P (work-stealing của bài trước).9ms— steady state:idleprocs=0, hàng đợi toàn rỗng. Cả 10 P đều đang chạy một goroutine nặng — không ai xếp hàng vì mọi goroutine đang chạy, không chờ.17ms— tàn cuộc:idleprocs=8,runqueue=1. Gần xong: 8 P đã hết việc, chỉ còn 1 goroutine ở hàng đợi toàn cục.
Vòng đời này — dồn vào một P, phân phối, mọi P bận, rồi cạn dần — là hình mẫu của một workload song song lành mạnh.
Đọc schedtrace để chẩn đoán gì
Đây mới là giá trị thực dụng. Vài tín hiệu cảnh báo:
idleprocscao đồng thờirunqueuecao: có goroutine sẵn sàng chạy (runqueue) nhưng P vẫn rảnh (idleprocs) — nghịch lý này thường do các goroutine bị chặn bởi tranh chấp khoá hoặc một điểm nóng đồng bộ, không thể tiến dù có P rảnh.threadstăng vọt (như thấy nó lên 18 ở trên): nhiều goroutine kẹt trong syscall blocking — mỗi goroutine kẹt syscall giữ một M trong kernel, buộc runtime tạo M mới để giữ P bận. Nếuthreadsphình lớn liên tục, nghi ngờ quá nhiều I/O blocking đồng thời.spinningthreadsluôn > 0: M phí CPU đi quay tìm việc thay vì làm việc — dấu hiệu tải phân bố không đều, goroutine đến rải rác.
Đánh đổi cần cân nhắc
schedtrace=1 (mỗi 1ms) rất ồn và có chi phí. In một dòng mỗi mili giây tạo ra hàng nghìn dòng và bản thân việc in tốn tài nguyên, làm lệch chính cái bạn đo. Dùng schedtrace=1 chỉ để soi kỹ trong lab; trên sản xuất dùng schedtrace=1000 (mỗi giây) hoặc lâu hơn để giám sát nhẹ nhàng.
Đây là snapshot, không phải lịch sử. Mỗi dòng chỉ chụp một khoảnh khắc; giữa hai dòng, scheduler có thể đã làm rất nhiều. Với phân tích sâu hơn (thấy từng sự kiện lập lịch, goroutine bị preempt lúc nào), cần execution tracer (go tool trace) — chủ đề bài riêng. schedtrace cho bức tranh tổng quan rẻ; tracer cho chi tiết đắt hơn.
Số liệu là của runtime, không phải của OS. threads là M do runtime Go quản lý, không phải tổng thread OS của tiến trình (có thể có thread khác từ cgo, thư viện C). Đừng lẫn threads trong schedtrace với con số bạn thấy trong top hay ps.
Ba ý mang về
GODEBUG=schedtracelà cửa sổ rẻ nhất nhìn vào scheduler: mỗi dòng SCHED cho biết số P (gomaxprocs), P rảnh (idleprocs), số OS thread (threads), M đang quay tìm việc (spinningthreads), hàng đợi toàn cục (runqueue) và hàng đợi cục bộ mỗi P — không cần thư viện, chỉ một biến môi trường.- Bốn snapshot thật kể vòng đời một workload song song: goroutine dồn vào hàng đợi cục bộ của P tạo chúng (
[128 13 ...]) → phân phối qua work-stealing (spinningthreads>0) → mọi P bận (idleprocs=0) → cạn dần (runqueue=1). - Đọc để chẩn đoán:
idleprocscao màrunqueuecao = nghi tranh chấp khoá;threadstăng vọt = nhiều syscall blocking giữ M;spinningthreadsluôn >0 = tải không đều — nhưng nhớ dùngschedtrace=1000trên sản xuất (mỗi 1ms quá ồn) và đây là snapshot, cần tracer cho chi tiết.
Bài tập làm thử
Bài 1 (đọc hiểu). Cho dòng schedtrace sau, chụp trên máy GOMAXPROCS=10:
SCHED 9ms: gomaxprocs=10 idleprocs=0 threads=12 spinningthreads=0 runqueue=0 [0 0 0 0 0 0 0 0 0 0]
Dòng này khớp với giai đoạn nào trong bốn giai đoạn vòng đời được mô tả trong bài (vừa spawn / đang phân phối / steady state / tàn cuộc)? Giải thích dựa trên các trường số liệu.
Đáp án
Đây là steady state. Vì idleprocs=0 (không P nào rảnh, cả 10 P đều đang chạy một goroutine) và runqueue=0 cùng hàng đợi cục bộ toàn 0 (không ai xếp hàng) — đúng đặc điểm nêu trong bài: "không ai xếp hàng vì mọi goroutine đang chạy, không chờ". Khớp gần như y hệt snapshot 9ms thật trong bài (idleprocs=0, threads=12, spinningthreads=0, runqueue=0).
Bài 2 (sửa lỗi). Đoạn code này định tạo 300 goroutine tính toán nặng để tái hiện thí nghiệm schedtrace trong bài, nhưng khi chạy chỉ in ra "done" gần như ngay lập tức và chương trình thoát — 300 goroutine gần như chưa kịp chạy gì:
func burn() int {
    x := 0
    for i := 0; i < 200_000_000; i++ {
        x ^= i * 3
    }
    return x
}

func spawnHeavyWork(n int) {
    for i := 0; i < n; i++ {
        go func() {
            burn()
        }()
    }
}

func main() {
    spawnHeavyWork(300)
    fmt.Println("done")
}
Lỗi ở đâu và sửa thế nào để chương trình thật sự đợi 300 goroutine chạy xong?
Đáp án
main không hề đợi các goroutine — nó gọi spawnHeavyWork rồi in "done" và kết thúc ngay, khiến tiến trình thoát trước khi phần lớn (hoặc toàn bộ) 300 goroutine kịp chạy. Sửa bằng sync.WaitGroup: thêm wg.Add(1) trước mỗi go func(), gọi defer wg.Done() trong goroutine, và wg.Wait() trong main trước dòng fmt.Println("done").
Bài 3 (vận dụng). Qua bốn snapshot đo thật trong bài, số threads tăng dần: 6 → 7 → 12 → 18, dù cả 300 goroutine chỉ thuần tính toán CPU (burn()), không hề gọi syscall blocking nào. Dựa vào mục "Đọc schedtrace để chẩn đoán gì", việc threads tăng ở đây có nhất thiết nghĩa là có nhiều syscall blocking không? Giải thích.
Đáp án
Không nhất thiết. Bài chỉ nói threads tăng vọt là tín hiệu nghi ngờ nhiều goroutine kẹt trong syscall blocking, đó là một gợi ý chẩn đoán chứ không phải quy luật tuyệt đối — cần đọc kèm các trường khác (ví dụ spinningthreads, runqueue) và biết workload thực tế đang chạy gì. Ở ví dụ 300 goroutine CPU thuần trong bài, không có syscall blocking nào cả; threads tăng đơn thuần vì runtime cần thêm M để chạy đủ số P bận. Kết luận chỉ dựa trên một chỉ số duy nhất dễ chẩn đoán sai.
Bài 4 (bẫy/đánh đổi). Một kỹ sư muốn giám sát scheduler trên một dịch vụ đang chạy production bằng cách bật GODEBUG=schedtrace=1. Theo bài, đây có phải lựa chọn tốt không? Nêu lựa chọn thay thế và lý do.
Đáp án
Không nên. schedtrace=1 in một dòng SCHED mỗi 1 mili giây, tạo ra hàng nghìn dòng log và bản thân việc in cũng tốn tài nguyên, làm lệch chính cái đang được đo — chỉ phù hợp để soi kỹ trong môi trường lab. Trên production nên dùng schedtrace=1000 (mỗi 1 giây) hoặc lâu hơn, để giám sát nhẹ nhàng mà vẫn có tín hiệu tổng quan.
Bài 5 (bẫy/đánh đổi). Một kỹ sư thấy lệnh top báo tiến trình Go của mình có 40 OS thread, nhưng dòng schedtrace gần nhất lại ghi threads=12. Anh ta kết luận schedtrace bị lỗi. Theo bài, kết luận này có đúng không? Vì sao hai con số có thể khác nhau?
Đáp án
Kết luận đó sai. threads trong schedtrace chỉ đếm số M do chính runtime Go quản lý, không phải tổng số thread OS của cả tiến trình — tiến trình có thể có thêm thread khác đến từ cgo hoặc thư viện C mà runtime Go không đếm vào threads. Bài nhấn mạnh: "đừng lẫn threads trong schedtrace với con số bạn thấy trong top hay ps".
Phần sau ta xem runtime xử lý một goroutine "cứng đầu" thế nào: Phần sau mổ xẻ async preemption — cơ chế từ Go 1.14 cắt ngang một goroutine chạy vòng lặp không hợp tác, để nó không giữ P mãi mãi.
