"Truy vấn nào chậm nhất?" nghe như câu hỏi đúng khi tối ưu, nhưng nó dẫn bạn đi lạc. Câu hỏi đúng là: "truy vấn nào tốn tổng thời gian nhiều nhất trên hệ thống?" — vì một truy vấn nhanh chạy hàng trăm nghìn lần có thể ngốn nhiều thời gian hơn một truy vấn chậm chạy vài lần. Công cụ để trả lời là extension pg_stat_statements, và chìa khoá là cột total_exec_time. Bài này đo thật một nghịch lý khiến nhiều người tối ưu nhầm chỗ.
pg_stat_statements gom theo dạng truy vấn
pg_stat_statements ghi thống kê tích luỹ cho mỗi dạng truy vấn — nó chuẩn hoá tham số, gom mọi lần chạy khác giá trị vào cùng một dòng:
-- WHERE aid=5, WHERE aid=99, WHERE aid=12345 ... đều gom thành:
--   SELECT abalance FROM pgbench_accounts WHERE aid = $1
Nhờ vậy calls đếm đúng tổng số lần dạng đó chạy, không bị phân mảnh theo từng giá trị. Với mỗi dạng, nó lưu calls, total_exec_time, mean_exec_time, rows, số block trúng cache / đọc đĩa, và nhiều nữa.
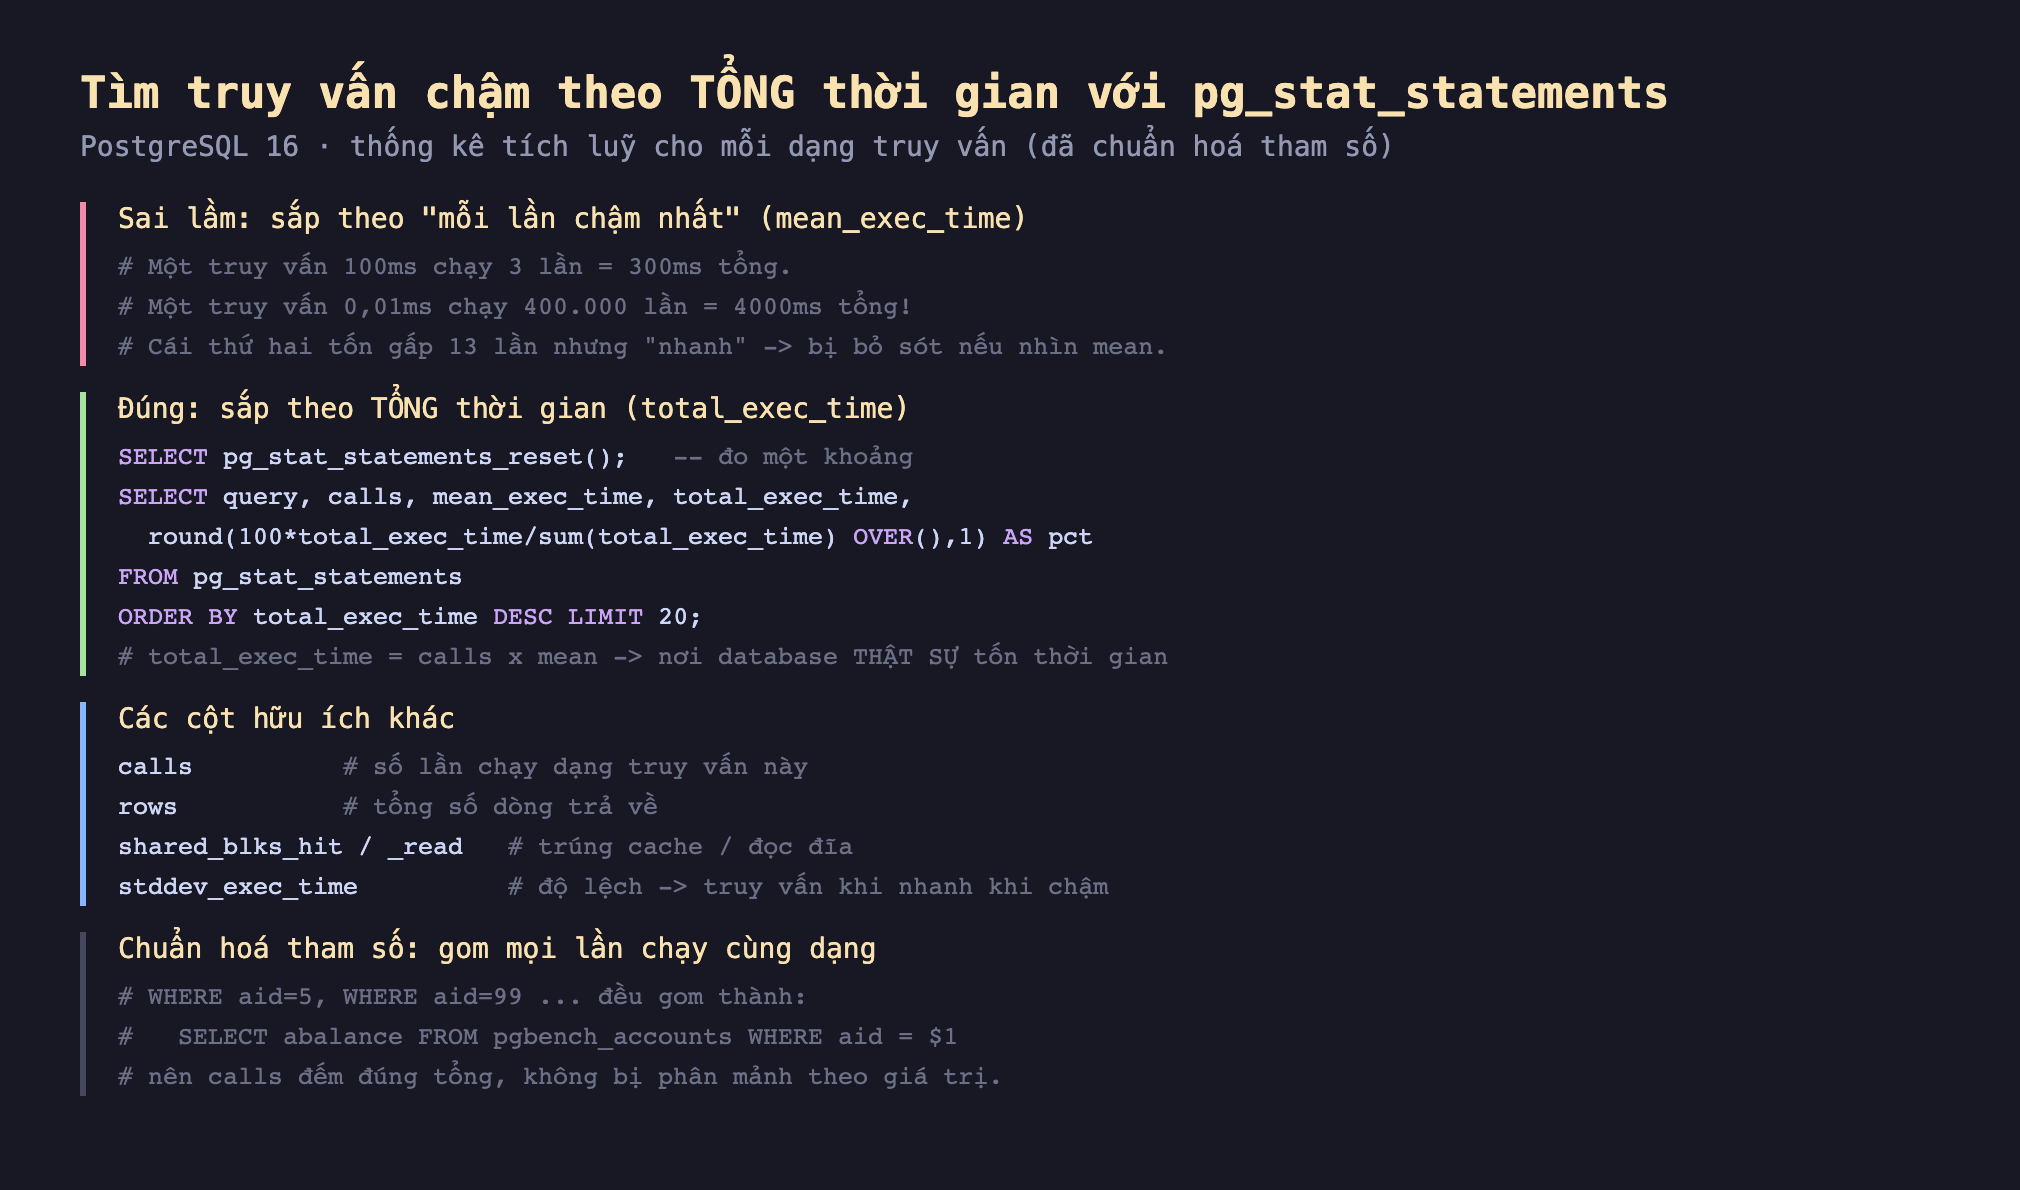
Hình 1: pg_stat_statements chuẩn hoá tham số để gom mọi lần chạy cùng dạng. Sai lầm là sắp theo mean_exec_time (mỗi lần chậm nhất); đúng là sắp theo total_exec_time = calls × mean — nơi database thật sự tốn thời gian.
Đo thật: nghịch lý nhanh × nhiều
Tôi dựng một kịch bản có chủ đích: một truy vấn chậm (full scan 5 triệu dòng, sum(abalance)) chạy 3 lần, và một truy vấn nhanh (point-lookup theo khoá chính, WHERE aid = ...) chạy 427.777 lần (qua pgbench). Rồi sắp xếp hai cách:
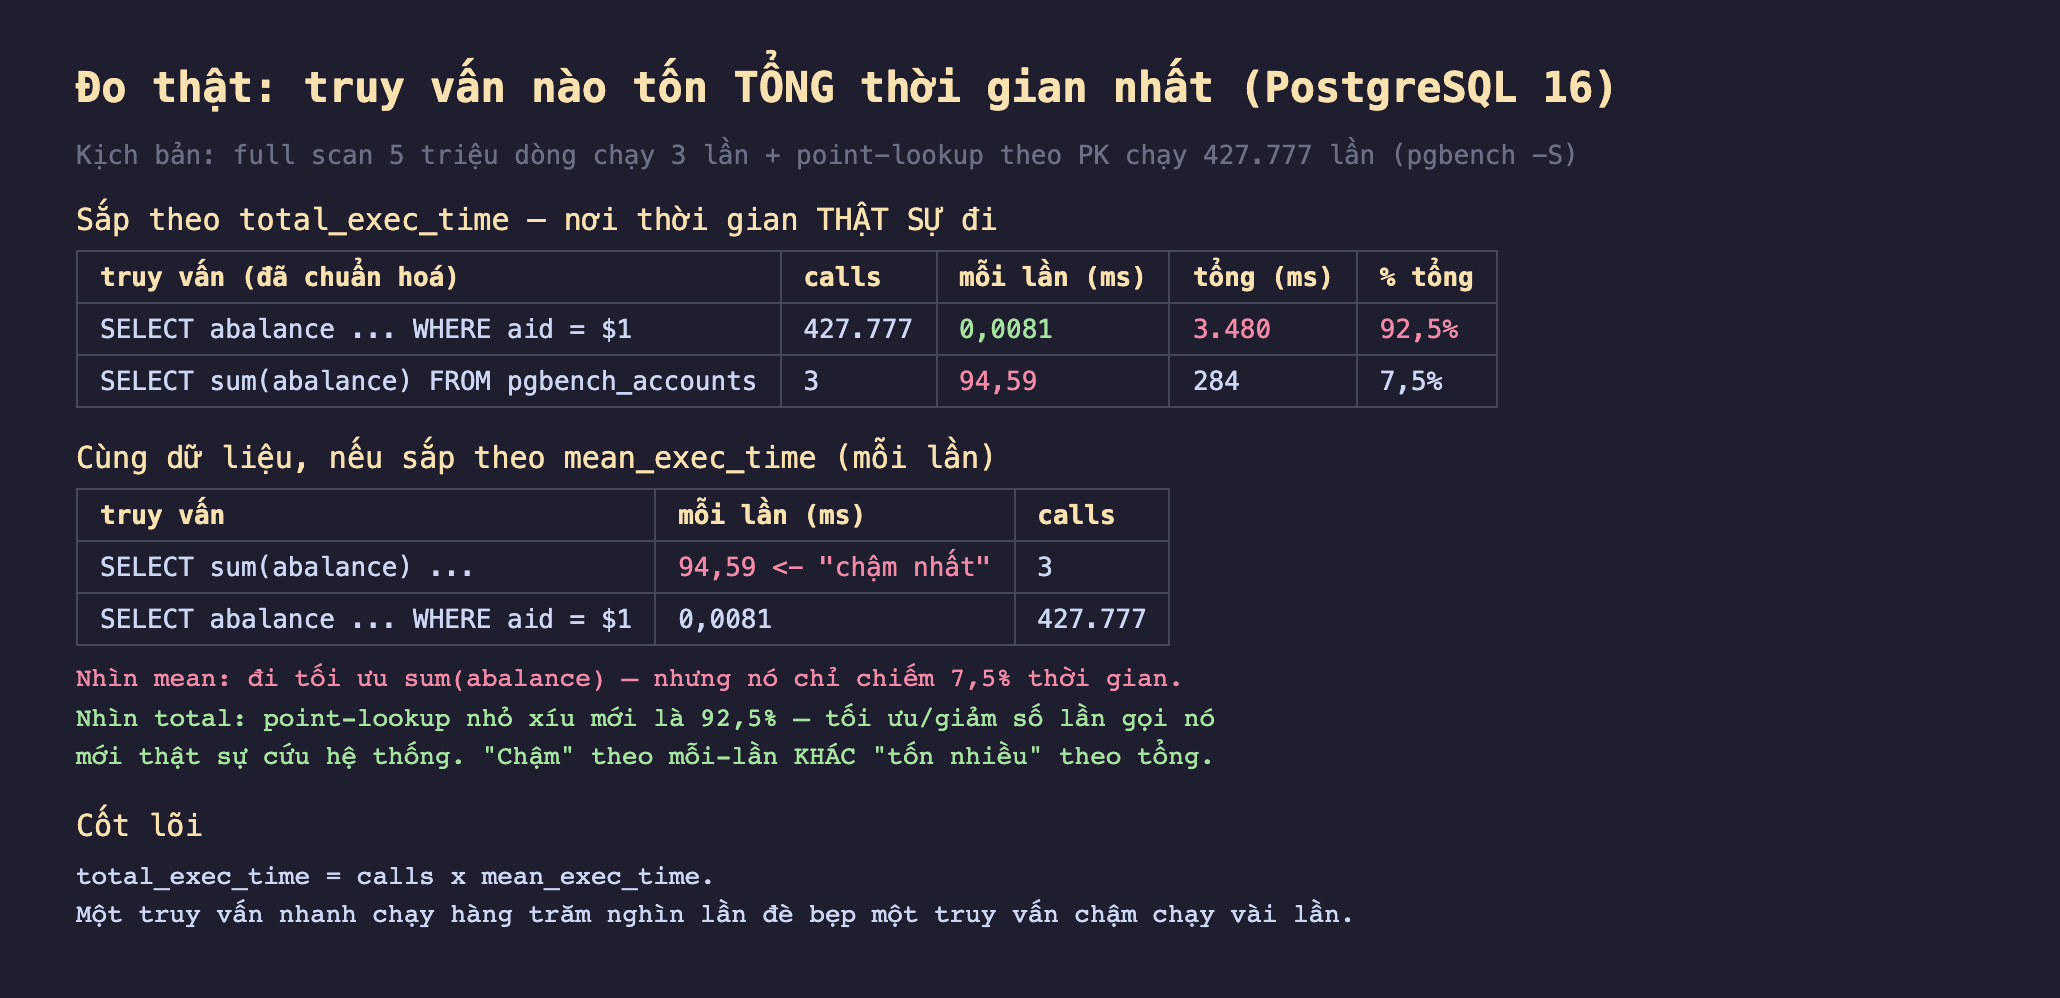
Hình 2: Sắp theo total_exec_time: point-lookup 0,0081 ms × 427.777 lần = 3.480 ms (92,5%), full scan 94,59 ms × 3 = 284 ms (7,5%). Sắp theo mean_exec_time thì full scan đứng đầu — đuổi nhầm thủ phạm.
Kết quả thật:
- Sắp theo
total_exec_time: point-lookupWHERE aid = $1— mỗi lần chỉ 0,0081 ms nhưng chạy 427.777 lần = 3.480 ms tổng, chiếm 92,5% toàn bộ thời gian. Full scansum(abalance)— 94,59 ms/lần nhưng chỉ 3 lần = 284 ms, chỉ 7,5%. - Sắp theo
mean_exec_time: thứ tự đảo ngược — full scan (94,59 ms) đứng đầu vì nó chậm nhất mỗi lần.
Đây là bài học cốt lõi. Nếu bạn nhìn mean_exec_time, bạn sẽ đổ công tối ưu sum(abalance) — nhưng nó chỉ chiếm 7,5% thời gian, tối ưu hết cũng cứu được rất ít. Thủ phạm thật là cái point-lookup 0,0081 ms tưởng như vô hại: nó chiếm 92,5% vì chạy quá nhiều lần. Muốn cứu hệ thống, phải tối ưu nó — hoặc giảm số lần gọi (cache ở tầng ứng dụng), hoặc gộp nhiều lookup thành một truy vấn. "Chậm" theo mỗi-lần khác hẳn "tốn nhiều" theo tổng.
Đọc kết quả cho đúng
Công thức nền tảng: total_exec_time = calls × mean_exec_time. Khi tìm nơi tối ưu, luôn ORDER BY total_exec_time DESC — nó chỉ ra nơi database thực sự đốt thời gian, cân nhắc cả tần suất lẫn chi phí mỗi lần.
Vài cột bổ trợ đáng nhìn cùng:
stddev_exec_timecao nghĩa là truy vấn khi nhanh khi chậm — có thể do dữ liệu lệch hoặc kế hoạch không ổn định, đáng điều tra riêng.shared_blks_readcao nghĩa là đọc đĩa nhiều — thiếu cache hoặc thiếu index.rows / callscho biết mỗi lần trả về bao nhiêu dòng — một truy vấn trả về hàng triệu dòng mỗi lần là dấu hiệu thiết kế cần xem lại.
Đánh đổi cần cân nhắc
Reset để đo đúng khoảng. Số liệu tích luỹ từ lần reset gần nhất. SELECT pg_stat_statements_reset() trước khi đo một khoảng cụ thể (giờ cao điểm, một job) để thấy đúng bức tranh khoảng đó. Không reset thì một truy vấn nặng từ tuần trước vẫn đứng đầu dù giờ đã sửa.
pg_stat_statements có chi phí và giới hạn số dạng. Nó theo dõi tối đa pg_stat_statements.max dạng truy vấn (mặc định 5.000); vượt thì dạng ít dùng bị đẩy ra. Với hệ thống có cực nhiều dạng truy vấn khác nhau (ví dụ SQL sinh động không chuẩn hoá được), có thể mất dữ liệu. Chi phí ghi thống kê nhỏ nhưng không bằng không — đây là đánh đổi đáng giá cho khả năng chẩn đoán.
Tổng thời gian chỉ ra nơi tối ưu, không tự nói cách. Biết point-lookup chiếm 92,5% là bước đầu; bước sau là hỏi vì sao gọi nhiều thế (vòng lặp N+1 ở ứng dụng?), có cache được không, có gộp được không. Đôi khi câu trả lời nằm ở tầng ứng dụng chứ không phải SQL. pg_stat_statements thu hẹp mục tiêu; cách chữa vẫn cần hiểu ngữ cảnh.
Ba ý mang về
- Sắp truy vấn theo
total_exec_time(= calls × mean), không phảimean_exec_time: đo thật một point-lookup 0,0081 ms chạy 427.777 lần chiếm 92,5% tổng thời gian database, còn một full scan 94,59 ms chạy 3 lần chỉ chiếm 7,5% — nhìn mean sẽ đuổi nhầm thủ phạm. pg_stat_statementschuẩn hoá tham số để gom mọi lần chạy cùng dạng (WHERE aid = $1), nêncallsđếm đúng tổng và bạn thấy được dạng truy vấn nào lặp lại nhiều — điều kiện để phát hiện nghịch lý nhanh × nhiều.- Tổng thời gian chỉ ra nơi tối ưu, cách chữa còn tuỳ ngữ cảnh: một truy vấn gọi hàng trăm nghìn lần thường là vòng lặp N+1 hay thiếu cache ở tầng ứng dụng — reset trước khi đo một khoảng, và nhìn kèm
stddev,shared_blks_read,rows/callsđể hiểu bản chất.
Phần sau ta chuyển từ thống kê trực tuyến sang phân tích log lịch sử: Phần sau tìm hiểu pgBadger — công cụ sinh báo cáo hiệu năng trực quan từ log PostgreSQL, cho thấy truy vấn chậm, giờ cao điểm và lỗi theo thời gian.
