Trước PostgreSQL 16, việc theo dõi I/O của database khá thô: bạn biết tổng số block đọc và trúng cache, nhưng không biết ai gây ra, vì sao, hay I/O đó là đọc thường, quét lớn, hay dọn dẹp VACUUM. Phiên bản 16 thêm một view mới thay đổi hẳn cuộc chơi: pg_stat_io. Nó tách I/O theo ba chiều, cho cái nhìn chi tiết chưa từng có về việc đĩa đang bị dùng vào việc gì. Bài này đo thật vài kịch bản để thấy sức mạnh của nó.
Ba chiều phân loại
Mỗi dòng trong pg_stat_io được phân loại theo ba chiều — trả lời ai, cái gì, vì sao:
backend_type— AI gây ra I/O:client backend(truy vấn người dùng),autovacuum worker,checkpointer,background writer, ...object— CÁI GÌ:relation(bảng/index thường) haytemp relation(bảng tạm).context— VÌ SAO:normal(truy cập thông thường),bulkread(quét lớn),bulkwrite(ghi hàng loạt như COPY),vacuum(dọn dẹp).
Cùng với đó là các cột đo lường: reads (đọc đĩa), hits (trúng cache), writes, extends (mở rộng file), evictions, reuses, fsyncs, và các cột *_time.
SELECT pg_stat_reset_shared('io');   -- reset để đo một khoảng
SELECT backend_type, context, reads, hits, extends, reuses
FROM pg_stat_io WHERE reads>0 OR writes>0 OR extends>0;
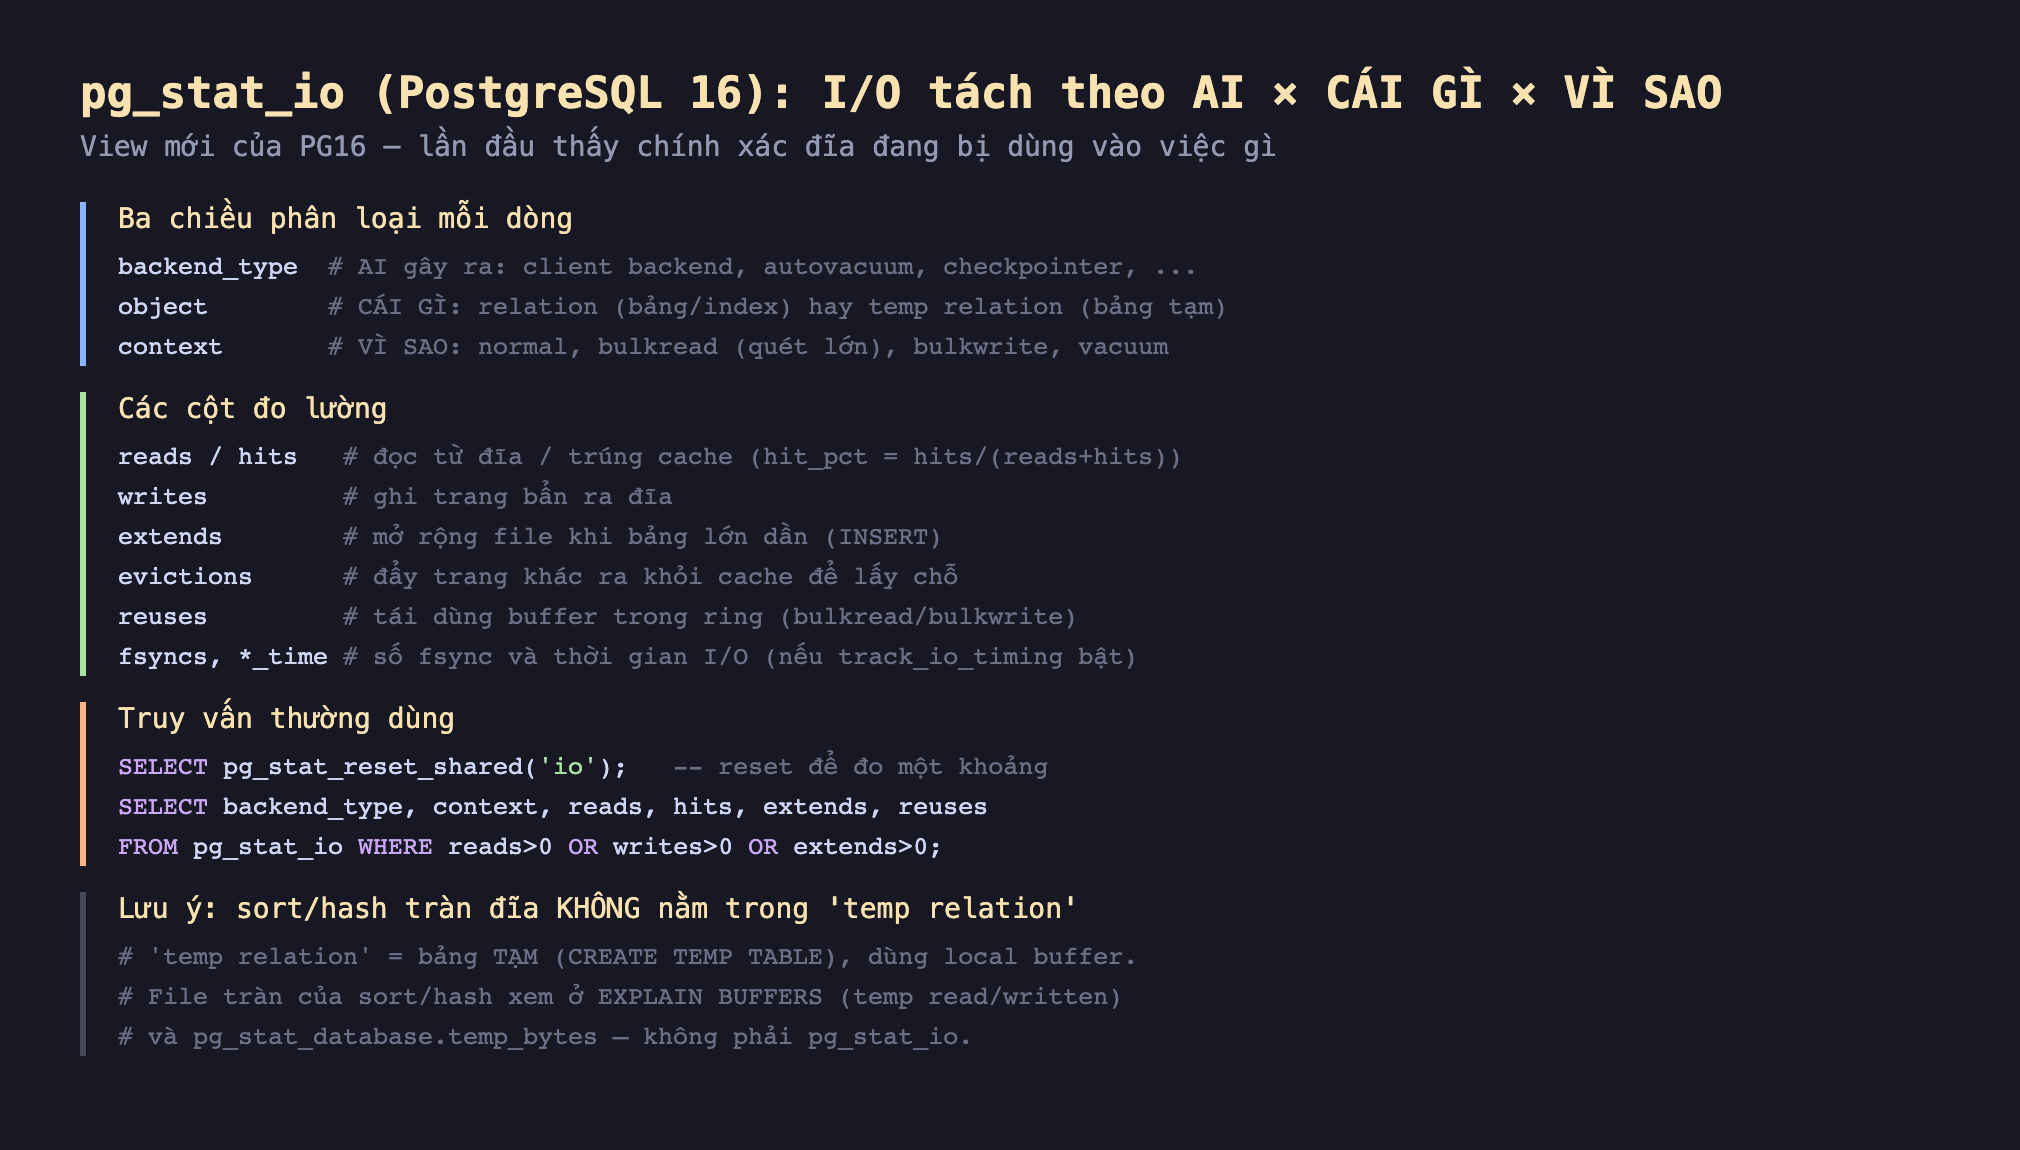
Hình 1: pg_stat_io phân loại mỗi dòng theo backend_type (ai) × object (cái gì) × context (vì sao), với các cột reads/hits/writes/extends/reuses. Lưu ý sort/hash tràn đĩa không nằm trong "temp relation".
Đo thật: quét lớn dùng ring buffer
Kịch bản đầu tiên hé lộ một cơ chế mà trước đây gần như vô hình. Tôi quét tuần tự bảng pgbench_accounts 925 MB (lớn hơn shared_buffers 128 MB) sau khi reset thống kê I/O:
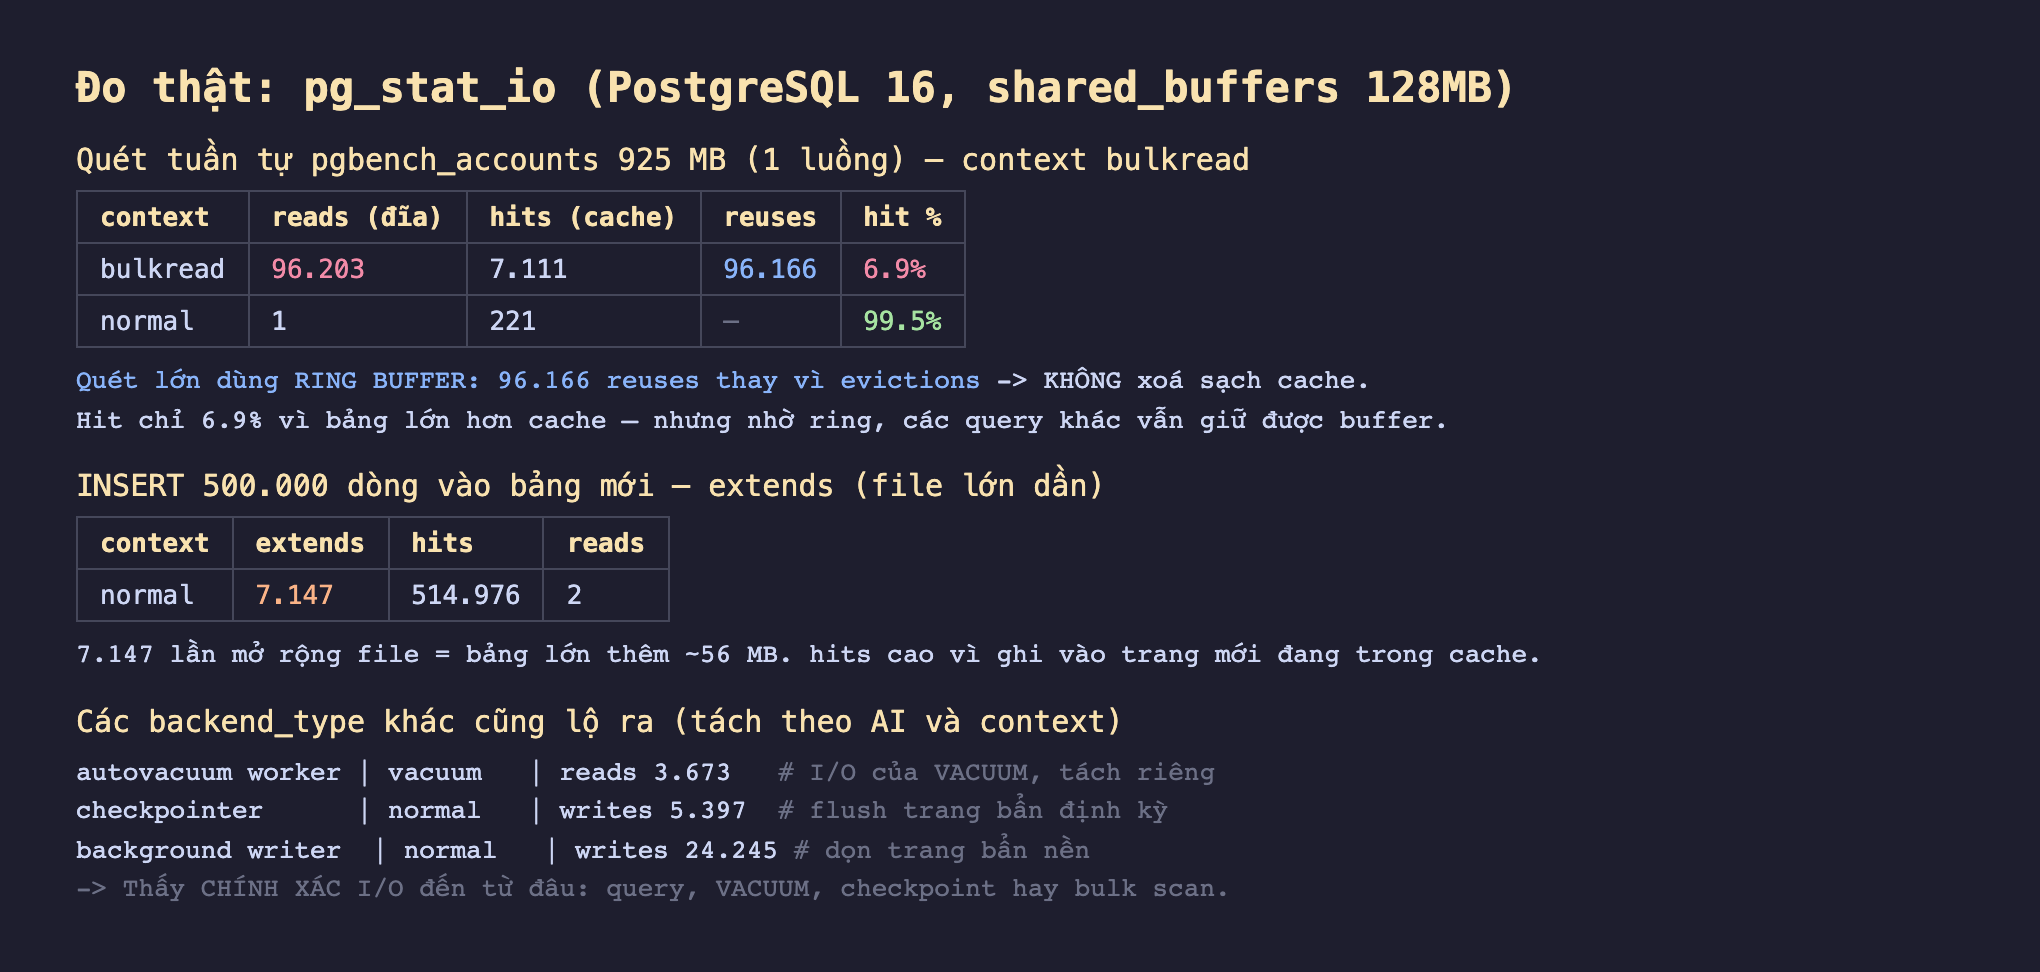
Hình 2: Seq scan lớn dùng context bulkread: 96.203 reads đĩa, chỉ 6,9% hit, nhưng 96.166 reuses (ring buffer) thay vì evictions. INSERT tạo 7.147 extends. Và I/O của autovacuum/checkpointer/background writer tách riêng.
Kết quả thật:
- context bulkread: 96.203 reads, chỉ 7.111 hits — hit ratio 6,9% — và 96.166 reuses.
- context normal: 1 read, 221 hits — 99,5%.
Con số reuses lớn tiết lộ điều quan trọng: khi quét một bảng lớn hơn bộ nhớ, PostgreSQL không nạp toàn bộ vào shared_buffers (làm vậy sẽ đẩy hết dữ liệu nóng khác ra ngoài). Thay vào đó nó dùng một ring buffer nhỏ và tái dùng (reuse) các buffer trong ring đó — 96.166 lần. Vì thế một seq scan khổng lồ không xoá sạch cache của bạn. Hit ratio thấp (6,9%) là chuyện đương nhiên với bảng lớn hơn ring, nhưng đổi lại các truy vấn khác vẫn giữ được buffer của chúng. Trước pg_stat_io, cơ chế này hoàn toàn ẩn.
Extends và I/O của từng loại tiến trình
Extends — khi bảng lớn dần. Tôi INSERT 500.000 dòng vào một bảng mới: pg_stat_io ghi extends = 7.147 (mở rộng file 7.147 lần, bảng lớn thêm ~56 MB), với hits cao (514.976) vì ghi vào các trang mới vẫn đang trong cache. Đây là cách nhìn ra một bảng đang tăng trưởng nhanh qua I/O.
Tách theo tiến trình. Điểm mạnh nhất của pg_stat_io là thấy I/O đến từ ai: autovacuum worker với context vacuum (I/O dọn dẹp, tách riêng khỏi truy vấn), checkpointer (flush trang bẩn định kỳ), background writer (dọn trang bẩn nền). Nếu đĩa bị quá tải, bạn biết ngay thủ phạm là truy vấn người dùng, VACUUM, checkpoint, hay một bulk scan — thay vì đoán mò như trước.
Đánh đổi cần cân nhắc
"temp relation" không phải là temp file của sort. Đây là điểm dễ nhầm. object = 'temp relation' theo dõi I/O trên bảng tạm (CREATE TEMP TABLE, dùng local buffer). Còn file tràn đĩa của sort/hash khi thiếu work_mem không nằm ở đây — đo thật một sort tràn 117 MB ra đĩa cho thấy pg_stat_io temp relation vẫn bằng 0. Loại I/O đó xem ở EXPLAIN (BUFFERS) (dòng temp read/written) và pg_stat_database.temp_bytes.
Cần track_io_timing để có thời gian I/O. Các cột read_time, write_time, fsync_time chỉ có số liệu khi bật track_io_timing. Nó có chi phí nhỏ (đo thời gian mỗi thao tác I/O) nhưng cho thông tin quý — thời gian chờ I/O, không chỉ số lượng. Cân nhắc bật trên hệ thống cần chẩn đoán sâu.
Thống kê tích luỹ, reset để đo khoảng. Như mọi view pg_stat_*, số liệu cộng dồn từ lần reset gần nhất. Dùng pg_stat_reset_shared('io') trước khi đo một khoảng cụ thể — ví dụ trước và sau một job nạp dữ liệu — để thấy đúng I/O của khoảng đó thay vì con số tích luỹ từ khi khởi động.
Ba ý mang về
pg_stat_io(mới ở PG16) tách I/O theo ba chiều: ai gây ra (backend_type), trên cái gì (object), vì sao (context) — cho phép thấy chính xác đĩa bị dùng vào việc gì (truy vấn thường, quét lớn, VACUUM, checkpoint), thay vì chỉ có tổng số đọc/trúng cache như trước.- Đo thật hé lộ cơ chế ring buffer cho quét lớn: seq scan bảng 925 MB dùng context bulkread với 96.166 reuses thay vì evictions và hit ratio 6,9% — chứng minh vì sao một seq scan lớn không xoá sạch cache của các truy vấn khác, điều trước đây gần như vô hình.
- Chú ý hai điểm dễ nhầm:
temp relationlà bảng tạm chứ không phải file tràn của sort/hash (loại đó xem ởEXPLAIN BUFFERSvàpg_stat_database.temp_bytes), và cần bậttrack_io_timingđể có các cột thời gian I/O; nhớ reset để đo đúng khoảng.
Phần sau ta quay lại bài toán thực dụng nhất của tối ưu: Phần sau tìm truy vấn chậm theo thời gian bằng pg_stat_statements — cách xác định câu lệnh nào tốn tổng thời gian nhiều nhất trên hệ thống, chứ không chỉ chậm một lần.
