Bạn nghi có bảng nào đó đang bị quét tuần tự (đọc cả bảng) quá nhiều vì thiếu index, nhưng bảng nào? Kiểm từng truy vấn bằng EXPLAIN thì mò kim đáy bể. Có một cách nhìn tổng thể: view pg_stat_user_tables đếm tích luỹ mỗi bảng đã bị quét tuần tự bao nhiêu lần, dùng index bao nhiêu lần, và đọc tổng cộng bao nhiêu dòng. Từ đó tìm ra bảng đáng ngờ chỉ trong một truy vấn. Bài này đo thật một bảng thiếu index, và làm rõ một cạm bẫy: không phải cứ nhiều seq scan là xấu.
Các cột cần đọc
pg_stat_user_tables có một dòng cho mỗi bảng, với những cột chẩn đoán quan trọng:
seq_scan: số lần bảng bị quét tuần tự (đọc toàn bộ).seq_tup_read: tổng số dòng đã đọc qua tất cả các lần seq scan — con số quan trọng nhất.idx_scan: số lần dùng index.idx_tup_fetch: số dòng lấy qua index.n_live_tup/n_dead_tup: dòng sống / dòng chết (dấu hiệu bloat).
-- Tìm bảng đọc nhiều dòng nhất qua seq scan (nghi thiếu index):
SELECT relname, seq_scan, idx_scan,
  round(100.0*seq_scan/nullif(seq_scan+idx_scan,0),1) AS pct_seq,
  seq_tup_read
FROM pg_stat_user_tables
WHERE seq_scan+idx_scan > 0
ORDER BY seq_tup_read DESC;   -- đọc nhiều dòng nhất lên đầu
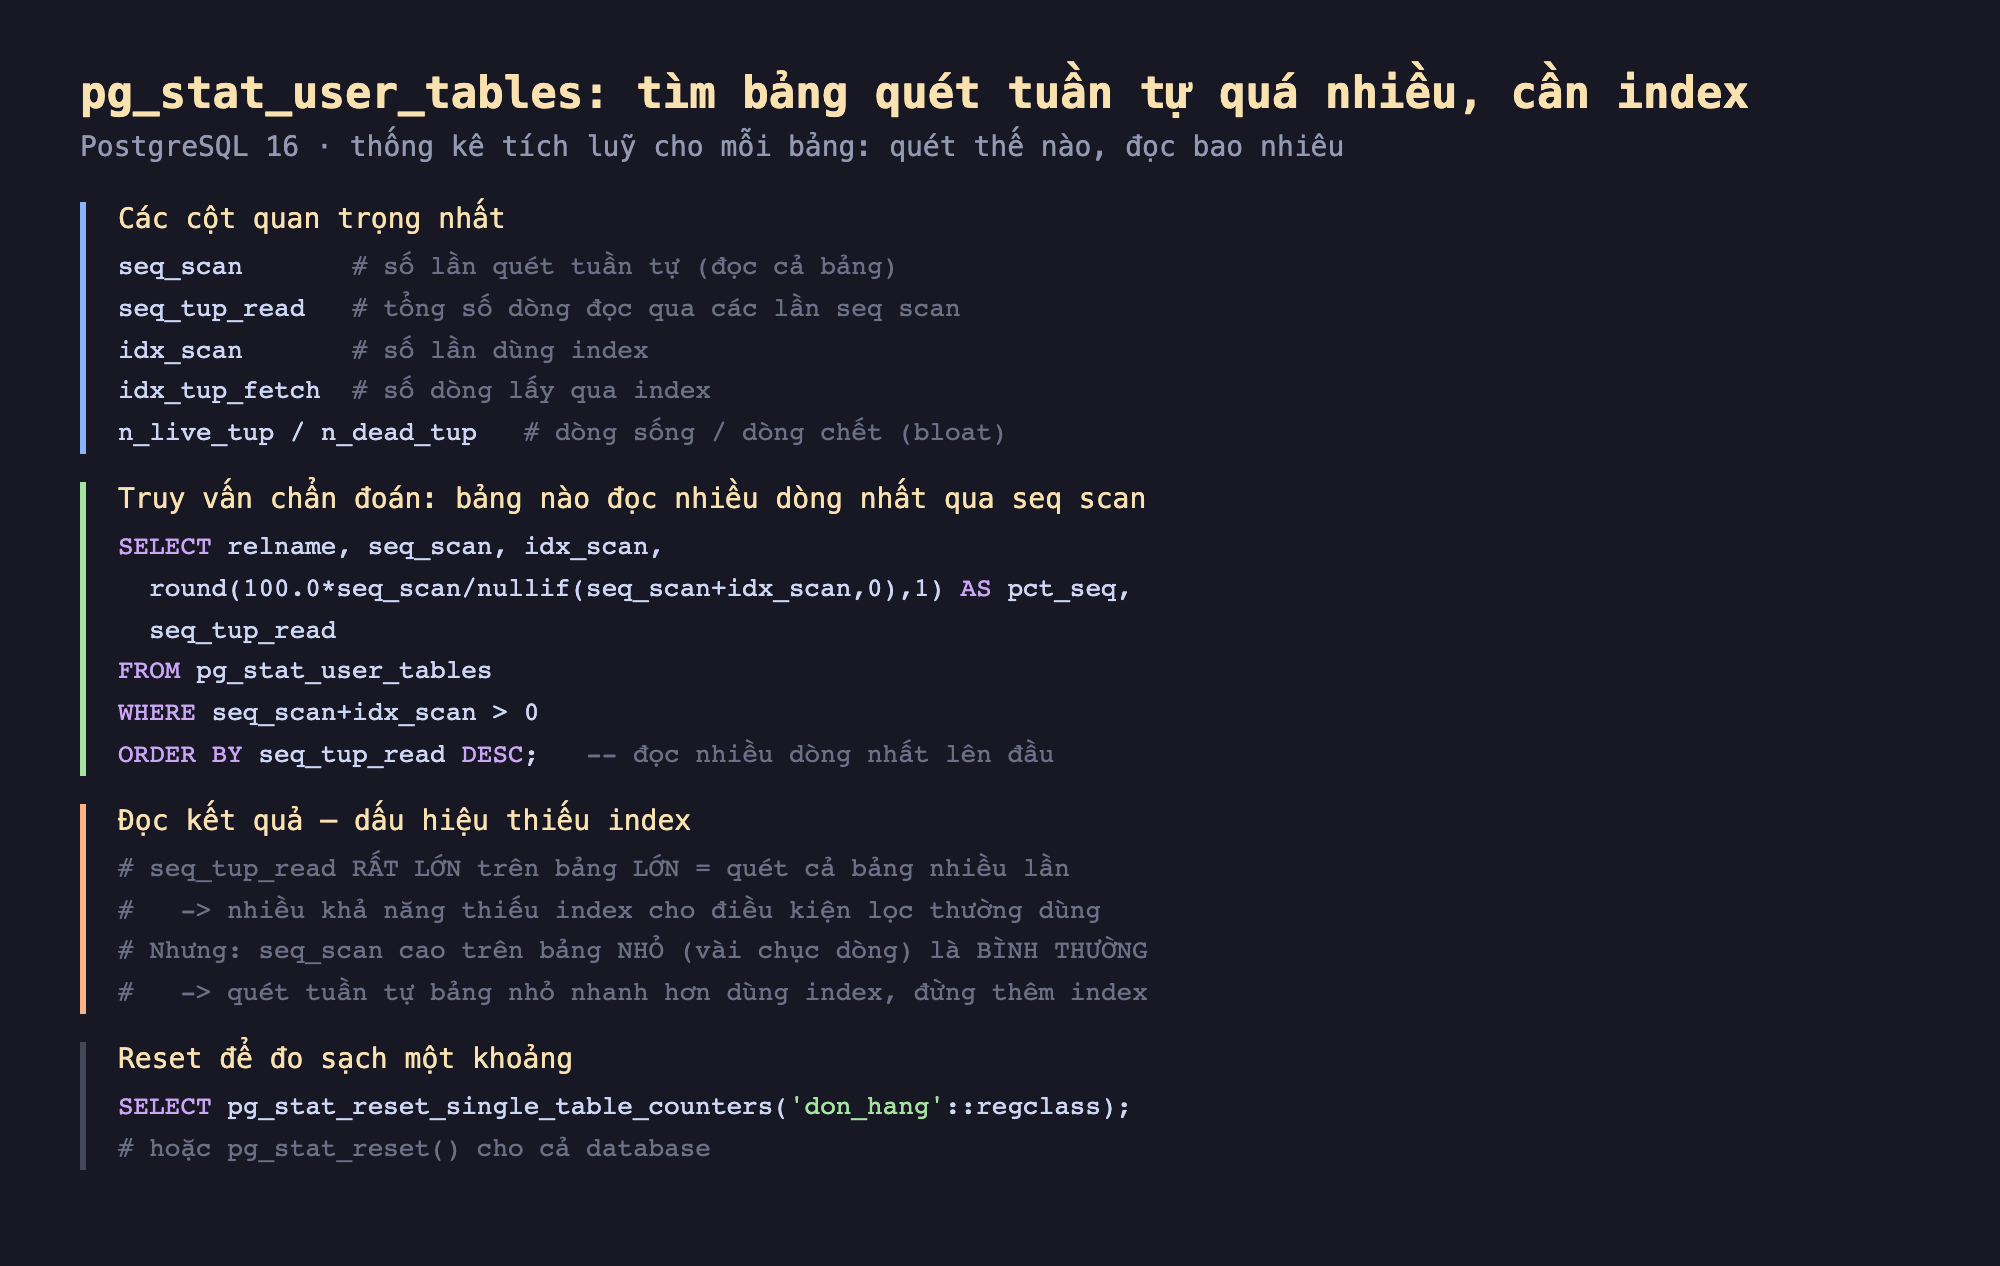
Hình 1: Các cột chính của pg_stat_user_tables và truy vấn chẩn đoán sắp theo seq_tup_read. Dấu hiệu thiếu index là seq_tup_read lớn trên bảng lớn — nhưng nhiều seq scan trên bảng nhỏ là bình thường.
Đo thật: một bảng thiếu index
Bảng don_hang một triệu dòng. Tôi reset bộ đếm rồi chạy 20 truy vấn lọc theo khach_id (chưa có index trên cột này), soi pg_stat_user_tables:
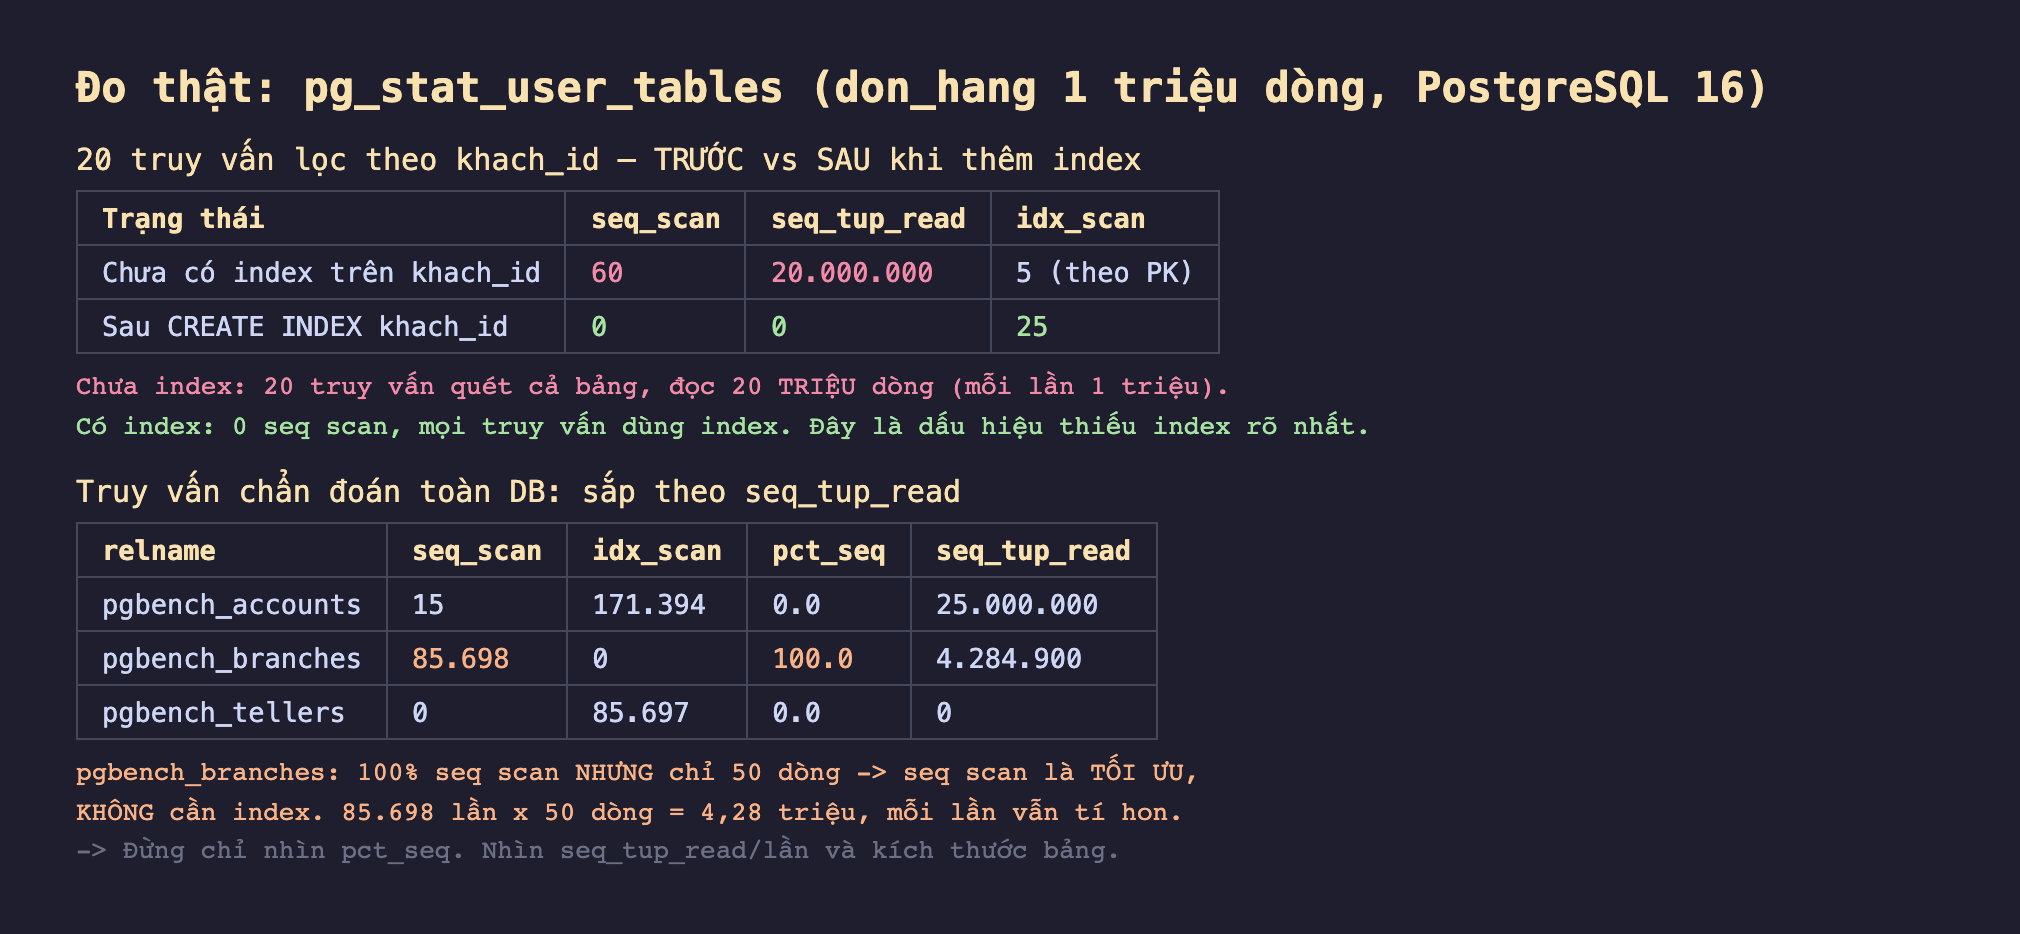
Hình 2: Chưa index trên khach_id: 60 seq_scan đọc 20 triệu dòng. Sau CREATE INDEX: 0 seq_scan, mọi truy vấn dùng index. Truy vấn chẩn đoán toàn DB cho thấy pgbench_branches 100% seq nhưng chỉ 50 dòng (bình thường).
Con số thật:
- Chưa có index trên
khach_id:seq_scan = 60,seq_tup_read = 20.000.000. Hai mươi truy vấn của tôi quét cả bảng, mỗi lần đọc một triệu dòng — tổng 20 triệu dòng đọc chỉ để đếm vài kết quả. (idx_scan = 5là các truy vấn khác lọc theo khoá chính.) - Sau
CREATE INDEX idx_dh_khach ON don_hang(khach_id)rồi reset và chạy lại:seq_scan = 0,seq_tup_read = 0,idx_scan = 25. Mọi truy vấn giờ dùng index — không còn đọc thừa dòng nào.
Đây chính là dấu hiệu thiếu index rõ nhất: một bảng lớn có seq_tup_read khổng lồ. Thêm index đúng cột lọc, con số về không.
Cạm bẫy: không phải seq scan nào cũng xấu
Truy vấn chẩn đoán toàn database cho một kết quả đáng suy ngẫm. pgbench_branches có seq_scan = 85.698 và pct_seq = 100% — 100% truy vấn của nó là quét tuần tự! Nghe như một thảm hoạ thiếu index. Nhưng nhìn kỹ: bảng này chỉ có 50 dòng. seq_tup_read = 4.284.900 = 85.698 lần × 50 dòng — mỗi lần quét vẫn tí hon.
Với bảng 50 dòng, quét tuần tự nhanh hơn dùng index (index phải đọc trang index rồi mới tới trang dữ liệu, tốn hơn việc đọc thẳng 50 dòng nằm trong một trang). PostgreSQL cố ý chọn seq scan ở đây — và đó là tối ưu. Thêm index vào bảng nhỏ này chỉ tốn chỗ và làm chậm ghi, không giúp gì.
Bài học: đừng chỉ nhìn pct_seq. Con số cần chú ý là seq_tup_read trên các bảng lớn. Một bảng lớn bị đọc hàng triệu dòng qua seq scan mới là bảng cần điều tra.
Đánh đổi cần cân nhắc
Thống kê là tích luỹ từ lần reset gần nhất. Các con số cộng dồn từ khi database khởi động hoặc từ lần pg_stat_reset cuối. Để đo một khoảng cụ thể (ví dụ "trong giờ cao điểm hôm nay"), reset trước rồi đo sau bằng pg_stat_reset_single_table_counters hoặc pg_stat_reset. Nếu không, một bảng seq scan nhiều từ lâu vẫn hiện con số lớn dù giờ đã có index.
seq_tup_read lớn chỉ ra hướng, không tự động nghĩa là thêm index. Nó nói "bảng này bị quét đọc nhiều dòng" — bước tiếp theo là xem truy vấn nào gây ra (dùng pg_stat_statements), lọc theo cột nào, rồi mới quyết định index. Đôi khi câu trả lời không phải index mà là viết lại truy vấn, hoặc chấp nhận seq scan nếu truy vấn thật sự cần phần lớn bảng.
Index không miễn phí. Mỗi index làm chậm INSERT/UPDATE/DELETE (phải cập nhật index) và tốn đĩa — như các bài trước đã đo. Thêm index để diệt seq scan phải cân với chi phí đó. Với bảng ghi nhiều, đọc ít, một index thừa có thể hại hơn lợi.
Ba ý mang về
pg_stat_user_tablesđếm tích luỹ mỗi bảng bị seq scan hay dùng index bao nhiêu lần — sắp theoseq_tup_readgiảm dần để tìm bảng đọc nhiều dòng nhất qua quét tuần tự, dấu hiệu số một của thiếu index.- Đo thật một bảng 1 triệu dòng thiếu index: 20 truy vấn lọc
khach_idgây 60 seq scan đọc 20 triệu dòng; thêm index đúng cột thì về 0 seq scan và mọi truy vấn dùng index. - Đừng chỉ nhìn
pct_seq: một bảng nhỏ (pgbench_branches 50 dòng) có 100% seq scan vẫn hoàn toàn bình thường và tối ưu — con số đáng lo làseq_tup_readlớn trên bảng lớn; và nhớ reset bộ đếm để đo đúng khoảng thời gian cần quan tâm.
Phần sau ta xét một view thống kê mới và mạnh của PostgreSQL 16: Phần sau mổ xẻ pg_stat_io — cái nhìn chi tiết chưa từng có về I/O của database, tách theo loại thao tác và ngữ cảnh, giúp thấy chính xác đĩa đang bị dùng vào việc gì.
