Suốt sê-ri này ta dùng benchmark để đo hiệu năng — nhưng benchmark có giới hạn cố hữu: nó đo cái bạn nghĩ là nóng. Trong production, điểm nóng thật thường ở chỗ bất ngờ: một hàm serialize tưởng rẻ hóa ra ngốn 40% CPU dưới tải thật, một chỗ cấp phát ẩn gây áp lực GC chỉ với dữ liệu thật, một mutex tranh chấp chỉ khi đủ đồng thời. Benchmark không lộ những thứ đó vì nó không có tải thật, dữ liệu thật, tương tác thật.
Continuous profiling giải bằng cách thu hồ sơ (profile) từ dịch vụ đang chạy, liên tục, để thấy CPU và bộ nhớ thực sự đi đâu. Go có công cụ tích hợp mạnh: package net/http/pprof phơi các endpoint cho phép thu profile từ một service live mà không dừng nó. Bài này dựng một service với pprof endpoint, thu CPU và heap profile từ nó khi đang chạy, và phân tích để tìm hàm nóng — nền tảng của mọi hệ continuous profiling.
Bật endpoint pprof: chỉ một dòng import
import _ "net/http/pprof" // đăng ký /debug/pprof/* lên DefaultServeMux

func main() {
	go func() {
		// mở cổng riêng cho profiling (KHÔNG lộ ra Internet)
		http.ListenAndServe("localhost:6060", nil)
	}()
	// ... dịch vụ chính chạy bình thường ...
}
Chỉ cần import _ "net/http/pprof" (import blank — chạy hàm init của package để đăng ký handler) và mở một HTTP server. Không code thêm gì; các endpoint profiling tự sẵn sàng.
Các endpoint pprof phơi ra
/debug/pprof/profile   // hồ sơ CPU (mặc định 30s, ?seconds=N)
/debug/pprof/heap      // bộ nhớ đang cấp phát
/debug/pprof/allocs    // tổng cấp phát tích lũy
/debug/pprof/goroutine // stack mọi goroutine (tìm rò rỉ goroutine)
/debug/pprof/block     // chờ trên channel/mutex
/debug/pprof/mutex     // tranh chấp khóa
Mỗi endpoint cho một góc nhìn khác nhau: CPU (thời gian chạy), heap (bộ nhớ giữ), goroutine (tìm rò rỉ goroutine — số goroutine tăng mãi), block/mutex (điểm nghẽn đồng thời).
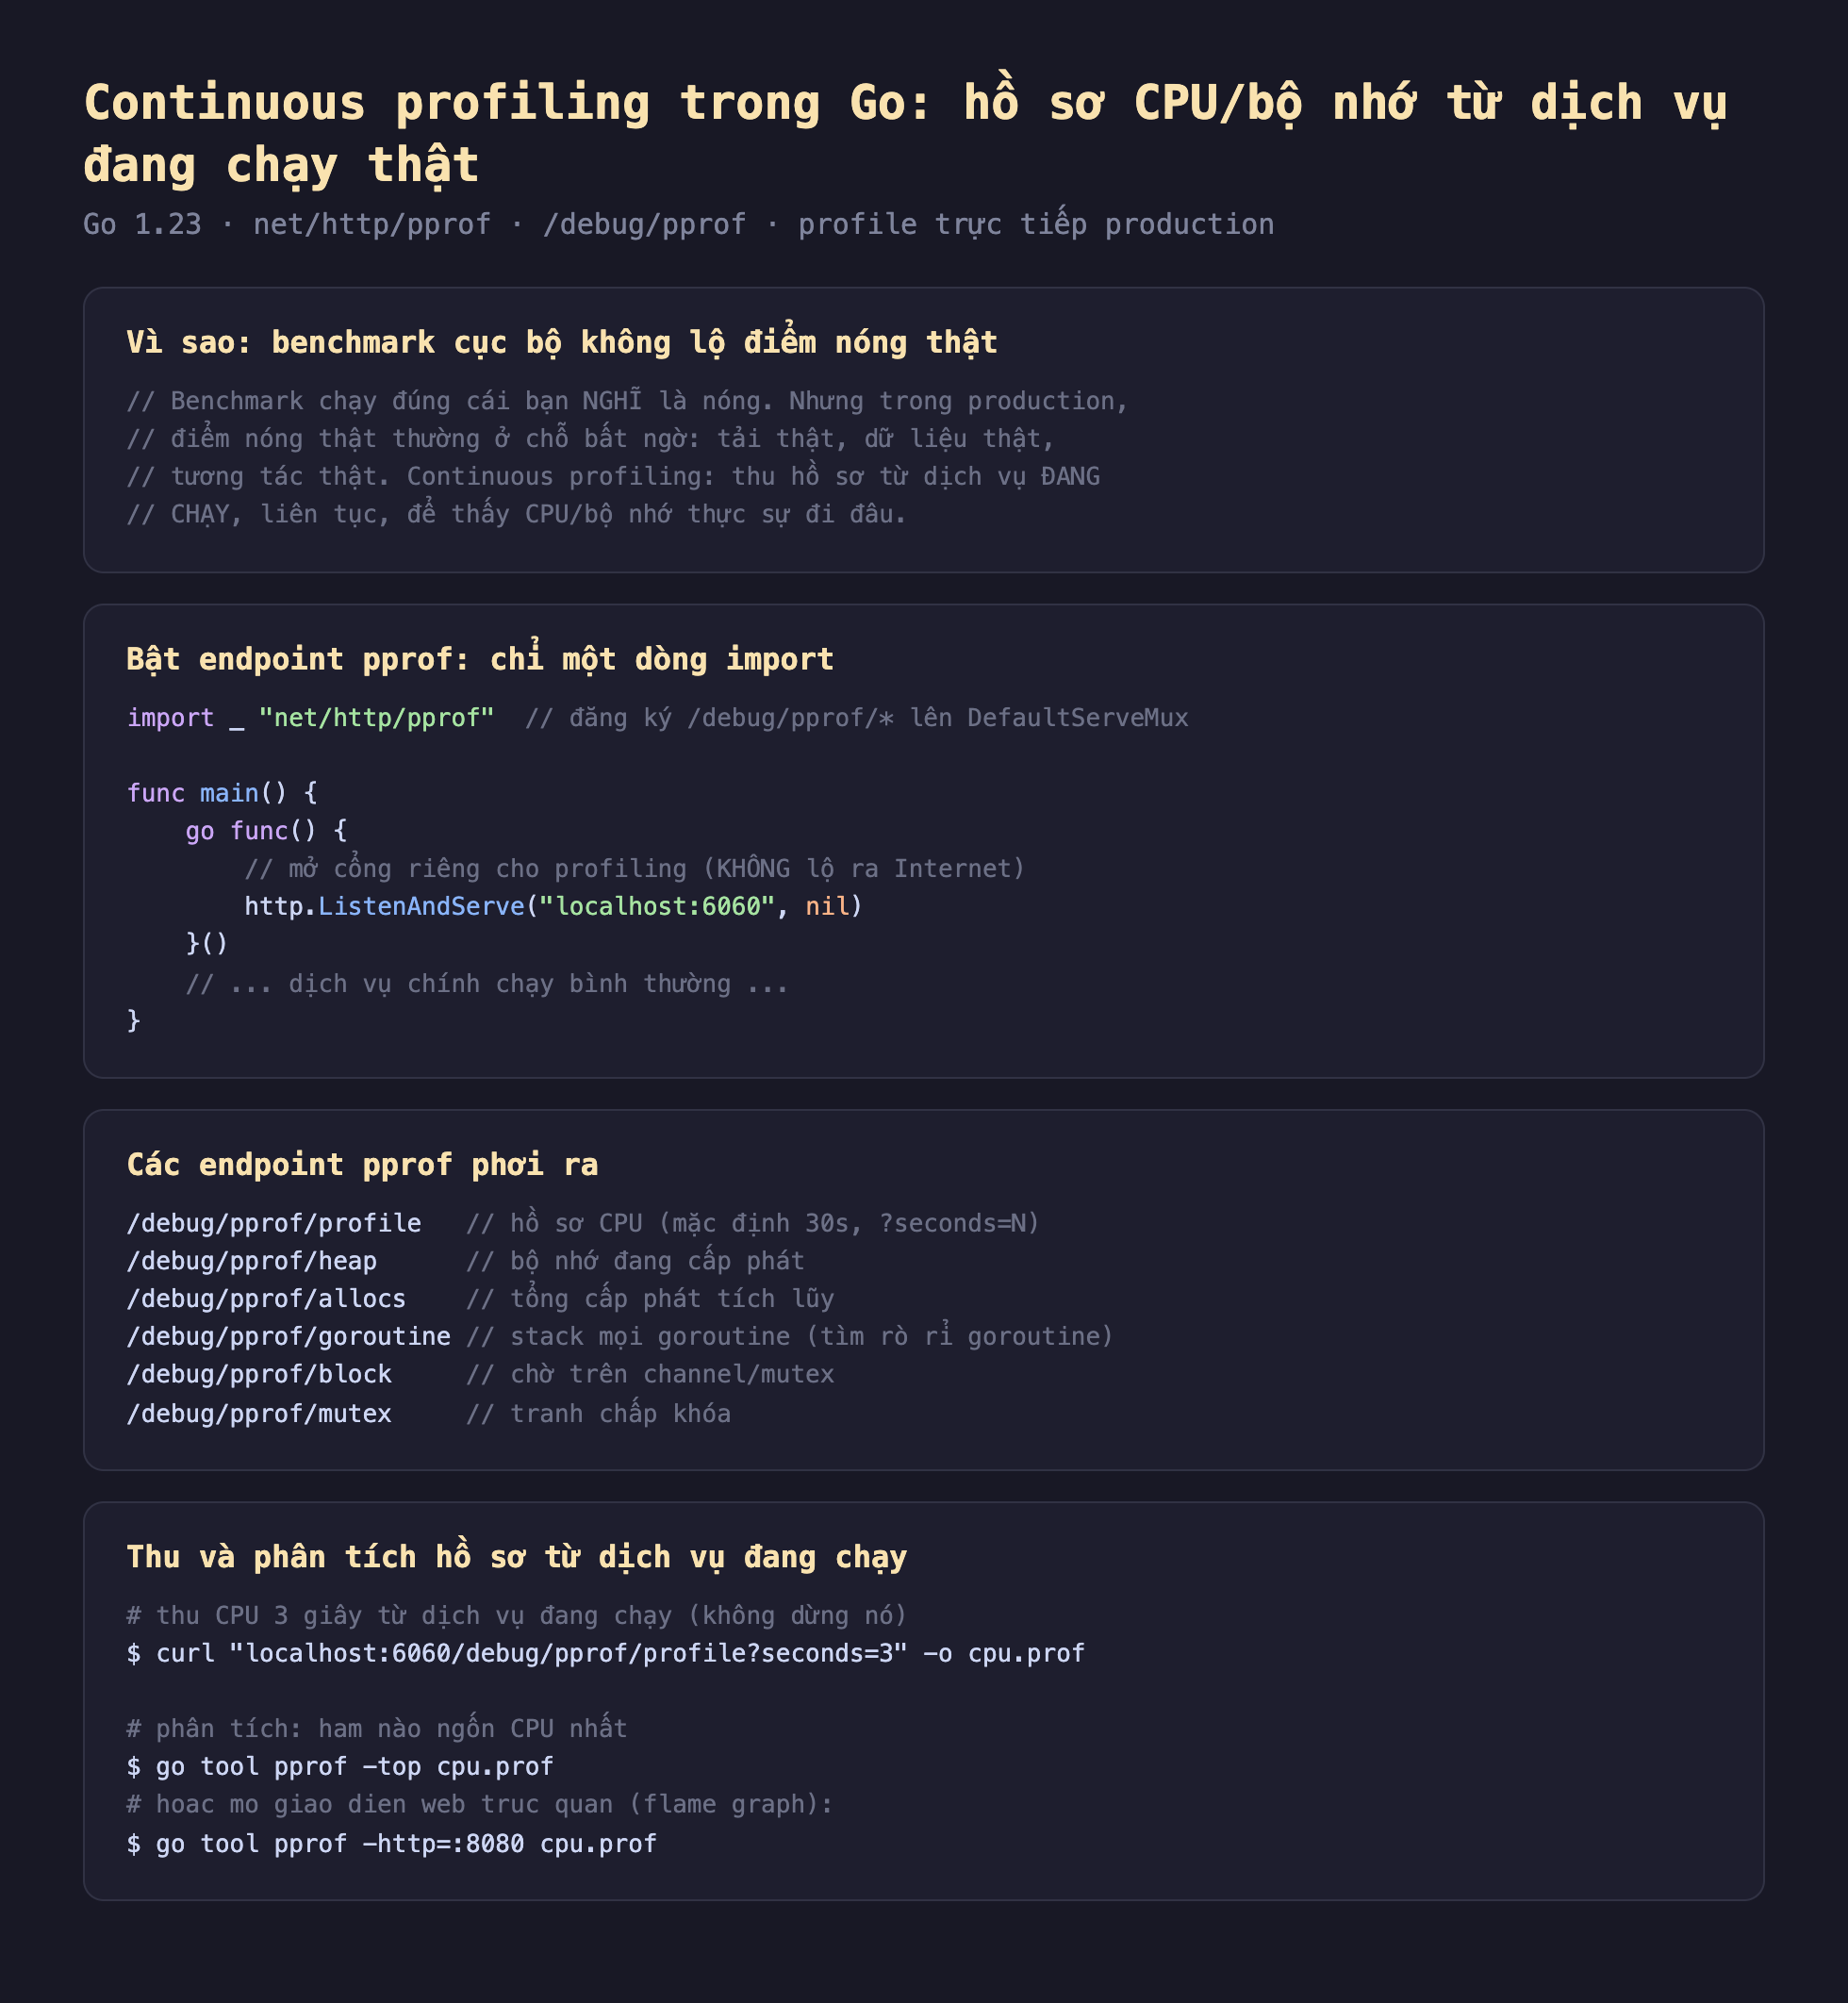
Hình 1: net/http/pprof phơi các endpoint /debug/pprof/ chỉ bằng một dòng import blank; thu profile từ dịch vụ đang chạy bằng curl (không dừng nó) rồi phân tích bằng go tool pprof (top hoặc flame graph web).*
Đo thật: thu CPU profile từ dịch vụ đang chạy
Chạy service (có một goroutine chạy hàm congViecNong tốn CPU liên tục), rồi thu CPU profile 3 giây từ nó khi đang chạy:
$ curl "localhost:6060/debug/pprof/profile?seconds=3" -o cpu.prof
-rw-r--r-- 455 cpu.prof   // thu về mà KHÔNG dừng dịch vụ
Điểm mấu chốt: profile được thu từ service đang chạy, không dừng nó — production tiếp tục phục vụ trong khi bạn lấy hồ sơ. Phân tích:
$ go tool pprof -top cpu.prof
Duration: 3.15s, Total samples = 2.99s (95.03%)
      flat  flat%   sum%        cum   cum%
   2.99s   100%   100%      2.99s   100%  main.congViecNong (inline)
      0     0%   100%      2.99s   100%  main.main.func2
pprof chỉ đúng: main.congViecNong ngốn 100% CPU (2.99s trên tổng 3.15s lấy mẫu). Đây là điểm nóng thật lộ ra từ dịch vụ đang chạy — nếu đây là production, bạn vừa tìm ra chính xác hàm cần tối ưu, không phải đoán. Heap profile thu tương tự (curl .../heap), cho biết bộ nhớ đang cấp phát ở đâu — tìm chỗ ngốn RAM hoặc rò rỉ.
go tool pprof còn có giao diện web (-http=:8080) vẽ flame graph trực quan — nhìn một cái là thấy hàm nào chiếm bao nhiêu, ai gọi ai — mạnh hơn nhiều so với danh sách text cho profile phức tạp.
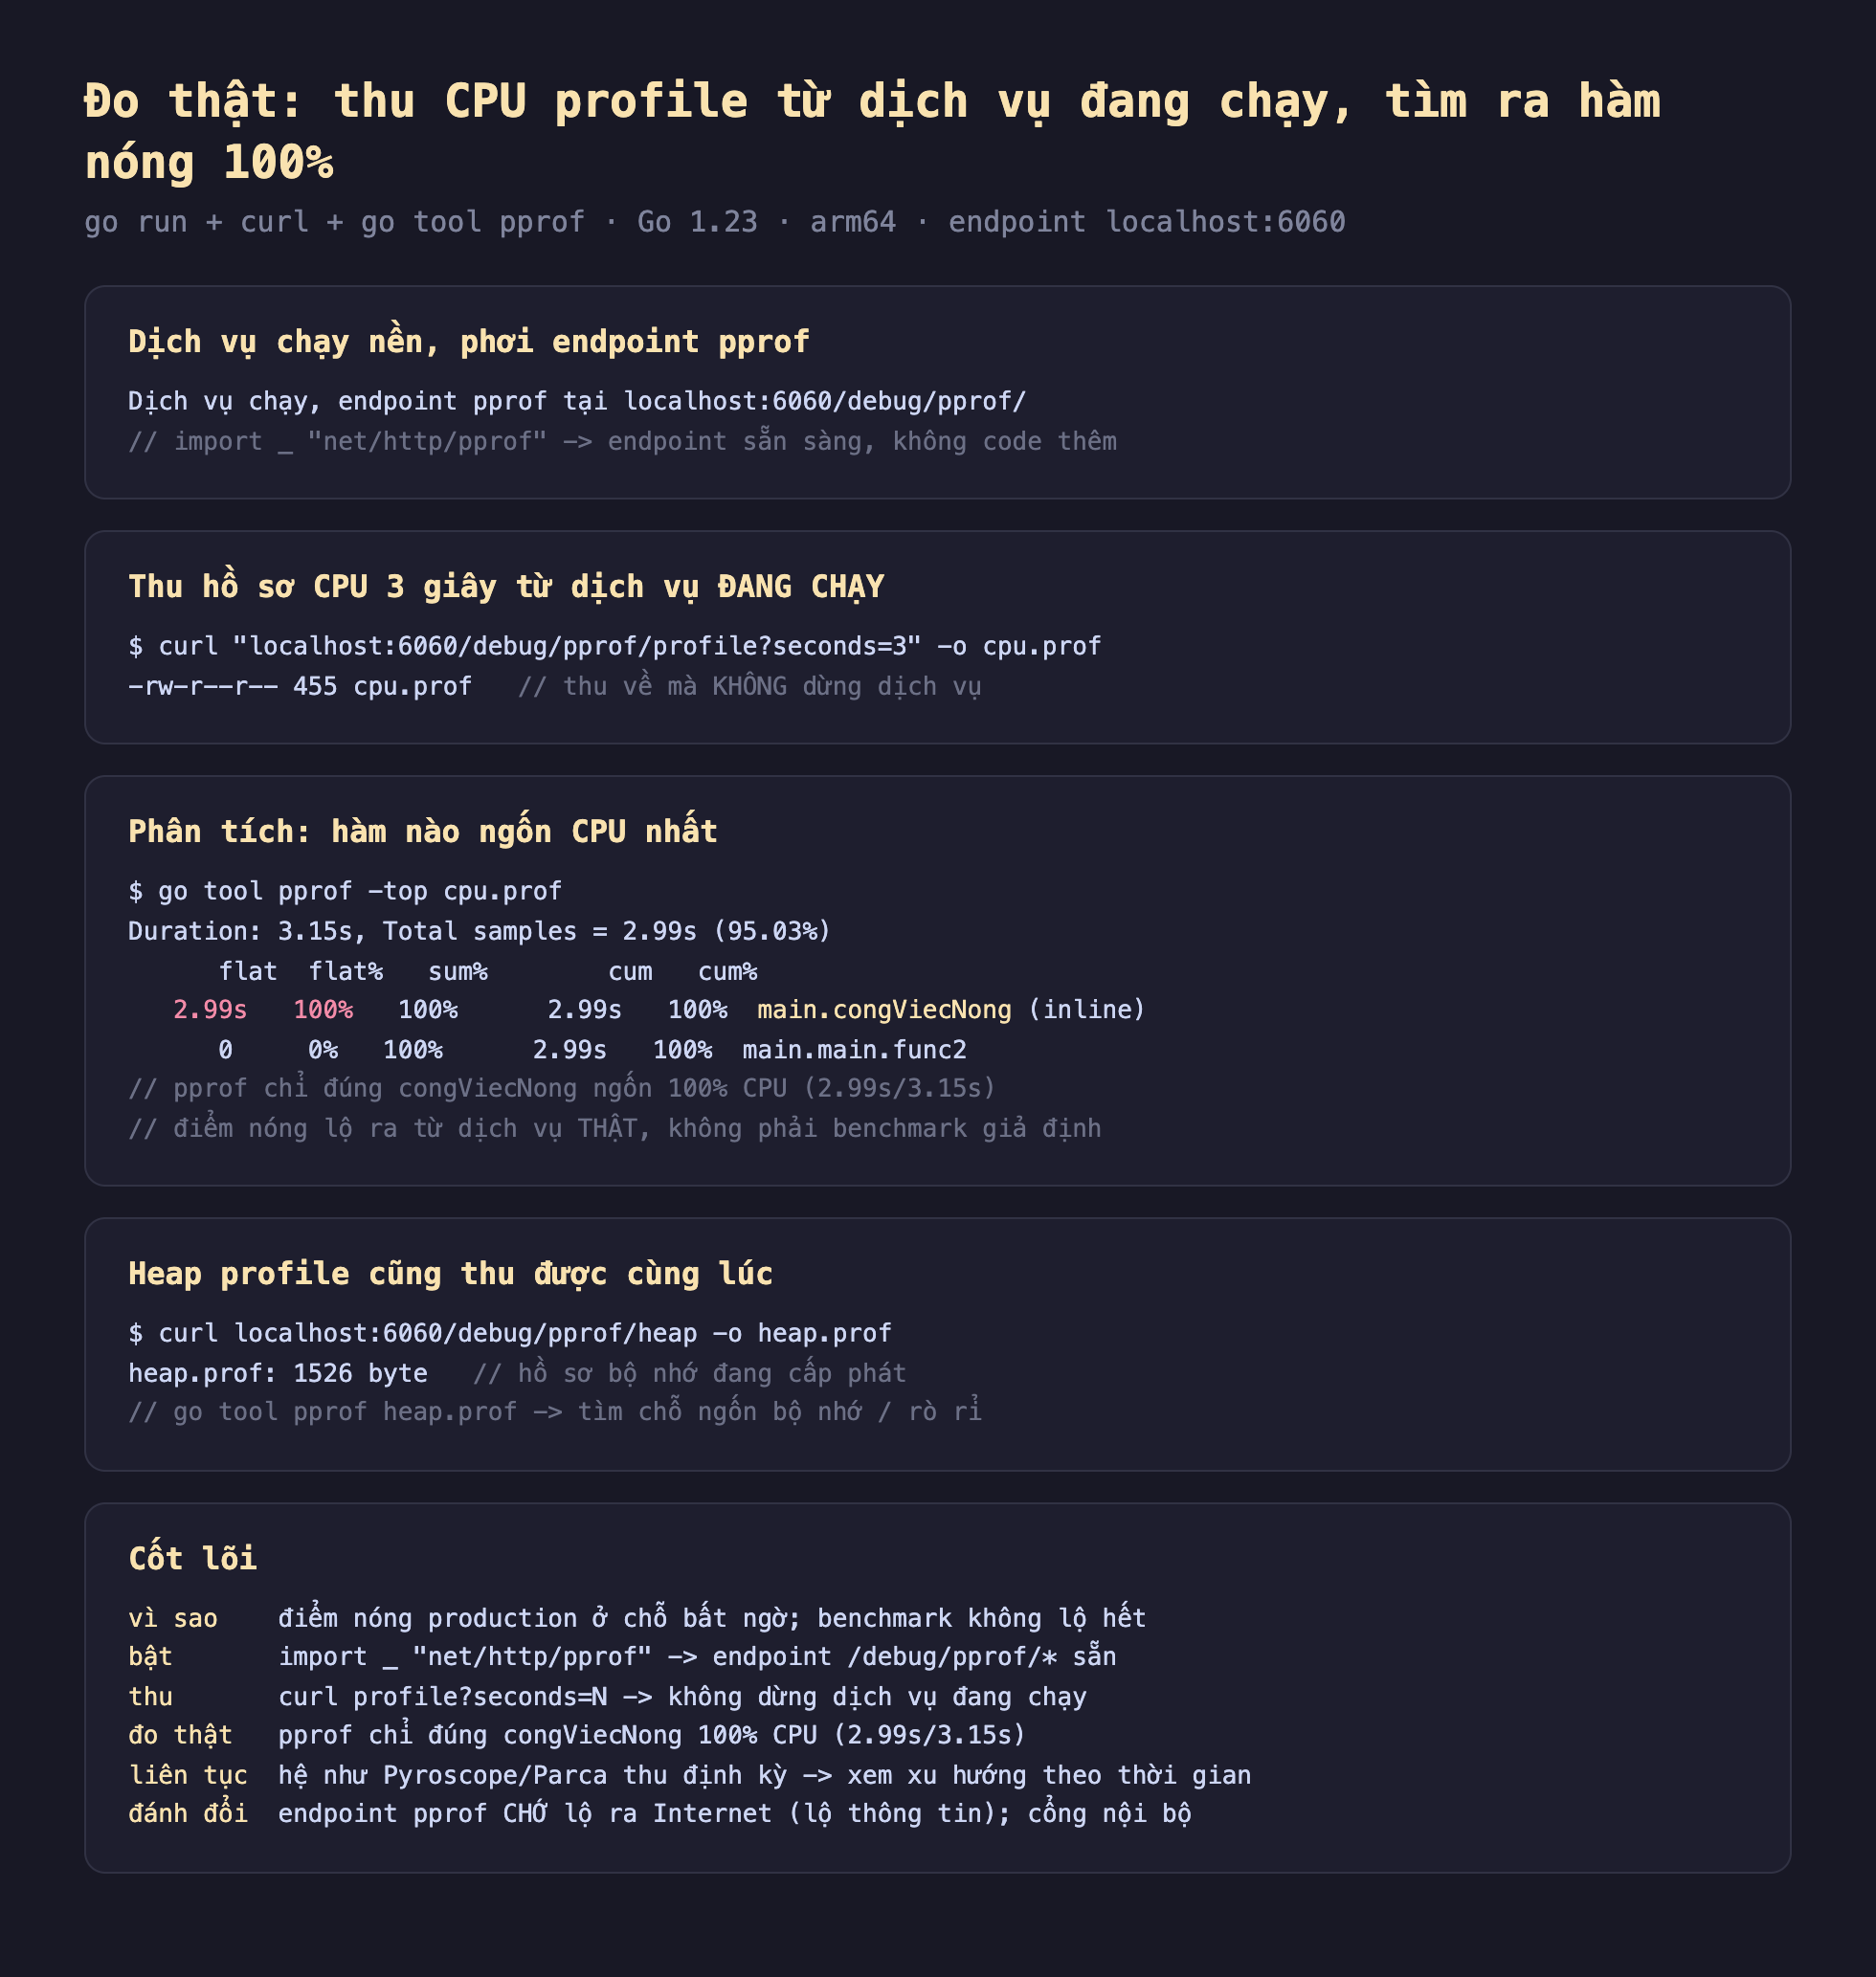
Hình 2: Đo thật — thu CPU profile 3 giây từ dịch vụ đang chạy (không dừng nó) qua endpoint pprof; go tool pprof -top chỉ đúng main.congViecNong ngốn 100% CPU (2.99s/3.15s); heap profile thu cùng lúc để tìm chỗ ngốn bộ nhớ.
Đánh đổi cần cân nhắc
Endpoint pprof TUYỆT ĐỐI không được lộ ra Internet. Đây là rủi ro bảo mật nghiêm trọng nhất. /debug/pprof/* phơi thông tin nội bộ (tên hàm, stack, cấu trúc code) và cho phép kích hoạt profiling tốn tài nguyên (một kẻ tấn công spam /profile làm tăng tải). Luôn bind vào localhost hoặc một cổng nội bộ chỉ truy cập được qua mạng riêng/VPN, không bao giờ để nó nghe trên cổng công khai. Nhiều sự cố lộ dữ liệu đến từ việc vô tình mount pprof lên cổng chính.
Thu profile có chi phí, dù nhỏ. CPU profiling lấy mẫu (mặc định 100 lần/giây) nên overhead thấp (~vài %), an toàn để chạy trên production. Nhưng block/mutex profiling cần bật rõ ràng (runtime.SetBlockProfileRate, SetMutexProfileFraction) và có chi phí cao hơn — chỉ bật khi cần điều tra, không để mặc định. Heap profile thì gần như miễn phí (Go luôn thu mẫu cấp phát). Hiểu chi phí từng loại để không tự làm chậm chính dịch vụ mình đo.
"Continuous" cần hạ tầng thu thập, không chỉ endpoint. Bài này thu một profile thủ công bằng curl. Continuous profiling thật nghĩa là một hệ thống (Pyroscope, Parca, Grafana Phlare, hoặc dịch vụ cloud như Google Cloud Profiler) tự động thu profile định kỳ từ mọi instance, lưu trữ, và cho bạn xem xu hướng theo thời gian — so profile hôm nay với tuần trước, tìm hồi quy hiệu năng sau một release. Endpoint pprof là nguồn dữ liệu; hệ continuous profiling là phần thu thập và trực quan hóa lịch sử. Với dịch vụ nhỏ, thu thủ công lúc cần đã đủ; quy mô lớn thì đáng đầu tư hệ liên tục.
Ba ý mang về
- Continuous profiling tìm điểm nóng thật mà benchmark không lộ: benchmark đo cái bạn nghĩ là nóng, còn profiling từ dịch vụ đang chạy cho thấy CPU/bộ nhớ thực sự đi đâu dưới tải và dữ liệu thật — đo thật, thu CPU profile 3 giây từ service live và pprof chỉ đúng hàm nóng 100% CPU.
- net/http/pprof bật bằng một dòng import:
import _ "net/http/pprof"phơi các endpoint (profile, heap, goroutine, block, mutex...), thu bằngcurl .../profile?seconds=Nkhông dừng dịch vụ, phân tích bằnggo tool pprof(top hoặc flame graph web). - Nêu rõ rủi ro và giới hạn: endpoint pprof TUYỆT ĐỐI không lộ ra Internet (bind localhost/cổng nội bộ), profiling có chi phí (CPU/heap rẻ, block/mutex đắt phải bật rõ ràng), và "continuous" thật cần hạ tầng thu thập (Pyroscope/Parca...) để xem xu hướng theo thời gian, không chỉ endpoint.
Bài tập làm thử
Bài 1 (đọc hiểu code Go). Giải thích tác dụng của dòng import sau, và vì sao nó đủ để "kích hoạt" profiling mà không cần viết thêm handler nào:
import _ "net/http/pprof"
Đáp án
Đây là một import blank (dùng _ làm tên), nghĩa là package net/http/pprof được nạp chỉ để chạy hàm init() của nó, không dùng trực tiếp identifier nào từ package. Hàm init() này tự đăng ký các handler /debug/pprof/* lên http.DefaultServeMux, nên chỉ cần import và chạy một HTTP server dùng DefaultServeMux (như http.ListenAndServe("localhost:6060", nil)) là các endpoint đã sẵn sàng phục vụ, không cần code thêm route nào.
Bài 2 (đọc hiểu). Bài đo thật cho: go tool pprof -top cpu.prof báo main.congViecNong chiếm 100% CPU (2.99s/3.15s lấy mẫu). Việc thu profile này có làm gián đoạn dịch vụ đang chạy không? Giải thích dựa trên cách lệnh curl được gọi.
Đáp án
Không làm gián đoạn dịch vụ. Lệnh curl "localhost:6060/debug/pprof/profile?seconds=3" -o cpu.prof chỉ yêu cầu server lấy mẫu CPU trong 3 giây rồi trả file profile về — dịch vụ chính vẫn tiếp tục phục vụ request bình thường trong lúc đó. Đây chính là ưu điểm cốt lõi của continuous profiling: thu hồ sơ từ dịch vụ đang chạy mà không cần dừng nó.
Bài 3 (sửa lỗi / bẫy bảo mật). Một kỹ sư cấu hình endpoint pprof như sau để dễ truy cập từ xa khi cần debug production:
go func() {
	http.ListenAndServe(":6060", nil) // lắng nghe trên mọi interface
}()
Chỉ ra vấn đề nghiêm trọng trong cấu hình này và cách sửa.
Đáp án
Vấn đề: :6060 (không chỉ định địa chỉ) lắng nghe trên mọi interface, có nguy cơ lộ endpoint /debug/pprof/* ra Internet nếu server có địa chỉ IP công khai và không có tường lửa chặn — đây là rủi ro bảo mật nghiêm trọng vì nó phơi thông tin nội bộ (tên hàm, stack, cấu trúc code) và cho phép kẻ tấn công kích hoạt profiling tốn tài nguyên (spam /profile). Sửa: bind vào localhost (http.ListenAndServe("localhost:6060", nil)) hoặc một cổng chỉ truy cập được qua mạng nội bộ/VPN, không bao giờ để nó nghe trên cổng công khai.
Bài 4 (vận dụng thực tế). Bạn nghi ngờ dịch vụ đang bị rò rỉ goroutine (số goroutine tăng mãi không giảm). Trong các endpoint /debug/pprof/profile, /debug/pprof/heap, /debug/pprof/goroutine, /debug/pprof/block, bạn nên thu endpoint nào trước tiên, và vì sao?
Đáp án
Nên thu /debug/pprof/goroutine trước — endpoint này cho stack của mọi goroutine đang sống, phù hợp nhất để tìm rò rỉ goroutine (goroutine kẹt mãi không thoát khiến số lượng tăng liên tục). /profile đo CPU, /heap đo bộ nhớ đang cấp phát, /block đo chờ trên channel/mutex — đều là góc nhìn khác, không trực tiếp cho thấy số goroutine tăng ở đâu.
Bài 5 (đánh đổi). Vì sao bài viết nói block/mutex profiling "có chi phí cao hơn và chỉ nên bật khi cần điều tra", khác với CPU và heap profiling? Nêu cách bật chúng.
Đáp án
CPU profiling lấy mẫu (mặc định 100 lần/giây) nên overhead thấp (~vài %), an toàn chạy liên tục trên production; heap profile gần như miễn phí vì Go luôn thu mẫu cấp phát sẵn. Ngược lại, block/mutex profiling cần được bật rõ ràng bằng runtime.SetBlockProfileRate và runtime.SetMutexProfileFraction, và việc theo dõi mọi lần chờ/tranh chấp khóa có chi phí cao hơn đáng kể — nên chỉ bật tạm thời khi đang điều tra một vấn đề cụ thể về đồng thời, không để mặc định bật liên tục trên production.
Phần sau ta chuyển sang gỡ lỗi sâu: gỡ lỗi từ xa với Delve trong Go — gắn debugger vào tiến trình đang chạy (kể cả trong container), đặt breakpoint, xem biến, để soi lỗi mà log không lộ.
