Phần trước ta nói về ba trụ cột quan sát; metric là trụ cột rẻ nhất và được dùng nhiều nhất. Nhưng ngay khi bắt tay instrument một service, câu hỏi đầu tiên đập vào mặt: dùng counter, gauge, histogram hay summary? Bốn cái tên này nghe na ná, tài liệu thì định nghĩa trừu tượng, và chọn sai loại không báo lỗi — nó chỉ âm thầm cho bạn một con số vô nghĩa khi bạn cần nó nhất, lúc sự cố đang xảy ra. Bài này (phần 2 loạt Observability) instrument một Go app với cả bốn loại, bắn request thật vào, rồi đọc thẳng output /metrics để thấy mỗi loại hành xử ra sao.
Mỗi loại trả lời một câu hỏi khác nhau
Khác biệt cốt lõi không nằm ở cú pháp mà ở câu hỏi mỗi loại trả lời được:
- Counter — một con số chỉ tăng (hoặc reset về 0 khi process khởi động lại). Dùng cho những thứ tích luỹ: tổng request, tổng lỗi, tổng byte gửi đi. Bạn gần như không bao giờ đọc giá trị thô của counter; bạn đọc tốc độ tăng của nó bằng
rate(). - Gauge — một con số lên xuống tự do, phản ánh trạng thái tức thời. Dùng cho: số kết nối đang mở, dung lượng RAM đang dùng, độ dài hàng đợi, nhiệt độ. Giá trị thô có nghĩa — "ngay lúc này có 51 kết nối".
- Histogram — ghi lại phân bố của các quan sát (thường là độ trễ) bằng cách đếm chúng rơi vào các bucket định sẵn. Quantile (p90, p99) được tính phía server từ các bucket, nên gộp được số liệu từ nhiều instance.
- Summary — cũng đo phân bố, nhưng tự tính sẵn quantile phía client (trong chính process app). Nhẹ cho server nhưng không gộp được quantile giữa các instance.
// Counter: chỉ tăng
var reqTotal = promauto.NewCounter(prometheus.CounterOpts{
    Name: "demo_requests_total"})
// Gauge: lên xuống
var active = promauto.NewGauge(prometheus.GaugeOpts{
    Name: "demo_active_connections"})
// Histogram: chia bucket, quantile tính phía server
var hist = promauto.NewHistogram(prometheus.HistogramOpts{
    Name: "demo_latency_seconds",
    Buckets: []float64{0.005, 0.01, 0.025, 0.05, 0.1, 0.25}})
// Summary: quantile tính phía client
var summ = promauto.NewSummary(prometheus.SummaryOpts{
    Name: "demo_latency_summary_seconds",
    Objectives: map[float64]float64{0.5: 0.05, 0.9: 0.01, 0.99: 0.001}})
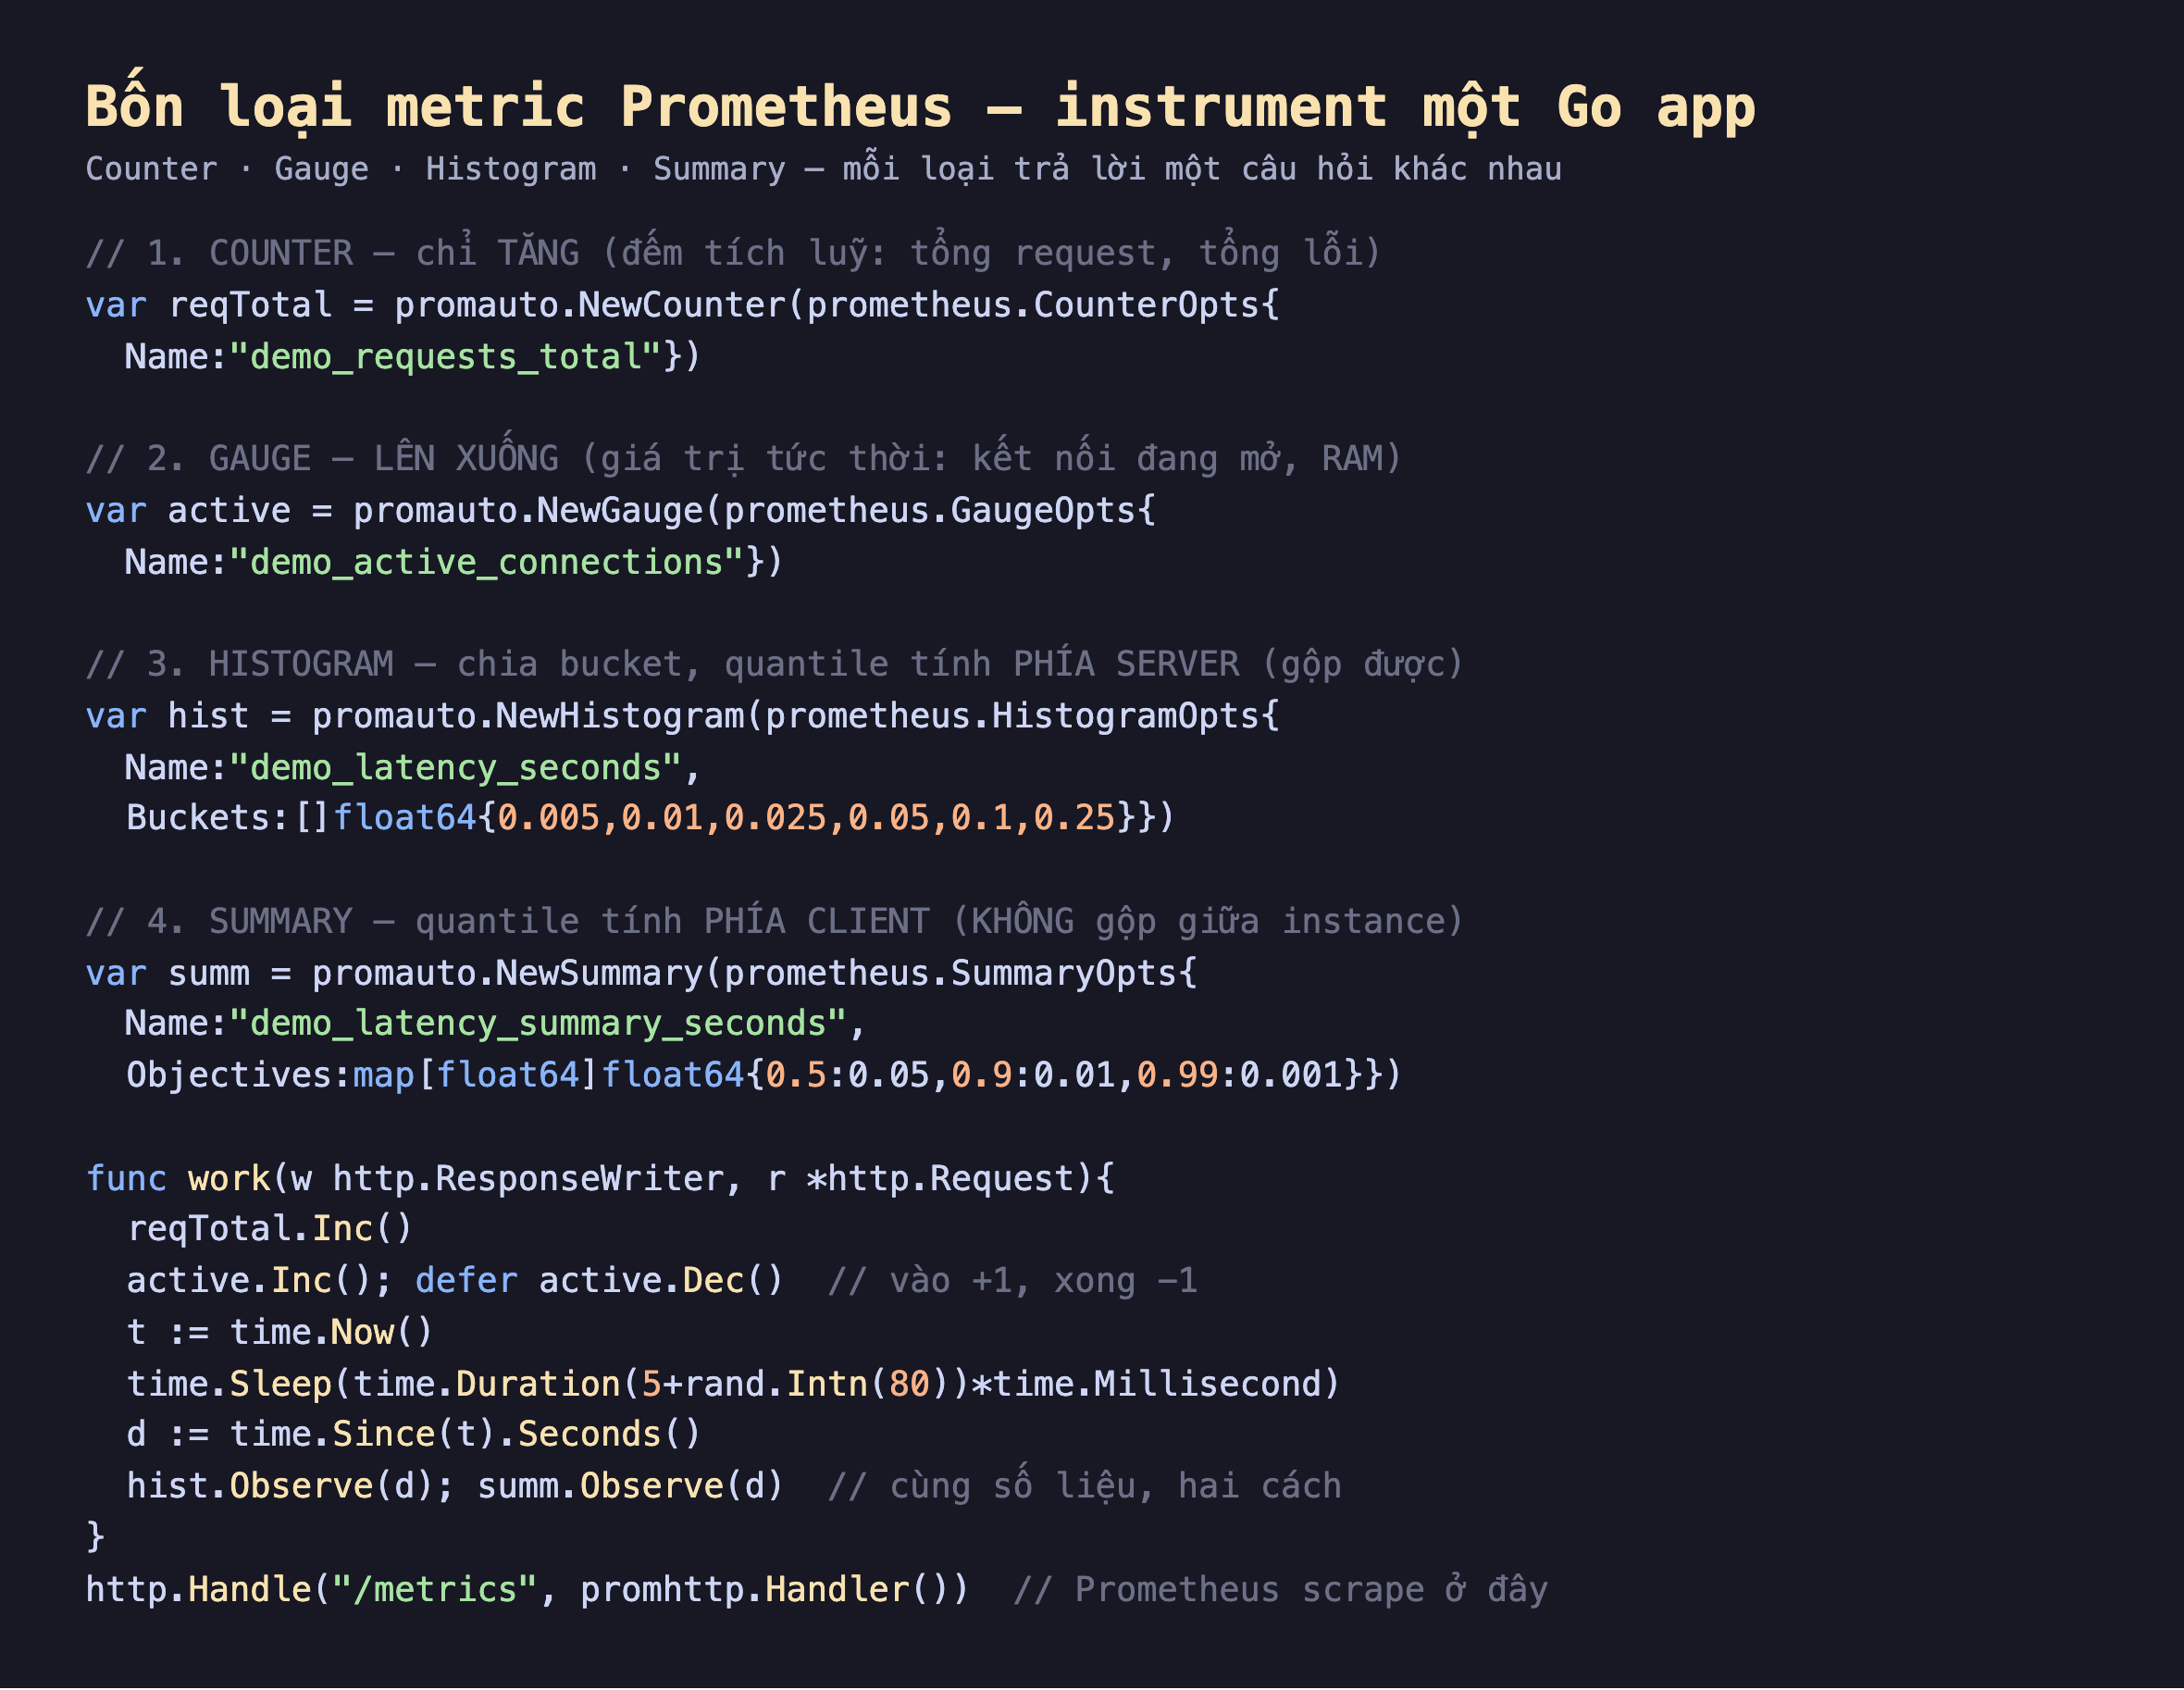
Hình 1: Instrument một Go app với cả bốn loại metric. Trong hàm work, counter Inc() mỗi request, gauge Inc() lúc vào và defer Dec() lúc ra, còn histogram và summary cùng Observe() một giá trị độ trễ để so sánh trực tiếp hai cách đo phân bố.
Điểm then chốt ở hàm xử lý: active.Inc() rồi defer active.Dec() — gauge tăng khi request vào, giảm khi nó xong, nên giá trị gauge luôn bằng số request đang chạy. Còn hist.Observe(d) và summ.Observe(d) nhận cùng một giá trị độ trễ d, để ta so sánh thẳng histogram với summary trên cùng dữ liệu.
Đo thật: 150 request, rồi đọc output /metrics
Mình chạy app trong container go-lab (go1.23, pin client_golang@v1.19.1), bắn 150 request tuần tự vào /work, thêm một đợt 60 request song song để bắt đỉnh gauge, rồi curl localhost:2112/metrics:
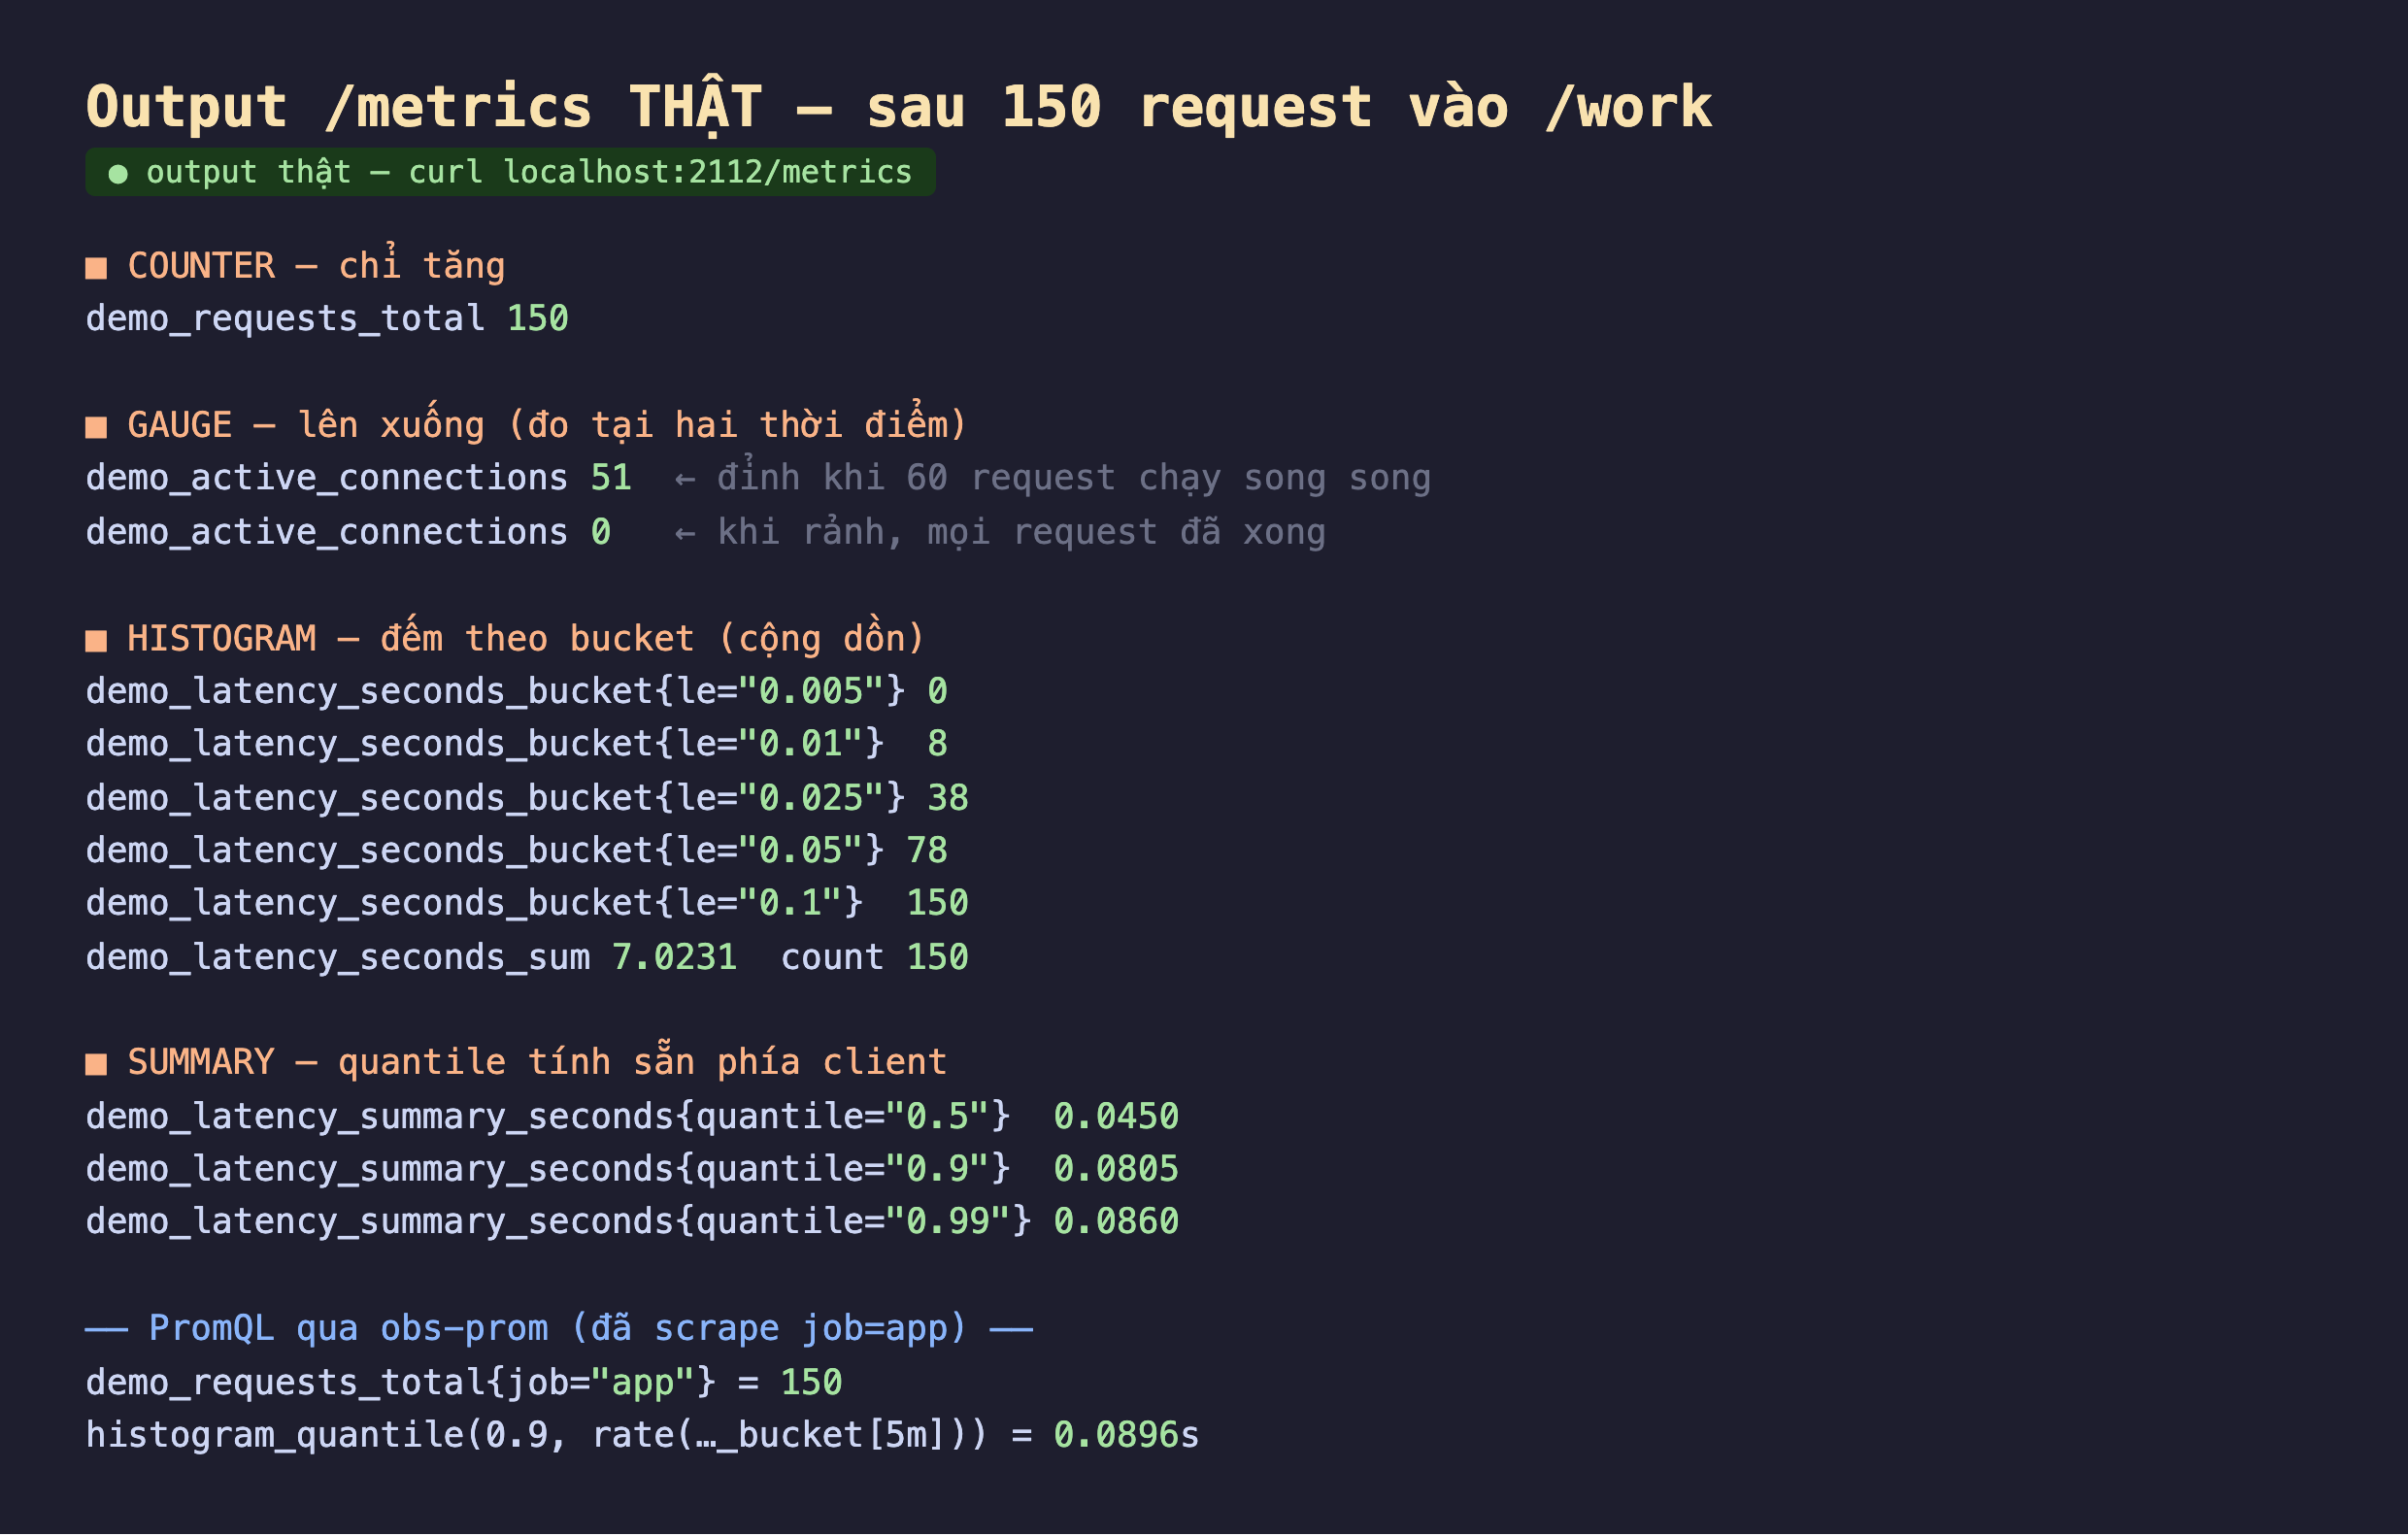
Hình 2: Output /metrics thật sau 150 request. Counter dừng đúng ở 150; gauge đo được 51 lúc 60 request chạy song song rồi về 0 khi rảnh; histogram cho các bucket cộng dồn (0/8/38/78/150) với sum 7.0231s; summary tự tính p50=0.045, p90=0.0805, p99=0.086. PromQL qua obs-prom xác nhận con số sau khi scrape.
Đọc từng loại từ output thật:
- Counter
demo_requests_total 150— đúng bằng số request đã bắn. Nó chỉ tăng; nếu restart app, nó về 0 vàrate()xử lý được cú nhảy đó. - Gauge đo được 51 ngay lúc 60 request chạy song song (không phải 60 vì một số đã kịp xong trong lúc mình lấy mẫu), và 0 khi mọi request đã xong. Cùng một metric, hai thời điểm, hai giá trị — đó chính là bản chất "lên xuống" của gauge.
- Histogram cho các bucket cộng dồn:
le="0.01"có 8 quan sát,le="0.025"có 38,le="0.05"có 78,le="0.1"có đủ 150. "Cộng dồn" nghĩa là bucketle="0.05"=78 đã bao gồm 38 củale="0.025"— mọi quan sát ≤0.05s. Kèm_sum=7.0231(tổng mọi độ trễ) và_count=150. Từ các bucket này, server tính được p90:histogram_quantile(0.9, rate(...[5m]))ra 0.0896s. - Summary tự cho quantile sẵn: p50=0.045, p90=0.0805, p99=0.086 — không cần server tính. Nhưng ba con số này chỉ đúng cho riêng instance này.
Vì sao phân biệt histogram với summary là quan trọng nhất
Counter và gauge dễ chọn. Cái bẫy thật nằm ở histogram vs summary, vì cả hai đều đo độ trễ và output nhìn tương tự. Khác biệt quyết định nằm ở chỗ quantile được tính ở đâu:
- Histogram gửi các bucket thô lên server. Server cộng bucket từ 10 instance lại rồi mới tính p99 — ra p99 toàn hệ thống. Bù lại, độ chính xác phụ thuộc bạn chọn bucket có khớp vùng giá trị thật không.
- Summary tính p99 ngay trong từng instance rồi gửi con số đã tính. Chính xác cho instance đó, nhưng không có phép toán nào cộng được p99 của 10 instance thành p99 toàn cục — trung bình của các p99 không phải là p99 thật. Với service chạy nhiều bản (gần như mọi service production), đây là lý do mặc định nên chọn histogram.
Nói ngắn: nếu service của bạn chạy nhiều hơn một instance và bạn muốn p99 toàn hệ thống — dùng histogram. Summary chỉ hợp khi bạn thật sự cần quantile chính xác của một process đơn lẻ và không cần gộp.
Đánh đổi cần cân nhắc
Chọn bucket histogram sai thì số liệu thành vô dụng. Nếu mọi request của bạn rơi vào khoảng 5–100ms mà bucket cao nhất là le="0.25", thì mọi thứ đổ dồn vào vài bucket cuối và histogram_quantile nội suy rất thô — p99 ra sai lệch lớn. Bucket phải phủ đúng vùng độ trễ thực tế của service; không có bộ bucket "đúng cho mọi app". Go runtime 1.17+ có native histogram giảm bớt nỗi đau này, nhưng với histogram cổ điển thì chọn bucket là việc phải làm cẩn thận.
Cardinality là kẻ giết chết Prometheus. Mỗi tổ hợp label tạo một chuỗi thời gian riêng. Một histogram với 10 bucket, nhân với label path có 1000 giá trị, nhân với label status có 5 giá trị = 50.000 chuỗi chỉ từ một metric. Đừng bao giờ đặt những thứ vô hạn (user id, request id, full URL) làm label — đó là chủ đề riêng của một bài sau, nhưng hãy cảnh giác ngay từ lúc đặt tên metric.
Gauge có thể lỡ nhịp nếu quên defer. Mẫu Inc() + defer Dec() an toàn vì defer chạy cả khi handler panic. Nếu bạn Dec() thủ công ở cuối hàm mà giữa chừng có return sớm hoặc panic, gauge sẽ rò rỉ — tăng mãi không giảm, và bạn tưởng có kết nối treo trong khi không hề. Luôn dùng defer.
Ba ý mang về
- Bốn loại trả lời bốn câu hỏi: counter cho cái tích luỹ (đo thật dừng ở 150, đọc bằng
rate), gauge cho trạng thái tức thời (đo thật 51 lúc tải, 0 lúc rảnh), histogram/summary cho phân bố độ trễ. - Histogram là lựa chọn mặc định cho độ trễ: nó gửi bucket thô để server gộp quantile từ nhiều instance (đo thật p90=0.0896s qua PromQL); summary tính quantile phía client nên chính xác cho một process nhưng không gộp được — chỉ dùng khi thật sự cần.
- Chọn sai không báo lỗi, chỉ cho số vô nghĩa: bucket lệch vùng giá trị làm p99 sai, label cardinality cao làm sập Prometheus, quên
defer Dec()làm gauge rò rỉ — ba cái bẫy phải tránh ngay từ lúc instrument.
Nguồn
- Prometheus docs — Metric types: https://prometheus.io/docs/concepts/metric_types/
- Prometheus docs — Histograms and summaries: https://prometheus.io/docs/practices/histograms/
- client_golang — godoc: https://pkg.go.dev/github.com/prometheus/client_golang/prometheus
Phần sau ta học PromQL cho ra hồn: không chỉ rate() mà cách ghép các toán tử để biến đống chuỗi thời gian thô thành câu trả lời cho câu hỏi "service có khoẻ không", chạy thật trên chính bộ metric vừa dựng.
