Phần trước ta đã instrument một app với bốn loại metric. Nhưng khi mở /metrics ra, bạn thấy http_requests_total 1055 và... rồi sao? Con số cộng dồn đó gần như vô nghĩa khi đọc trực tiếp — nó chỉ cho biết tổng từ lúc app khởi động, không cho biết bây giờ service đang nhận bao nhiêu request, endpoint nào nóng, hay tỉ lệ lỗi là bao nhiêu. Toàn bộ giá trị của metric được mở khoá bởi PromQL — ngôn ngữ truy vấn biến đống chuỗi thời gian thô thành câu trả lời. Bài này (phần 3 loạt Observability) dựng một app có counter gắn nhãn, bắn tải đều, rồi chạy các query PromQL thật trên obs-prom để thấy chính xác mỗi hàm làm gì.
Nhãn, và vì sao counter thô vô dụng
Metric của Prometheus hiếm khi là một con số đơn — nó gắn nhãn (label) để tách chiều. Một CounterVec với nhãn path và status tạo một chuỗi thời gian riêng cho mỗi tổ hợp:
var reqs = promauto.NewCounterVec(
    prometheus.CounterOpts{Name: "http_requests_total"},
    []string{"path", "status"})

// mỗi tổ hợp nhãn là một chuỗi độc lập
reqs.WithLabelValues("/api/users", "200").Inc()
reqs.WithLabelValues("/api/login", "500").Inc()
Counter chỉ tăng. Đọc giá trị thô (1055) cho bạn tổng tích luỹ từ lúc process chạy — một con số phụ thuộc uptime, không so sánh được giữa các instance, không phản ánh tải hiện tại. Điều bạn thật sự muốn biết là tốc độ: nó tăng bao nhanh mỗi giây. Đó là việc của rate().
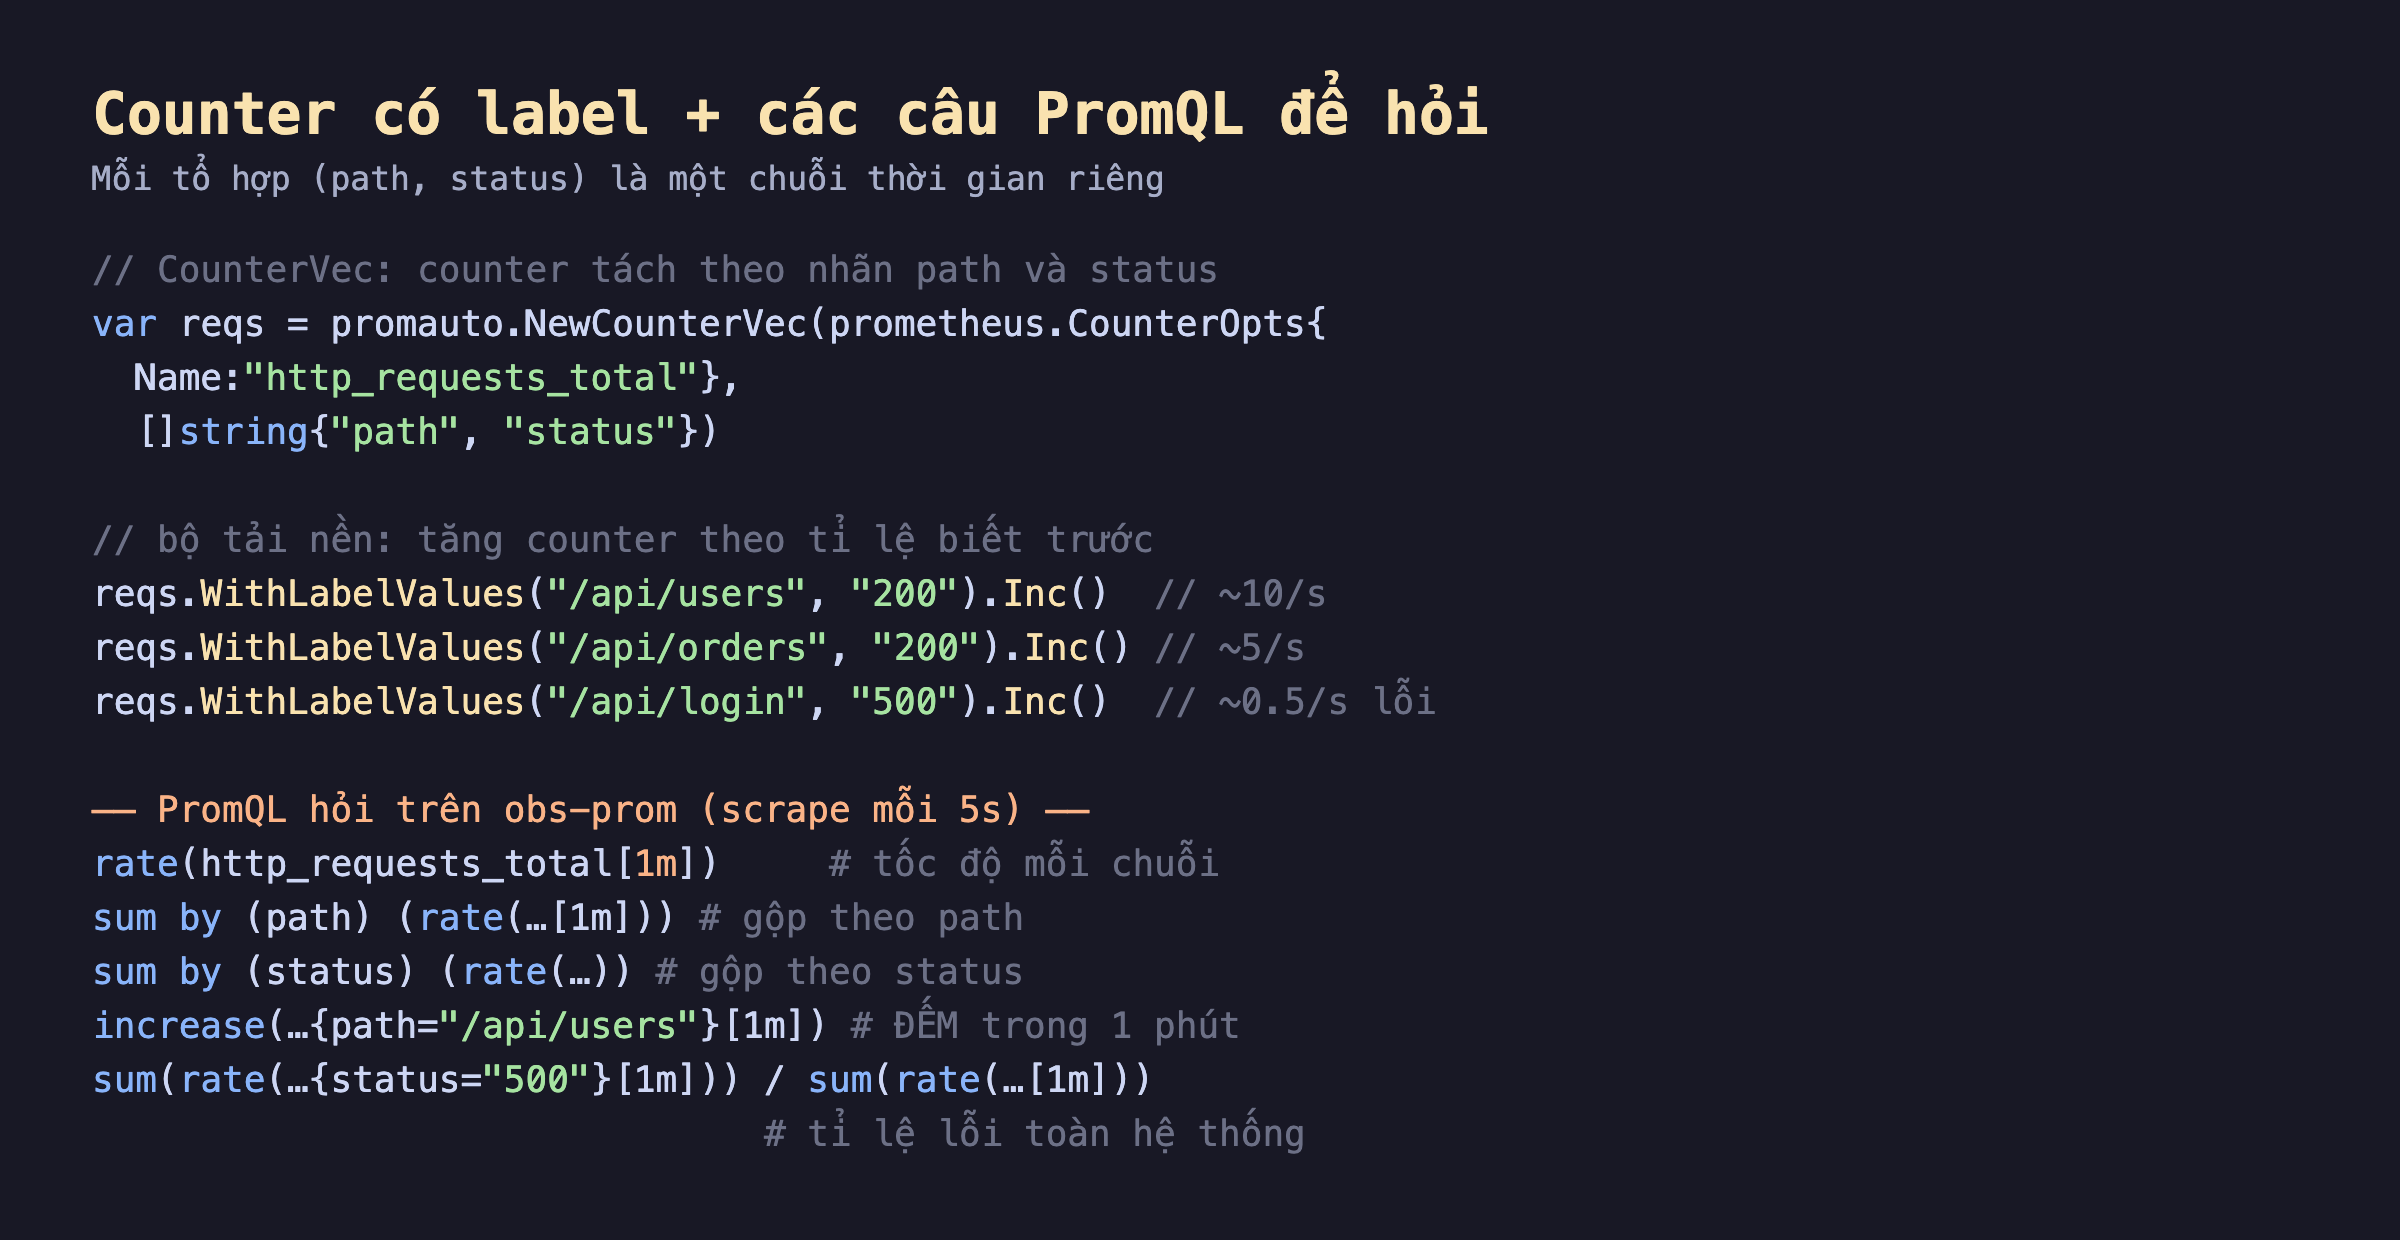
Hình 1: Counter http_requests_total gắn nhãn path và status; bộ tải nền tăng nó theo tỉ lệ biết trước để output PromQL dễ kiểm chứng; bên dưới là các câu PromQL ta sẽ chạy — rate, sum by, increase và một biểu thức tính tỉ lệ lỗi.
Đo thật: chạy query trên obs-prom
Mình chạy app trong go-lab, để obs-prom scrape mỗi 5 giây. Bộ tải nền tăng counter theo tỉ lệ cố định: /api/users 10/s, /api/orders 5/s, /api/login 2/s, cộng ít request lỗi (status="500"). Sau khi app chạy đủ một phút (để cửa sổ [1m] có dữ liệu), mình gọi /api/v1/query trên obs-prom:
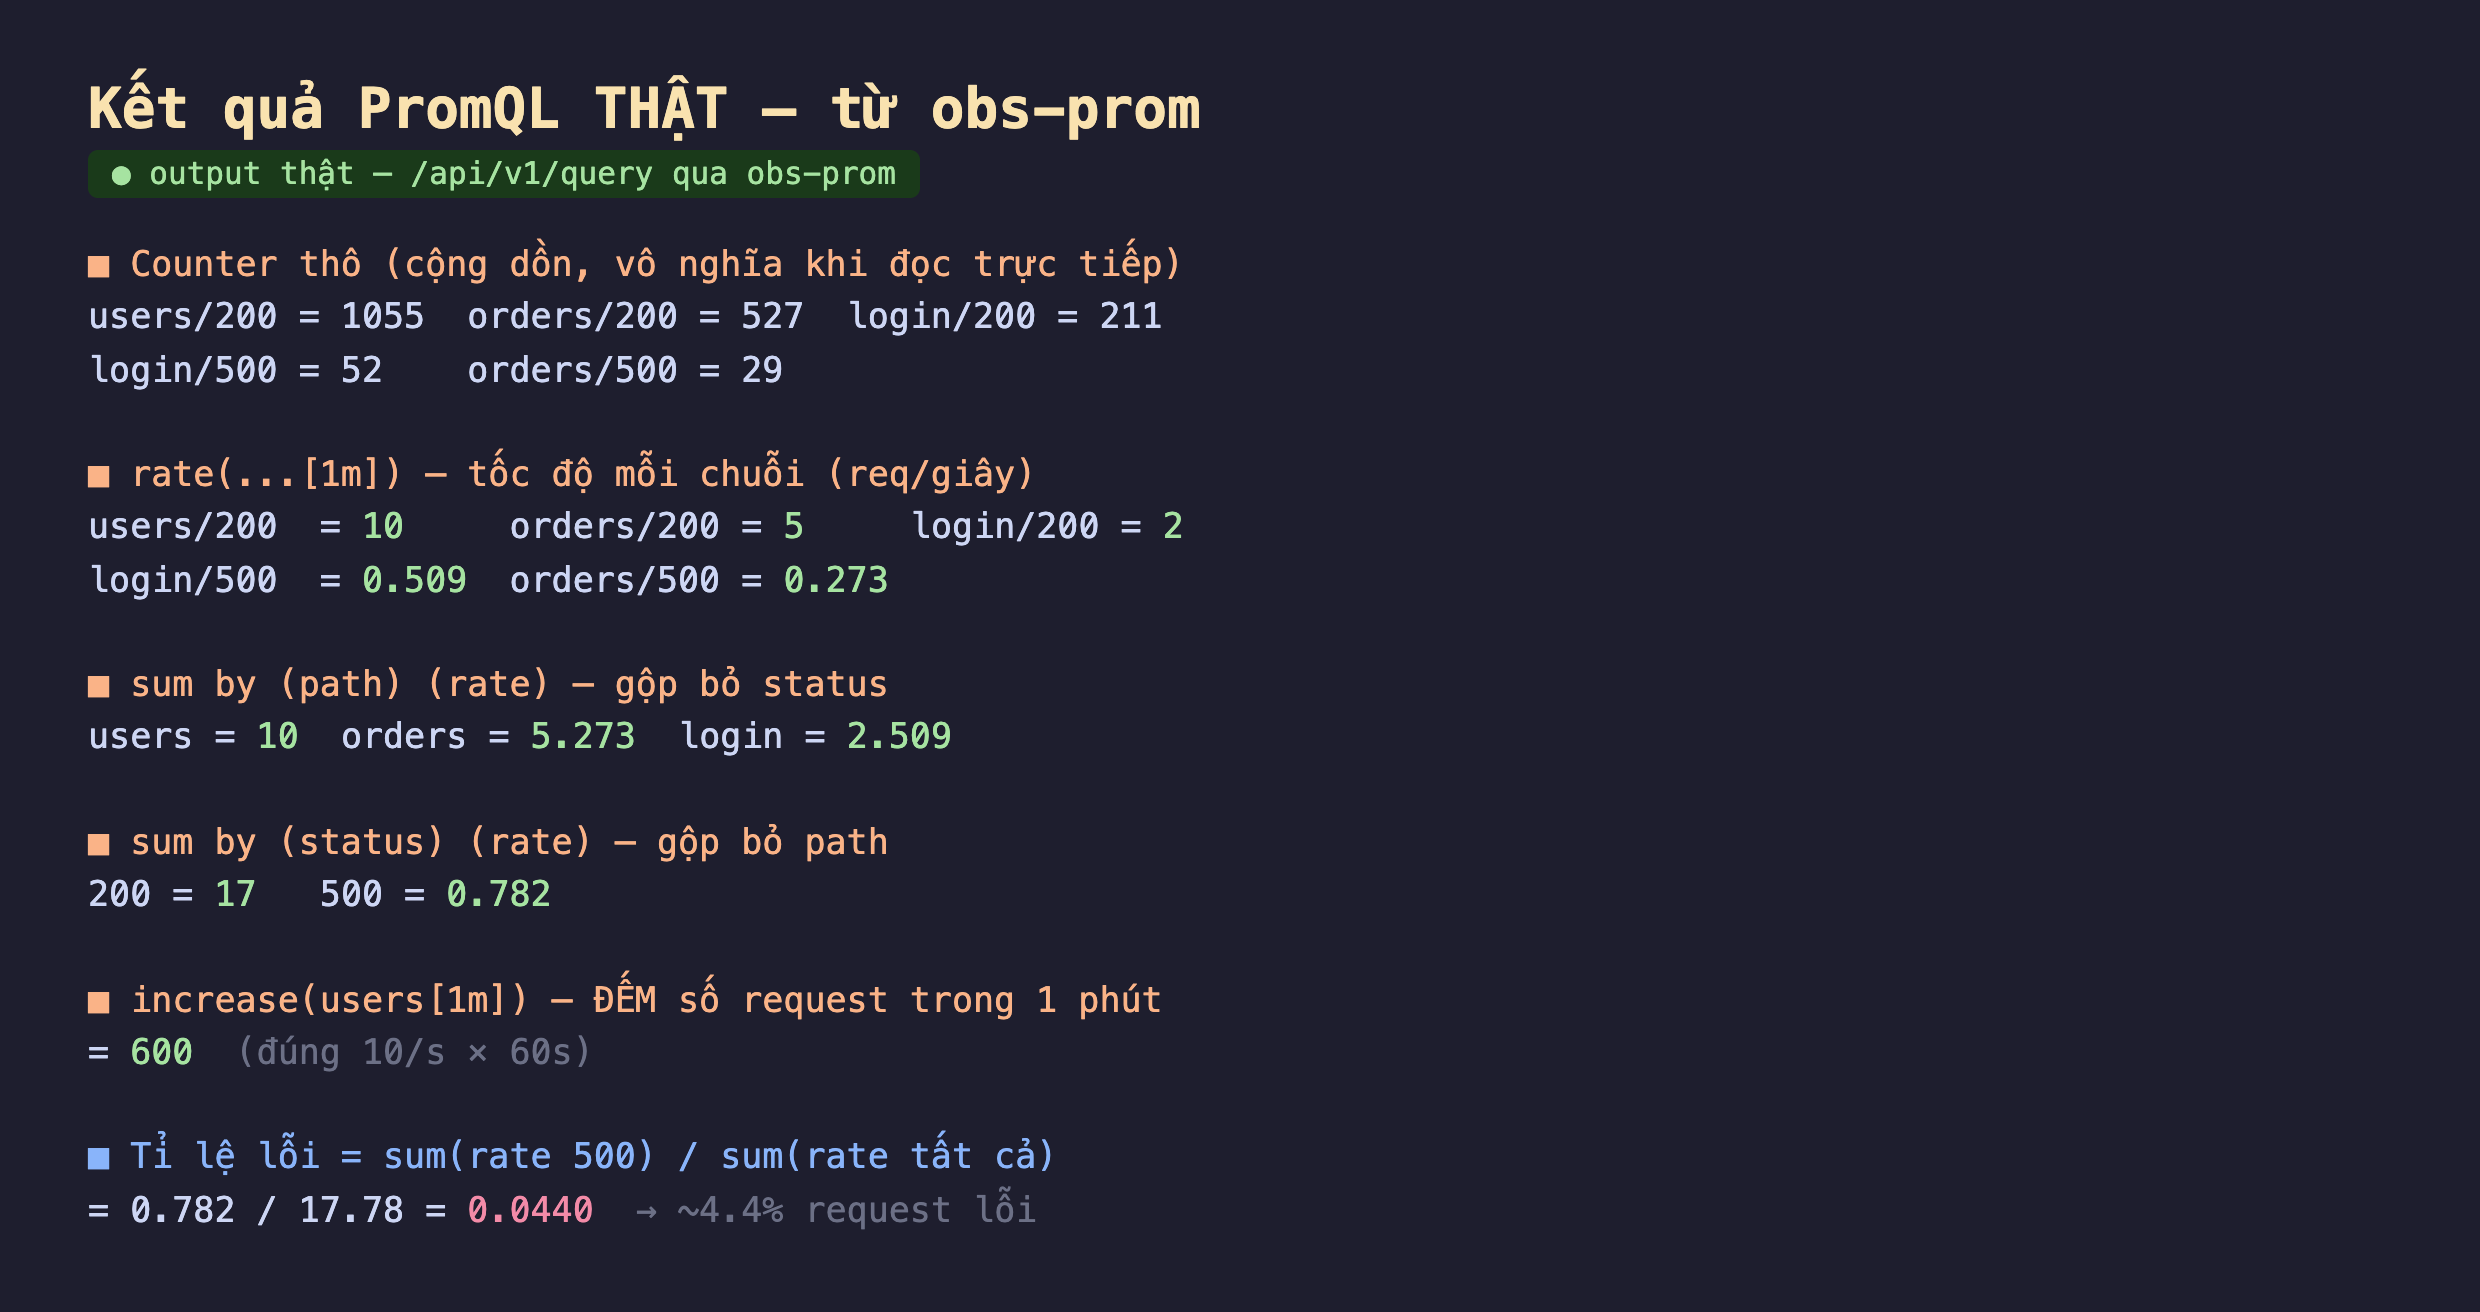
Hình 2: Kết quả thật. Counter thô (1055, 527…) vô nghĩa khi đọc trực tiếp; rate(...[1m]) trả về đúng tốc độ đã đặt (10, 5, 2 req/s); sum by (path) và sum by (status) gộp theo chiều; increase(users[1m]) ra đúng 600; tỉ lệ lỗi tính được 0.0440 (~4.4%).
Đọc từng query:
rate(http_requests_total[1m])— với mỗi chuỗi, tính tốc độ tăng trung bình mỗi giây trong cửa sổ 1 phút. Kết quả: users/200 = 10, orders/200 = 5, login/200 = 2 — đúng tỉ lệ mình đặt. Đây là con số bạn thật sự quan tâm, không phải counter thô.rate()cũng tự xử lý counter reset (app restart) nên không bao giờ ra giá trị âm.sum by (path) (rate(...))— gộp các chuỗi, giữ nhãnpath, bỏstatus. Nên/api/login= 2.509 (gộp cả 200 lẫn 500: 2 + 0.509). Đây là cách trả lời "endpoint nào nóng nhất" bất kể status.sum by (status) (rate(...))— gộp theo chiều kia: tổng mọi request 200 = 17/s, mọi request 500 = 0.782/s, không quan tâm path.increase(http_requests_total{path="/api/users"}[1m])— khácrate,increasecho số lượng tăng trong cửa sổ (không chia cho giây). Kết quả 600 — đúng bằng 10/s × 60s. Dùng khi bạn muốn "có bao nhiêu request trong 1 phút qua" thay vì tốc độ.- Tỉ lệ lỗi —
sum(rate(...{status="500"}[1m])) / sum(rate(...[1m]))= 0.782 / 17.78 = 0.0440, tức ~4.4% request bị lỗi. Một dòng PromQL cho ra chỉ số sức khoẻ cốt lõi của service.
Điểm mấu chốt: cùng một bộ counter thô, PromQL bóc ra được tốc độ, phân rã theo bất kỳ nhãn nào, và chỉ số tổng hợp — tất cả sau khi thu thập, không cần đổi code app.
Vì sao luôn bọc counter trong rate() trước khi gộp
Một lỗi kinh điển của người mới: sum(http_requests_total) — cộng thẳng các counter thô. Nó cho một con số tăng vô hạn, nhảy giật mỗi khi một instance restart (counter về 0 kéo tổng tụt xuống), và hoàn toàn không phản ánh tải. Thứ tự đúng luôn là: rate() trước (biến counter thô thành tốc độ, xử lý reset), rồi sum() sau (gộp các tốc độ lại). sum(rate(...)) có nghĩa; rate(sum(...)) thì không (bạn không thể rate một đại lượng đã mất thông tin per-series về reset). Quy tắc: rate trong, sum ngoài.
Đánh đổi cần cân nhắc
Cửa sổ [1m] phải chứa đủ điểm dữ liệu. rate() cần ít nhất 2 mẫu trong cửa sổ để tính. Với scrape 5s, [1m] có ~12 mẫu — thừa. Nhưng nếu scrape interval là 1 phút mà bạn dùng rate(...[1m]), cửa sổ chỉ chứa 1 điểm và query trả về rỗng. Quy tắc an toàn: cửa sổ range nên ít nhất gấp 4 lần scrape interval. Query cảnh báo thường dùng [5m] để mượt và bền với một lần scrape lỗi.
rate làm mượt, nên che gai nhọn ngắn. rate(...[5m]) trung bình hoá 5 phút — một đợt lỗi bùng 10 giây sẽ bị pha loãng và có thể không chạm ngưỡng cảnh báo. Cửa sổ ngắn ([1m]) nhạy hơn nhưng nhiễu hơn. Chọn cửa sổ là đánh đổi giữa độ nhạy và độ ổn định; không có giá trị đúng cho mọi trường hợp.
rate nội suy nên con số có thể hơi "lẻ". Ở đây kết quả ra tròn (10, 5, 600) vì tải cực đều, nhưng trong thực tế rate ngoại suy ở biên cửa sổ và căn mẫu không trùng ranh giới, nên bạn thường thấy 9.98 thay vì 10. Đó là bản chất của phép tính trên chuỗi thời gian rời rạc, không phải lỗi — đừng mong con số tuyệt đối chính xác từ rate.
Ba ý mang về
- Counter thô vô dụng,
rate()mới có nghĩa: đo thật counterhttp_requests_total=1055chẳng nói gì, nhưngrate(...[1m])ra đúng 10/5/2 req/s — tốc độ hiện tại là thứ bạn thật sự cần, vàratetự xử lý counter reset. sum byphân rã theo nhãn,increaseđếm số lượng: đo thậtsum by (path)tách endpoint nóng,sum by (status)tách lỗi,increase(users[1m])=600cho số request trong cửa sổ — cùng bộ metric, nhiều góc nhìn.- Rate trong, sum ngoài; chọn cửa sổ cẩn thận:
sum(rate(...))đúng cònsumcounter thô thì sai; cửa sổ range nên ≥4× scrape interval, và cửa sổ ngắn nhạy nhưng nhiễu — ví dụ một dòng tính tỉ lệ lỗi ra 4.4% cho chỉ số sức khoẻ tức thì.
Nguồn
- Prometheus docs — Querying basics: https://prometheus.io/docs/prometheus/latest/querying/basics/
- Prometheus docs — Query functions (rate, increase): https://prometheus.io/docs/prometheus/latest/querying/functions/
- Prometheus docs — Aggregation operators: https://prometheus.io/docs/prometheus/latest/querying/operators/#aggregation-operators
Phần sau ta mổ xẻ percentile: vì sao trung bình độ trễ nói dối, p99 thật sự nghĩa là gì, và histogram_quantile tính nó từ bucket ra sao — chạy thật để thấy average che giấu đuôi chậm thế nào.
