Dashboard của bạn ghi "độ trễ trung bình: 36ms". Nghe tuyệt — service khoẻ, không cần lo. Nhưng trung bình là một trong những con số dối trá nhất trong giám sát hệ thống, vì nó gộp tất cả vào một điểm và che mất thứ quan trọng nhất: đuôi chậm. Một service có thể có trung bình đẹp mà vẫn khiến một phần người dùng chờ hàng giây. Công cụ bóc trần chuyện này là percentile — p50, p95, p99. Bài này (phần 4 loạt Observability) chạy thật một app có phân bố độ trễ lệch để thấy chính xác trung bình giấu gì, và p99 phơi bày gì.
Vì sao trung bình che mất đuôi
Trung bình cộng mọi giá trị rồi chia cho số lượng. Vấn đề: nó nhạy với giá trị cực đoan theo cách sai. Nếu 95% request nhanh (10ms) và 5% rất chậm (500ms), trung bình bị kéo lên một chút — nhưng nó không cho bạn biết rằng có một nhóm người dùng đang chịu trải nghiệm tệ. Nó trộn hai thế giới thành một con số vô hại.
Percentile trả lời câu hỏi khác hẳn: "pN = giá trị mà N% quan sát nằm dưới nó". p99 = 500ms nghĩa là 99% request nhanh hơn 500ms, nhưng 1% chậm hơn thế. Đó chính là nhóm user khổ sở mà trung bình giấu đi. Với service thật, SLO (mục tiêu mức dịch vụ) gần như luôn đặt theo p95/p99, không bao giờ theo trung bình.
Prometheus tính percentile từ histogram bằng histogram_quantile, nội suy từ các bucket cộng dồn:
var lat = promauto.NewHistogram(prometheus.HistogramOpts{
    Name:    "http_latency_seconds",
    Buckets: []float64{.005, .01, .025, .05, .1, .25, .5, 1.0},
})
// bộ tải nền: phân bố BIMODAL — hai cụm tách biệt
if rand.Intn(100) < 5 {
    d = 0.40 + rand.Float64()*0.20   // 5%: chậm 400-600ms
} else {
    d = 0.005 + rand.Float64()*0.015 // 95%: nhanh 5-20ms
}
lat.Observe(d)
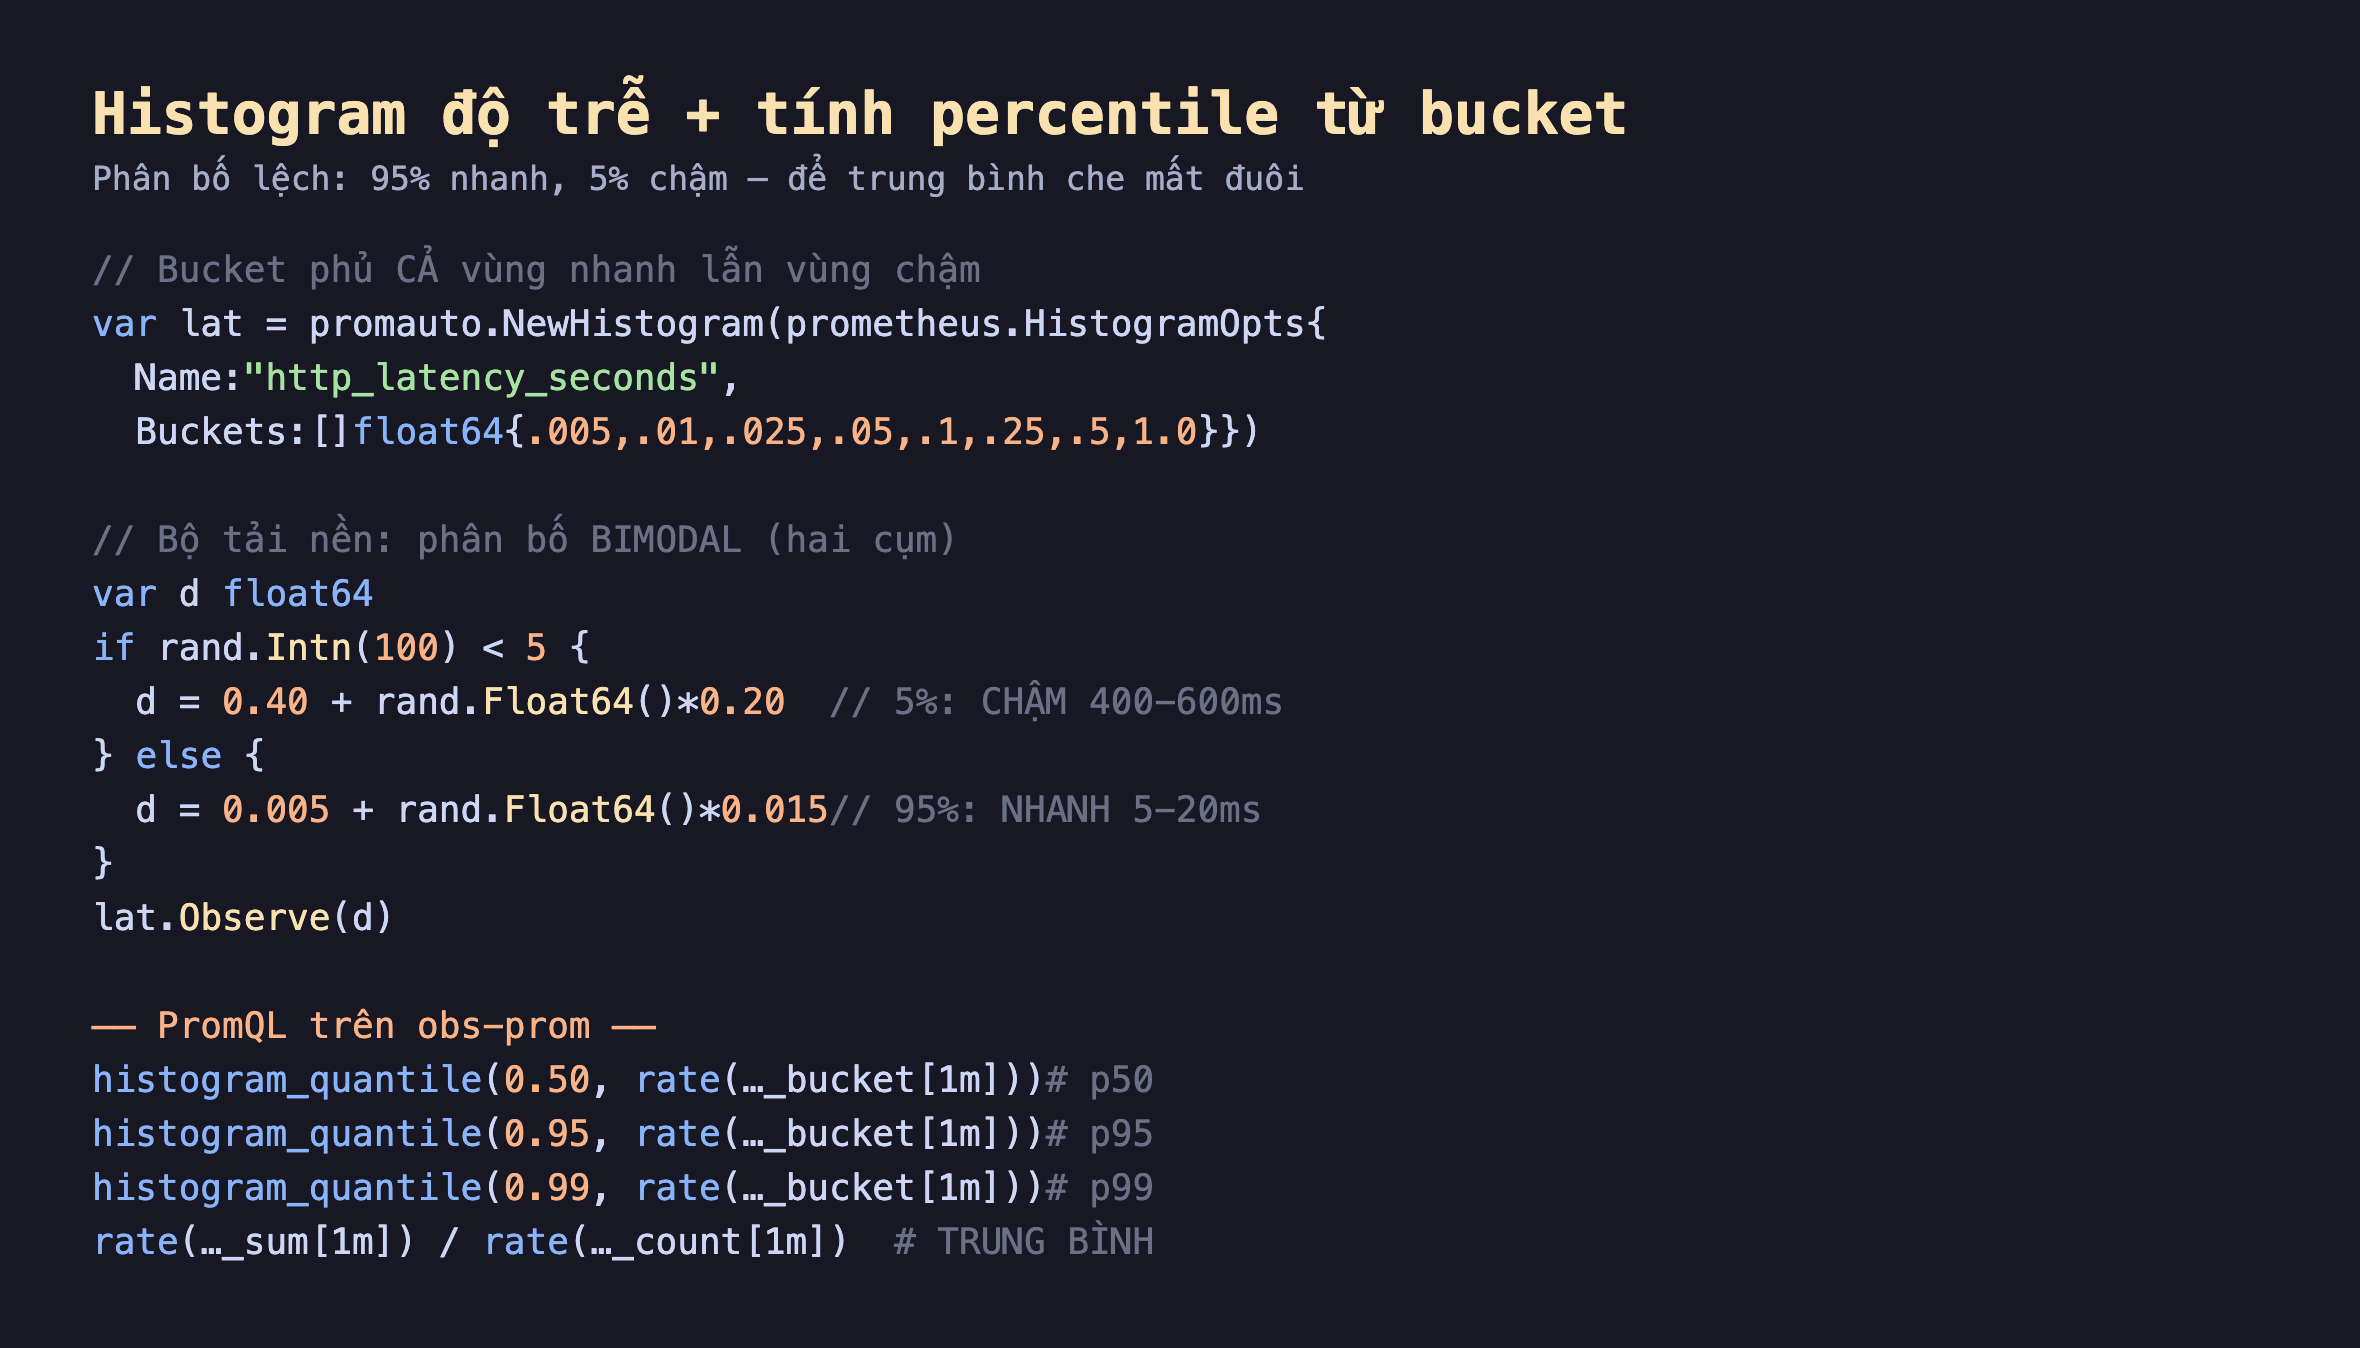
Hình 1: Histogram với bucket phủ cả vùng nhanh và chậm; bộ tải nền tạo phân bố bimodal (95% nhanh, 5% chậm) — kiểu phân bố thực tế hay gặp. Bên dưới là các câu PromQL tính p50/p95/p99 bằng histogram_quantile và trung bình bằng rate(_sum)/rate(_count).
Đo thật: bốn con số từ cùng một dữ liệu
Mình để app chạy ~70 giây, obs-prom scrape, tích được 4595 mẫu. Rồi hỏi cùng một histogram bốn cách:
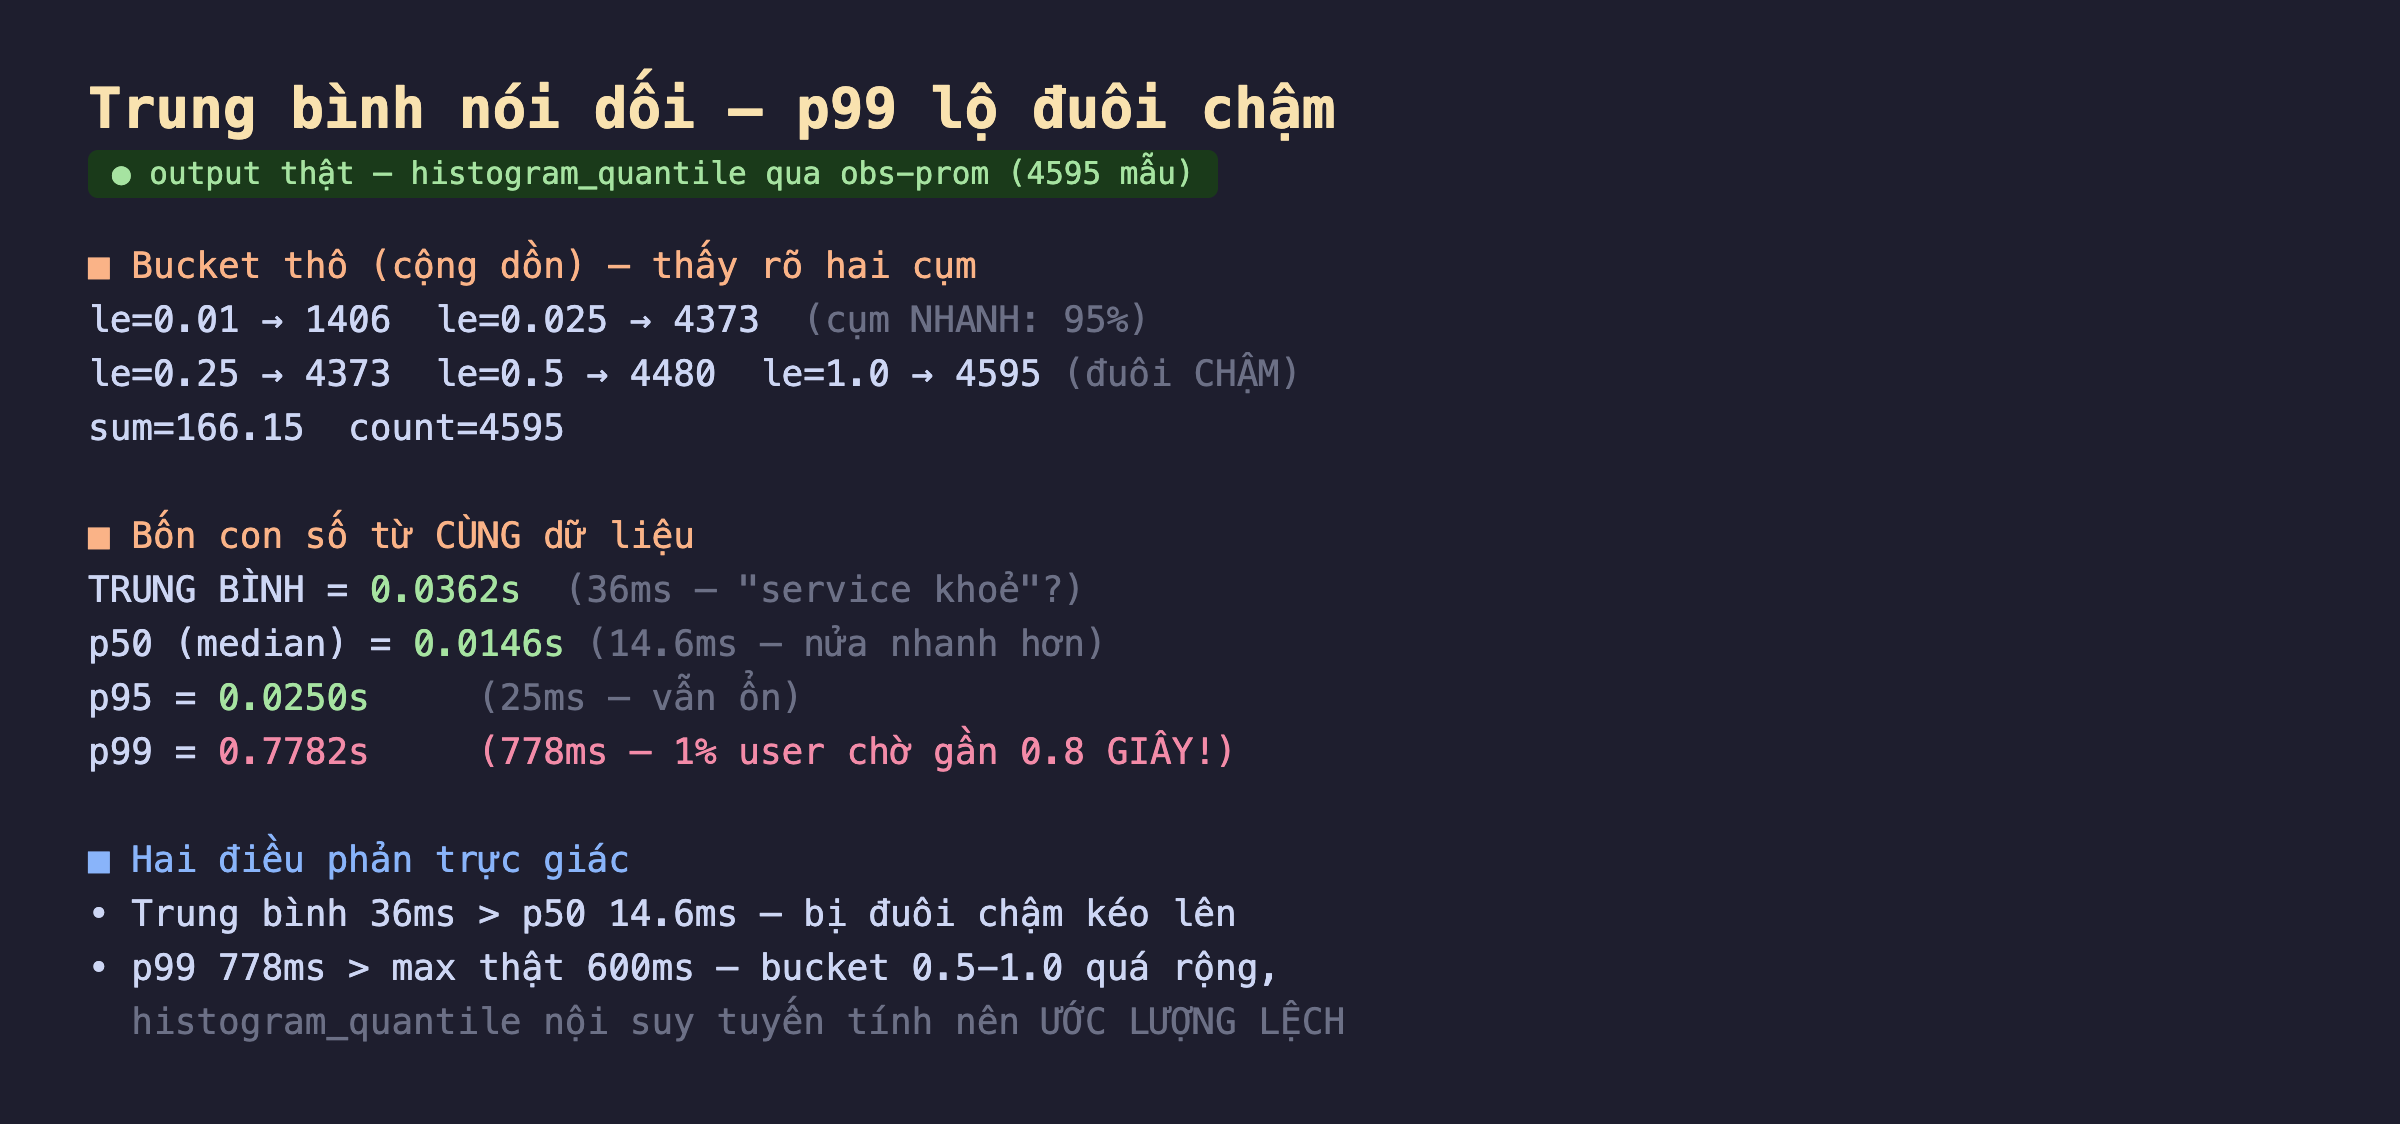
Hình 2: Kết quả thật. Bucket thô cho thấy rõ hai cụm (4373/4595 nằm ≤0.025s, phần còn lại ở 0.25–1.0s). Từ cùng dữ liệu: trung bình=36ms và p95=25ms trông đẹp, nhưng p99=778ms. Hai điều phản trực giác: trung bình (36ms) > p50 (14.6ms), và p99 (778ms) > giá trị chậm nhất thật (600ms).
Đọc kết quả:
- Trung bình = 36ms — nhìn qua thì service hoàn toàn khoẻ. Đây là con số nhiều dashboard mặc định hiển thị.
- p50 (median) = 14.6ms — một nửa số request còn nhanh hơn 15ms. Để ý: trung bình (36ms) lớn hơn hẳn median (14.6ms) — dấu hiệu kinh điển của phân bố có đuôi. Khi
mean > mediannhiều, bạn biết có đuôi chậm đang kéo trung bình lên. - p95 = 25ms — 95% request dưới 25ms. Vẫn đẹp! Đây là cái bẫy: ngay cả p95 cũng có thể không bắt được đuôi nếu đuôi mỏng hơn 5%.
- p99 = 778ms — và đây là sự thật. Cứ 100 request thì 1 cái mất gần 0.8 giây. Với service nhận 1000 req/s, đó là 10 user mỗi giây chịu trải nghiệm tệ — hoàn toàn vô hình nếu bạn chỉ nhìn trung bình hay p95.
Cùng một bộ dữ liệu, bốn con số, bốn kết luận khác nhau về sức khoẻ service. Đó là lý do percentile không phải lựa chọn mà là bắt buộc.
Bất ngờ: vì sao p99 = 778ms khi giá trị chậm nhất chỉ 600ms?
Đây là điểm mình muốn nói thẳng vì nó dễ làm người ta mất niềm tin vào số liệu. Mình biết giá trị chậm nhất trong code là 600ms (0.40 + 0.20), vậy sao p99 đo được tới 778ms?
Vì histogram_quantile không biết giá trị thật — nó chỉ thấy các bucket. Các request chậm (400–600ms) rơi vào bucket (0.5, 1.0] và một phần vào (0.25, 0.5]. Khi tính p99, hàm giả định dữ liệu phân bố đều trong bucket chứa nó, rồi nội suy tuyến tính. Vì bucket (0.5, 1.0] rộng tới 500ms, phép nội suy đặt p99 ở đâu đó giữa 0.5 và 1.0 — ra 778ms, cao hơn giá trị thật. Bucket càng rộng ở vùng có dữ liệu, ước lượng càng lệch.
Bài học: percentile từ histogram chỉ chính xác bằng độ mịn của bucket ở đúng vùng giá trị. Nếu mình thêm bucket 0.6, 0.7 vào vùng chậm, p99 sẽ sát 600ms hơn nhiều. Đây không phải lỗi của Prometheus — đó là bản chất của việc nén phân bố thành bucket, và là lý do chọn bucket quan trọng ngang chọn metric.
Đánh đổi cần cân nhắc
Không bao giờ tính trung bình của percentile. Một lỗi phổ biến: lấy p99 của 10 instance rồi tính trung bình chúng. Toán học không cho phép — p99 không cộng/trung bình được. Phải dùng histogram (gửi bucket thô, gộp ở server rồi mới histogram_quantile) như bài trước đã nói; summary tính p99 phía client thì không gộp được giữa instance. Đây là lý do thực tế để chọn histogram.
Bucket phải khớp vùng giá trị thực tế. Như demo cho thấy, bucket lệch làm p99 sai cả trăm ms. Nhưng thêm quá nhiều bucket lại tăng cardinality (mỗi bucket là một chuỗi). Cân bằng: đặt bucket dày ở vùng bạn quan tâm nhất (quanh SLO target), thưa ở vùng ít quan trọng. Go runtime có native histogram (từ client_golang mới) tự co giãn bucket, giảm bớt nỗi đau này — nhưng cần Prometheus bật hỗ trợ.
p99 vẫn giấu p99.9 và p100. Percentile càng cao càng lộ đuôi, nhưng cũng càng nhiễu (ít mẫu hơn ở đuôi). p99 bỏ qua 1% chậm nhất — với hệ thống quy mô lớn, 1% đó có thể là hàng nghìn user. Dịch vụ nhạy cảm theo dõi cả p99.9. Và timeout/lỗi (request không bao giờ xong) không xuất hiện trong histogram độ trễ — phải đo riêng, đừng tưởng p99 đẹp là không có request treo.
Ba ý mang về
- Trung bình che đuôi, percentile phơi bày: đo thật trung bình=36ms và p95=25ms trông khoẻ, nhưng p99=778ms — 1% user chờ gần 0.8 giây; dấu hiệu
mean (36) > median (14.6)cho biết ngay có đuôi chậm. - Percentile từ histogram chỉ chính xác bằng bucket: đo thật p99=778ms cao hơn max thật 600ms vì bucket
(0.5,1.0]quá rộng vàhistogram_quantilenội suy tuyến tính — chọn bucket khớp vùng giá trị quan trọng ngang chọn metric. - Không trung bình hoá percentile, và p99 vẫn chưa phải tất cả: dùng histogram để gộp bucket ở server rồi mới tính quantile (summary không gộp được); p99 bỏ qua 1% chậm nhất và không thấy request treo — theo dõi thêm p99.9 và lỗi riêng.
Nguồn
- Prometheus docs — Histograms and summaries: https://prometheus.io/docs/practices/histograms/
- Prometheus docs — histogram_quantile(): https://prometheus.io/docs/prometheus/latest/querying/functions/#histogram_quantile
- Gil Tene — How NOT to Measure Latency: https://www.infoq.com/presentations/latency-response-time/
Phần sau ta áp dụng percentile vào một khung chuẩn: RED method (Rate, Errors, Duration) — ba metric cốt lõi cho mọi service request-driven, dựng thật dashboard RED từ chính các metric đã có.
