Bạn vừa nhận một service mới để vận hành. Cần gắn metric gì để biết nó có khoẻ không? Nếu bắt đầu liệt kê — CPU, RAM, goroutine, connection pool, GC... — bạn sẽ chết chìm trong hàng trăm chỉ số mà vẫn không trả lời được câu hỏi đơn giản nhất: người dùng có đang gặp vấn đề không? RED method cắt qua mớ hỗn độn đó bằng một tuyên bố gọn: với mọi service xử lý request, chỉ cần ba tín hiệu — Rate, Errors, Duration. Bài này (phần 5 loạt Observability) dựng thật một dashboard RED, và cho thấy vì sao cách tách ba tín hiệu đó quan trọng ngang việc đo chúng.
RED là gì và vì sao đủ
RED (do Tom Wilkie đặt tên, họ hàng với USE method cho tài nguyên) gồm:
- Rate — số request mỗi giây service đang xử lý. Cho biết tải.
- Errors — số (hoặc tỉ lệ) request thất bại mỗi giây. Cho biết tính đúng đắn.
- Duration — phân bố thời gian xử lý (p50/p99). Cho biết tốc độ.
Vì sao ba cái này đủ cho tầng đầu? Vì chúng phản ánh trực tiếp trải nghiệm người dùng, không phải trạng thái nội tại của máy. CPU 90% không phải vấn đề nếu request vẫn nhanh và không lỗi; CPU 20% cũng không an ủi gì nếu nửa số request đang trả 500. RED đo đúng cái người dùng cảm nhận. Chỉ số tài nguyên (CPU/RAM) vẫn hữu ích — nhưng để chẩn đoán nguyên nhân sau khi RED cho biết có vấn đề.
Điều hay nhất: cả ba lấy từ chỉ hai metric — một counter (cho R và E) và một histogram (cho D):
// R + E: một counter, tách theo route và status
var reqs = promauto.NewCounterVec(prometheus.CounterOpts{
    Name: "http_requests_total"}, []string{"route", "status"})
// D: một histogram độ trễ theo route
var dur = promauto.NewHistogramVec(prometheus.HistogramOpts{
    Name:    "http_request_duration_seconds",
    Buckets: []float64{.01, .025, .05, .1, .25, .5, 1}}, []string{"route"})

// mỗi request ghi cả ba tín hiệu trong vài dòng
reqs.WithLabelValues(route, status).Inc()
dur.WithLabelValues(route).Observe(d)
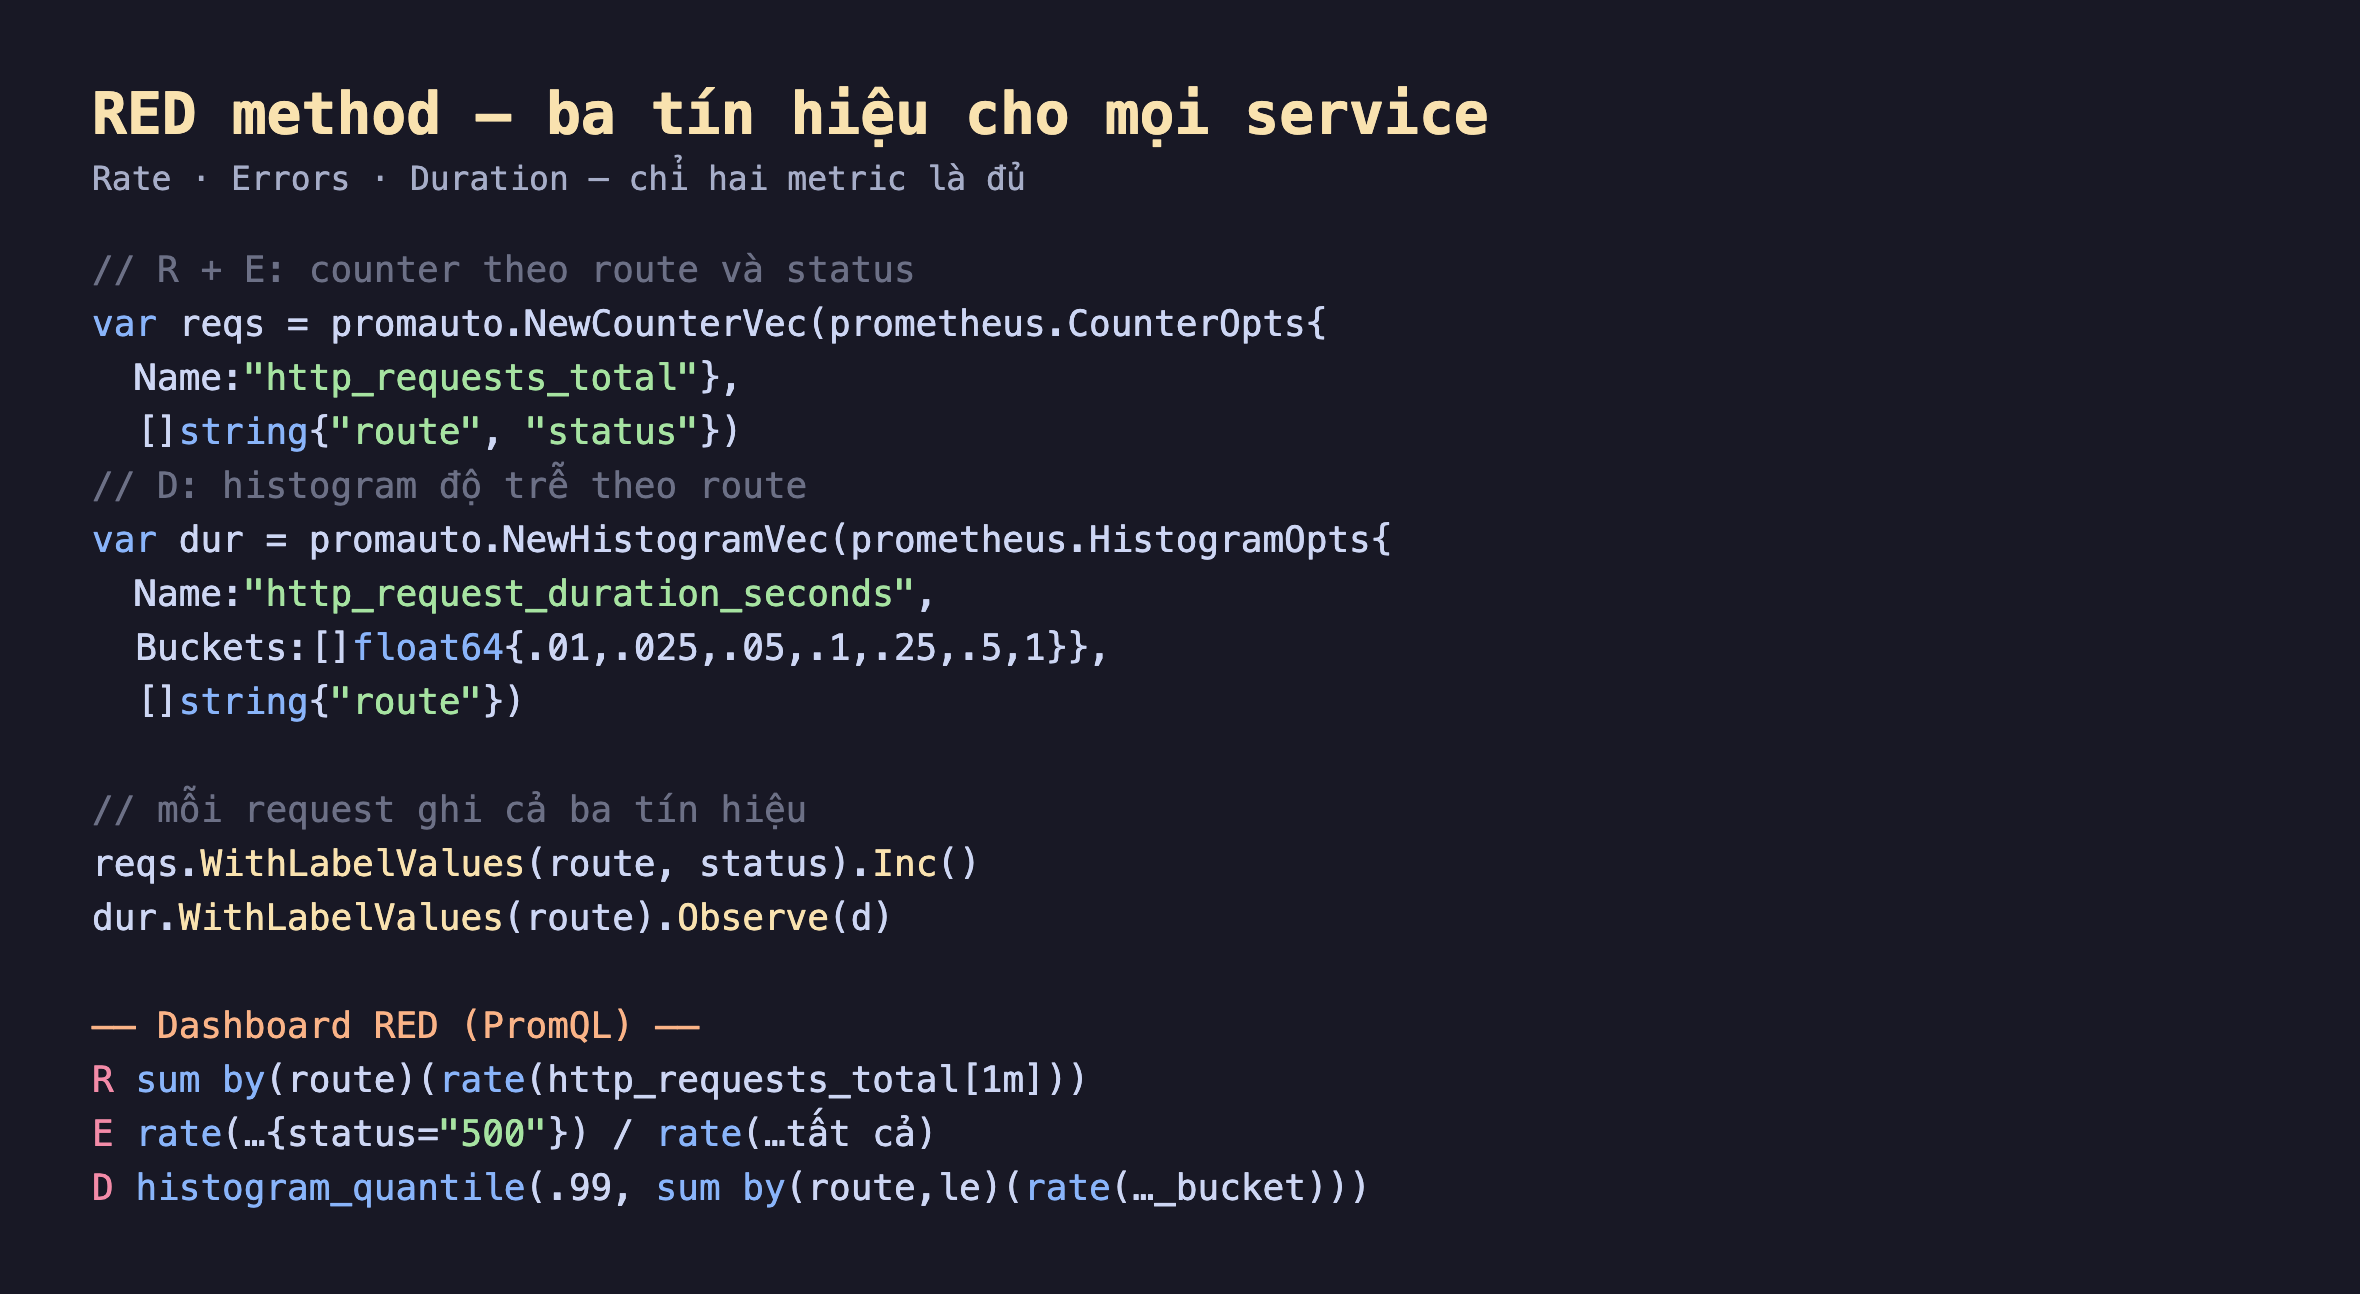
Hình 1: Instrument RED chỉ cần hai metric — một counter http_requests_total{route,status} (cho Rate và Errors) và một histogram http_request_duration_seconds{route} (cho Duration). Mỗi request ghi cả ba tín hiệu trong vài dòng; ba câu PromQL bên dưới dựng nên dashboard.
Đo thật: dashboard RED và cú lừa của số tổng hợp
Mình dựng một service hai route: /products (route nóng, nhanh, ít lỗi) và /checkout (route quan trọng về tiền, mình cố tình cho chậm hơn và lỗi nhiều hơn — như thực tế hay gặp khi route phức tạp gọi nhiều dịch vụ con). Cho chạy ~70 giây, obs-prom scrape, rồi chạy ba câu PromQL RED:
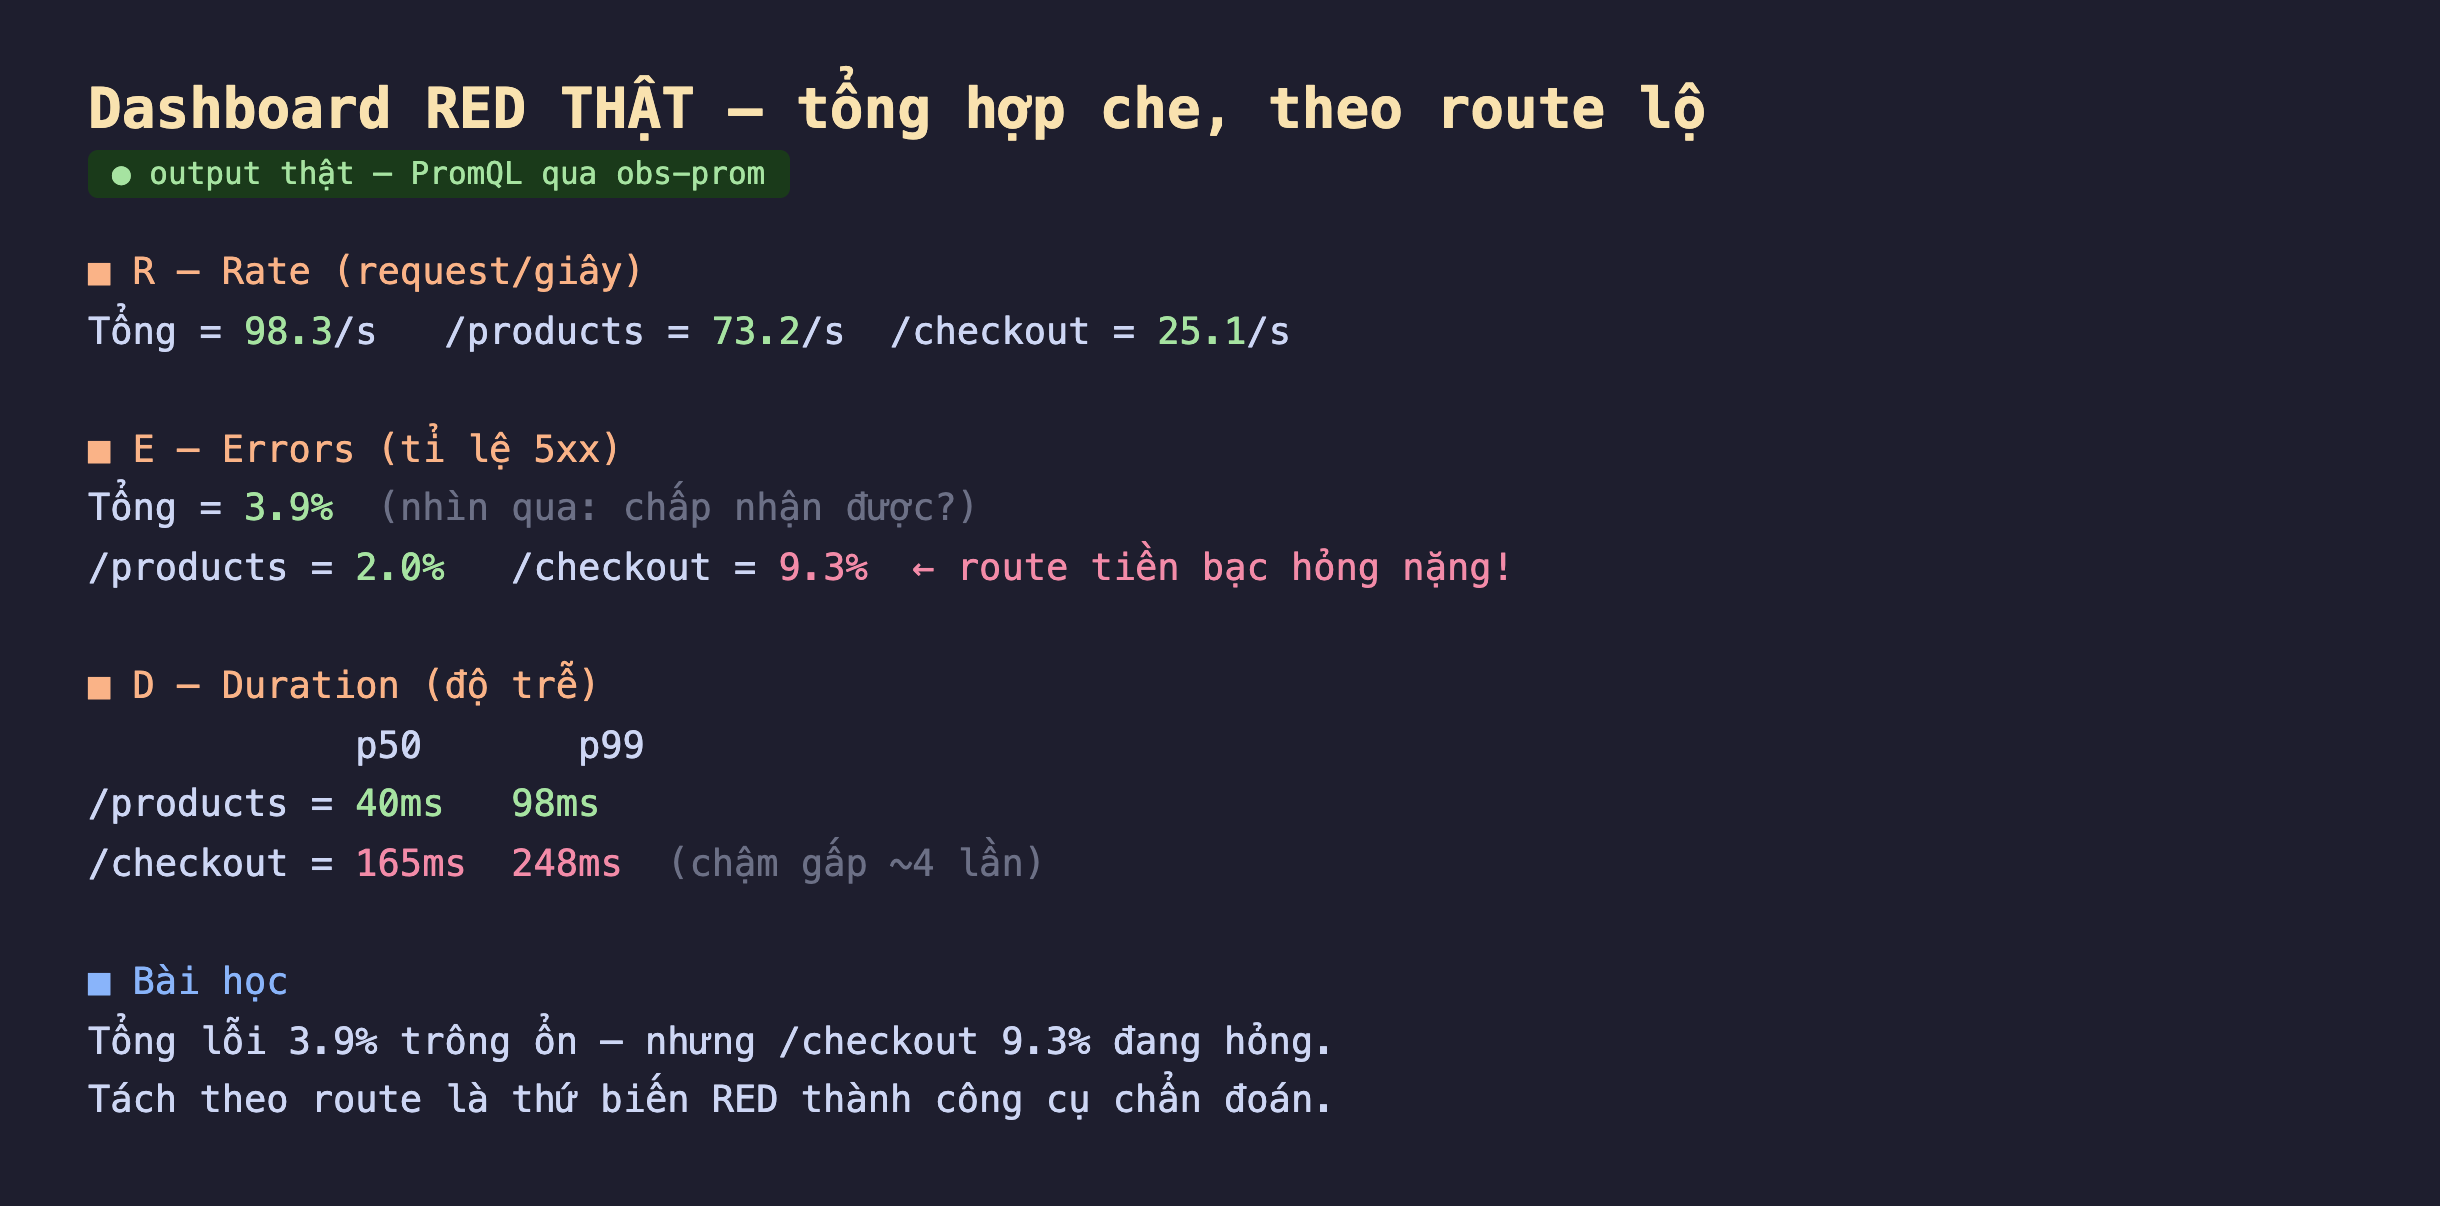
Hình 2: Dashboard RED thật. R: tổng 98.3 req/s (products 73.2, checkout 25.1). E: tỉ lệ lỗi tổng 3.9% — nhưng tách ra, /checkout lỗi 9.3% trong khi /products chỉ 2.0%. D: /checkout chậm gấp ~4 lần (p50 165ms, p99 248ms) so với /products (p50 40ms, p99 98ms).
Đọc dashboard:
- Rate: service nhận 98.3 req/s, phần lớn vào
/products(73.2/s). Con số này cho biết tải và là mẫu số để tính tỉ lệ lỗi. - Errors: đây là chỗ bài học nằm. Tỉ lệ lỗi tổng hợp = 3.9% — nhìn qua có vẻ chấp nhận được, nhiều team sẽ không báo động. Nhưng tách theo route:
/checkoutđang lỗi 9.3%, gần 1/10 giao dịch thất bại — trong khi/productschỉ 2.0% kéo con số trung bình xuống. Nếu chỉ nhìn số tổng, bạn hoàn toàn bỏ lỡ việc route tiền bạc đang hỏng nặng. - Duration:
/checkoutchậm gấp ~4 lần/productsở cả p50 (165ms vs 40ms) và p99 (248ms vs 98ms). Lại một lần nữa, số tổng hợp sẽ pha loãng điều này.
Thông điệp cốt lõi: RED chỉ mạnh khi tách theo chiều có ý nghĩa (route, endpoint, phiên bản). Số tổng hợp cho bạn biết "có gì đó", số tách ra cho bạn biết "chỗ nào" — và đó là khác biệt giữa một con số đẹp vô dụng và một công cụ chẩn đoán.
Vì sao RED hợp cho service, USE hợp cho tài nguyên
RED đo công việc đi qua một service (request). Nó không hợp để mô tả một tài nguyên (CPU, đĩa, connection pool) — những thứ đó không có khái niệm "request" hay "lỗi" theo cùng nghĩa. Cho tài nguyên, có khung chị em là USE (Utilization, Saturation, Errors) — chủ đề bài sau. Quy tắc nhanh: thứ gì phục vụ request thì đo bằng RED; thứ gì là tài nguyên bị tiêu thụ thì đo bằng USE. Một hệ thống hoàn chỉnh dùng cả hai: RED ở biên (service) để biết người dùng có khổ không, USE bên trong (tài nguyên) để biết vì sao.
Đánh đổi cần cân nhắc
Cardinality là cái giá của việc tách. Tách theo route rất giá trị, nhưng nếu route chứa tham số (/user/12345, /user/67890...) thì mỗi id tạo một chuỗi mới và làm nổ Prometheus. Luôn chuẩn hoá route về mẫu (/user/{id}) trước khi đặt làm nhãn — đây là lỗi cardinality phổ biến nhất khi làm RED, và là chủ đề riêng của bài sau.
"Error" cần định nghĩa rõ. Ở đây mình đếm status 5xx là lỗi. Nhưng 4xx (client gửi sai) có tính là lỗi service không? Thường là không — 404 hay 400 là hành vi đúng của service. Một timeout phía client mà service vẫn trả 200 thì sao? RED counter không thấy. Định nghĩa "lỗi" phải khớp với cái bạn thật sự quan tâm, nếu không tỉ lệ lỗi sẽ gây hiểu nhầm theo cả hai chiều.
RED cho biết "có" và "ở đâu", không cho biết "vì sao". Dashboard chỉ ra /checkout lỗi 9.3% và chậm — nhưng không nói vì database chậm, vì một dependency sập, hay vì deploy lỗi. RED là tầng phát hiện; để tìm nguyên nhân gốc cần đào xuống trace (bài sau) và log. Đừng kỳ vọng RED tự giải thích; nó chỉ đường cho bạn biết đào ở đâu.
Ba ý mang về
- Ba tín hiệu, hai metric, đủ cho tầng đầu: đo thật RED từ một counter + một histogram cho Rate (98.3/s), Errors (tỉ lệ 5xx), Duration (p50/p99) — phản ánh trực tiếp trải nghiệm người dùng, không phải trạng thái máy.
- Tách theo route mới là sức mạnh thật: đo thật tỉ lệ lỗi tổng 3.9% trông ổn nhưng che mất /checkout đang lỗi 9.3% và chậm gấp ~4 lần — số tổng hợp cho biết "có vấn đề", số tách ra cho biết "ở đâu".
- RED cho service, USE cho tài nguyên, và cả hai chỉ phát hiện: dùng RED ở biên để biết người dùng có khổ không, USE bên trong để biết vì sao; chuẩn hoá route tránh nổ cardinality, định nghĩa "lỗi" cho rõ, và đào trace/log để tìm nguyên nhân gốc.
Nguồn
- Tom Wilkie — The RED Method (Grafana/Weaveworks): https://www.weave.works/blog/the-red-method-key-metrics-for-microservices-architecture/
- Grafana — The RED Method: how to instrument your services: https://grafana.com/blog/2018/08/02/the-red-method-how-to-instrument-your-services/
- Google SRE Book — Monitoring Distributed Systems: https://sre.google/sre-book/monitoring-distributed-systems/
Phần sau ta sang khung chị em USE (Utilization, Saturation, Errors) cho tài nguyên — đo thật saturation của một tài nguyên bị quá tải để thấy vì sao utilization cao chưa chắc là vấn đề, mà saturation mới là.
