Dashboard báo "CPU 100%". Phản xạ đầu tiên của nhiều người là hoảng — nhưng đó có thể là sai lầm. Một tài nguyên dùng hết 100% công suất không nhất thiết là vấn đề: có thể nó đang làm việc đúng hết sức mà mọi thứ vẫn trơn tru. Ngược lại, một tài nguyên mới 70% utilization vẫn có thể đang làm người dùng khổ sở. Bí mật nằm ở một tín hiệu mà utilization không bao giờ cho bạn thấy: saturation — mức độ công việc đang xếp hàng chờ. Đây là cốt lõi của USE method, khung chị em của RED (bài trước) nhưng dành cho tài nguyên thay vì service. Bài này (phần 6 loạt Observability) dựng thật một tài nguyên bị quá tải để thấy chính xác vì sao saturation mới là tín hiệu thật.
USE là gì và vì sao utilization không đủ
USE (Brendan Gregg) đo mỗi tài nguyên bằng ba thứ:
- Utilization — phần trăm thời gian tài nguyên bận (CPU bận, worker đang chạy, pool đang dùng).
- Saturation — mức độ công việc không được phục vụ ngay mà phải chờ (độ dài run queue, độ sâu hàng đợi, số kết nối chờ).
- Errors — số sự kiện lỗi (gói tin rớt, job bị từ chối, cấp phát thất bại).
Vì sao utilization một mình lừa dối? Vì nó bão hoà ở 100% và dừng ở đó. Một CPU ở 100% có thể đang phục vụ đúng đủ tải (lành mạnh), hoặc đang bị dội gấp 3 lần sức chứa (thảm hoạ) — cùng một con số 100%. Utilization không phân biệt được hai tình huống. Saturation thì có: nó tiếp tục tăng quá điểm 100% utilization, đo chính xác lượng công việc đang chờ. Đó là lý do saturation thường là chỉ báo sớm và chính xác nhất của quá tải.
Mình mô hình hoá một tài nguyên rõ ràng — một worker pool 4 worker với hàng đợi sức chứa 20 — và instrument cả ba:
jobs := make(chan struct{}, QUEUE)          // tài nguyên: pool + hàng đợi
var busy     = promauto.NewGauge(...)        // U: worker đang bận
var qdepth   = promauto.NewGauge(...)        // S: độ sâu hàng đợi
var rejected = promauto.NewCounter(...)      // E: job bị từ chối

// worker lấy job
busy.Inc(); time.Sleep(50*time.Millisecond); busy.Dec()

// nạp 120 job/s (quá sức 80/s của pool)
select {
case jobs <- struct{}{}: qdepth.Set(float64(len(jobs)))
default:                  rejected.Inc()      // hàng đầy → rớt
}
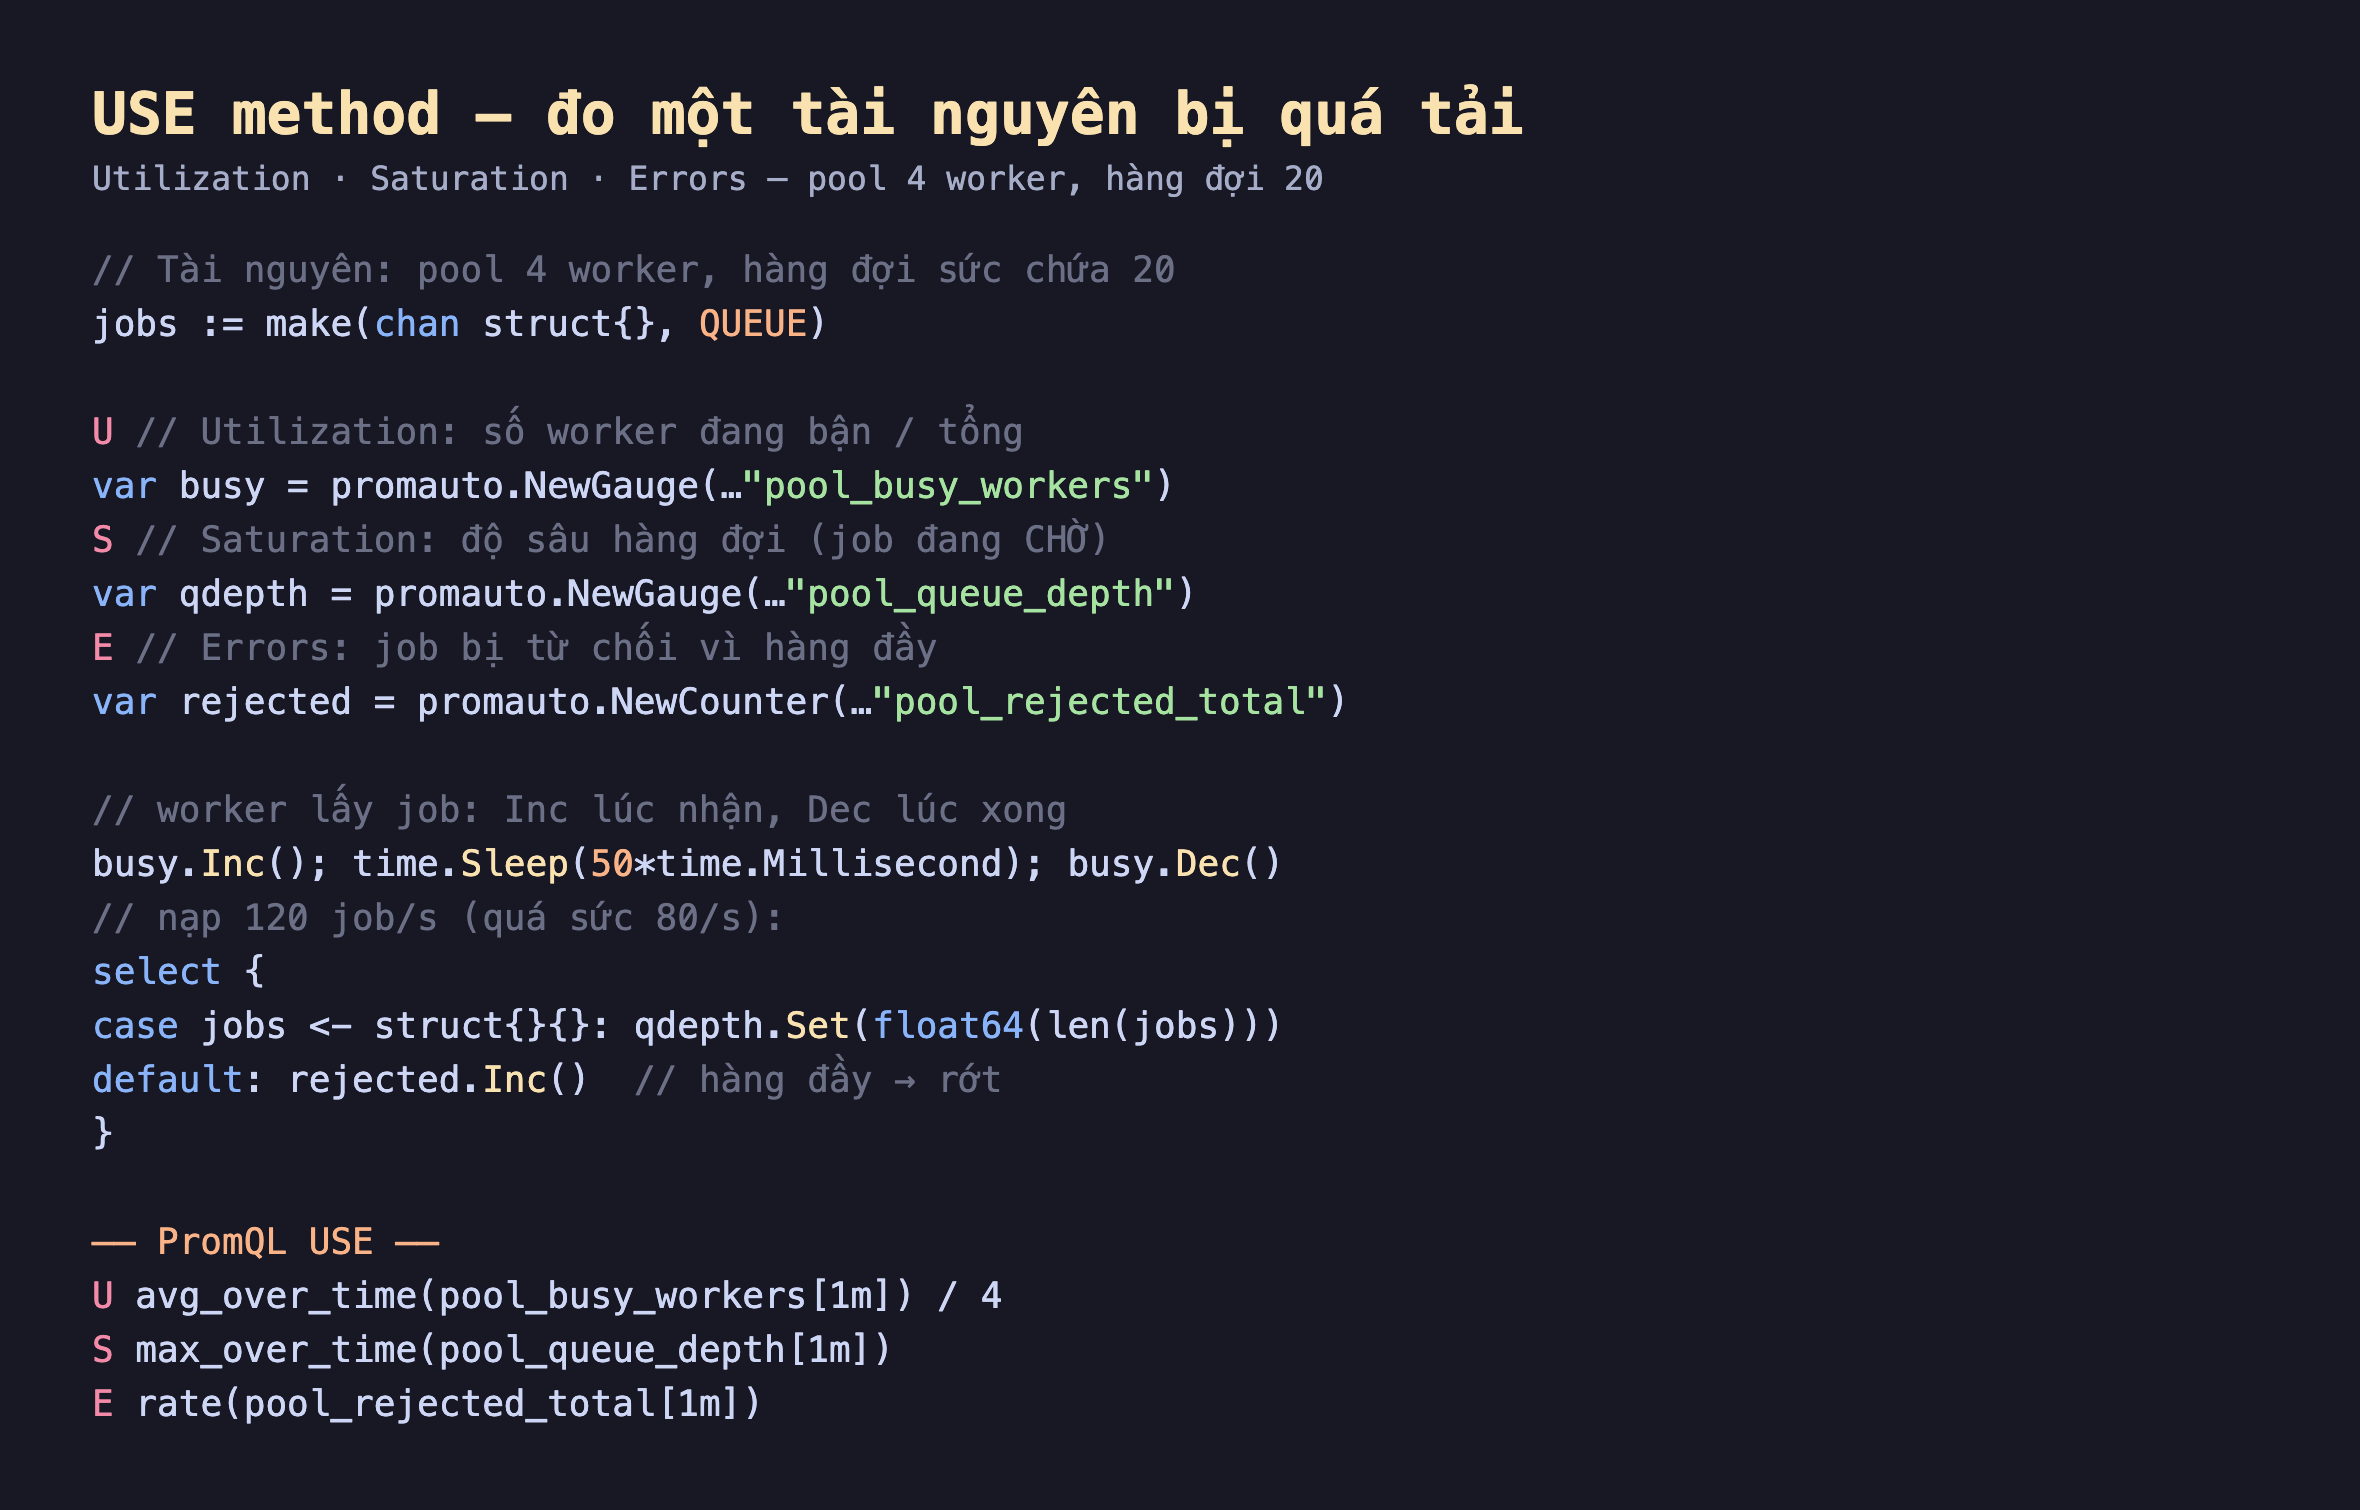
Hình 1: Instrument USE cho một worker pool. Tài nguyên là pool 4 worker + hàng đợi 20; pool_busy_workers (U), pool_queue_depth (S), pool_rejected_total (E). Bộ tải nạp 120 job/s — quá sức xử lý ~80/s — để đẩy tài nguyên vào trạng thái quá tải.
Đo thật: utilization 100% che giấu, saturation phơi bày
Mình cho pool chạy ~70 giây dưới tải 120 job/s (trong khi năng lực chỉ ~80/s), obs-prom scrape, rồi tính ba tín hiệu USE:
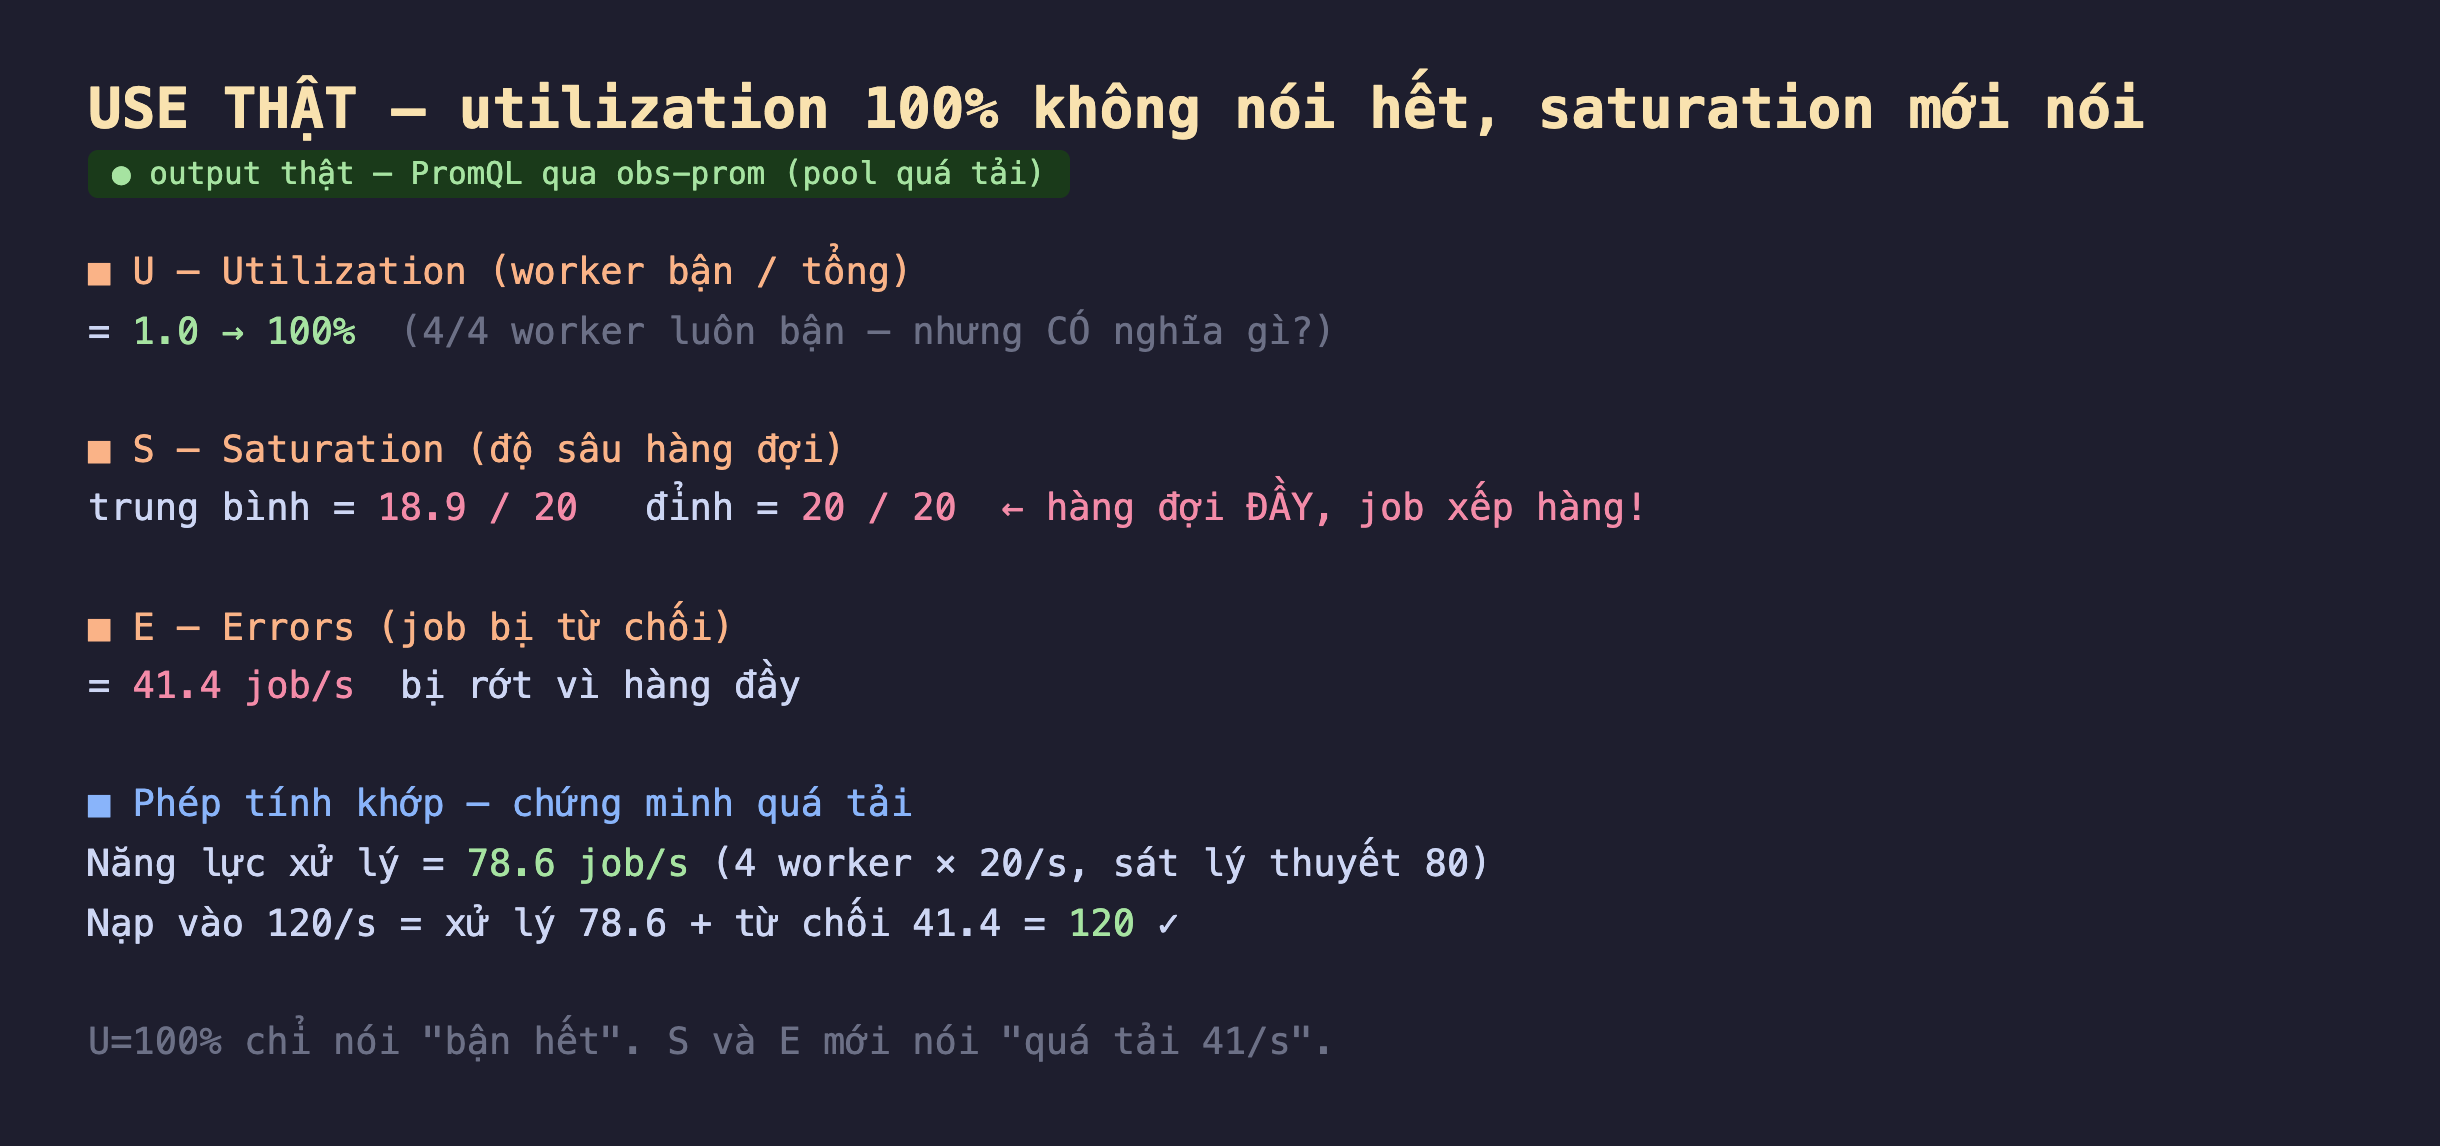
Hình 2: Kết quả USE thật. U=100% (4/4 worker luôn bận) — nhưng con số này một mình không cho biết mức độ. S: hàng đợi trung bình 18.9/20, đỉnh 20/20 — đầy, job phải xếp hàng. E: 41.4 job/s bị rớt. Phép tính khớp: năng lực 78.6/s + từ chối 41.4/s = 120/s nạp vào.
Đọc kết quả:
- Utilization = 100%. Cả 4 worker luôn bận. Nhưng — đây là mấu chốt — con số này giống hệt dù mình nạp 85 job/s hay 1000 job/s. Nó bão hoà. Nhìn riêng U, bạn biết pool "bận hết" nhưng không biết nó đang thiếu hụt bao nhiêu. 100% utilization có thể là hoàn toàn ổn (vừa đủ tải) hoặc đang chết ngạt.
- Saturation = 18.9/20 trung bình, đỉnh 20/20. Đây mới là tín hiệu thật. Hàng đợi gần như luôn đầy — nghĩa là công việc đến nhanh hơn khả năng xử lý, và đang chất đống chờ. Saturation khác 0 (và càng cao/càng đầy) là bằng chứng trực tiếp rằng tài nguyên không theo kịp. Đây là thứ utilization không bao giờ cho thấy.
- Errors = 41.4 job/s bị từ chối. Khi hàng đợi đầy, job mới bị rớt thẳng. Con số này định lượng mức độ quá tải: 41 job mỗi giây đang bị mất.
Và phép tính khớp một cách đẹp đẽ, chứng minh số liệu thật: năng lực xử lý đo được 78.6 job/s (sát lý thuyết 4 worker × 20 job/s = 80), cộng với 41.4 job/s bị từ chối, bằng đúng 120 job/s mình nạp vào. Không con số nào bịa — chúng cân bằng theo định luật bảo toàn.
Thông điệp: utilization trả lời "có bận không", saturation trả lời "quá tải bao nhiêu". Để chẩn đoán một tài nguyên, bạn cần cả ba — và saturation thường là cái báo động trước, khi utilization đã chạm trần và mất khả năng phân biệt.
USE và RED bổ sung nhau thế nào
RED (bài trước) đo service từ góc người dùng: request có nhanh và đúng không. USE đo tài nguyên từ góc hệ thống: tài nguyên có đang nghẽn không. Chúng ăn khớp: khi RED cho thấy độ trễ tăng (triệu chứng ở biên), USE chỉ ra tài nguyên nào đang bão hoà gây ra điều đó (nguyên nhân bên trong). Trong demo này, nếu đặt một service lên trước pool, RED sẽ thấy duration tăng vọt và errors tăng — còn USE cho biết chính xác vì sao: pool saturation = đầy. RED phát hiện, USE định vị. Một hệ thống quan sát tốt có cả hai tầng.
Đánh đổi cần cân nhắc
Saturation khó đo hơn utilization. Utilization thường có sẵn (CPU%, mem%). Saturation cần đo thứ đang chờ — run queue length của OS, độ sâu connection pool, backlog của socket — và nhiều hệ thống không phơi bày nó mặc định. Với tài nguyên tự quản (như pool ở đây), bạn phải chủ động instrument độ dài hàng đợi. Chính vì khó đo mà saturation hay bị bỏ qua, dù nó là tín hiệu giá trị nhất.
Utilization trung bình che giấu đỉnh ngắn. U=100% đo trên 1 phút có thể là 100% liên tục, hoặc trung bình của các đợt bùng 100% xen kẽ nhàn rỗi. Với tài nguyên, đỉnh ngắn mới gây rớt request (một burst 50ms lấp đầy hàng đợi là đủ). Nên saturation nên nhìn cả max_over_time, không chỉ trung bình — như demo cho thấy đỉnh 20/20 là lúc rejection xảy ra.
Không phải tài nguyên nào cũng có đủ ba. Một số tài nguyên không có khái niệm "saturation" rõ ràng, số khác không có "errors". USE là khung gợi ý câu hỏi ("tài nguyên này saturation đo bằng gì?"), không phải công thức cứng. Nếu một chiều không áp dụng, bỏ qua nó — đừng bịa ra một metric vô nghĩa chỉ để lấp đủ ba chữ cái.
Ba ý mang về
- Utilization bão hoà ở 100% nên mơ hồ: đo thật U=100% khi pool quá tải — nhưng con số này giống hệt dù nạp 85 hay 1000 job/s, nó không cho biết mức độ thiếu hụt.
- Saturation là tín hiệu thật của quá tải: đo thật hàng đợi 18.9/20 (đỉnh 20/20) và 41.4 job/s bị từ chối định lượng chính xác service đang chết ngạt thế nào; phép tính khớp (78.6 xử lý + 41.4 rớt = 120 nạp) chứng minh số liệu thật.
- USE cho tài nguyên, RED cho service, dùng cả hai: RED phát hiện triệu chứng ở biên, USE định vị tài nguyên nghẽn bên trong; saturation khó đo nên hay bị bỏ qua dù giá trị nhất, và nên nhìn cả đỉnh chứ không chỉ trung bình.
Nguồn
- Brendan Gregg — The USE Method: https://www.brendangregg.com/usemethod.html
- Brendan Gregg — USE Method: Linux Performance Checklist: https://www.brendangregg.com/USEmethod/use-linux.html
- Google SRE Book — Monitoring Distributed Systems: https://sre.google/sre-book/monitoring-distributed-systems/
Phần sau ta đối mặt kẻ giết chết Prometheus: cardinality. Đo thật một metric với nhãn cardinality cao làm số chuỗi thời gian nổ ra sao, và vì sao một nhãn vô hại như user id có thể hạ gục cả hệ thống giám sát.
