Trong các bài trước, nhãn (label) là công cụ mạnh nhất: tách rate theo route, tỉ lệ lỗi theo status, độ trễ theo endpoint. Nên phản xạ tự nhiên là gắn thêm nhãn cho mọi thứ — "cứ thêm user_id vào, sau này lọc theo user tiện". Đó chính xác là câu nói trước khi Prometheus sập. Mỗi tổ hợp nhãn tạo một chuỗi thời gian riêng, và số chuỗi — gọi là cardinality — là tài nguyên khan hiếm nhất của Prometheus. Một nhãn chọn sai có thể biến một metric đơn thành hàng triệu chuỗi, ăn hết RAM và giết cả hệ thống giám sát đúng lúc bạn cần nó nhất. Bài này (phần 7 loạt Observability) đo thật cú nổ cardinality để thấy cơ chế và cái giá.
Cardinality là gì và vì sao nó chết người
Prometheus lưu mỗi tổ hợp nhãn duy nhất như một chuỗi thời gian độc lập trong bộ nhớ. Cardinality của một metric = tích số lượng giá trị phân biệt của mọi nhãn:
http_requests_total{route}với 3 route → 3 chuỗi.http_requests_total{route, status}với 3 route × 5 status → 15 chuỗi.http_requests_total{route, status, user_id}với 3 × 5 × 1.000.000 user → 15 triệu chuỗi.
Phép nhân là kẻ giết người. Mỗi chuỗi tốn RAM (Prometheus giữ metadata + chunk gần nhất của mọi chuỗi trong "head" nằm hoàn toàn trong bộ nhớ), nên cardinality cao làm Prometheus phình RAM tuyến tính theo số chuỗi — tới lúc OOM và bị kernel giết. Và điều trớ trêu: hệ thống giám sát thường sập trong sự cố, khi lưu lượng (và cardinality động) tăng vọt — đúng lúc bạn cần nó.
Nhãn an toàn là nhãn có tập giá trị hữu hạn, nhỏ, biết trước (route, status, method, region). Nhãn nguy hiểm là nhãn có giá trị không giới hạn: user id, request id, email, full URL có tham số, timestamp, địa chỉ IP.
// TỐT: route chỉ vài giá trị → ít chuỗi
var good = promauto.NewCounterVec(prometheus.CounterOpts{
    Name: "good_requests_total"}, []string{"route"})      // 3 route → 3 chuỗi
// XẤU: user_id duy nhất mỗi request → nổ
var bad = promauto.NewCounterVec(prometheus.CounterOpts{
    Name: "bad_requests_total"}, []string{"user_id"})     // 10000 user → 10000 chuỗi!

uid := fmt.Sprintf("%d", i%10000)
bad.WithLabelValues(uid).Inc()   // mỗi user_id mới = một chuỗi mới
good.WithLabelValues(route).Inc()
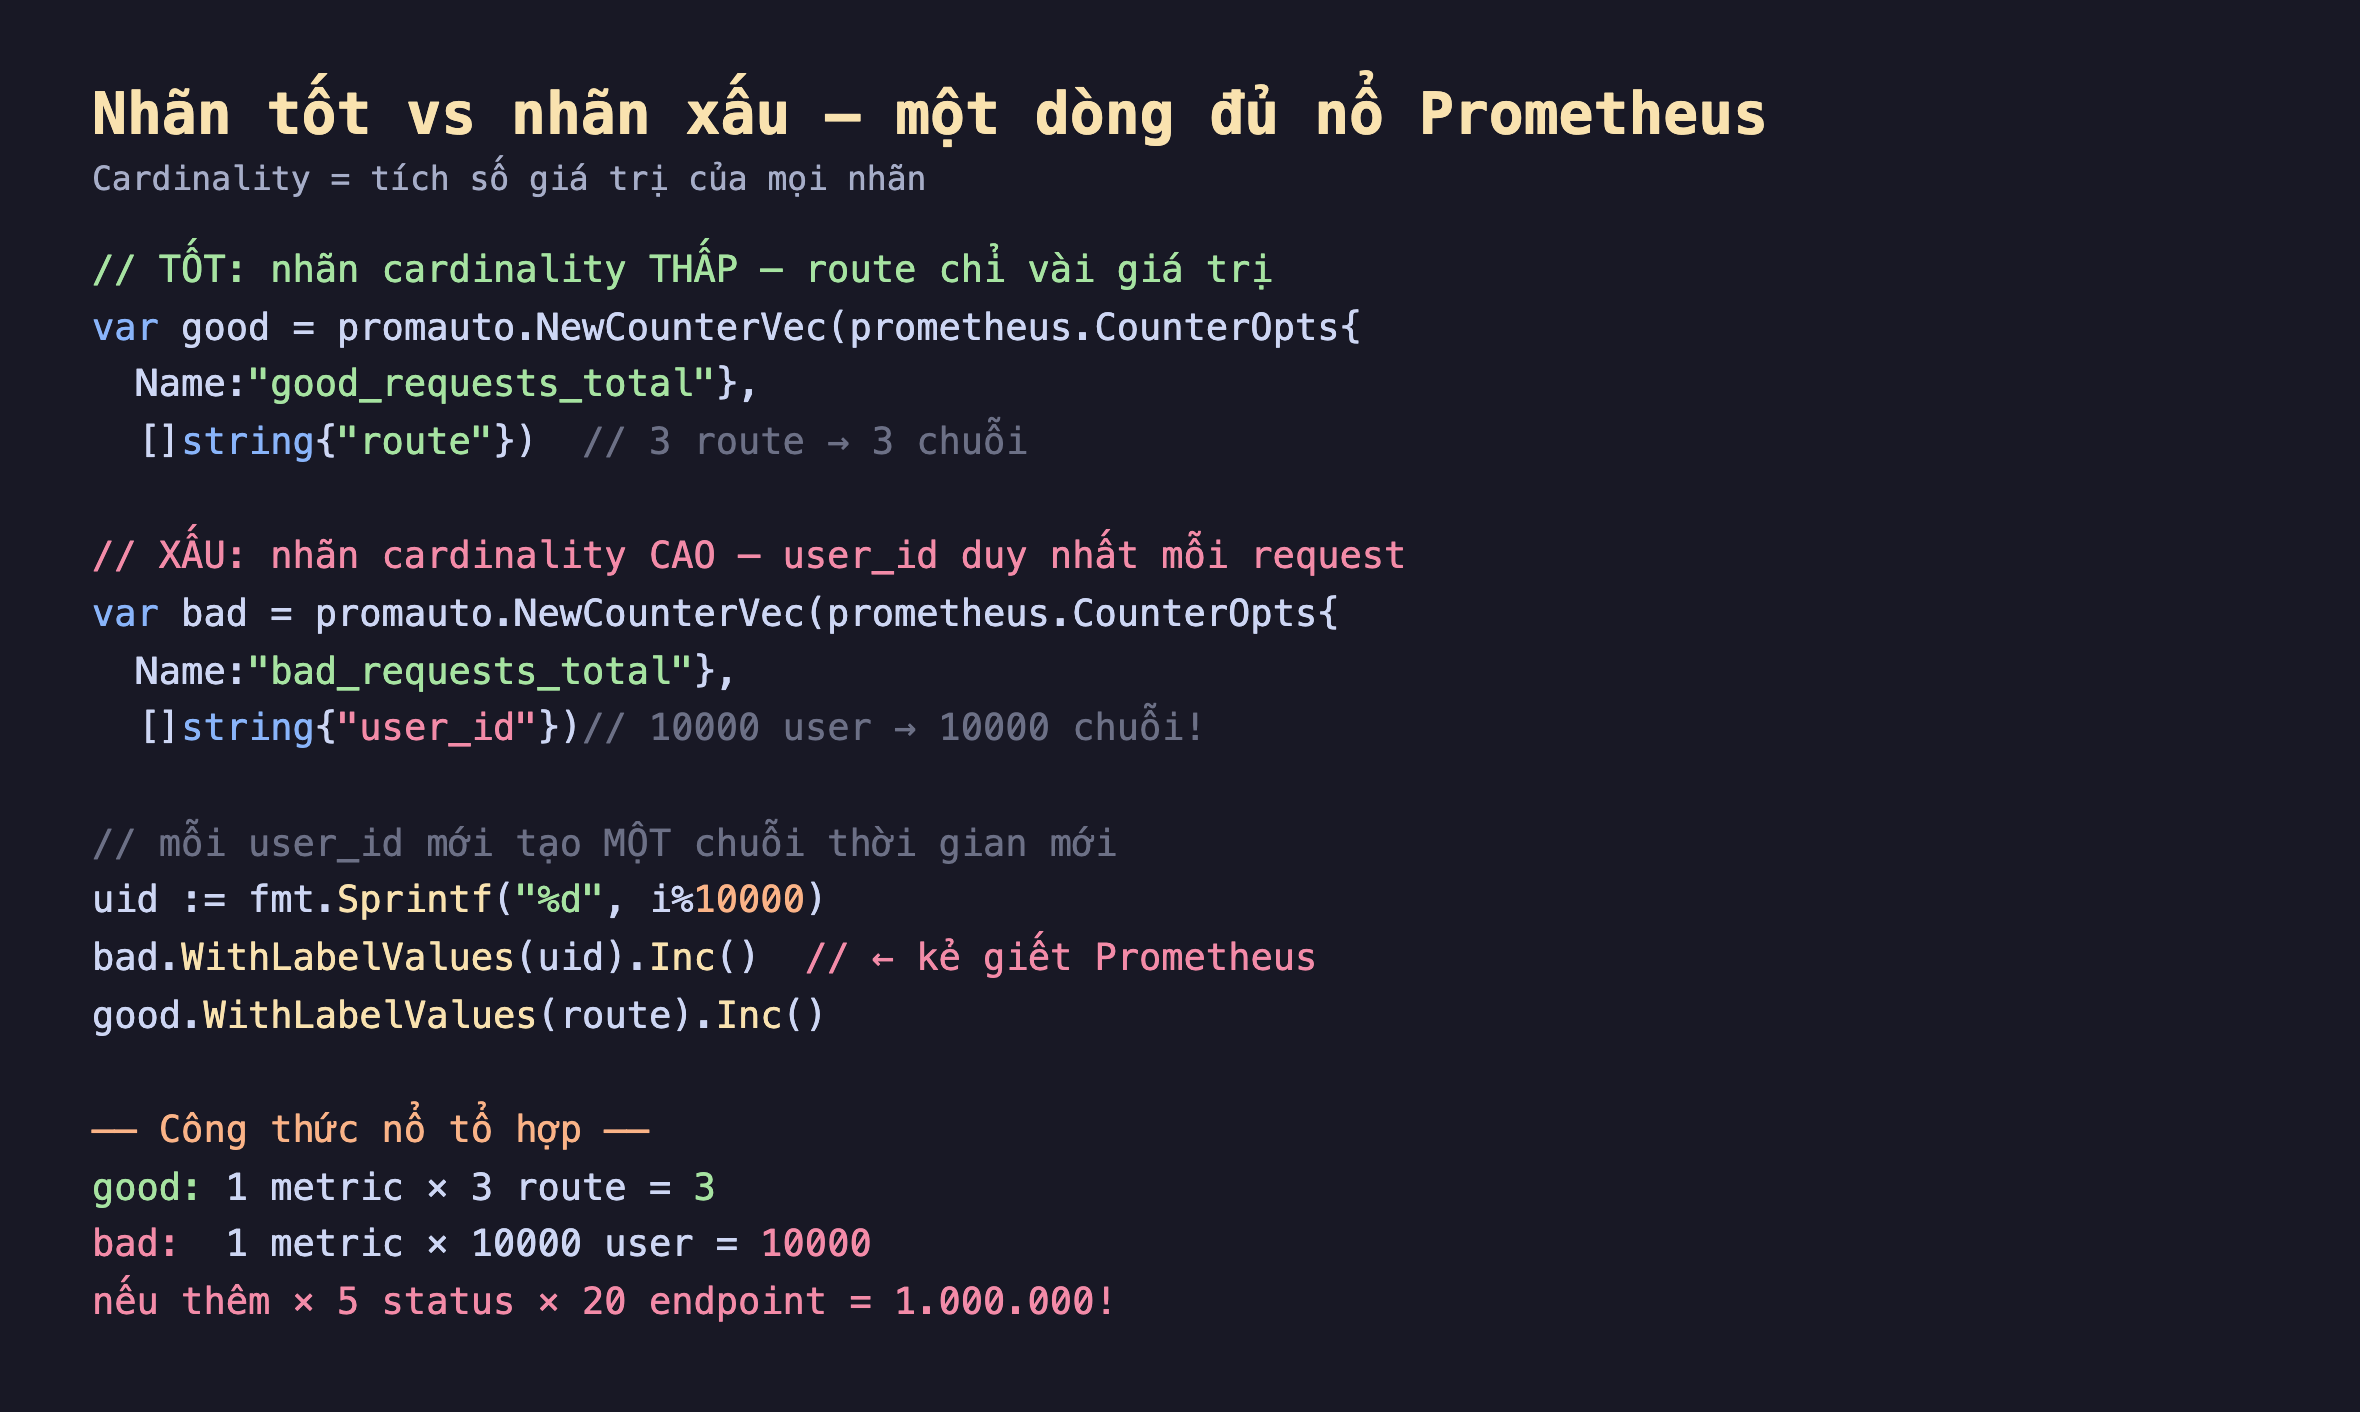
Hình 1: Hai metric cùng một app — good_requests_total{route} cardinality thấp, bad_requests_total{user_id} cardinality cao. Mỗi user_id mới tạo một chuỗi mới. Công thức nổ tổ hợp: cardinality là tích số giá trị của mọi nhãn, nên thêm vài nhãn vô hạn là nhân lên hàng triệu.
Đo thật: một nhãn, 10000 chuỗi, Prometheus phình 14 lần
Mình chạy app tạo 10000 user_id duy nhất, obs-prom scrape, rồi đếm số chuỗi thực tế mỗi metric sinh ra và tác động lên toàn hệ thống:
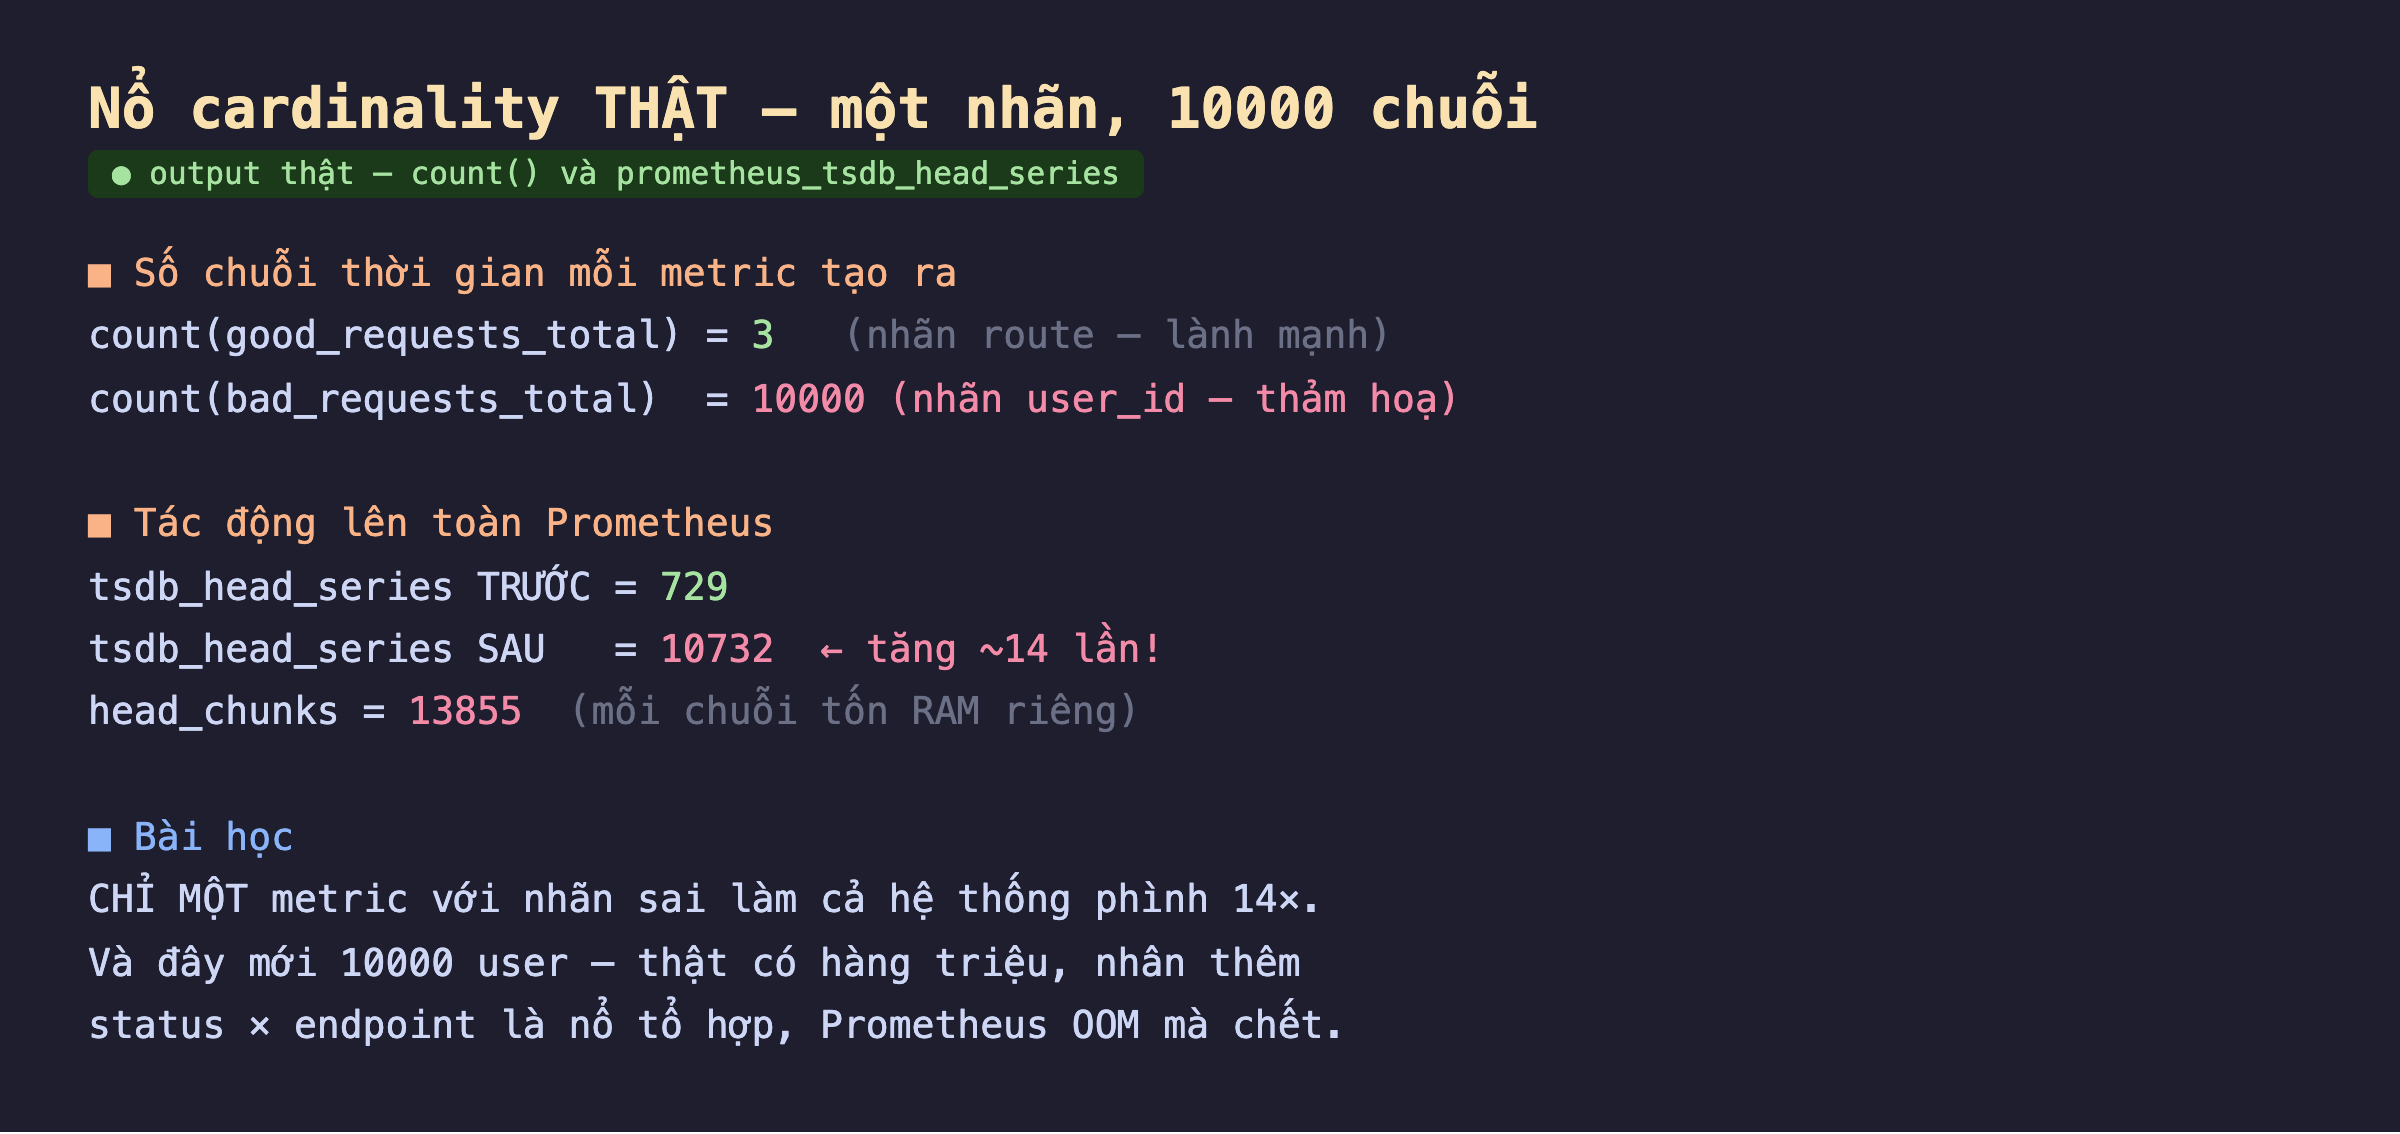
Hình 2: Kết quả thật. count(good_requests_total)=3, count(bad_requests_total)=10000 — cùng một app, hai metric, chênh nhau hơn 3000 lần chỉ vì chọn nhãn. Tổng prometheus_tsdb_head_series nhảy từ 729 lên 10732 (~14 lần) — một metric sai nuốt trọn hệ thống.
Đọc kết quả:
count(good_requests_total)= 3. Nhãnroutecó 3 giá trị, nên dù phục vụ hàng triệu request, metric này vẫn chỉ 3 chuỗi. Rẻ, bền, dùng mãi được.count(bad_requests_total)= 10000. Nhãnuser_idcó 10000 giá trị phân biệt → đúng 10000 chuỗi. Cùng số request như metric kia, nhưng tốn gấp hơn 3000 lần tài nguyên lưu trữ.prometheus_tsdb_head_series: 729 → 10732. Đây mới là điều đáng sợ. Trước khi chạy app, cả Prometheus có 729 chuỗi (metric nội bộ + các metric khác). Sau khi scrape metricbad, tổng nhảy lên 10732 — tăng ~14 lần. Một metric với một nhãn sai làm phình toàn bộ hệ thống giám sát.
Và phải nói thẳng về quy mô: 10000 ở đây là con số demo nhỏ, Prometheus xử lý thoải mái. Nhưng nó cho thấy cơ chế. Thực tế một app có hàng triệu user; gắn user_id làm nhãn là hàng triệu chuỗi ngay. Tệ hơn, nếu nhãn đó đi cùng các nhãn khác (user_id × endpoint 20 × status 5), cardinality là tích — 100 triệu chuỗi từ một metric. Ở quy mô đó Prometheus ăn hàng chục GB RAM rồi OOM. Cú nổ không tuyến tính, nó là tổ hợp.
Dấu hiệu nhận biết và cách phòng
Nhãn nguy hiểm gần như luôn là thứ nhận dạng một thực thể riêng lẻ thay vì phân loại. Quy tắc nhanh: nếu tập giá trị của nhãn tăng theo lưu lượng hoặc theo thời gian, nó sai. route cố định (dù lưu lượng tăng, vẫn 3 route); user_id tăng mãi. Những thủ phạm kinh điển: id (user/order/request), email, URL đầy đủ (/user/12345/orders/67890), timestamp, IP, user-agent.
Cách sửa: chuẩn hoá về mẫu. Thay vì /user/12345 đặt nhãn /user/{id} (một giá trị). Thay vì ghi user_id làm nhãn metric, đưa nó vào log hoặc trace (bài sau) — nơi dữ liệu cardinality cao thuộc về. Metric là để tổng hợp, không phải để tra cứu từng cá thể; nhầm vai trò này là gốc rễ của mọi cú nổ cardinality.
Đánh đổi cần cân nhắc
Mất chi tiết là cái giá chấp nhận được. Bỏ user_id khỏi metric nghĩa là không thể hỏi "user X gặp bao nhiêu lỗi" bằng PromQL. Nhưng đó không phải việc của metric — đó là việc của log/trace. Metric trả lời "tỉ lệ lỗi toàn hệ thống là bao nhiêu", và nó làm việc đó với cardinality nhỏ. Chọn đúng công cụ cho đúng câu hỏi: tổng hợp → metric, cá thể → log/trace.
Cardinality ẩn trong nhãn tưởng an toàn. status_code nghe an toàn (vài giá trị) — nhưng nếu app vô tình phát ra mã lỗi tuỳ biến từ exception message thì nó bùng. version an toàn — trừ khi mỗi lần deploy tạo một giá trị và bạn giữ lịch sử. Luôn đo cardinality thực tế (count by (__name__)({__name__=~".+"}) hoặc topk trên count by), đừng chỉ đoán. Nhiều cú nổ đến từ nhãn người ta nghĩ là hữu hạn.
Giới hạn phòng thủ ở nhiều tầng. Prometheus có sample_limit per scrape (từ chối target vượt ngưỡng chuỗi) và cảnh báo trên scrape_series_added. Dùng chúng như lưới an toàn: thà mất metric của một target lỗi còn hơn để nó kéo sập cả Prometheus. Nhưng lưới chỉ là phương án cuối — kỷ luật đặt nhãn ngay từ code mới là gốc.
Ba ý mang về
- Cardinality là tích số giá trị mọi nhãn: đo thật metric nhãn
routetạo 3 chuỗi, metric nhãnuser_idtạo 10000 — cùng app, cùng số request, chênh hơn 3000 lần chỉ vì chọn nhãn; thêm nhãn vô hạn là nhân lên tổ hợp. - Một nhãn sai làm phình cả hệ thống: đo thật tổng
tsdb_head_seriesnhảy 729→10732 (~14 lần) chỉ vì một metric; ở quy mô thật (triệu user × endpoint × status) đây là trăm triệu chuỗi và Prometheus OOM mà chết. - Metric để tổng hợp, không để nhận dạng cá thể: nếu tập giá trị nhãn tăng theo lưu lượng/thời gian thì nó sai — chuẩn hoá về mẫu (
/user/{id}), đẩy dữ liệu cardinality cao (user_id, request_id) sang log/trace, và đo cardinality thực tế thay vì đoán.
Nguồn
- Prometheus docs — Naming and labels best practices: https://prometheus.io/docs/practices/naming/
- Prometheus docs — Cardinality & instrumentation: https://prometheus.io/docs/practices/instrumentation/#do-not-overuse-labels
- Grafana — Control Prometheus metrics cardinality: https://grafana.com/blog/2022/02/15/what-are-cardinality-spikes-and-why-do-they-matter/
Phần sau ta rời thế giới metric sang distributed tracing: dựng thật một trace đi qua nhiều service với OpenTelemetry và Jaeger, để thấy chính xác request chậm ở span nào — thứ mà metric tổng hợp không bao giờ chỉ ra được.
