Metric cho bạn biết service chậm: "checkout p99 = 127ms". Nhưng 127 mili-giây đó tiêu vào đâu? Validate giỏ hàng? Query database? Gọi cổng thanh toán? Một request duyệt qua năm, mười bước — và metric tổng hợp không thể nói bước nào là thủ phạm. Tệ hơn, trong hệ phân tán một request đi qua nhiều service, mỗi service lại có metric riêng, và ghép chúng lại để lần theo một request cụ thể là bất khả thi với chỉ metric. Đây chính là khoảng trống mà distributed tracing lấp: nó theo dõi một request đi xuyên toàn hệ thống, chia thành các span (đoạn công việc) có quan hệ cha–con, mỗi span biết chính xác nó bắt đầu khi nào và kéo dài bao lâu. Bài này (phần 8 loạt Observability) dựng thật tracing với OpenTelemetry và Jaeger để thấy đúng span nào ngốn thời gian.
Span, trace và context propagation
Ba khái niệm cốt lõi:
- Span — một đơn vị công việc có tên, thời điểm bắt đầu, thời lượng, và thuộc tính (ví dụ câu SQL). "queryDB" là một span.
- Trace — tập hợp mọi span của một request, nối với nhau thành cây cha–con. Một trace = hành trình đầy đủ của một request.
- Context propagation — cơ chế mang
traceIDvàspanIDcha đi theo lời gọi (quacontext.Contexttrong Go, qua HTTP header giữa các service), để span con biết nó thuộc trace nào và cha là ai.
Điểm then chốt trong OpenTelemetry Go: context.Context mang trace đi. Khi bạn tr.Start(ctx, ...), span mới lấy span hiện tại trong ctx làm cha, rồi trả về ctx mới chứa chính nó. Truyền đúng ctx là có cây span đúng:
// Exporter OTLP HTTP → obs-jaeger:4318
exp, _ := otlptracehttp.New(ctx,
    otlptracehttp.WithEndpoint("obs-jaeger:4318"),
    otlptracehttp.WithInsecure())
res, _ := resource.New(ctx, resource.WithAttributes(
    semconv.ServiceName("checkout-svc")))
tp := sdktrace.NewTracerProvider(
    sdktrace.WithBatcher(exp), sdktrace.WithResource(res))

// Span lồng nhau — ctx truyền xuống mang quan hệ cha-con
ctx, root := tr.Start(ctx, "POST /checkout")
_, s1 := tr.Start(ctx, "validateCart"); s1.End()
ctxDB, s2 := tr.Start(ctx, "queryDB")        // con của root
    _, s2b := tr.Start(ctxDB, "cacheGet"); s2b.End()  // con của queryDB
s2.End()
_, s3 := tr.Start(ctx, "callPaymentGateway"); s3.End()
root.End()
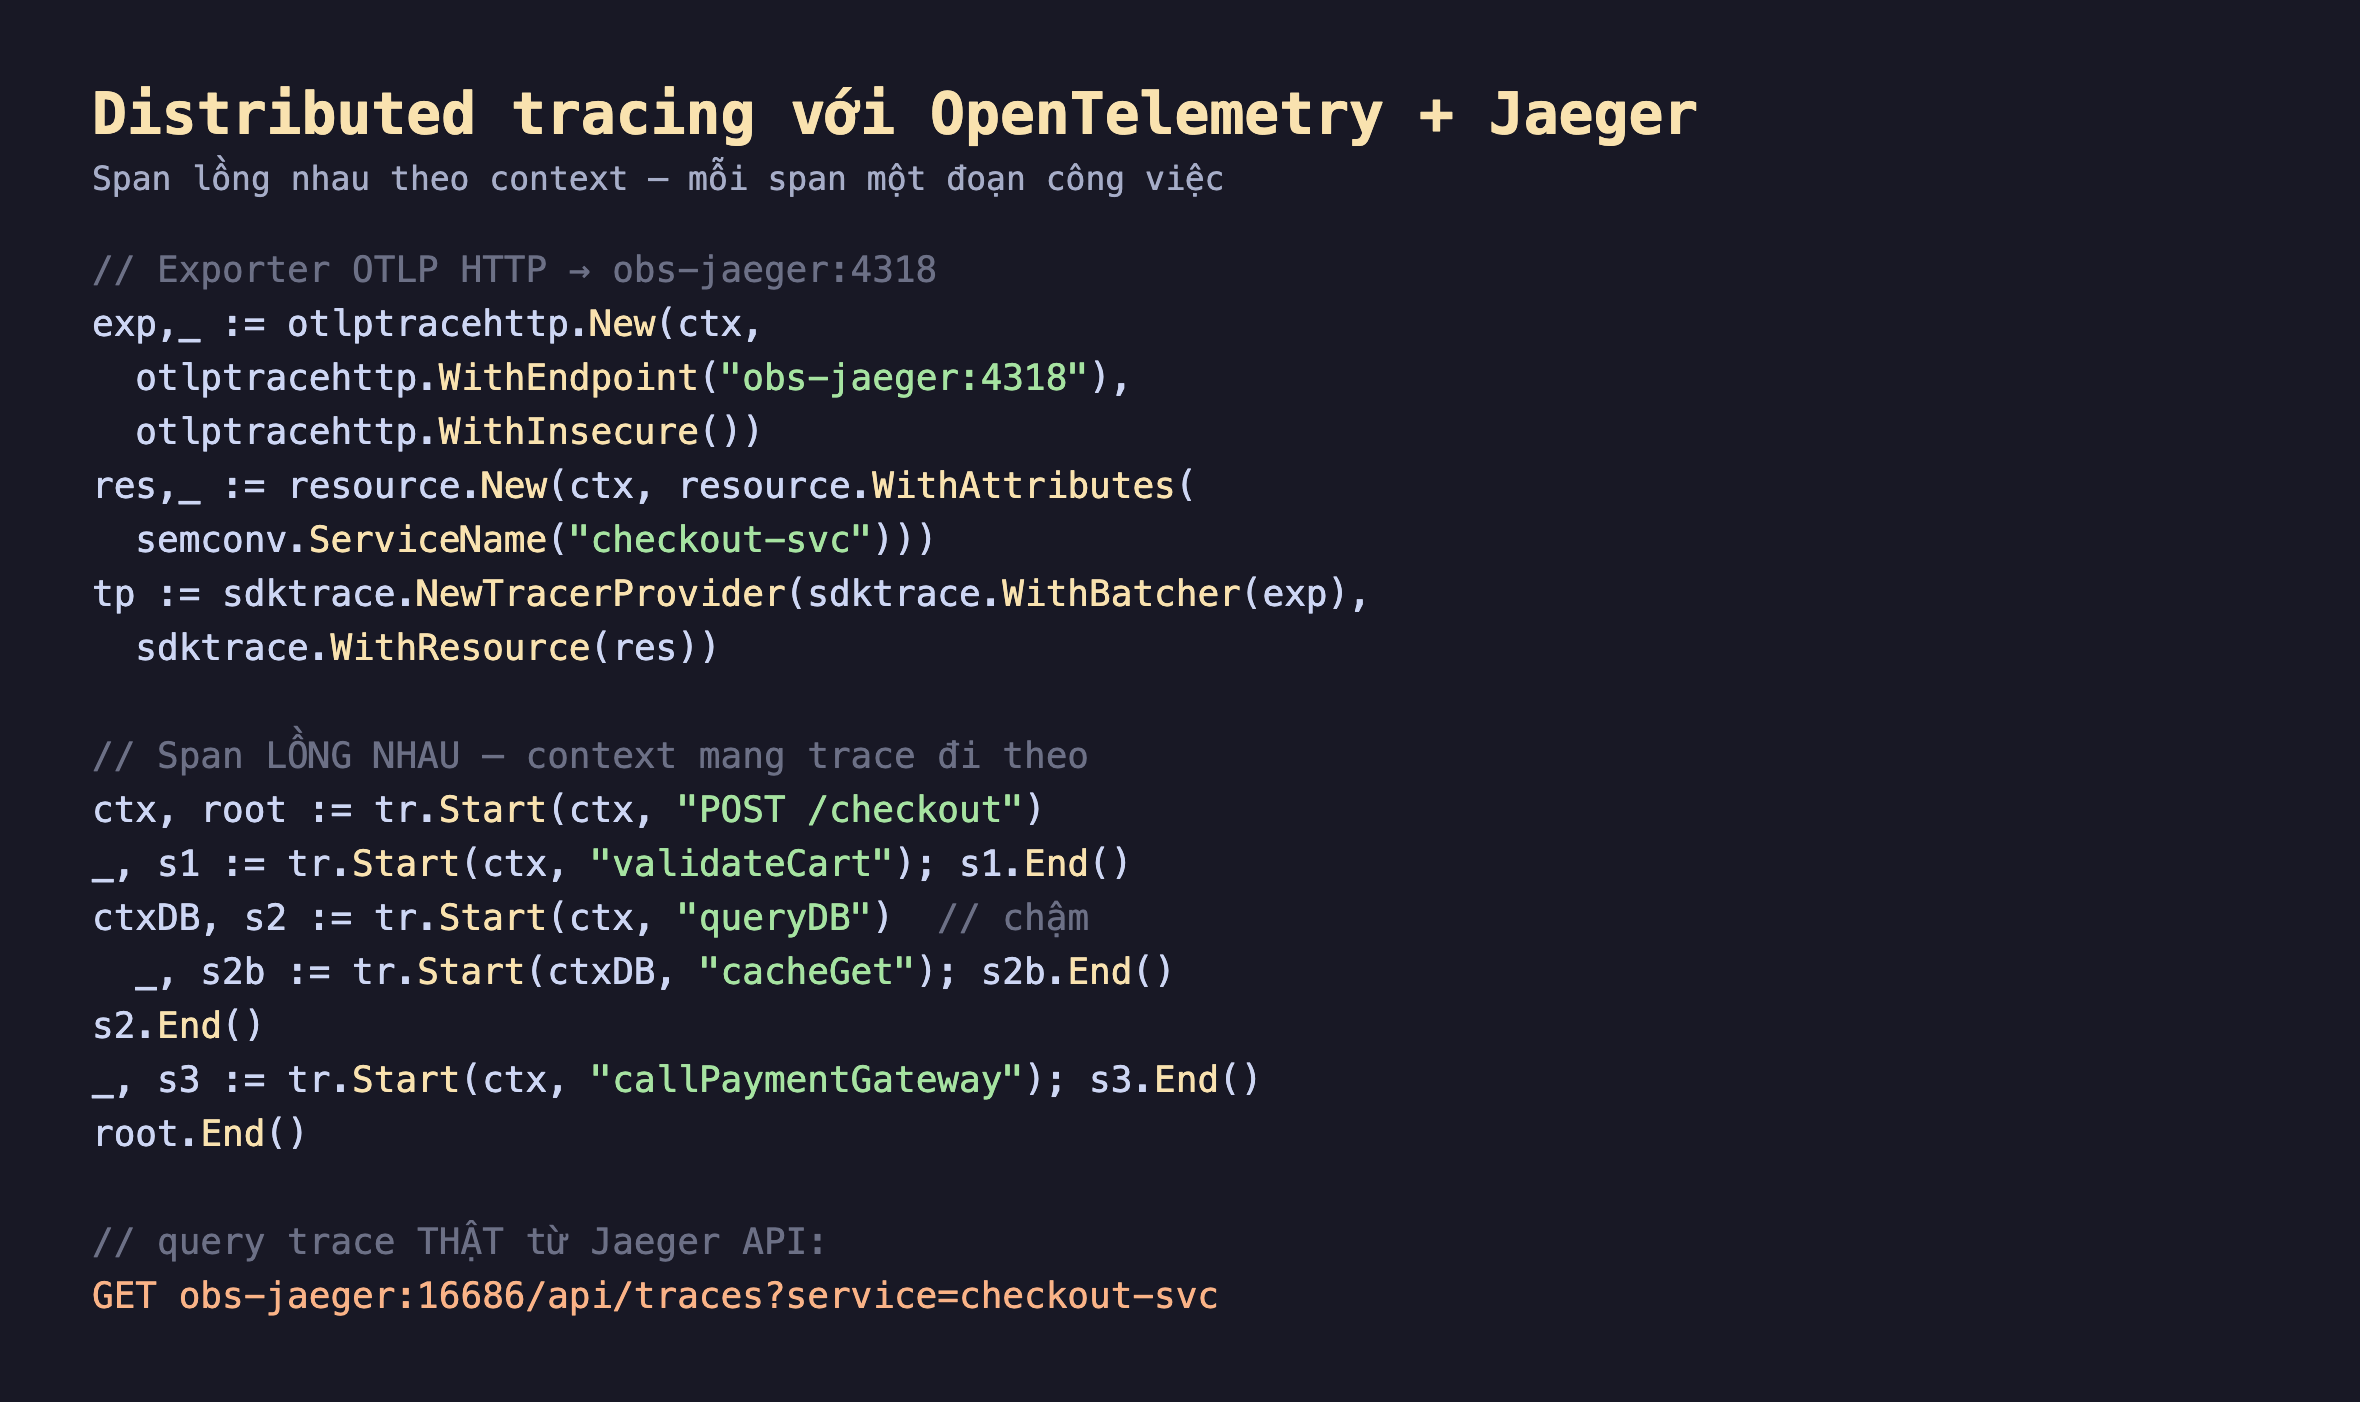
Hình 1: Dựng tracing với OpenTelemetry Go và exporter OTLP HTTP sang Jaeger. context.Context mang trace đi: validateCart, queryDB, callPaymentGateway nhận ctx của root nên là con của root; cacheGet nhận ctxDB nên là con của queryDB. Truyền đúng ctx quyết định cây span đúng.
Đo thật: query trace từ Jaeger và thấy thủ phạm
Mình chạy app export 5 trace sang obs-jaeger, rồi query Jaeger API thật (/api/traces?service=checkout-svc) để lấy một trace đầy đủ, dựng lại cây span từ các tham chiếu CHILD_OF:
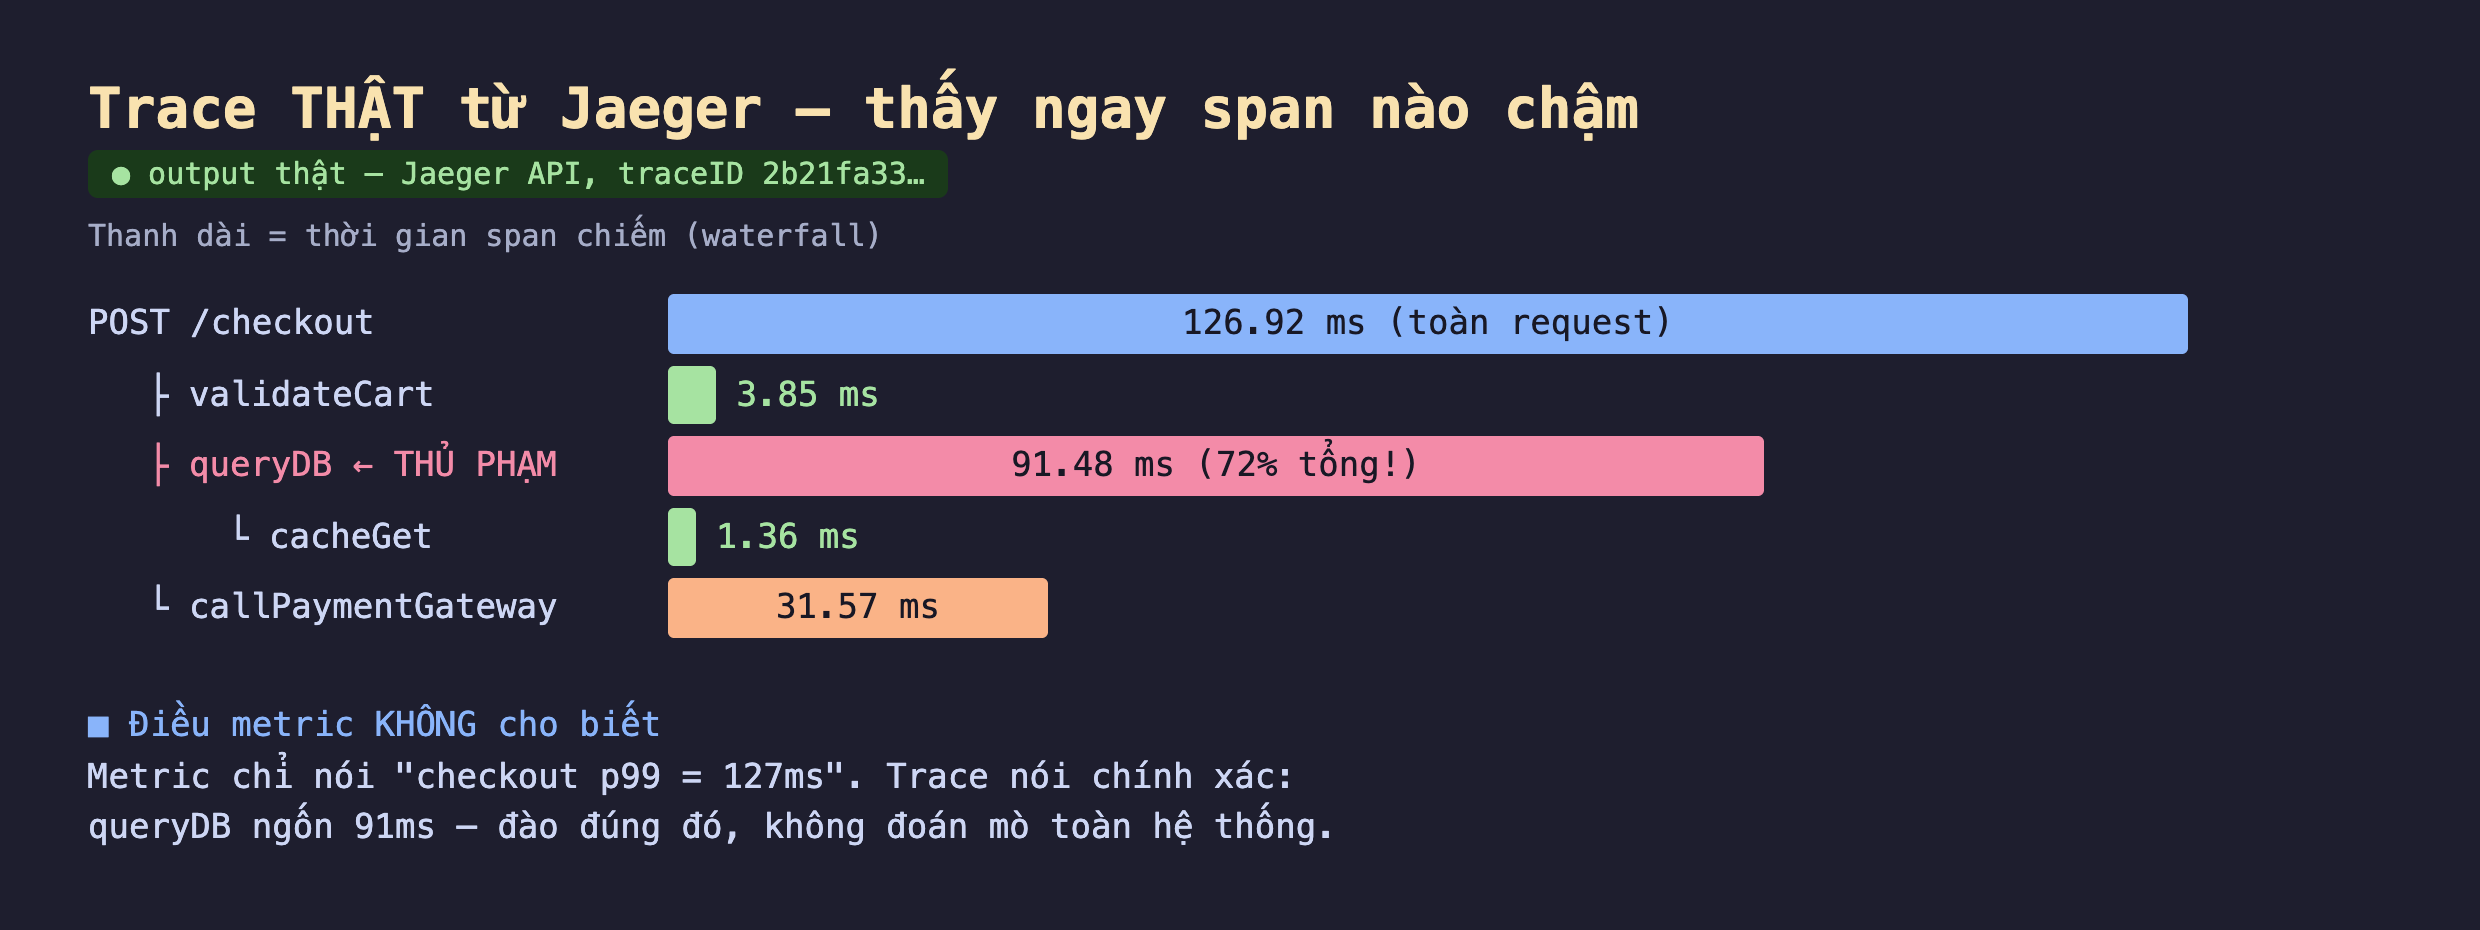
Hình 2: Trace thật (traceID 2b21fa33…) dựng dạng waterfall. POST /checkout tổng 126.92ms; bên trong, queryDB ngốn 91.48ms (72% toàn request) — thủ phạm rõ ràng; validateCart chỉ 3.85ms, callPaymentGateway 31.57ms, và cacheGet (1.36ms) nằm lồng trong queryDB. Metric chỉ nói "127ms"; trace chỉ đúng chỗ.
Đọc trace:
POST /checkout= 126.92ms — span gốc, bao trùm toàn request. Đây là con số duy nhất mà metric độ trễ nhìn thấy.queryDB= 91.48ms — đây là giá trị của trace. Nó chiếm 72% toàn bộ thời gian request. Nếu chỉ có metric, bạn biết checkout chậm nhưng phải đoán nguyên nhân (DB? payment? app logic?) và đi đo từng cái. Trace trả lời ngay: đào vào query DB.validateCart= 3.85ms,callPaymentGateway= 31.57ms — các bước khác nhanh hoặc vừa. Trace cho bạn phân bổ thời gian giữa các bước, thứ metric không có.cacheGet= 1.36ms nằm trongqueryDB— quan hệ cha–con hiện rõ nhờ context propagation. Bạn thấy không chỉ bước nào chậm mà cả cấu trúc gọi: cache lookup là một phần của bước query.
Thông điệp: metric nói "có vấn đề và ở service nào", trace nói "ở span nào trong request". Khi metric (hay RED ở bài trước) chỉ ra checkout chậm, trace là công cụ đưa bạn thẳng tới dòng code gây chậm — không phải mò mẫm.
Vì sao trace bổ sung chứ không thay metric
Trace mạnh ở chiều sâu một request, nhưng yếu ở tổng hợp. Bạn không thể nhìn một trace mà biết "tỉ lệ lỗi toàn hệ thống" hay "p99 trong 24h qua" — đó là việc của metric. Ngược lại metric không thể cho biết "request chậm này kẹt ở span nào". Chúng là hai lát cắt bù nhau: metric cho bức tranh tổng và cảnh báo (rẻ, luôn bật); trace cho chi tiết một request khi cần đào (đắt hơn, thường lấy mẫu). Quy trình điển hình: metric/alert báo động → nhìn RED biết service nào → mở trace của request chậm → thấy span thủ phạm → đọc log của span đó. Ba trụ cột làm việc cùng nhau.
Đánh đổi cần cân nhắc
Trace đắt — gần như luôn phải lấy mẫu (sampling). Ghi mọi span của mọi request tạo khối lượng dữ liệu khổng lồ (và chi phí lưu trữ). Production thường lấy mẫu: giữ 1% trace, hoặc "tail sampling" (chỉ giữ trace có lỗi/chậm). Ở đây mình export toàn bộ 5 trace vì là demo; thực tế phải cân nhắc tỉ lệ mẫu — quá thấp thì bỏ lỡ trace quan trọng, quá cao thì tốn kém. Đây là lý do metric vẫn là tầng luôn-bật còn trace là tầng đào sâu.
Context propagation xuyên service là phần khó nhất. Trong demo, mọi span cùng một process nên context.Context mang trace tự nhiên. Qua ranh giới service (HTTP, gRPC, message queue), phải tiêm trace context vào header ở phía gửi và trích ra ở phía nhận — nếu một service trong chuỗi không propagate, trace bị đứt và bạn mất phần hành trình sau đó. OpenTelemetry có middleware tự động cho HTTP/gRPC, nhưng với message queue hay code tự viết thì phải làm tay. Một mắt xích quên propagate là cả trace vô dụng.
Instrument thủ công tốn công, nhưng auto-instrument có giới hạn. Mình tạo span bằng tay (tr.Start) để kiểm soát tên và cấu trúc. OpenTelemetry có thư viện auto-instrument cho nhiều framework (bọc sẵn HTTP handler, DB driver), tiết kiệm công — nhưng chúng chỉ thấy ranh giới chúng biết; logic nghiệp vụ bên trong (như validateCart) vẫn cần span thủ công. Cân bằng: auto cho hạ tầng, thủ công cho các bước nghiệp vụ bạn thật sự muốn thấy.
Ba ý mang về
- Trace chỉ đúng span chậm, metric thì không: đo thật trace cho thấy trong
POST /checkout126.92ms, riêngqueryDBngốn 91.48ms (72%) — metric chỉ nói "127ms" còn trace đưa thẳng tới thủ phạm, không phải đoán. - Context propagation dựng nên cây span: đo thật
cacheGetnằm lồng trongqueryDBnhờ truyền đúngctx; quan hệ cha–con cho thấy cả bước nào chậm lẫn cấu trúc gọi — và qua ranh giới service phải tiêm/trích trace context thủ công, một mắt xích quên là đứt trace. - Trace bổ sung metric, không thay: metric cho tổng hợp và cảnh báo (luôn bật), trace cho chi tiết một request (đắt, phải lấy mẫu); quy trình là metric báo động → RED khoanh service → trace tìm span → log đọc chi tiết.
Nguồn
- OpenTelemetry — Traces / Go instrumentation: https://opentelemetry.io/docs/languages/go/
- Jaeger — Architecture & APIs: https://www.jaegertracing.io/docs/latest/apis/
- Google — Dapper, a Large-Scale Distributed Systems Tracing Infrastructure: https://research.google/pubs/pub36356/
Phần sau ta sang trụ cột thứ ba: structured logging — vì sao log dạng JSON có cấu trúc đánh bại log văn bản thuần, và cách gắn traceID vào log để nối thẳng log với trace vừa dựng.
