Mọi phần trước đều nhìn vào bên trong PostgreSQL. Phần này đứng trước cửa. Mỗi kết nối PostgreSQL là một tiến trình riêng: client thứ 101 với max_connections = 100 nhận FATAL, và một ứng dụng có hai trăm pod mỗi pod mười kết nối không thể nối thẳng vào cụm. PgBouncer giải bài toán đó bằng cách cho nhiều client dùng chung ít kết nối thật — và cách nó chia sẻ, đặc biệt ở transaction mode, làm gãy một danh sách tính năng mà ứng dụng vẫn tưởng mình có. Phần này đo cả hai mặt: pool mua được gì, với giá nào, và thứ gì không còn đúng khi đi qua nó.
Pool kết nối, và những gì gắn với "phiên"
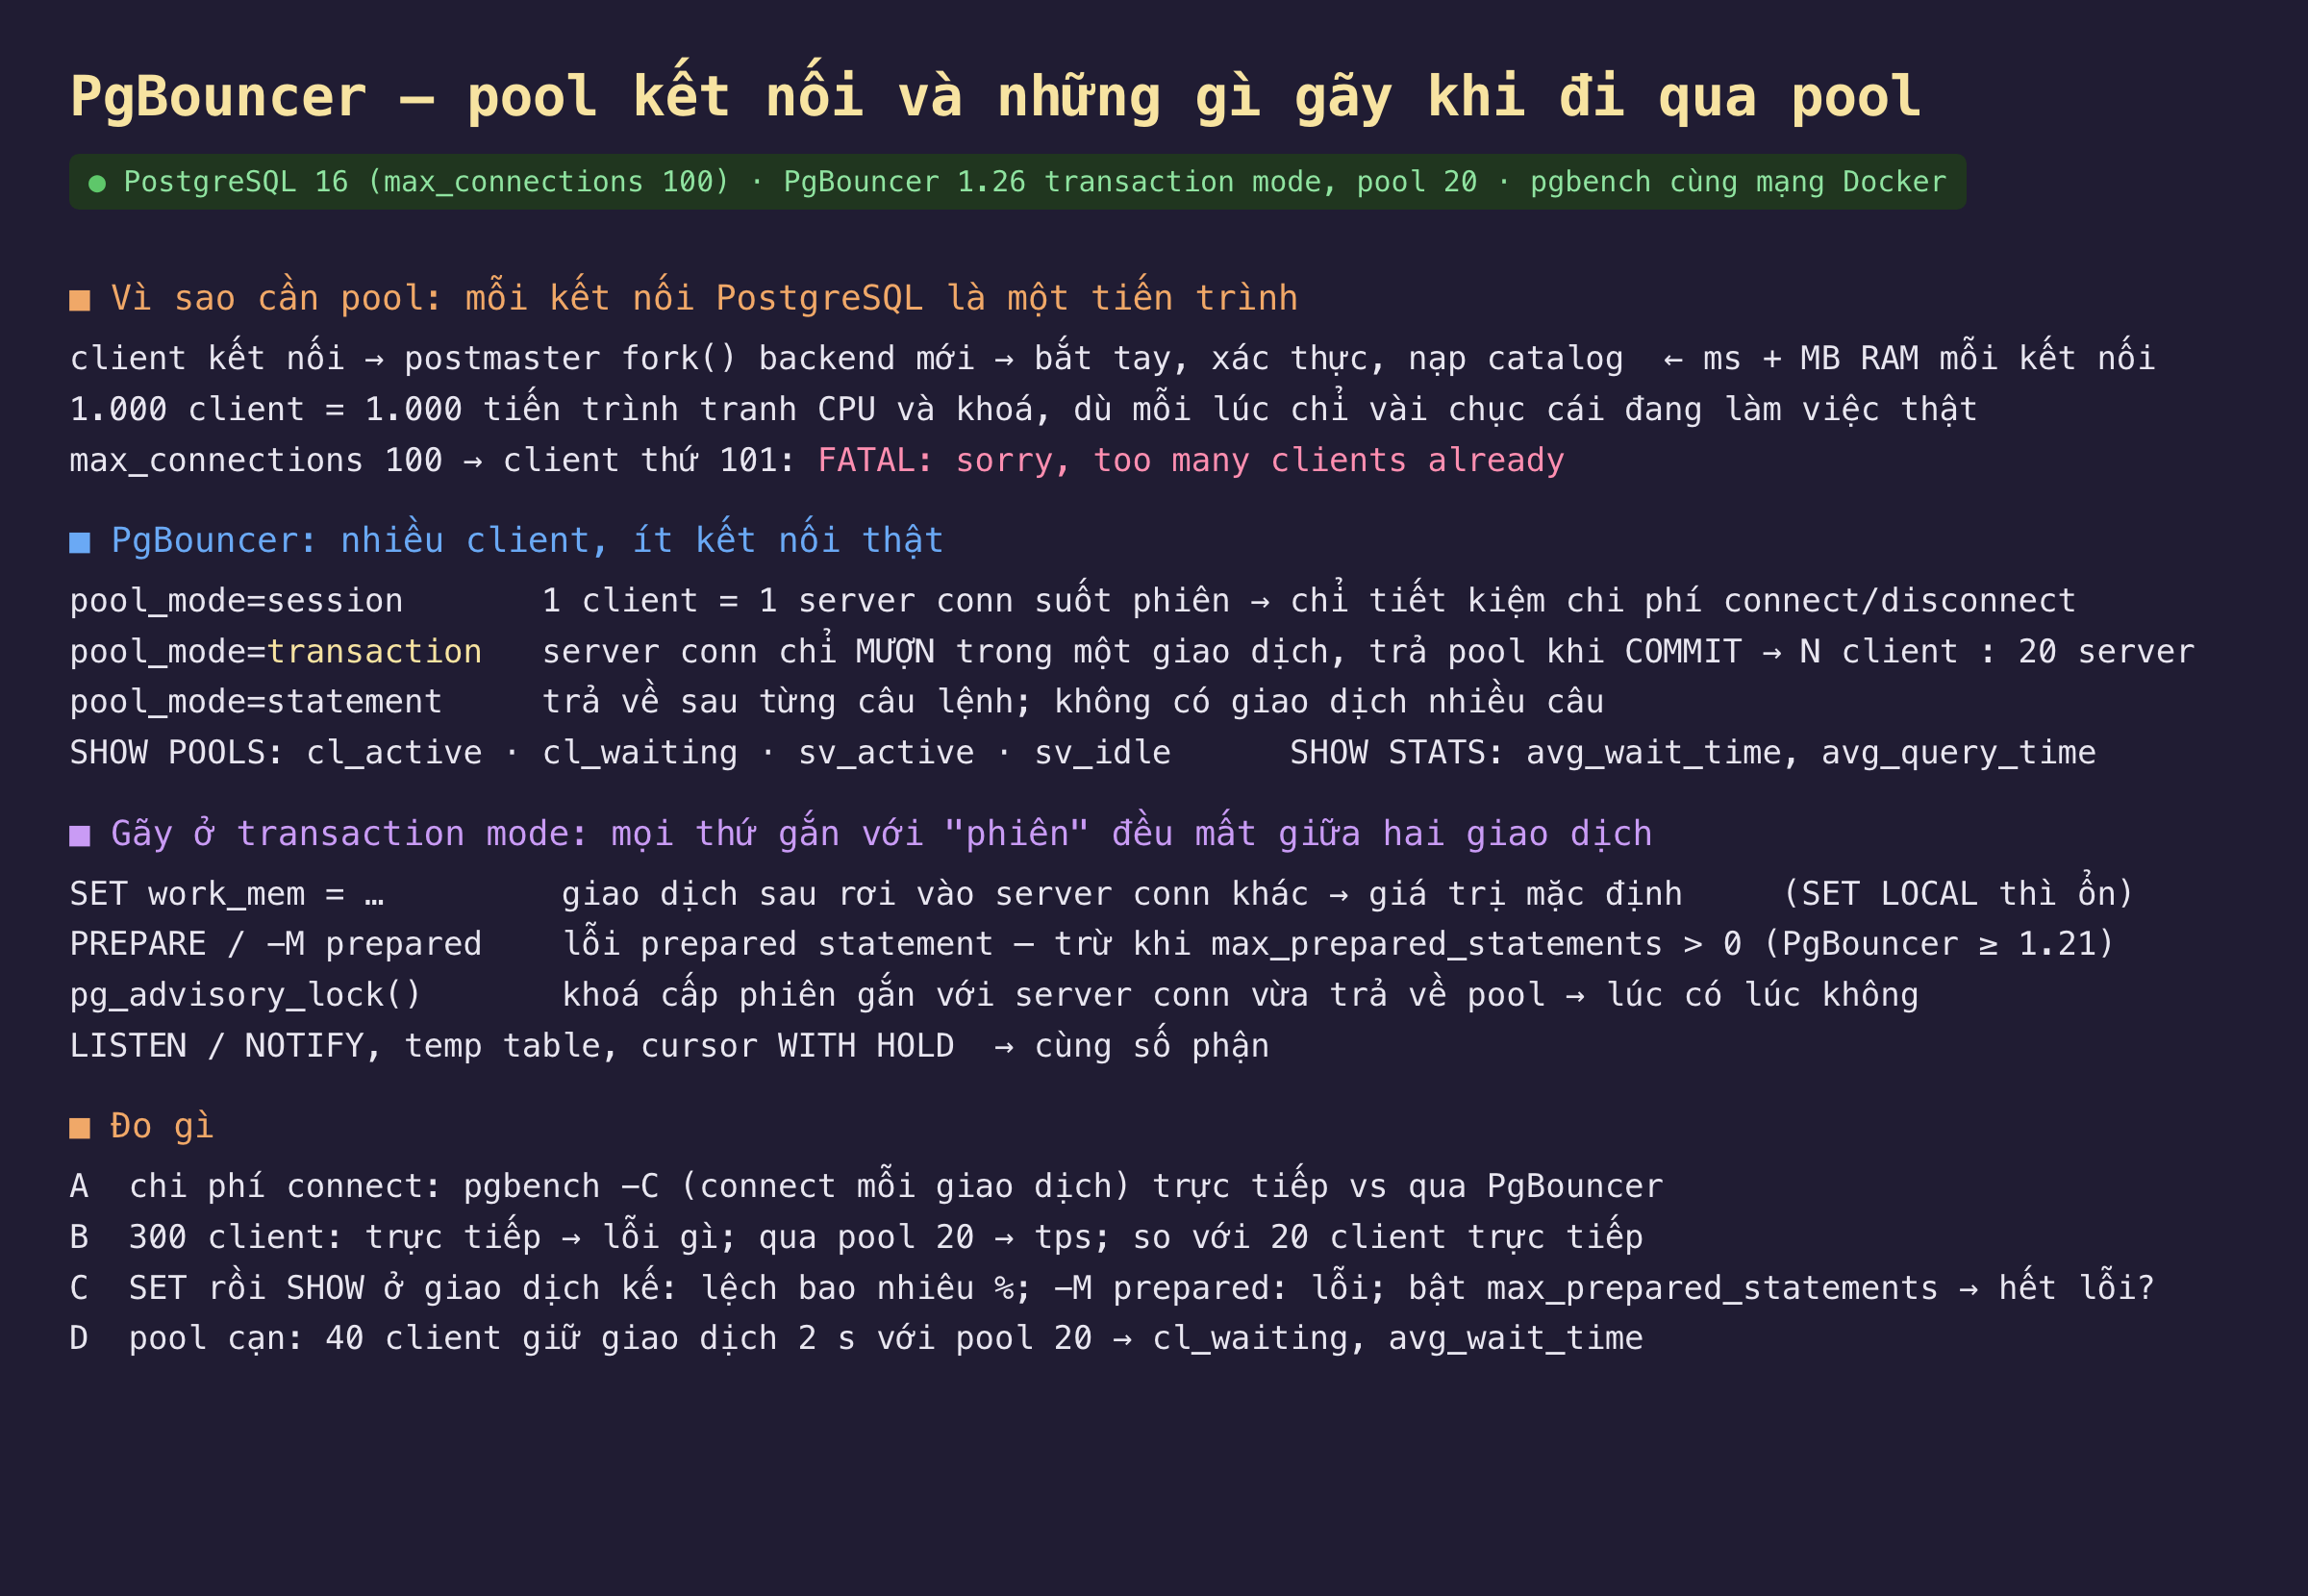
Hình 1: Mỗi kết nối là một tiến trình; PgBouncer cho N client mượn 20 kết nối thật theo từng giao dịch. Mọi thứ gắn với phiên không còn đúng giữa hai giao dịch.
Client nối vào PostgreSQL là postmaster fork() một backend mới: bắt tay, xác thực, nạp catalog — vài mili giây và vài MB RAM, rồi một tiến trình nữa tranh CPU và khoá dù phần lớn thời gian nó ngồi chờ ứng dụng. max_connections là trần cứng; vượt là FATAL: sorry, too many clients already.
PgBouncer đứng giữa và giữ một pool kết nối thật tới PostgreSQL. Ở session mode, mỗi client giữ một kết nối thật suốt phiên — chỉ tiết kiệm chi phí connect. Ở transaction mode, client chỉ mượn kết nối thật trong một giao dịch và trả về pool khi COMMIT; giữa hai giao dịch nó không giữ gì, nên N client có thể chạy trên 20 kết nối. SHOW POOLS cho thấy ai đang mượn (cl_active), ai đang chờ (cl_waiting), và pool còn gì (sv_idle).
Giá của transaction mode là mọi thứ gắn với phiên không còn đáng tin giữa hai giao dịch: SET biến phiên, prepared statement, advisory lock cấp phiên, LISTEN, temp table, cursor WITH HOLD. Giao dịch kế tiếp có thể rơi vào kết nối thật khác — hoặc tệ hơn, kết nối thật của bạn rơi vào tay người khác với trạng thái bạn để lại.
Môi trường đo: PgBouncer 1.26 (edoburu/pgbouncer) trên cùng mạng Docker với pg-prim, pool_mode = transaction, default_pool_size = 20, max_client_conn = 2000; pgbench -S (chỉ đọc, SELECT theo khoá chính) chạy từ container PostgreSQL, trỏ thẳng vào localhost hoặc vào PgBouncer.
Đo thật: mua được gì, trả giá gì, gãy ở đâu
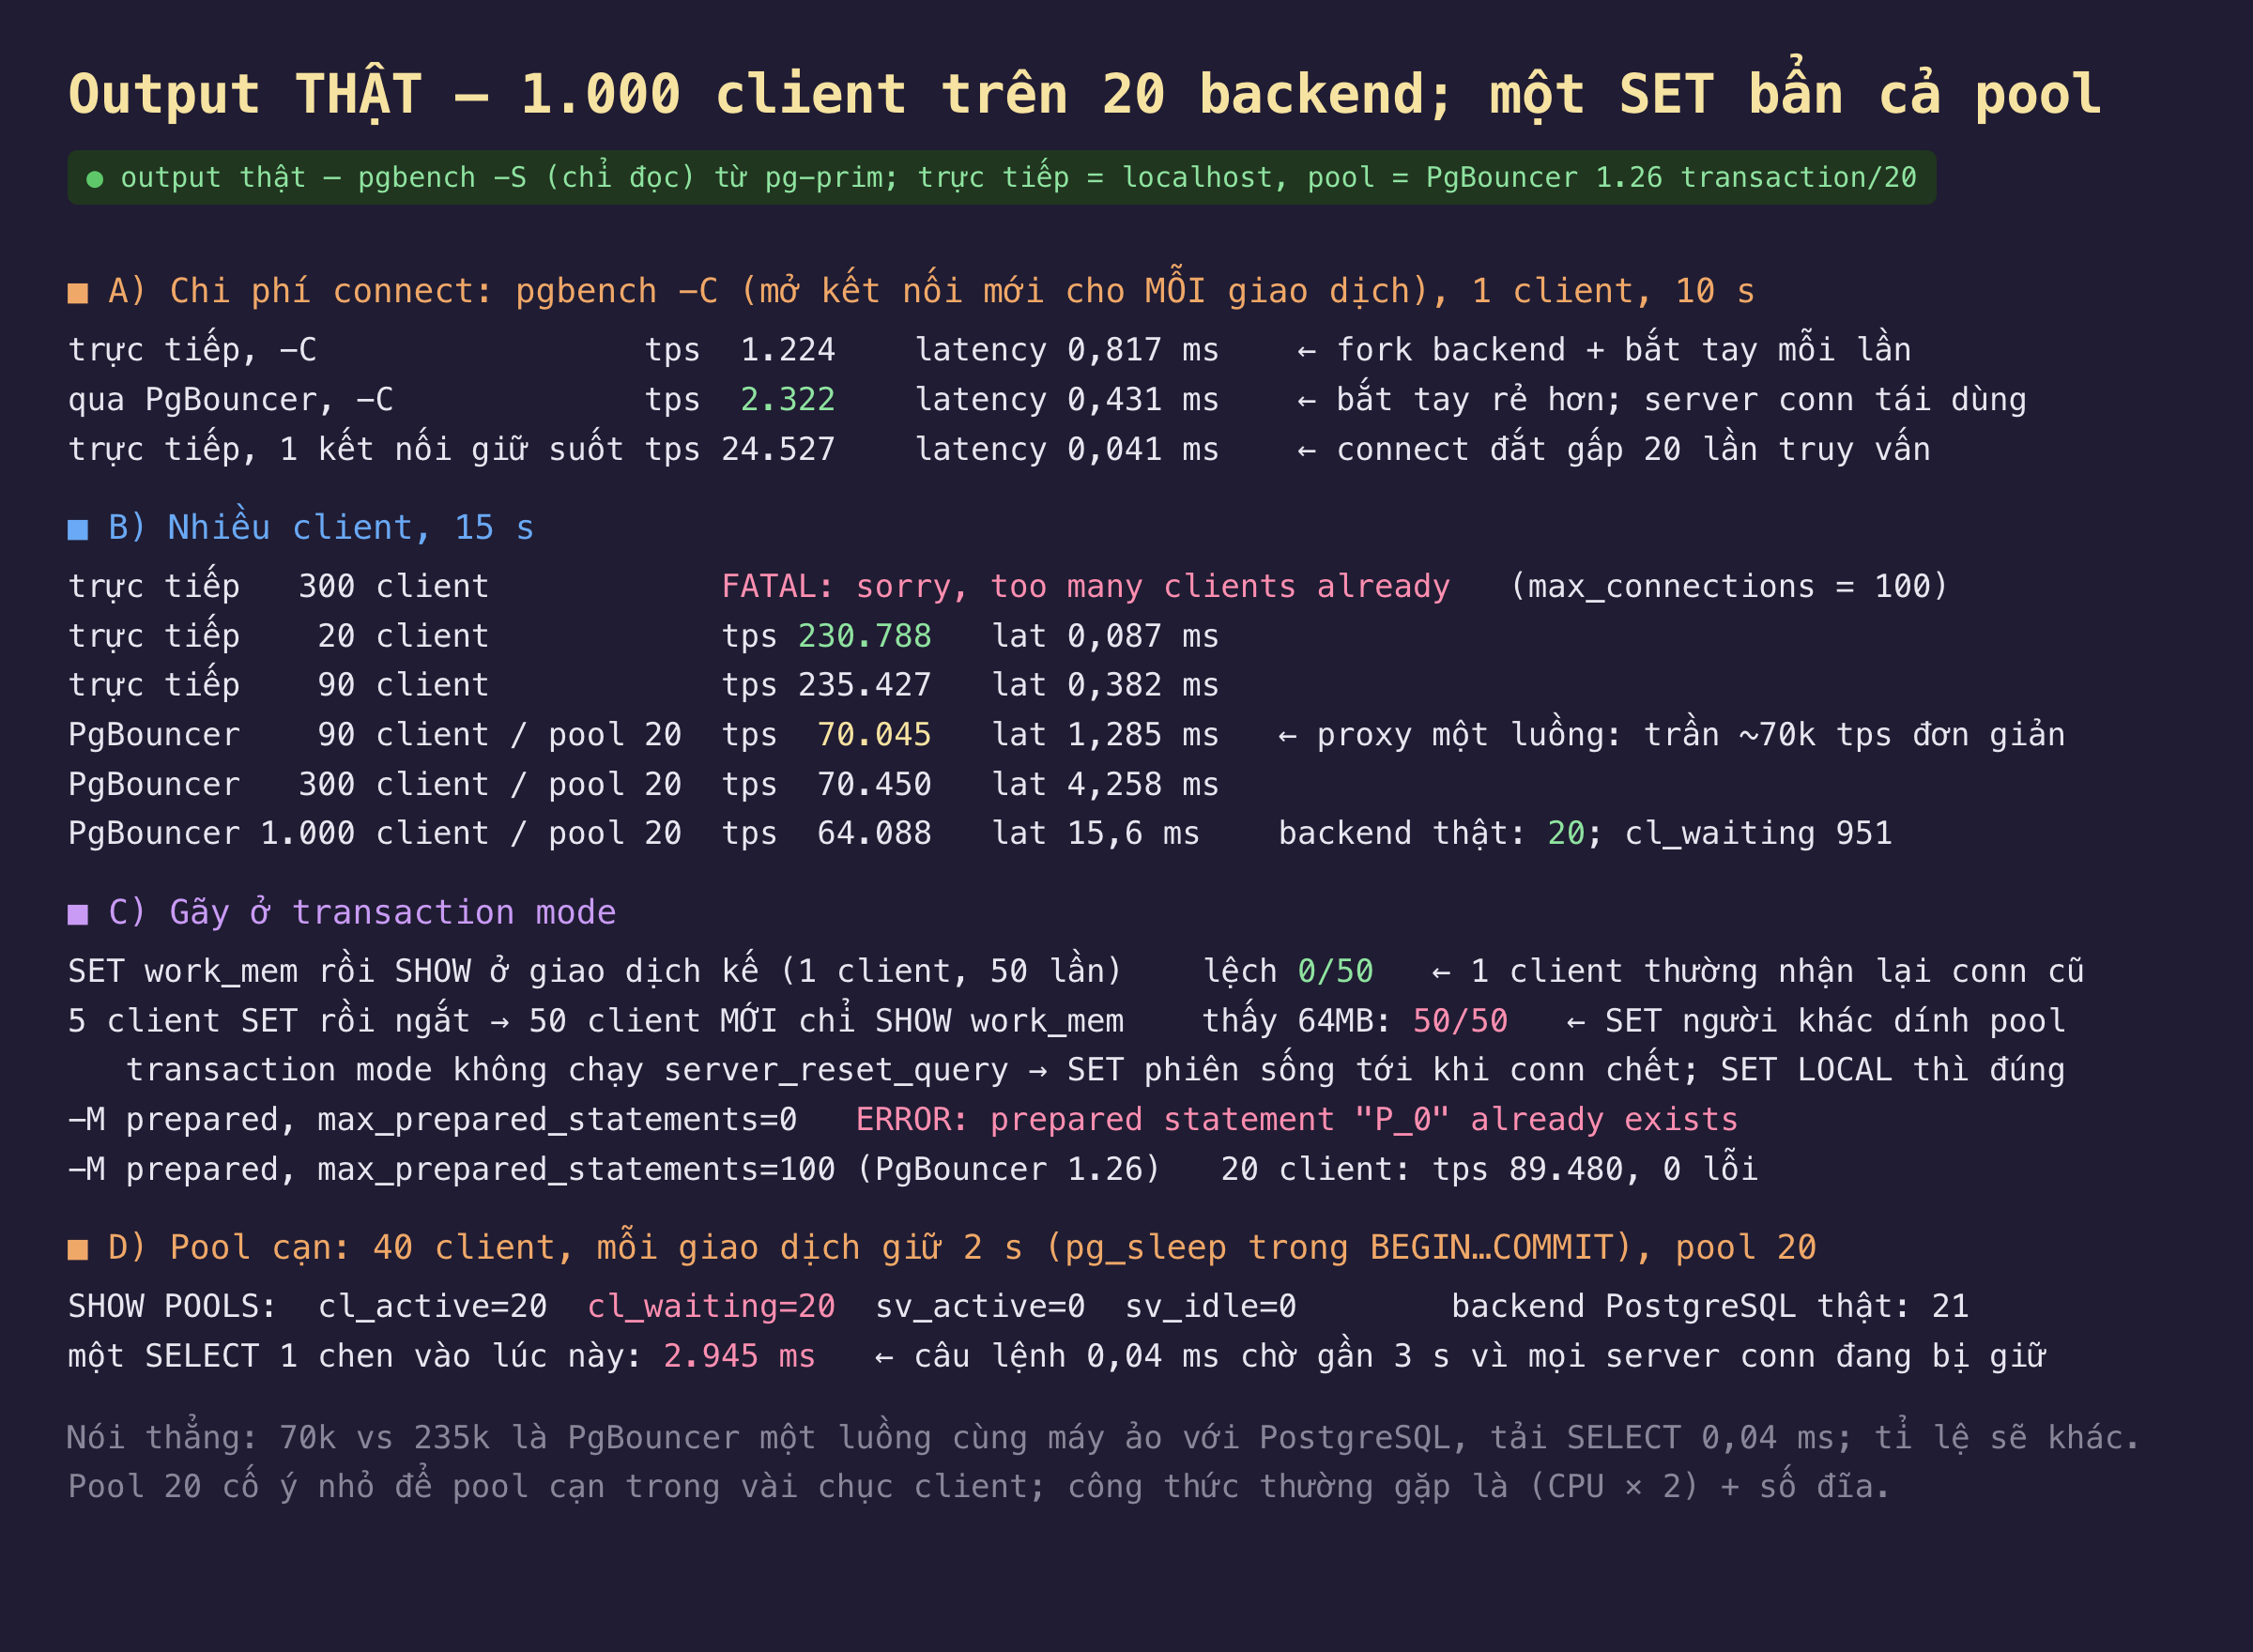
Hình 2: Pool cho 1.000 client chạy trên 20 backend và connect nhanh gấp đôi, nhưng proxy một luồng chạm trần 70k TPS. Một SET của một client dính vào pool cho 50 client sau.
| phép đo | kết quả |
|---|---|
| connect mỗi giao dịch (-C): trực tiếp / qua pool / 1 kết nối giữ suốt | 1.224 / 2.322 / 24.527 TPS |
| 300 client trực tiếp | FATAL: sorry, too many clients already |
| 20 / 90 client trực tiếp | 230.788 / 235.427 TPS |
| 90 / 300 / 1.000 client qua pool 20 | 70.045 / 70.450 / 64.088 TPS; 1.000 client = 20 backend, 951 chờ |
| SET rồi SHOW ở giao dịch kế, 1 client | lệch 0/50 |
| 5 client SET rồi ngắt → 50 client mới SHOW | 50/50 thấy 64MB |
-M prepared, max_prepared_statements 0 / 100 |
ERROR … already exists / 89.480 TPS, 0 lỗi |
| pool cạn (40 client giữ 2 s, pool 20): SELECT 1 chen vào | 2.945 ms, cl_waiting 20 |
Connect đắt gấp 20 lần truy vấn; pool mua lại một nửa. Cùng một SELECT theo khoá chính: một kết nối giữ suốt cho 24.527 TPS (0,041 ms); mở kết nối mới cho mỗi giao dịch (-C) rơi xuống 1.224 TPS (0,817 ms) — chi phí fork, bắt tay SCRAM và nạp catalog lớn gấp hai mươi lần truy vấn. Qua PgBouncer với -C: 2.322 TPS (0,431 ms) — client vẫn bắt tay, nhưng với PgBouncer (rẻ, không fork), còn kết nối thật tới PostgreSQL được tái dùng. Đây là lợi ích thứ nhất và ít ấn tượng nhất của pool: ứng dụng không có pool riêng (PHP, serverless, script) bớt một nửa chi phí connect.
300 client trực tiếp bị từ chối; 1.000 client qua pool chạy trên 20 backend. max_connections = 100: pgbench 300 client trực tiếp nhận FATAL: sorry, too many clients already ngay lập tức. Qua PgBouncer, 1.000 client chạy 15 giây ở 64.088 TPS với đúng 20 backend trên PostgreSQL (pg_stat_activity đếm 20 kết nối từ địa chỉ PgBouncer) và cl_waiting = 951 — 951 client xếp hàng mượn 20 kết nối, mỗi lượt vài chục micro giây. Đây là lợi ích thật của pool: số client không còn là số tiến trình, và PostgreSQL chạy với số backend mà nó chịu được thay vì số mà ứng dụng muốn mở.
Nhưng proxy một luồng có trần: 70.000 so với 235.000 TPS. 90 client trực tiếp: 235.427 TPS. Cùng 90 client qua PgBouncer: 70.045 — chưa bằng một phần ba, và không đổi khi lên 300 client (70.450); 1.000 client chỉ còn 64.088 với độ trễ 15,6 ms. PgBouncer là một tiến trình một luồng; mỗi byte đi qua nó hai lần. Với truy vấn 0,04 ms thì chính proxy là nút cổ chai — trên cùng máy ảo với PostgreSQL, như ở đây, càng rõ. Với truy vấn thật vài mili giây, trần này cao hơn nhiều lần so với nhu cầu; với tải toàn truy vấn tí hon, cần nhiều tiến trình PgBouncer (so_reuseport) hoặc pool trong ứng dụng. Con số đáng nhớ không phải 70k mà là: pool không làm truy vấn nhanh hơn, nó làm số kết nối nhỏ hơn.
SET không "lệch" cho người gọi — nó dính vào pool cho người khác. Thí nghiệm đầu: một client SET work_mem = '64MB' rồi SHOW ở giao dịch kế, 50 lần, lệch 0/50 — cả khi 15 client khác đang dùng pool. PgBouncer trả kết nối rảnh gần nhất, và với một client thì đó thường là kết nối vừa dùng; "lệch" khó xảy ra ở quy mô nhỏ. Thí nghiệm hai mới là bức tranh thật: 5 client SET rồi ngắt kết nối; 50 client mới, chỉ chạy SHOW work_mem, thấy 64MB ở 50/50 lượt. Transaction mode không chạy server_reset_query (chỉ session mode mới chạy DISCARD ALL), nên SET cấp phiên sống trong kết nối thật tới khi kết nối đó chết — và mọi client mượn nó sau đều thừa hưởng. Một SET statement_timeout, SET search_path, SET role của một dịch vụ là của tất cả. SET LOCAL trong BEGIN … COMMIT đo được đúng 64MB và hết hạn cùng giao dịch — đó là dạng duy nhất an toàn qua pool.
Prepared statement: lỗi, rồi hết lỗi với một tham số. pgbench -M prepared qua PgBouncer với max_prepared_statements = 0: ERROR: prepared statement "P_0" already exists — client chuẩn bị câu lệnh trên kết nối thật A, giao dịch sau rơi vào B không có nó, hoặc vào A đã có. PgBouncer 1.21+ theo dõi prepared statement theo client và tự chuẩn bị lại trên kết nối thật đang mượn: với max_prepared_statements = 100, 20 client -M prepared chạy 89.480 TPS, 0 lỗi. Trước 1.21 câu trả lời là "tắt prepared statement trong driver"; giờ là một dòng cấu hình.
Pool cạn: câu lệnh 0,04 ms chờ 2,9 giây. 40 client, mỗi giao dịch BEGIN; pg_sleep(2); COMMIT — mô phỏng giao dịch giữ kết nối lâu — với pool 20: cl_active = 20, cl_waiting = 20, sv_idle = 0. Một SELECT 1 chen vào mất 2.945 ms: không phải PostgreSQL chậm (21 backend, đều rảnh CPU), mà không còn kết nối thật nào để mượn. Pool biến "quá nhiều kết nối" thành "xếp hàng", và hàng đợi đó vô hình với PostgreSQL — pg_stat_activity thấy 21 backend bình thường trong khi 20 client đứng chờ ở PgBouncer. SHOW POOLS và cl_waiting là chỉ số phải vẽ lên bảng theo dõi; không có nó, sự cố hiện ra ở ứng dụng dưới dạng timeout không giải thích được.
Đánh đổi cần cân nhắc
Pool giải quyết số kết nối, không giải quyết thông lượng. 1.000 client trên 20 backend là thứ PostgreSQL không tự làm được; 70k thay vì 235k TPS là giá. Với tải thật (truy vấn vài ms, nhiều kết nối rảnh) giá đó gần như vô hình và lợi ích là quyết định; với tải toàn truy vấn tí hon trên ít kết nối, pool có thể là nút cổ chai duy nhất. Đo trên tải của bạn trước khi kết luận theo bất kỳ con số nào ở đây.
Transaction mode đổi tính năng lấy mật độ. Mọi thứ gắn với phiên — SET, prepared statement, advisory lock, LISTEN, temp table — hoặc gãy hoặc rò sang người khác. Quy ước: SET LOCAL thay SET, bật max_prepared_statements, không dùng advisory lock cấp phiên qua pool, và tách riêng một pool session mode cho vài thứ không bỏ được. Pool size cũng là một quyết định: 20 ở đây cố ý nhỏ để thấy pool cạn; công thức thường gặp là (CPU × 2) + số đĩa, rồi đo cl_waiting.
Phạm vi đo. PgBouncer chạy cùng máy ảo với PostgreSQL và pgbench nên tranh CPU với cả hai; trần 70k là của bố trí này. Tải -S là SELECT 0,04 ms, cực đoan có chủ ý để lộ chi phí proxy. Chưa chạm: auth_query thay vì userlist, nhiều PgBouncer với so_reuseport, và server_lifetime/server_idle_timeout để dọn kết nối bẩn theo thời gian.
Ba ý mang về
- Pool biến số client thành số backend bạn chọn: 1.000 client trên 20 backend trong khi 300 client trực tiếp bị từ chối; connect mỗi giao dịch nhanh gấp đôi. Nhưng nó là proxy một luồng: 70k so với 235k TPS truy vấn tí hon — pool không làm truy vấn nhanh hơn.
- Transaction mode không reset phiên: một
SETcủa một client dính vào kết nối thật và 50/50 client sau thừa hưởng. DùngSET LOCAL, bậtmax_prepared_statements, và coi mọi thứ cấp phiên là không tồn tại qua pool. - Pool cạn là hàng đợi vô hình với PostgreSQL:
SELECT 1chờ 2,9 giây trong khi 21 backend rảnh.cl_waitingtrongSHOW POOLSlà chỉ số theo dõi bắt buộc, và giao dịch giữ lâu là kẻ thù của pool nhỏ.
Nguồn
- PgBouncer — Configuration (
pool_mode,default_pool_size,max_prepared_statements,server_reset_query): https://www.pgbouncer.org/config.html - PgBouncer — Features và danh sách tính năng theo pool mode: https://www.pgbouncer.org/features.html
- PgBouncer — Usage,
SHOW POOLS/SHOW STATS: https://www.pgbouncer.org/usage.html - PostgreSQL 16 — Connections and Authentication,
max_connections: https://www.postgresql.org/docs/16/runtime-config-connection.html - PostgreSQL Wiki — Number Of Database Connections: https://wiki.postgresql.org/wiki/Number_Of_Database_Connections
Phần sau gom mười một phần thành một runbook: sao lưu gì và kiểm thử khôi phục bao lâu một lần, theo dõi chỉ số nào, thứ tự xử lý khi sự cố, và bảng số đo của cả sê-ri để đặt cạnh cụm của bạn.
