Mười một phần vừa rồi mỗi phần đo một thứ: cache nhanh hơn database bao nhiêu, cache-aside tiết kiệm được gì, TTL đổi độ mới lấy tải, eviction đá nhầm key nào, stampede lớn cỡ nào và chặn nó ra sao, thứ tự invalidation, write-back đánh đổi gì, hit ratio nói dối ở đâu, hot key, và cache phân tầng.
Phần cuối này gom tất cả vào một hàm đọc duy nhất, rồi đo nó cạnh bản ngây thơ dưới cùng một lưu lượng — để xem mười một bài học cộng lại đáng bao nhiêu.
Một hàm, mười một bài học
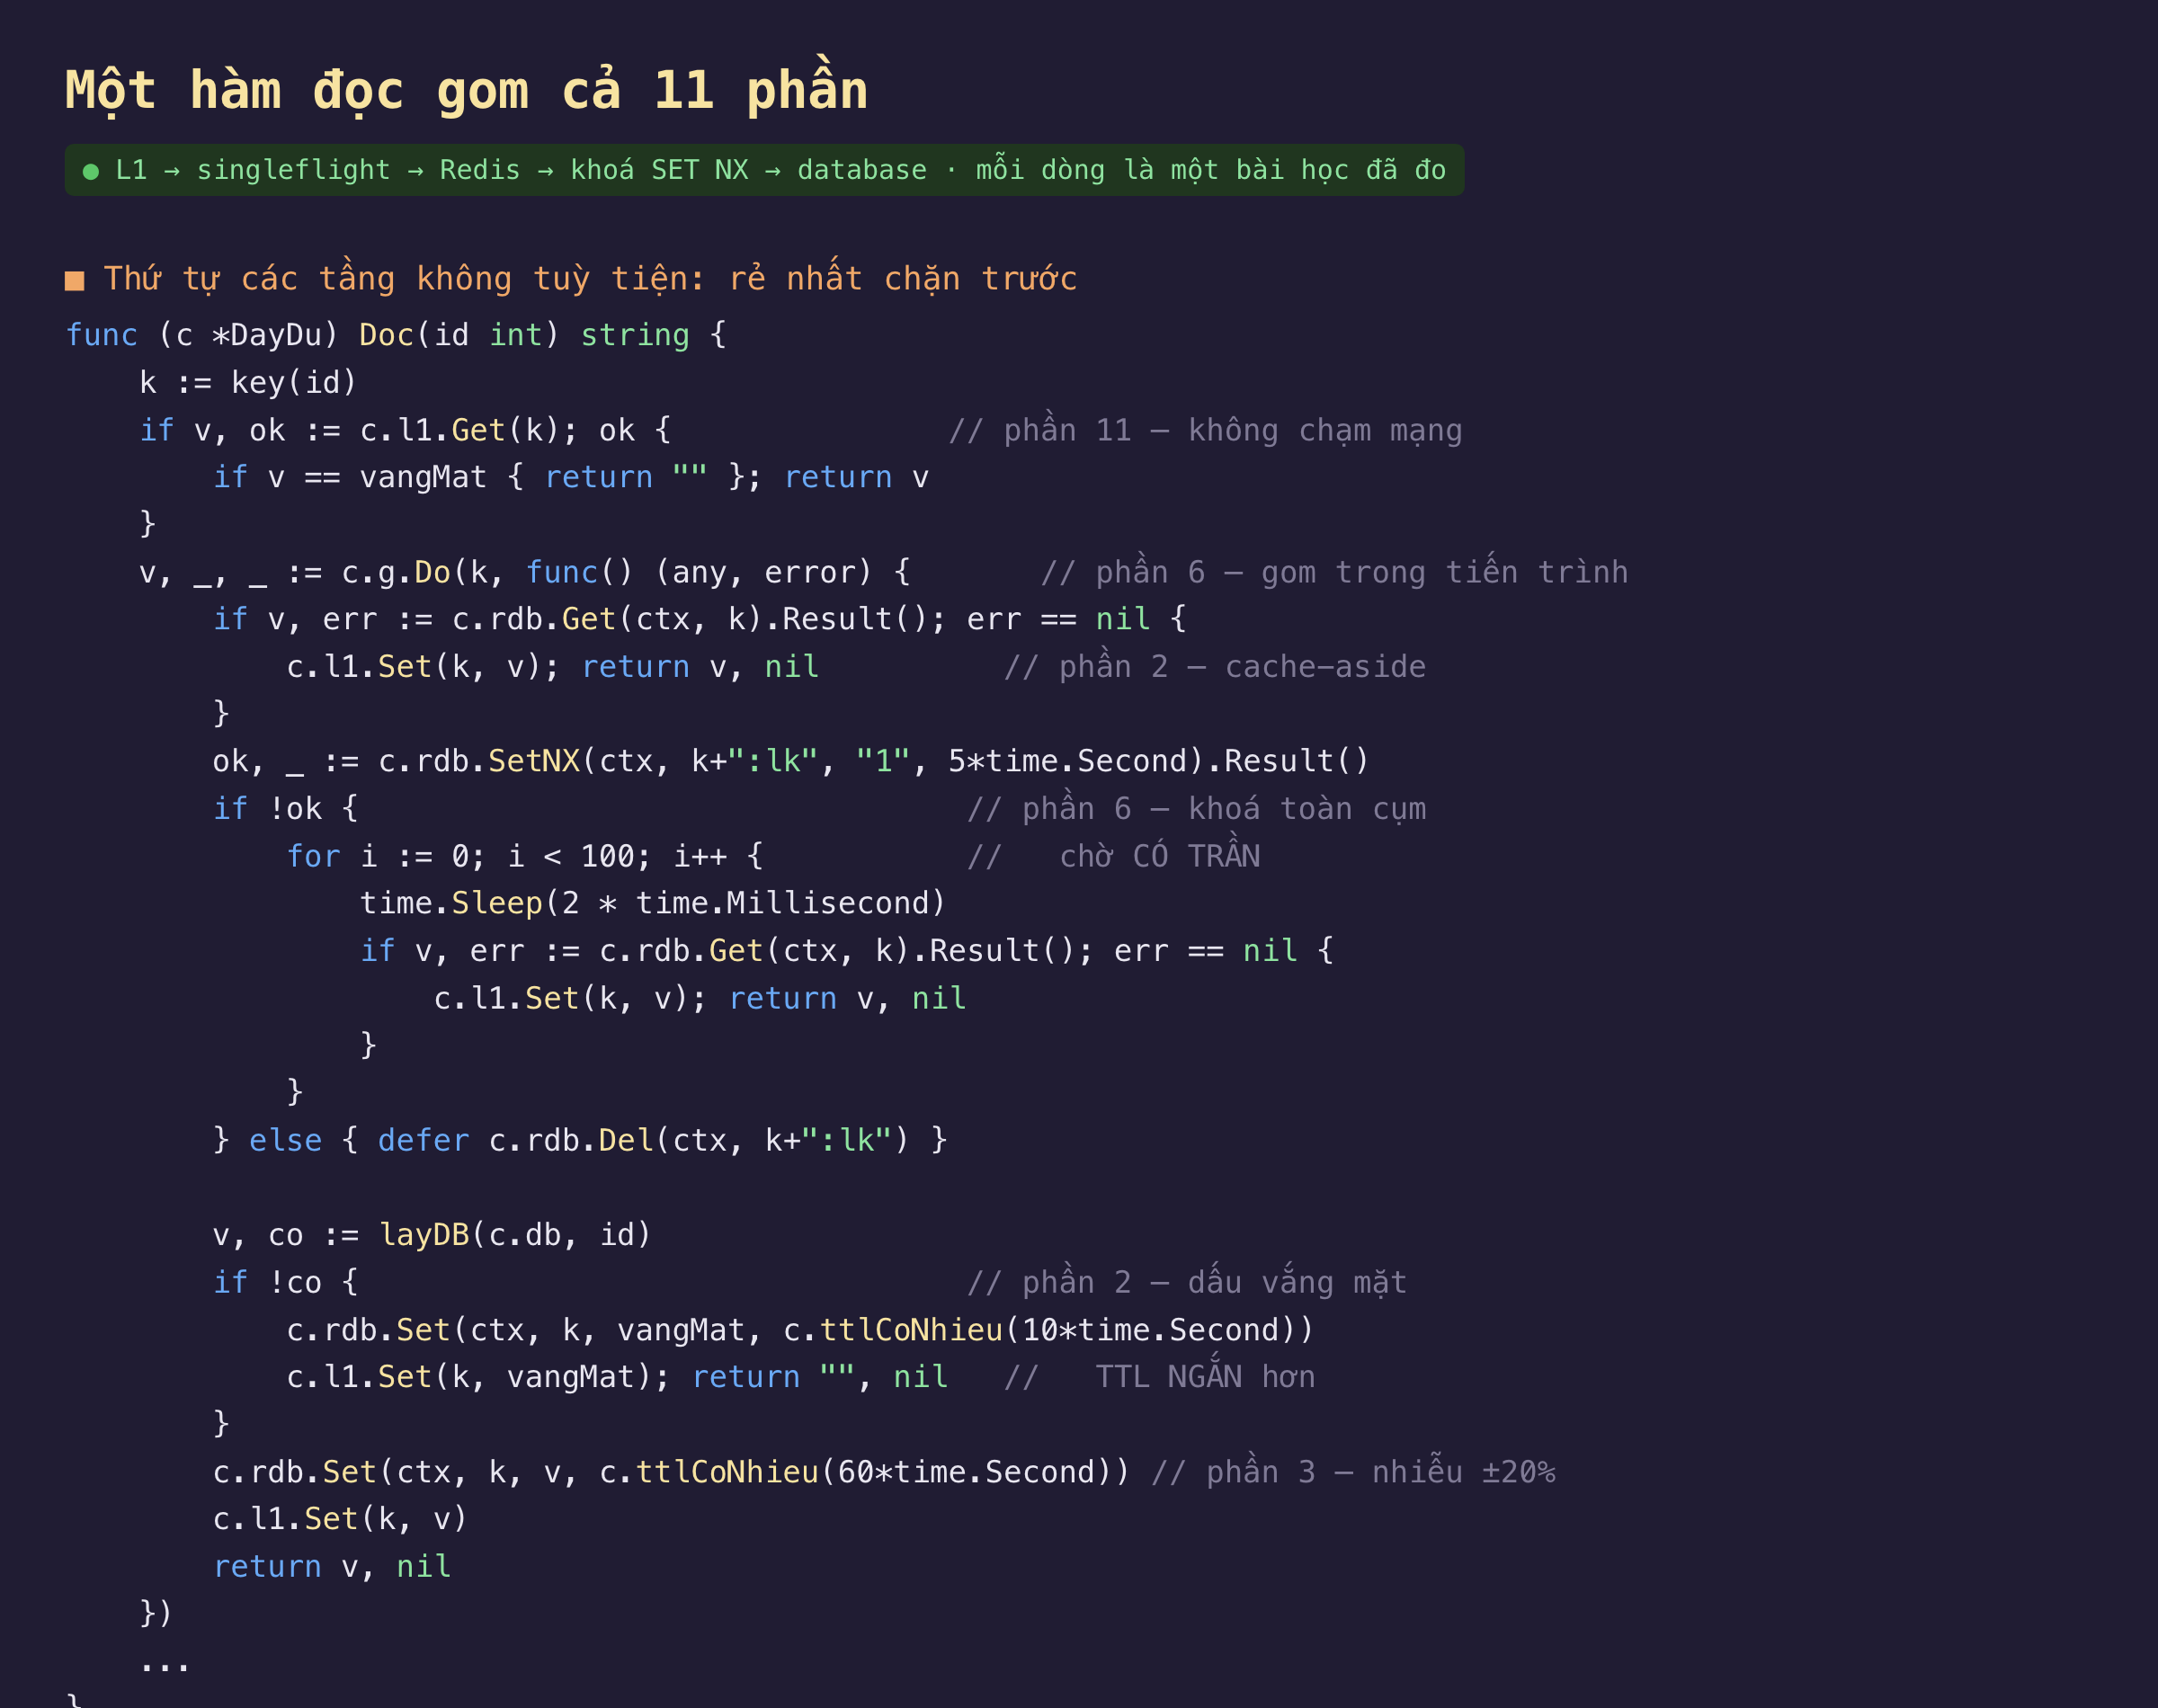
Hình 1: Hàm đọc gom mọi thứ. Thứ tự các tầng không tuỳ tiện — tầng rẻ nhất chặn trước, và mỗi tầng chỉ gỡ tải cho tầng ngay sau nó.
Ba bài học không nằm trong hàm này, và đó là chuyện đáng nhớ: chúng sống ở ba nơi khác nhau.
- Phần 4 (chọn
allkeys-lfuthay vì mặc địnhnoeviction) nằm ở cấu hình Redis. - Phần 7 (ghi database rồi xoá cache, không bao giờ ngược lại) nằm ở đường ghi, hoàn toàn tách khỏi đường đọc.
- Phần 9 (đo miss trên giây và hit ratio theo cửa sổ) nằm ở dashboard.
Viết đúng hàm đọc mà bỏ ba thứ kia thì vẫn hỏng — chỉ là hỏng ở chỗ khó nhìn hơn.
Đo thật: 101.739 truy vấn database còn 5.300
Lưu lượng dựng theo tất cả những gì đã học là thật: 32 người đọc song song, phân bố Zipf (lệch, như phần 10 đo), 5% lưu lượng là bot quét id không tồn tại (xuyên thủng cache, như phần 2 đo), và cả hai biến thể đều khởi động từ cache trống.
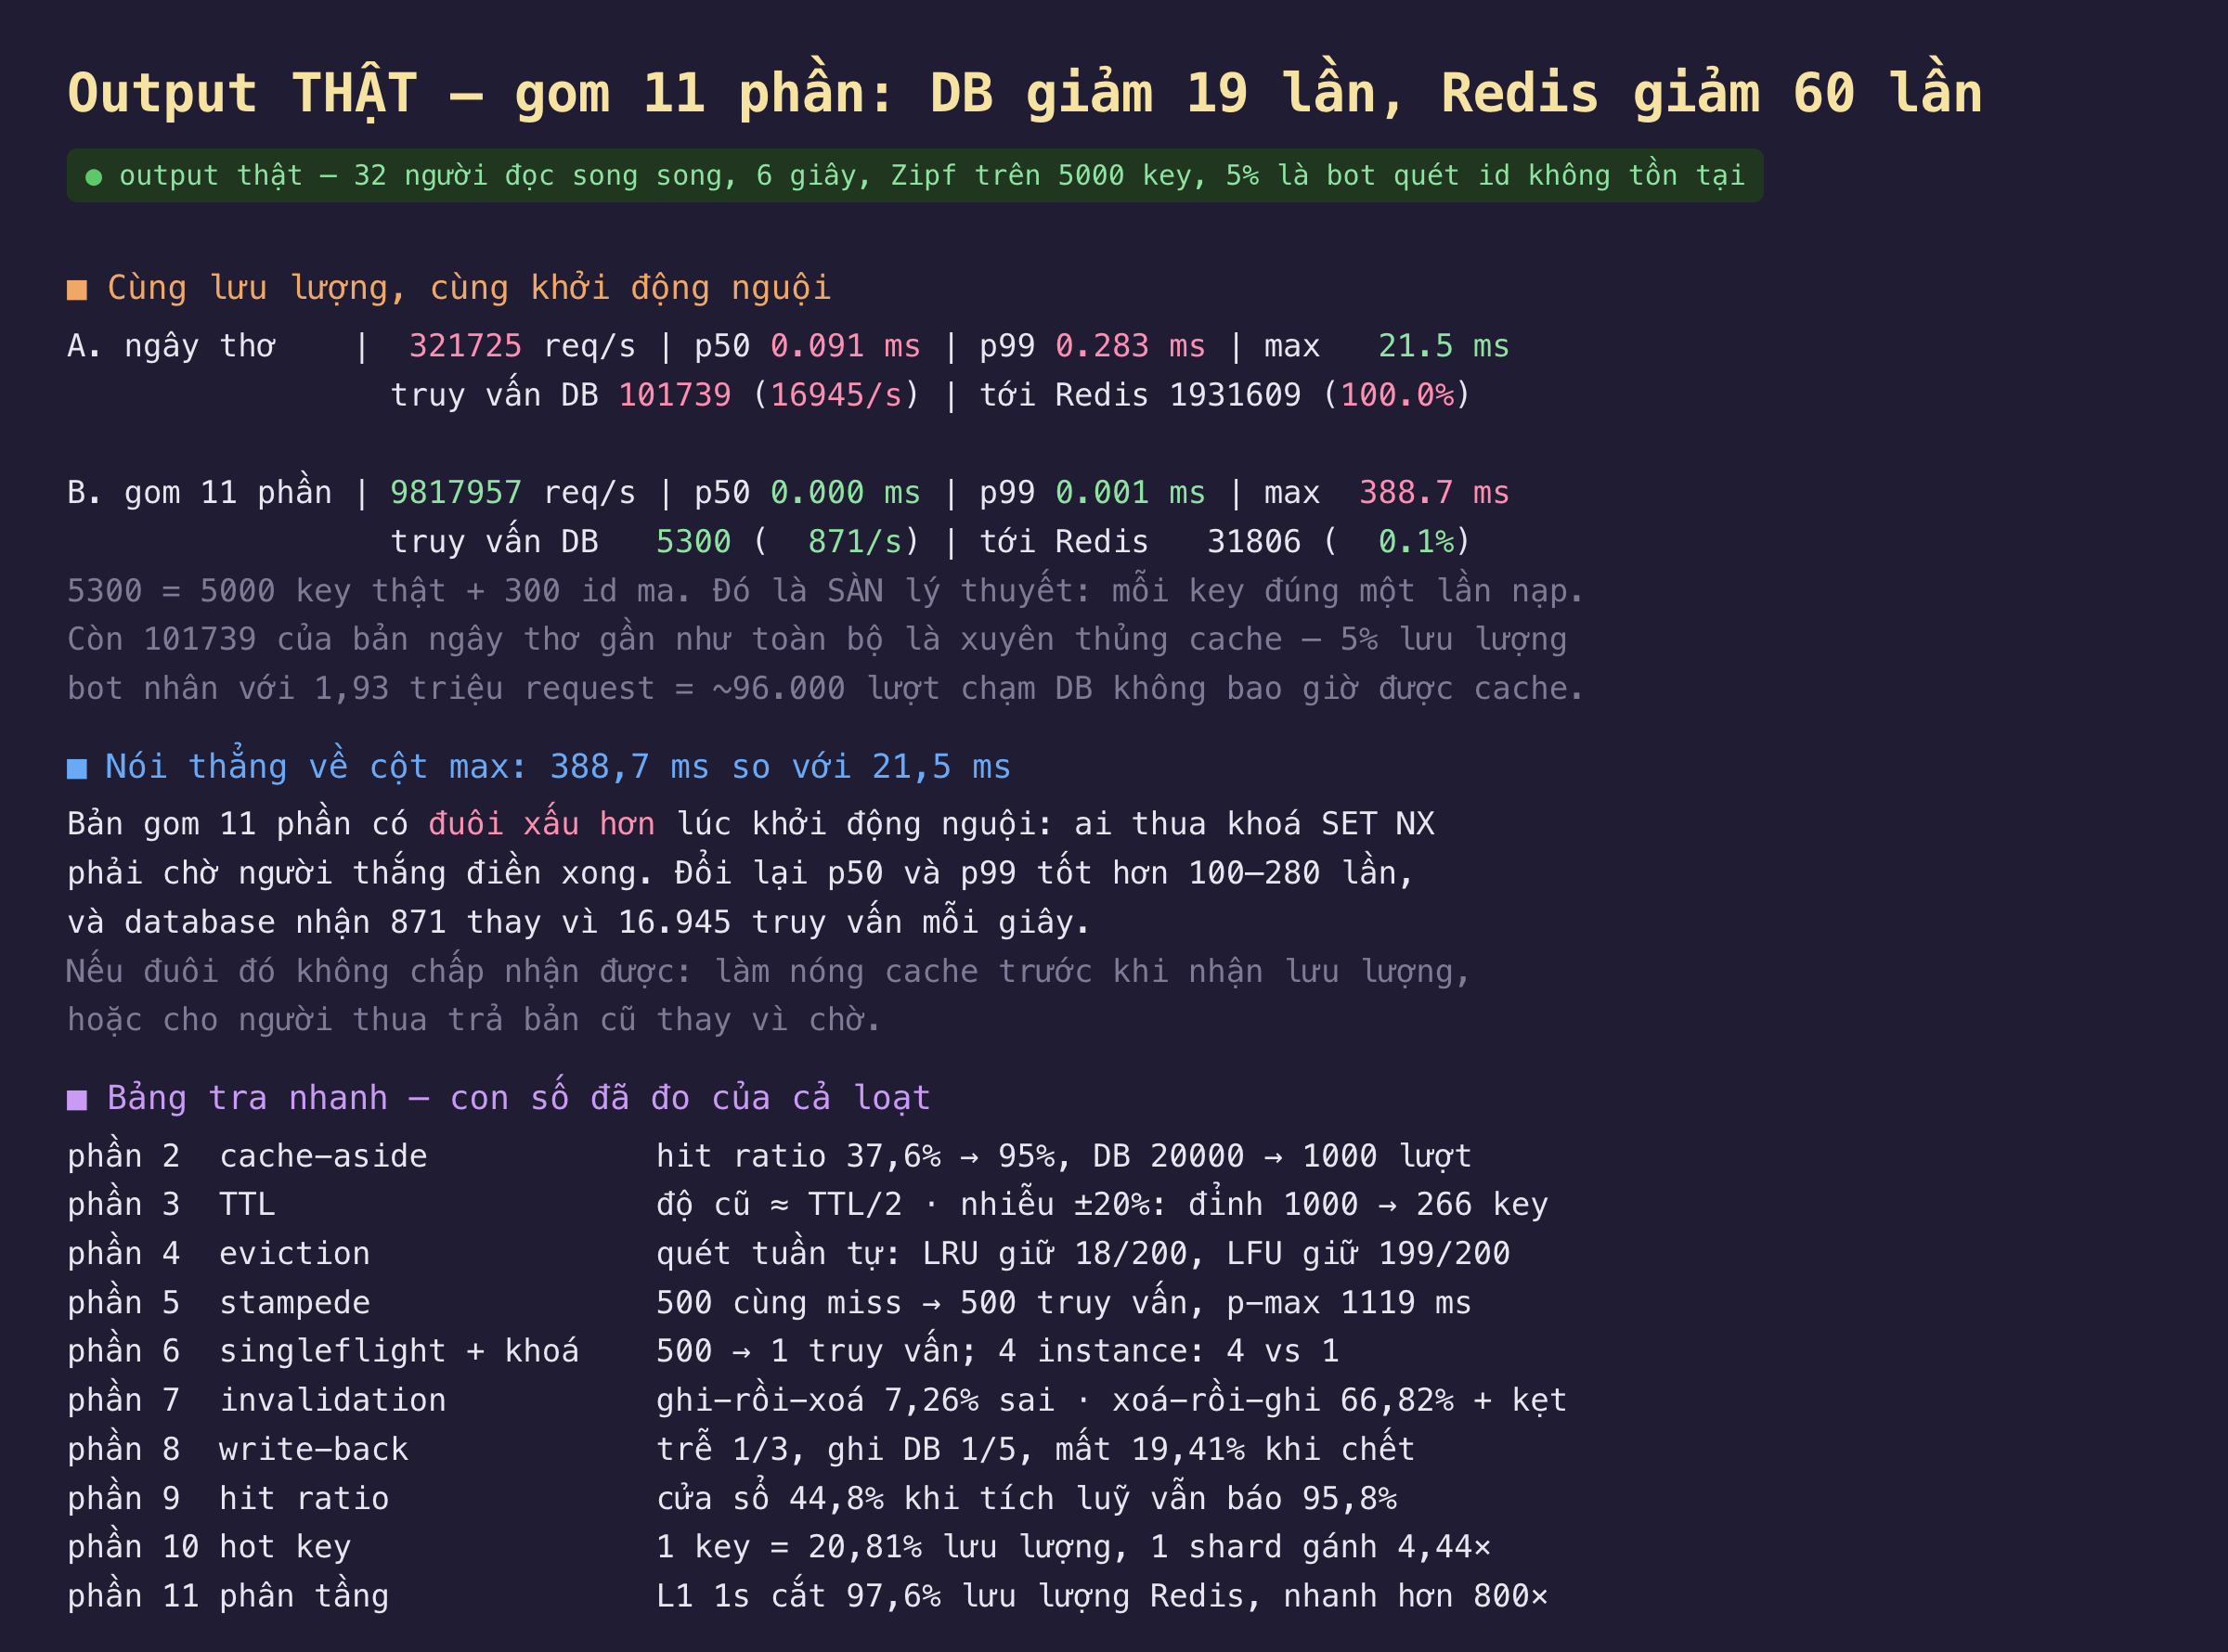
Hình 2: Kết quả thật, cùng bảng tra nhanh toàn bộ con số của loạt bài.
Truy vấn database: 101.739 → 5.300. Con số 5.300 không phải ngẫu nhiên — nó bằng đúng 5.000 key thật + 300 id ma, tức là sàn lý thuyết: mỗi key riêng biệt được nạp đúng một lần, không hơn. Khó mà làm tốt hơn thế.
Và đây là chỗ đáng ngạc nhiên nhất: phần lớn khoảng cách không đến từ L1 hay từ chống stampede. 101.739 − 5.300 ≈ 96.400, và 5% × 1,93 triệu request ≈ 96.500 — khớp gần như hoàn hảo. Gần như toàn bộ tải database của bản ngây thơ là xuyên thủng cache: những id không tồn tại không bao giờ được cache, nên mỗi lần bot hỏi lại là một lần chạm database. Thứ đắt nhất trong cả bài toán hoá ra được sửa bằng dấu vắng mặt — ba dòng code ở phần 2, bài học rẻ nhất của cả loạt.
Lưu lượng Redis: 100% → 0,1%. Tầng L1 với TTL 1 giây gần như xoá sổ đường đi tới Redis, đúng như phần 11 đo riêng.
p50 và p99 tốt hơn 100–280 lần, vì phần lớn request không rời khỏi tiến trình.
Nói thẳng: bản "đúng chuẩn" có đuôi xấu hơn
Cột max đi ngược mọi cột khác: 388,7ms so với 21,5ms. Bản gom 11 phần có request chậm nhất tệ hơn 18 lần.
Nguyên nhân nằm đúng ở cơ chế bảo vệ: lúc khởi động nguội, ai thua khoá SET NX phải chờ người thắng nạp xong. Với 32 người đọc tranh 5.000 key cùng lúc, một số request xui rơi vào chuỗi chờ dài. Đây chính là đánh đổi đã nêu ở phần 6, giờ hiện ra bằng số: chống stampede dời chi phí từ database sang hàng đợi của người thua.
Hai cách xử lý nếu cái đuôi đó không chấp nhận được, và cả hai đều đã nhắc tới trong loạt bài: làm nóng cache trước khi nhận lưu lượng, hoặc cho người thua trả bản cũ thay vì chờ (stale-while-revalidate). Điều cần nhớ là đừng ngạc nhiên khi thấy nó — p99 đẹp hơn và max xấu hơn là hình dạng bình thường của một hệ có khoá.
Khung quyết định
Gộp mọi thứ lại thành thứ tự câu hỏi nên hỏi, theo đúng thứ tự:
1. Có nên cache không? Đo truy vấn gốc trước (phần 1). Query nặng (gộp, join nhiều bảng) thì cache thắng lớn; query điểm có index thì lợi ích về độ trễ rất nhỏ — Redis chỉ nhanh hơn PostgreSQL 1,26 lần ở phần 11. Lý do đúng để cache một query nhẹ là gỡ tải, không phải tăng tốc.
2. Dữ liệu chịu được cũ bao lâu? Câu trả lời chính là TTL, vì độ cũ trung bình ≈ TTL/2 (phần 3). Không trả lời được câu này thì chưa nên cache. Và nhớ: sàn của độ cũ là tần suất ghi, TTL ngắn hơn chu kỳ ghi không mua thêm gì.
3. Mẫu nào? Đọc nhiều ghi ít → cache-aside + xoá khi ghi. Ghi nhiều và đọc lại ngay → write-through (xoá cache sau mỗi lần ghi là tự đục thủng cache, phần 8). Bộ đếm cộng dồn → write-back, và chấp nhận mất tối đa một chu kỳ dồn.
4. Key nào cần bảo vệ? Tính R × D (phần 5) cho từng nhóm key. Tích lớn thì thêm singleflight + khoá; tích nhỏ thì đừng thêm gì, cơ chế bảo vệ cũng có giá.
5. Đo gì? Miss trên giây (tuyệt đối, cho dung lượng) và hit ratio theo cửa sổ (cho cảnh báo) — không bao giờ chỉ dùng hit ratio tích luỹ (phần 9).
Checklist trước khi đưa lên production
Mỗi dòng dưới đây tương ứng một phép đo cụ thể trong loạt bài, không phải lời khuyên chung chung:
- Mọi
Setđều có TTL. Không TTL là mất lưới an toàn cuối cùng, và vớivolatile-*thì key đó còn bất tử. - TTL có nhiễu ±20%. Một dòng code, hạ đỉnh hết hạn đồng loạt từ 1.000 xuống 266 key.
-
maxmemoryvàmaxmemory-policyđã đặt. Mặc định của Redis lànoeviction— ghi bị từ chối vớiOOMtrong khi đọc vẫn chạy, không có tín hiệu nào. - Lỗi Redis ≠ cache miss. Phân biệt
redis.Nilvới lỗi kết nối; Redis sập thì đi thẳng xuống database, đừng trả lỗi cho người dùng. - Có dấu vắng mặt, TTL ngắn hơn TTL dữ liệu thật. Phép đo cuối cho thấy đây là nguồn tải database lớn nhất nếu thiếu.
- Key có R × D lớn được bảo vệ bằng singleflight và khoá toàn cụm.
singleflightmột mình nhân theo số instance. - Khoá có TTL, vòng chờ có trần, xoá khoá kiểm chủ.
- Đường ghi: ghi database rồi xoá cache. Không bao giờ ngược lại — 7,26% so với 66,82%, và cái sau để cache kẹt sai tới hết TTL.
- Dùng
Delchứ khôngSetkhi invalidate, trừ khi có cách sắp thứ tự. - Dashboard có miss/giây và hit ratio theo cửa sổ, vẽ miss ratio chứ không vẽ hit ratio.
- Biết key nóng nhất chiếm bao nhiêu phần trăm lưu lượng. Nếu lớn, L1 trước khi nghĩ tới tách key.
- TTL của L1 tính bằng giây, không bằng phút — không ai xoá được nó từ xa.
- L1 có trần số phần tử. Nó không có
maxmemory, và nạn nhân là heap của chính ứng dụng. - Đã thử chạy với cache trống. Nếu database không gánh nổi lưu lượng khi không có cache, cache đang che giấu một vấn đề dung lượng chứ không giải quyết nó.
Đánh đổi cần cân nhắc
Đừng áp cả 11 thứ ngay từ đầu. Phép đo cuối cho thấy phần lớn lợi ích đến từ hai thứ rẻ nhất — cache-aside cơ bản và dấu vắng mặt. Thêm singleflight, khoá cụm, L1 là thêm ba chế độ hỏng mới (khoá kẹt, đuôi 388,7ms, dữ liệu lệch giữa instance) để đổi lấy phần lợi ích còn lại. Thêm từng lớp, mỗi lớp khi đo được rằng nó cần.
Con số trong loạt bài này là của container trên một máy. Redis qua loopback 36,9µs thay vì 200–1000µs như qua mạng thật; PostgreSQL với buffer pool nóng và dữ liệu nhỏ; không có nhiều instance thật, không có mạng chậm, không có GC pause. Mọi tỉ lệ trong loạt bài đều kiểm chứng được ở hệ của bạn bằng đúng cách đo đó — và đó mới là thứ nên mang đi, không phải con số tuyệt đối.
Cache là tối ưu, không phải kiến trúc. Mọi thứ trong 12 phần này đều nhằm làm hệ thống nhanh hơn và nhẹ tải hơn — không có phần nào làm nó đúng hơn. Ngược lại là khác: mỗi tầng cache thêm vào là thêm một nơi dữ liệu có thể sai. Nếu một tính năng chỉ chạy được khi có cache, thì đó không còn là cache nữa, mà là một database thiếu độ bền.
Ba ý mang về
- Mười một bài học cộng lại đưa truy vấn database từ 101.739 xuống 5.300 — đúng sàn lý thuyết (mỗi key nạp một lần) — và lưu lượng Redis từ 100% xuống 0,1%, p99 tốt hơn 280 lần.
- Phần lớn khoảng cách đó đến từ bài học rẻ nhất: ~96.400 trong 96.439 truy vấn tiết kiệm được là nhờ dấu vắng mặt chặn xuyên thủng cache. Trước khi thêm cơ chế phức tạp, hãy đo xem tải database thực sự đến từ đâu.
- Bản "đúng chuẩn" có p99 tốt hơn nhưng max xấu hơn (388,7ms so với 21,5ms) vì chống stampede dời chi phí sang hàng đợi người thua. Mọi cơ chế bảo vệ đều có hình dạng đánh đổi như vậy — biết trước thì không hoảng, và chữa được bằng làm nóng cache hoặc trả bản cũ.
Nguồn
- Redis docs — Caching patterns, eviction, client-side caching: https://redis.io/docs/latest/develop/
- AWS Builders' Library — Caching challenges and strategies: https://aws.amazon.com/builders-library/caching-challenges-and-strategies/
- Facebook — Scaling Memcache at Facebook (NSDI'13): https://www.usenix.org/conference/nsdi13/technical-sessions/presentation/nishtala
- Martin Kleppmann — Designing Data-Intensive Applications (O'Reilly, 2017)
- Microsoft Azure Architecture Center — Caching guidance: https://learn.microsoft.com/en-us/azure/architecture/best-practices/caching
