Bảy phần đầu của loạt này đều có chung một giả định: cache đứng ngoài đường ghi. Ứng dụng ghi xuống database, rồi xoá cache (phần 7) — cache chỉ phục vụ đọc. Mẫu đó có tên riêng là write-around, và nó không phải lựa chọn duy nhất.
Hai mẫu còn lại đưa cache vào đường ghi: write-through (ghi cả hai nơi, đồng bộ) và write-back (chỉ ghi cache, dồn về database sau). Bài này dựng cả ba cho cùng một nghiệp vụ — tăng bộ đếm lượt xem — và đo xem đổi được gì lấy gì.
Ba cách ghi, khác nhau ở chỗ ai là nguồn sự thật lúc ghi
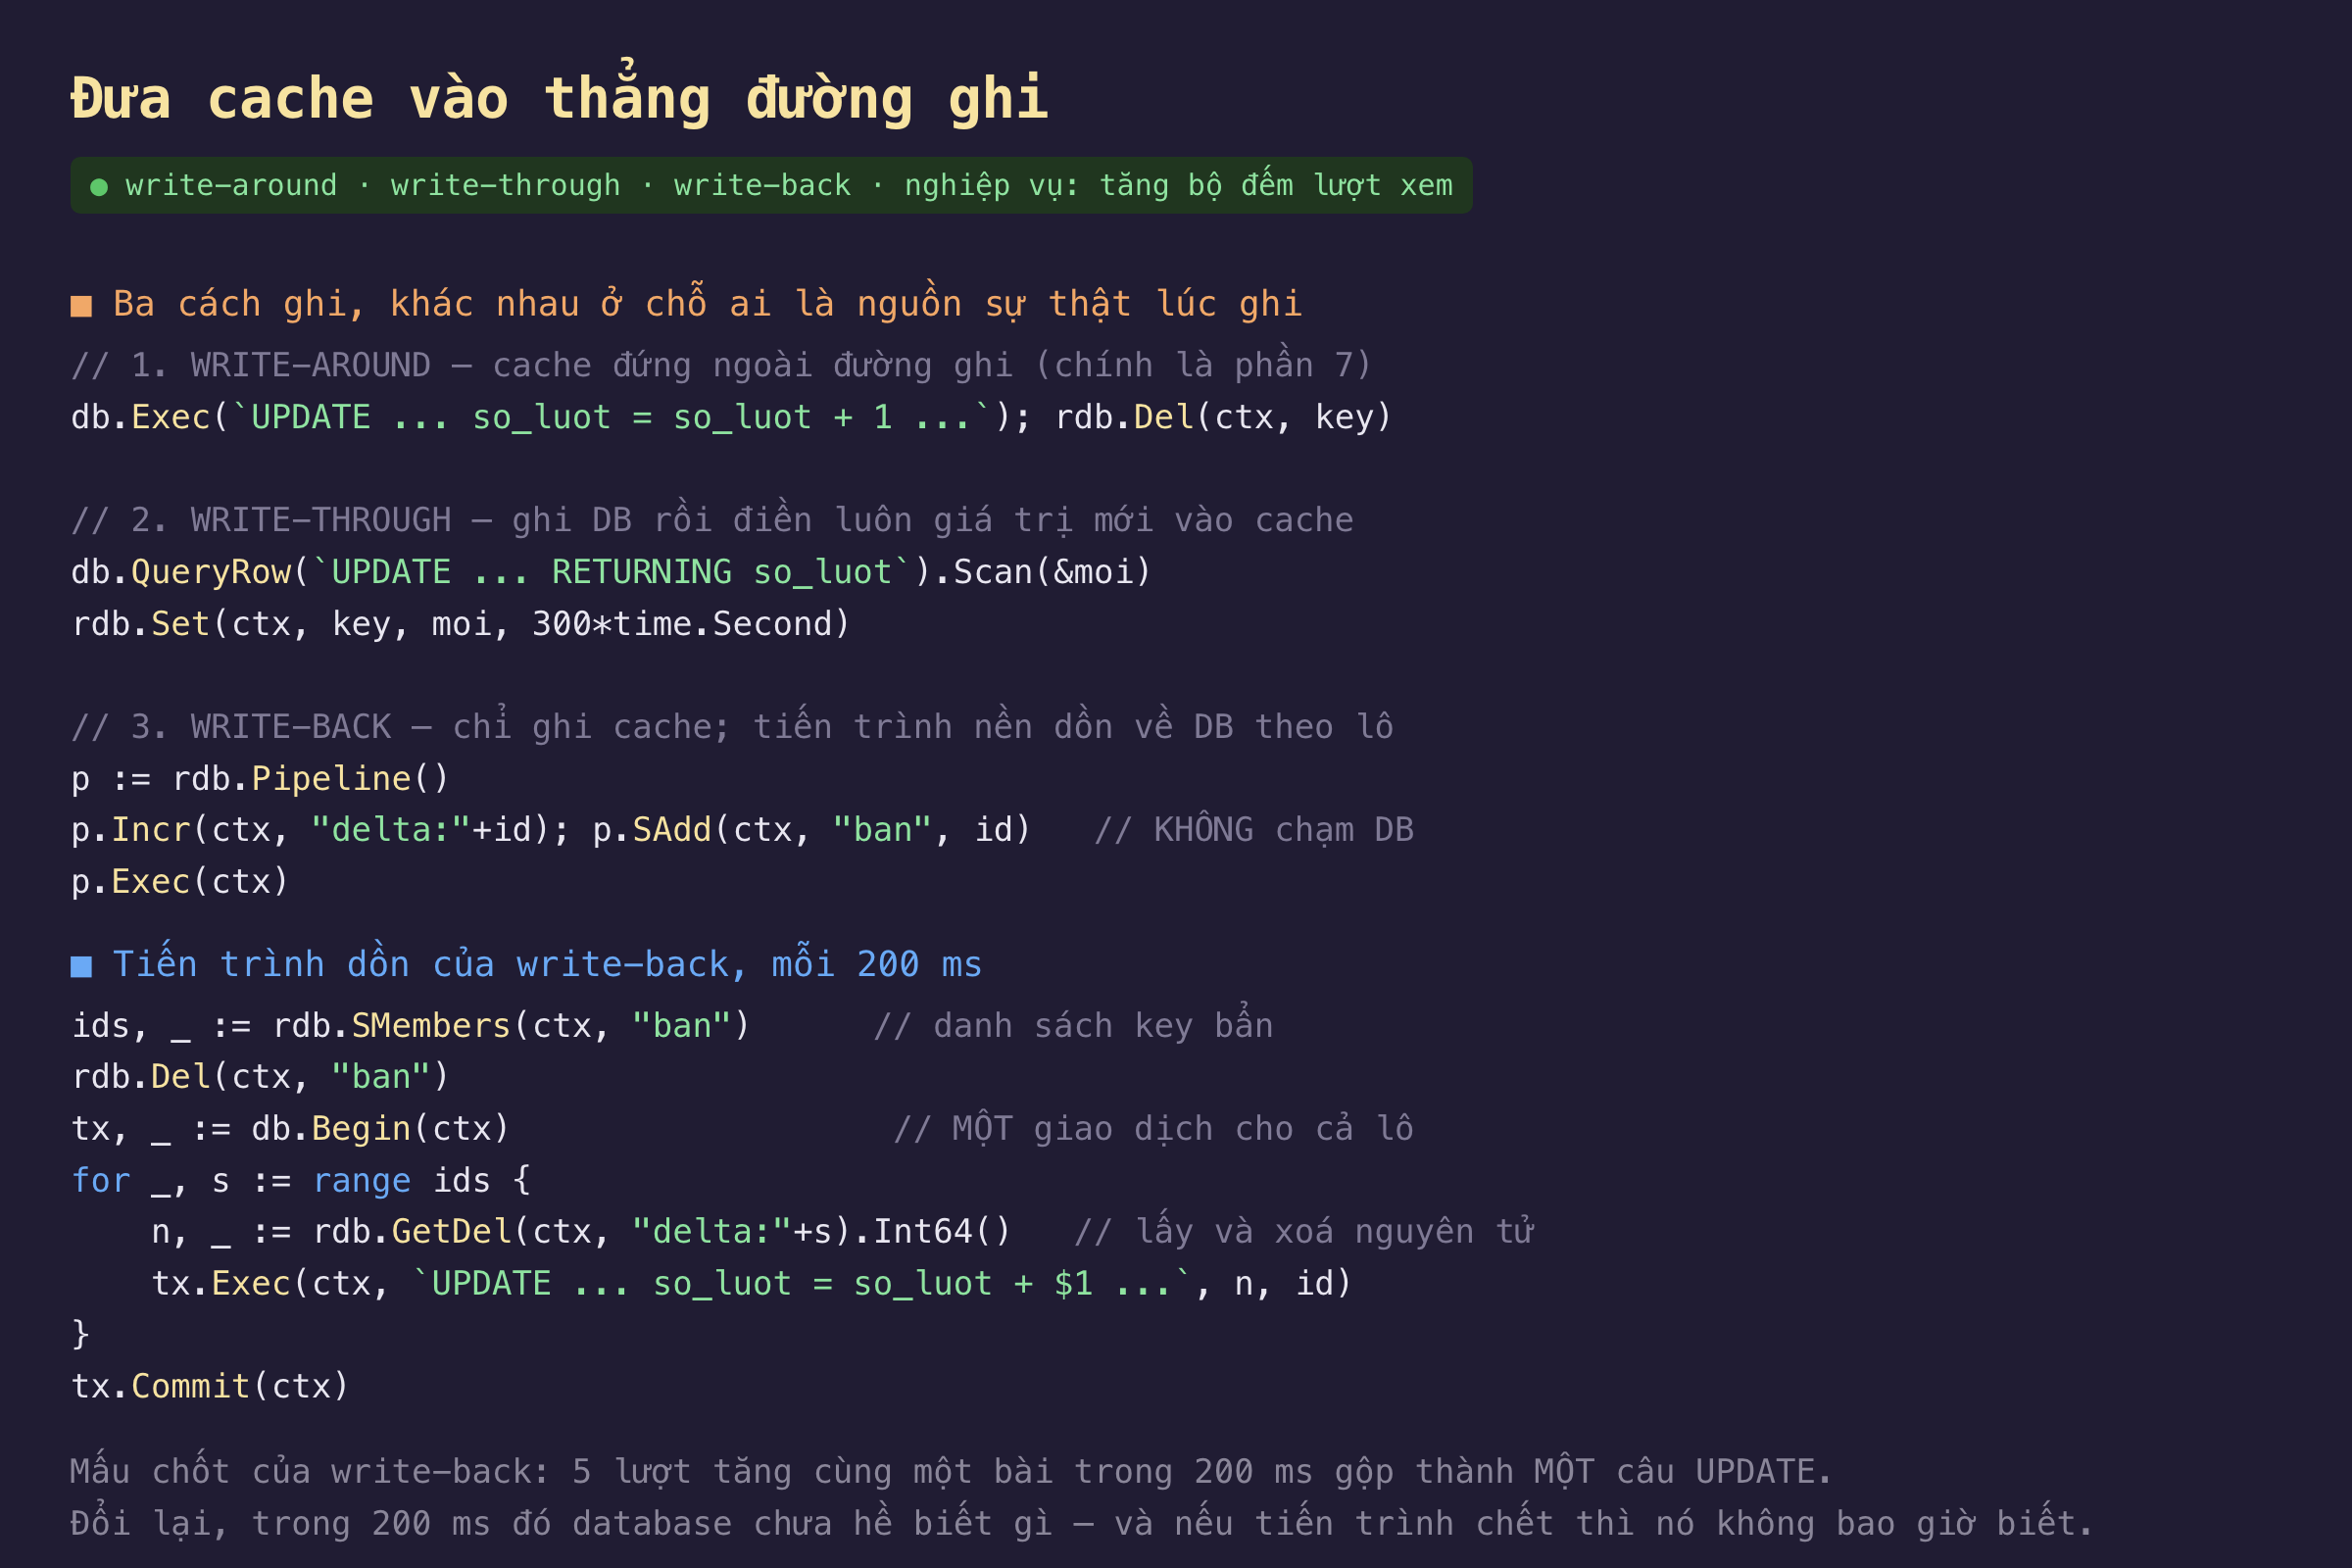
Hình 1: Ba mẫu ghi. Điểm khác biệt cốt lõi: write-around và write-through đều coi database là nguồn sự thật ngay tại thời điểm ghi; write-back coi cache là nguồn sự thật trong khoảng giữa hai lần dồn.
Ba mẫu trả lời khác nhau cho câu hỏi "khi hàm ghi trả về, ai đã biết giá trị mới?":
- write-around: database biết. Cache không biết gì — nó vừa bị xoá, lần đọc sau phải nạp lại.
- write-through: cả hai đều biết. Tốn thêm một lệnh Redis trên mỗi lần ghi.
- write-back: chỉ cache biết. Database sẽ biết sau — hoặc không bao giờ, nếu tiến trình chết trước.
Mấu chốt của write-back nằm ở chữ gộp: nếu một bài được xem 5 lần trong 200ms, write-around và write-through gửi 5 câu UPDATE, còn write-back gửi một câu cộng thêm 5. Đó cũng là lý do mẫu này gần như luôn xuất hiện ở đúng một chỗ: bộ đếm, và các dữ liệu cộng dồn khác.
Đo thật: 0,038ms so với 0,122ms, và 3.926 lệnh ghi so với 20.000
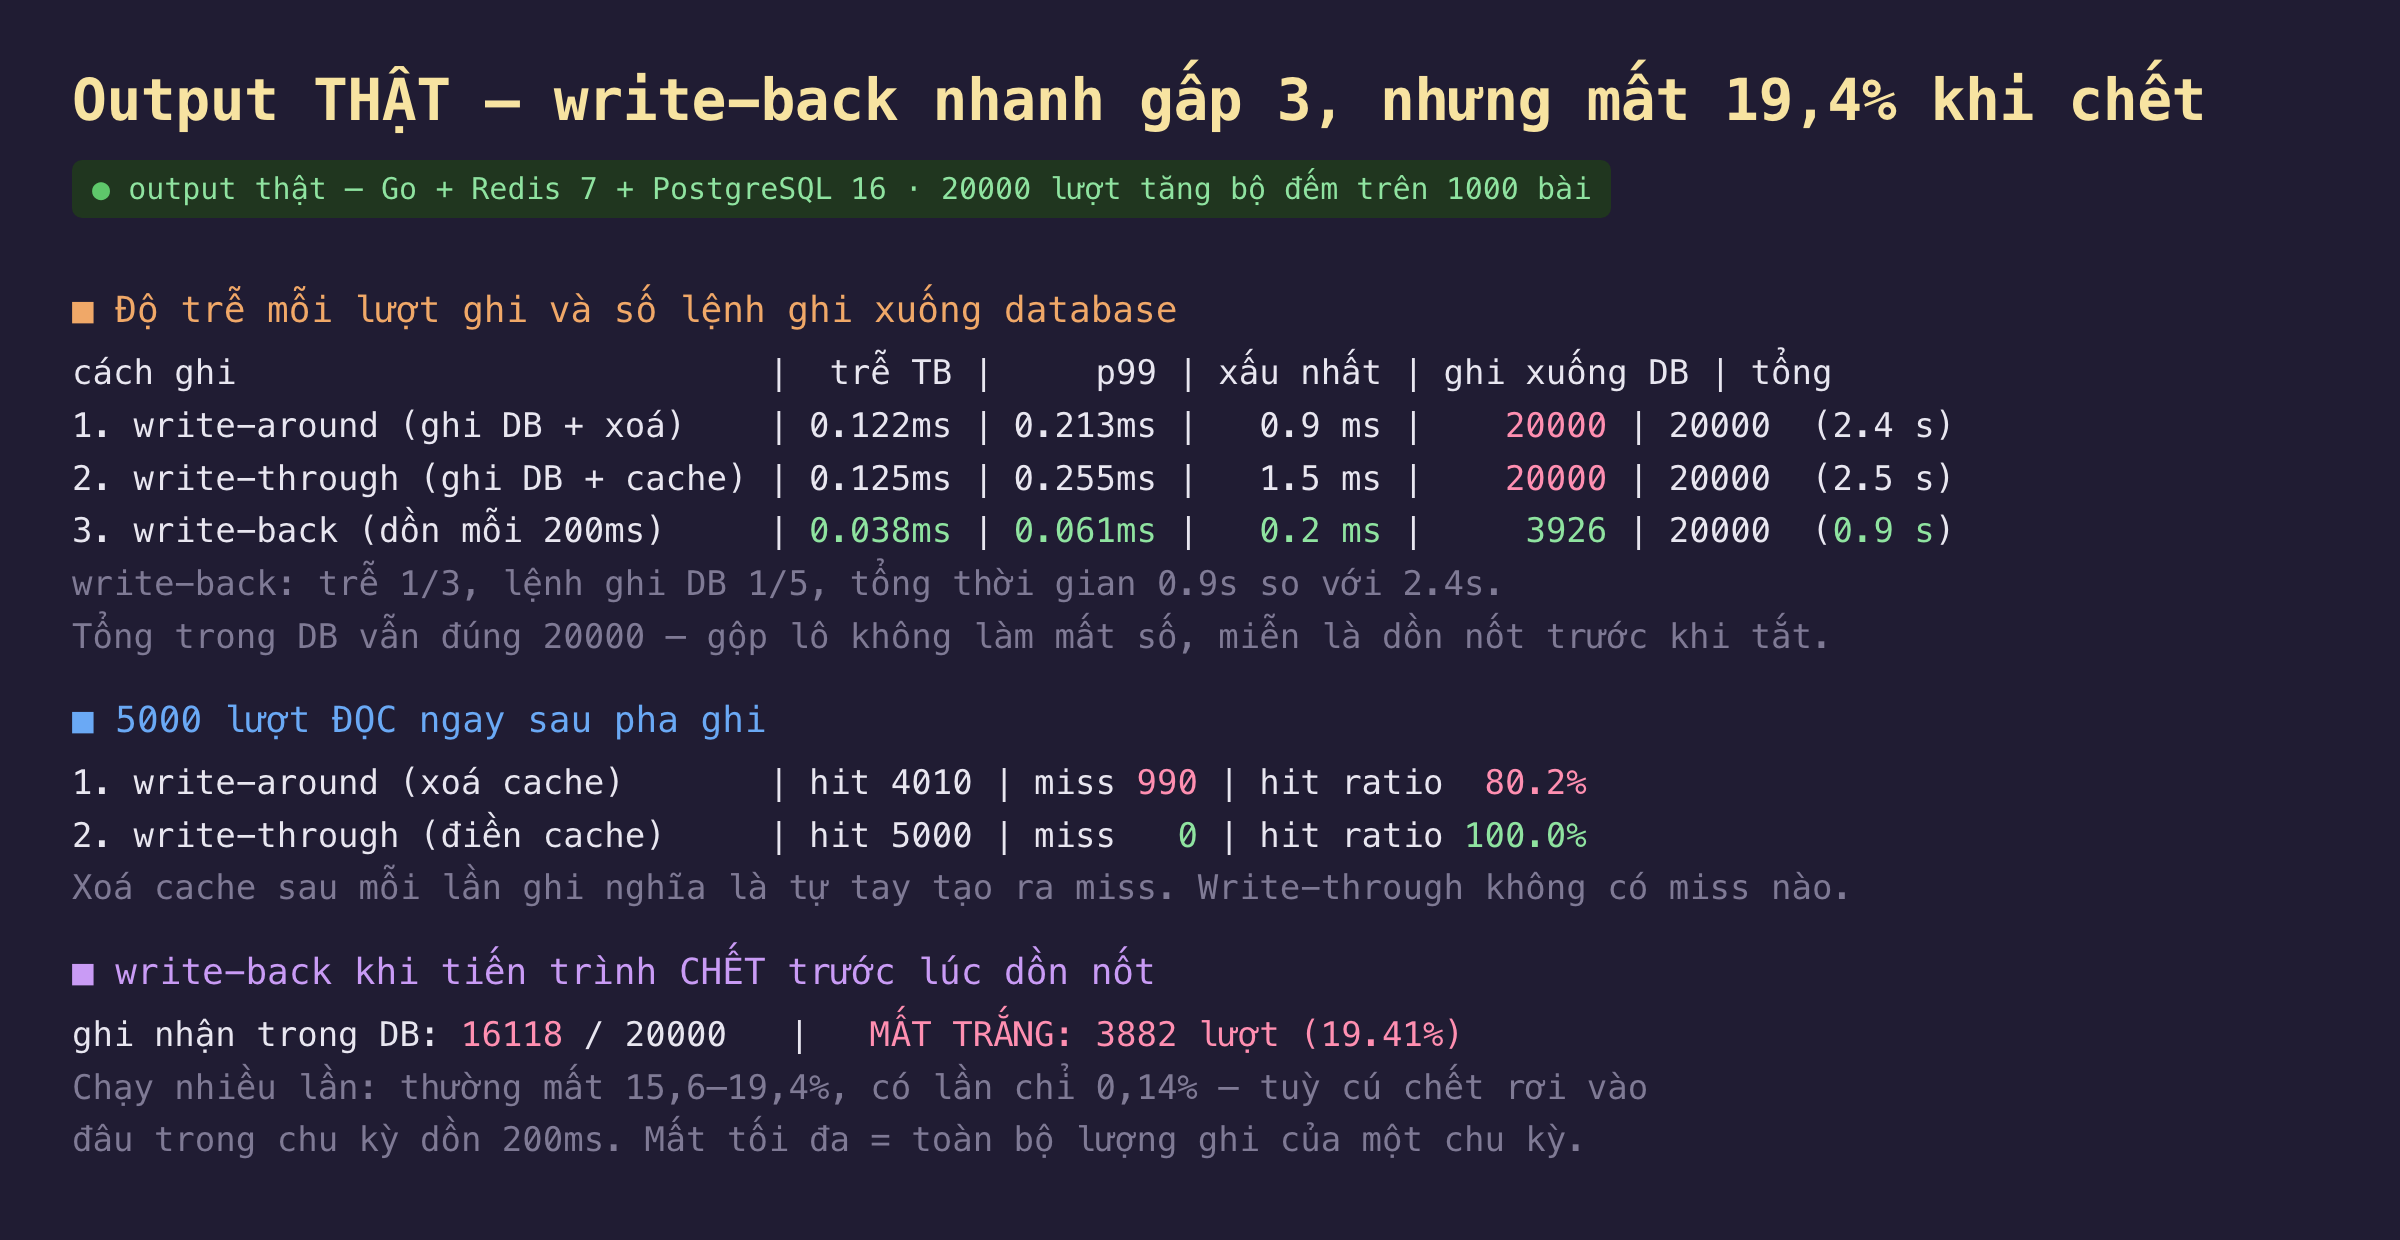
Hình 2: Kết quả thật. Ba bảng, ba câu hỏi khác nhau: ghi tốn bao lâu, đọc ngay sau đó có hit không, và mất gì khi tiến trình chết.
Write-through gần như không đắt hơn write-around. 0,125ms so với 0,122ms — chênh lệch nằm trong nhiễu đo. Thêm một lệnh Set vào Redis tốn khoảng 0,03ms, bị che hoàn toàn bởi lượt ghi database. Trực giác "write-through chậm hơn vì phải ghi hai nơi" sai ở đây, vì hai nơi đó chênh nhau một bậc về chi phí: ghi Redis rẻ hơn ghi database nhiều lần.
Đổi lại, write-through xoá sạch miss sau khi ghi. Bảng thứ hai mới là lý do chọn nó: 5.000 lượt đọc ngay sau pha ghi cho 100% hit với write-through, so với 80,2% với write-around — tức 990 truy vấn database bị tạo ra bởi chính việc xoá cache. Nhìn lại thì hợp lý: write-around xoá key sau mỗi lần ghi, nên với dữ liệu ghi nhiều, nó tự tay đục thủng cache của mình. Càng ghi nhiều, hit ratio càng tệ.
Write-back thắng rõ rệt ở cả hai cột: 0,038ms và 3.926 lệnh ghi. Trễ bằng 1/3, số lệnh ghi xuống database bằng 1/5, tổng thời gian chạy 0,9 giây so với 2,4 giây. Tỉ lệ gộp 20.000/3.926 ≈ 5,1 nghĩa là trung bình mỗi câu UPDATE mang theo 5 lượt xem. Và tổng trong database vẫn đúng 20.000 — gộp lô không làm mất số, miễn là dồn nốt trước khi tắt.
Cái giá của write-back, đo bằng số lượt mất trắng
Câu "miễn là dồn nốt trước khi tắt" chính là chỗ yếu. Mình chạy lại write-back và không cho nó dồn nốt — mô phỏng tiến trình bị kill, OOM, hoặc máy mất điện:
- 16.118/20.000 lượt vào được database. 3.882 lượt mất trắng — 19,41%.
Không phải "chậm hơn", không phải "cũ hơn", mà mất hẳn: không có ở database, cũng không còn ở Redis. Với bộ đếm lượt xem thì đó là chuyện chấp nhận được; với số dư tài khoản thì là thảm hoạ.
Chạy nhiều lần cho 15,6–19,4%, nhưng có lần chỉ 0,14% — vì lượng mất phụ thuộc cú chết rơi vào đâu trong chu kỳ dồn. Điều đó cho một công thức dễ nhớ và dễ chỉnh:
mất tối đa = toàn bộ lượng ghi của một chu kỳ dồn.
Rút chu kỳ từ 200ms xuống 20ms thì mất tối đa giảm 10 lần — nhưng tỉ lệ gộp cũng giảm theo, và lợi ích chính của write-back đi cùng. Chu kỳ dồn là núm đánh đổi trực tiếp giữa độ bền dữ liệu và mức gộp, không có cách nào có cả hai.
Đánh đổi cần cân nhắc
Write-back chỉ an toàn với phép toán giao hoán và cộng dồn. Demo này dùng INCR rồi dồn bằng so_luot = so_luot + n, nên thứ tự dồn không quan trọng và hai tiến trình dồn song song cũng không sai. Nếu dữ liệu là giá trị thay thế (đặt tên sản phẩm bằng X), write-back lập tức gặp lại đúng vấn đề thứ tự ghi của phần 7 nhưng ở quy mô tệ hơn, vì khoảng cách giữa lúc ghi và lúc xuống database giờ là cả một chu kỳ dồn. Hãy coi write-back là mẫu dành cho bộ đếm và dữ liệu tích luỹ, không phải một lựa chọn tổng quát.
Redis không phải nơi cất dữ liệu bền, kể cả khi bật AOF. Trong khoảng giữa hai lần dồn, Redis là nơi duy nhất giữ dữ liệu. Nếu Redis bị đá key đó ra vì hết bộ nhớ (phần 4), dữ liệu biến mất y như tiến trình chết — và lần này không có log nào. Nếu buộc phải dùng write-back, key chứa dữ liệu chưa dồn phải được bảo vệ khỏi eviction (dùng instance Redis riêng, hoặc chính sách volatile-* với key không TTL), và nên bật AOF appendfsync everysec. Kể cả vậy, mất một giây dữ liệu vẫn là mất.
Write-through không giải quyết được vấn đề của phần 7. Nó ghi đè cache bằng giá trị mới, đúng là "cách 4" đã đo ở bài trước — tức là nó thừa hưởng luôn chế độ hỏng của cách 4: hai người ghi đồng thời có thể tới Redis theo thứ tự ngược với thứ tự tới database, để lại cache kẹt sai. Phép đo ở đây một luồng nên không chạm vào chuyện đó. Dùng write-through khi bạn có cách sắp thứ tự (ghi qua một đường duy nhất, hoặc RETURNING kèm số phiên bản rồi chỉ ghi cache nếu phiên bản mới hơn).
Số đo ở đây là một luồng, một máy, Redis và PostgreSQL cùng container host. Độ trễ tuyệt đối sẽ khác ở production, nhất là khi Redis ở máy khác. Nhưng tỉ lệ giữa ba mẫu — write-through ≈ write-around về trễ, write-back nhanh hơn vài lần và gộp theo đúng tỉ lệ "số lượt ghi mỗi key trong một chu kỳ" — là tính chất của cơ chế, không phải của phần cứng. Tỉ lệ gộp 5,1 ở đây đến từ 20.000 lượt ghi rải trên 1.000 key trong 0,9 giây; tập key nhỏ hơn hoặc chu kỳ dài hơn cho tỉ lệ gộp cao hơn.
Ba ý mang về
- Write-through gần như miễn phí so với write-around (0,125ms so với 0,122ms) và xoá sạch miss sau ghi: 100% hit so với 80,2% khi đọc ngay sau pha ghi. Write-around tự đục thủng cache của mình mỗi lần ghi, nên dữ liệu càng ghi nhiều thì nó càng kém.
- Write-back nhanh gấp 3 và ghi xuống database ít đi 5 lần (0,038ms, 3.926 lệnh thay vì 20.000), nhờ gộp nhiều lượt tăng cùng key thành một câu
UPDATE. Tổng số vẫn đúng — gộp lô không làm mất số khi dồn nốt trước lúc tắt. - Cái giá là mất dữ liệu thật, không phải dữ liệu cũ: cho tiến trình chết trước lúc dồn thì 3.882/20.000 lượt mất trắng (19,41%). Mất tối đa bằng toàn bộ lượng ghi của một chu kỳ dồn — rút chu kỳ thì an toàn hơn nhưng gộp ít đi, đó là một núm duy nhất và không có cách nào có cả hai.
Nguồn
- Redis docs — INCR và bộ đếm: https://redis.io/docs/latest/commands/incr/
- Redis docs — GETDEL: https://redis.io/docs/latest/commands/getdel/
- Redis docs — Persistence (RDB, AOF, appendfsync): https://redis.io/docs/latest/operate/oss_and_stack/management/persistence/
- Microsoft Azure Architecture Center — Caching guidance (write-through, write-behind): https://learn.microsoft.com/en-us/azure/architecture/best-practices/caching
Phần sau ta quay lại chính con số đã dùng suốt tám bài mà chưa soi kỹ: hit ratio. Đo thật vì sao hit ratio tích luỹ che mất sự cố đang xảy ra, vì sao 95% có thể tệ hơn 80%, và đo cái gì thì mới biết cache đang thực sự giúp được bao nhiêu.
