Rust gọi mô hình đồng thời của mình là "đồng thời không sợ hãi" (fearless concurrency) — một cái tên nghe tiếp thị, nhưng có nội dung đo được đứng sau. Ý tưởng: trong hầu hết ngôn ngữ, data race — hai luồng cùng truy cập một dữ liệu mà ít nhất một bên ghi, không đồng bộ — là lỗi lúc chạy, không xác định, cực khó tái hiện và gỡ. Rust biến nó thành lỗi biên dịch. Cùng hệ thống kiểu đã chặn Rc qua luồng ở bài 5 giờ chặn mọi kiểu chia sẻ không an toàn. Bài này đo điều đó — và đo luôn cái giá của các công cụ đồng bộ — trong container rust:1 (rustc 1.99.1).
Hai đặc tính đánh dấu: Send và Sync
Cơ chế nằm ở hai đặc tính (trait) đánh dấu. Send: kiểu an toàn để chuyển quyền sở hữu sang luồng khác. Sync: kiểu an toàn để chia sẻ tham chiếu (&T) giữa nhiều luồng. Hầu hết kiểu tự động có cả hai; những kiểu không an toàn thì cố tình không có — và thread::spawn đòi closure của nó phải Send. Thử chia sẻ một Cell (kiểu cho phép sửa qua tham chiếu chia sẻ, nhưng không đồng bộ) qua 4 luồng:
let dem = Arc::new(Cell::new(0u64));   // Cell không đồng bộ
for _ in 0..4 {
    let d = Arc::clone(&dem);
    thread::spawn(move || {
        for _ in 0..1000 { d.set(d.get() + 1); }
    });
}
error[E0277]: `Cell<u64>` cannot be shared between threads safely
  = help: the trait `Sync` is not implemented for `Cell<u64>`
  = note: required for `Arc<Cell<u64>>` to implement `Send`
E0277. Cell không cài Sync, nên Arc<Cell> không Send, nên thread::spawn từ chối. Cái data race kinh điển — bốn luồng cùng get rồi set, giẫm lên nhau, mất cập nhật — không bao giờ tồn tại dưới dạng chương trình chạy được. Đây là "không sợ hãi": bạn không phải lo lắng mình vô tình tạo data race, vì trình biên dịch không cho.
Làm đúng: Arc cho kết quả chính xác
Để chia sẻ dữ liệu có sửa đổi qua luồng một cách an toàn, bọc nó trong Mutex (khoá loại trừ lẫn nhau) và chia sẻ bằng Arc (đếm tham chiếu nguyên tử, từ bài 5):
let dem = Arc::new(Mutex::new(0u64));
for _ in 0..4 {
    let d = Arc::clone(&dem);
    thread::spawn(move || {
        for _ in 0..1000 { *d.lock().unwrap() += 1; }
    });
}
4 luồng × 1000 = kết quả: 4000 (đúng, không mất cập nhật)
Đúng 4000, không mất một cập nhật nào. Mutex đảm bảo tại mỗi thời điểm chỉ một luồng giữ khoá và sửa dem; các luồng khác chờ. Và điều tinh tế rất Rust: bạn không thể quên khoá. Dữ liệu nằm bên trong Mutex; cách duy nhất chạm tới nó là gọi .lock(), trả về một "vệ sĩ (guard)" tự nhả khoá khi hết phạm vi (RAII, như drop ở bài 1). Không có cửa nào để truy cập dữ liệu mà không qua khoá — khác hẳn mutex trong C, nơi khoá và dữ liệu là hai thứ rời, quên khoá là lỗi thầm lặng.
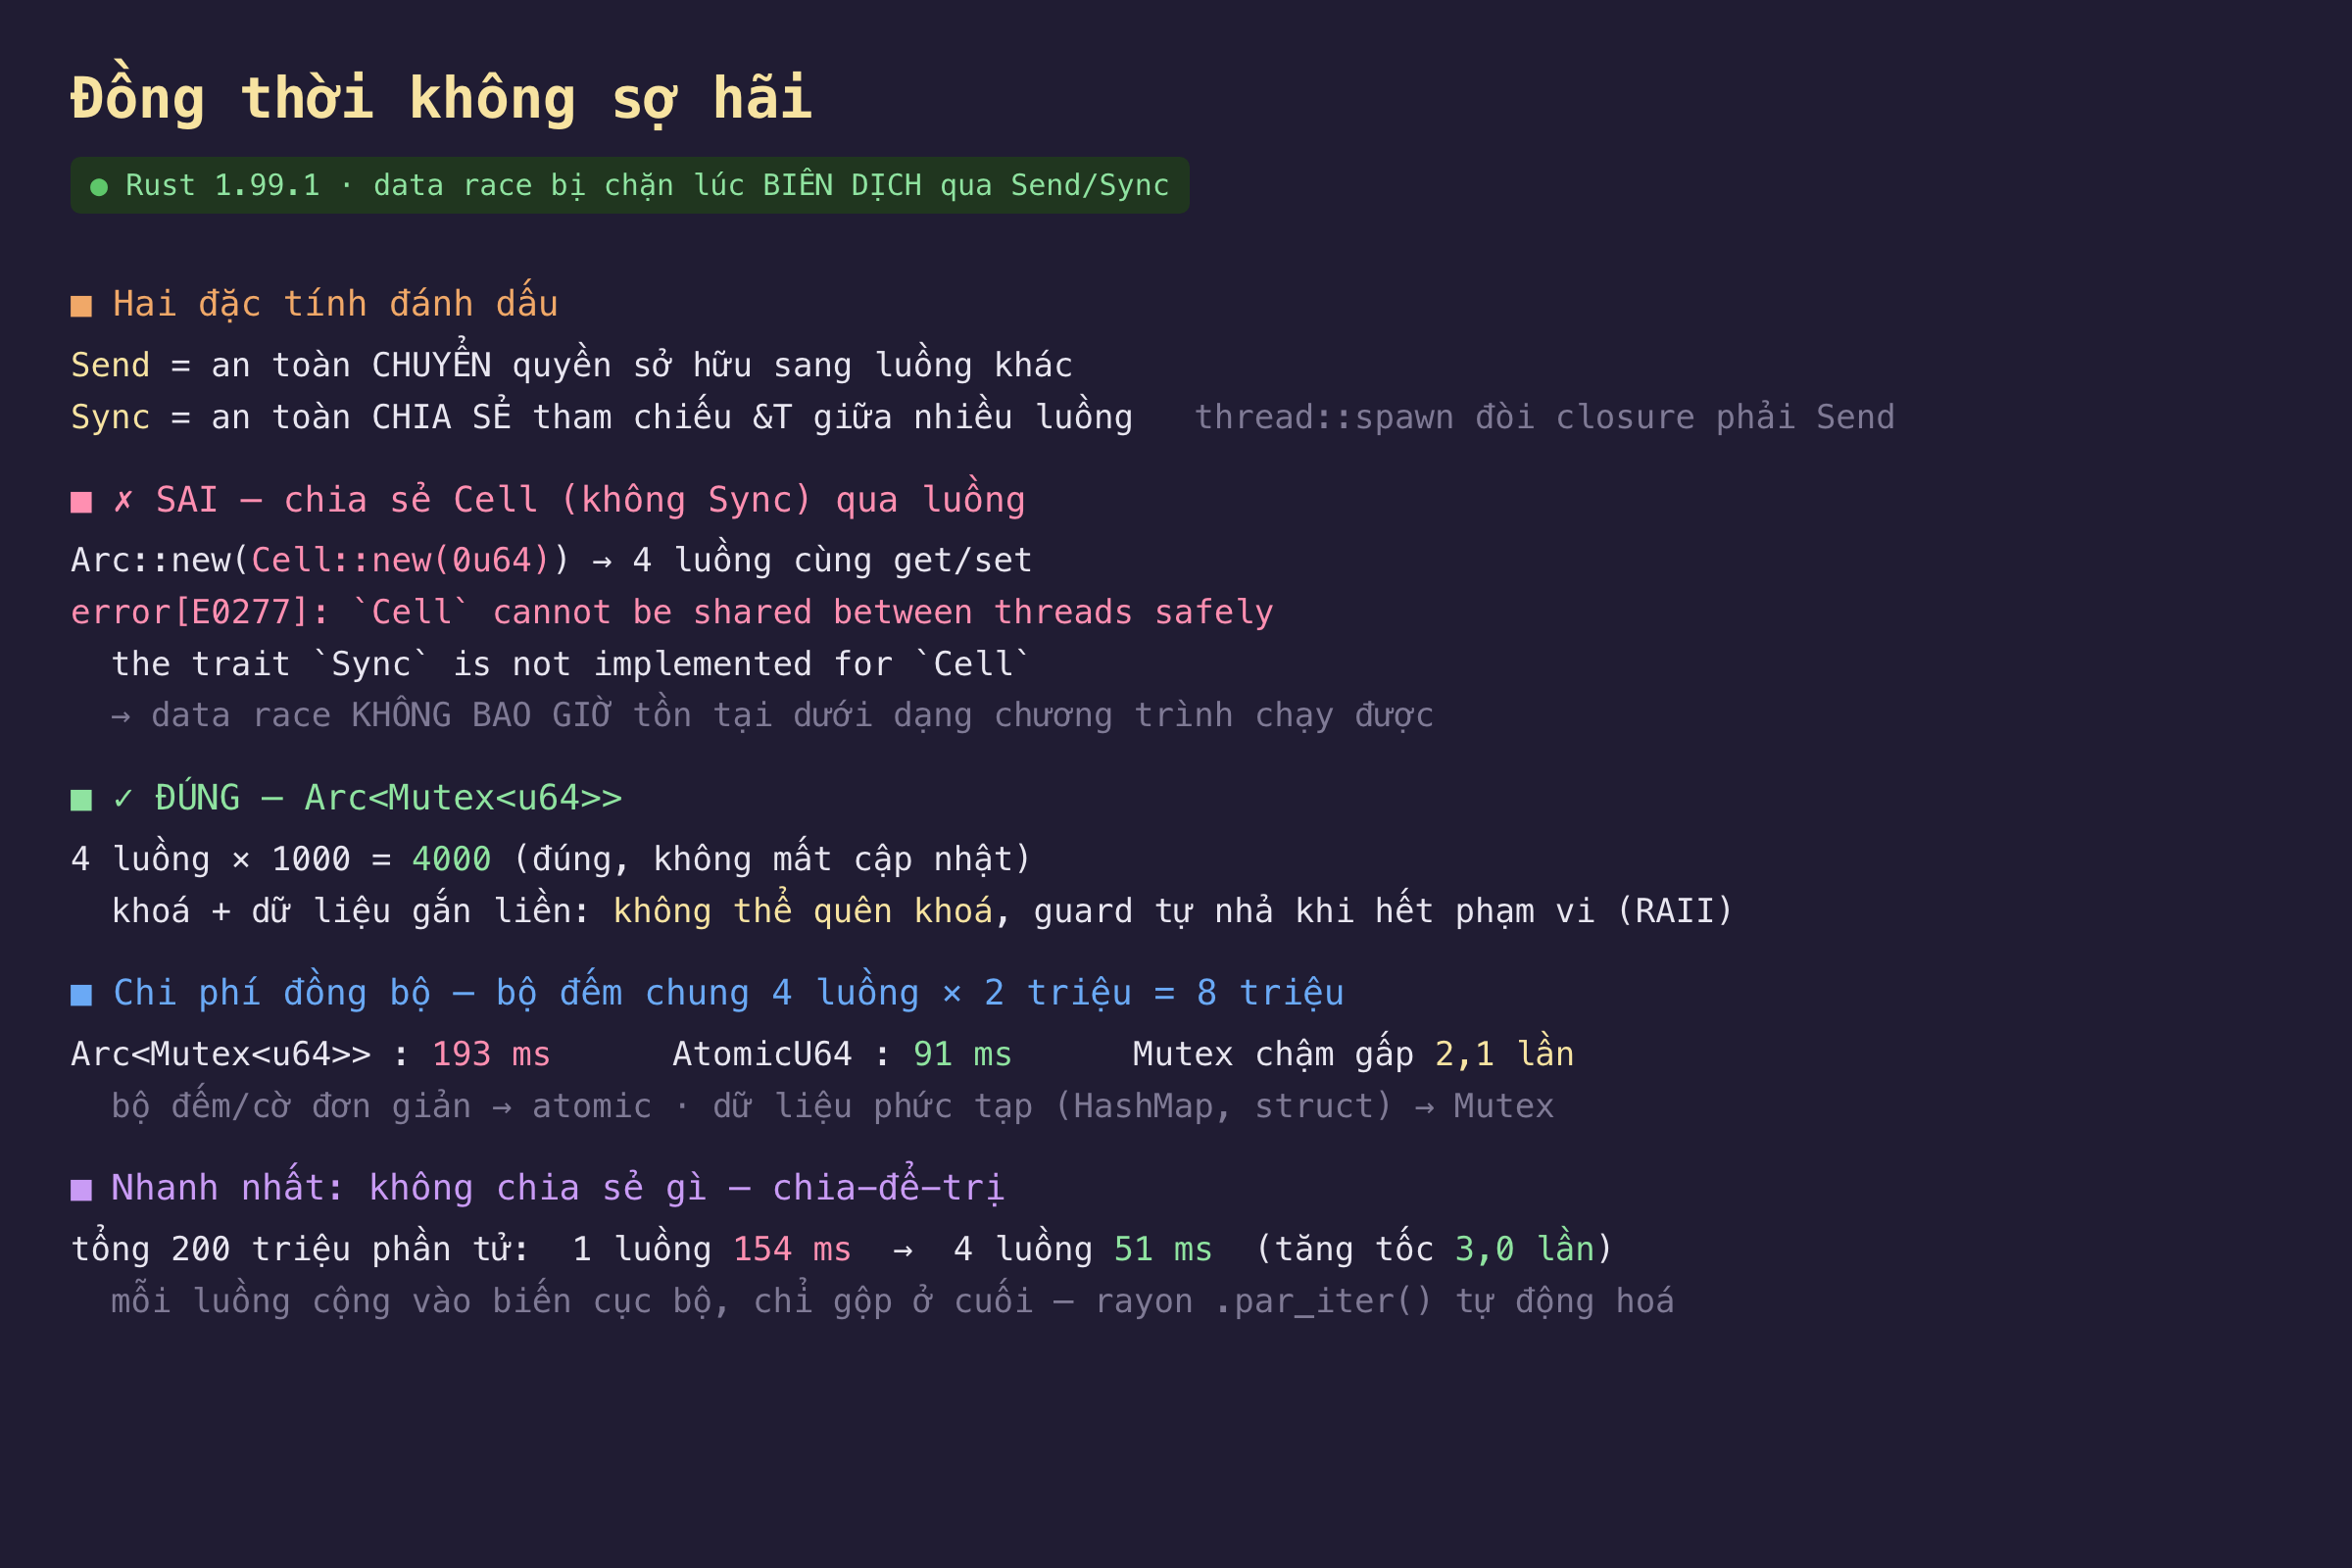
Hình 1: Data race bị chặn lúc biên dịch qua Send/Sync (E0277); Arc<Mutex> cho kết quả đúng; và chi phí các cách đồng bộ.
Chi phí đồng bộ: Mutex so với atomic
Không phải mọi chia sẻ đều cần Mutex. Với một bộ đếm số nguyên đơn giản, kiểu nguyên tử (atomic) rẻ hơn vì nó cập nhật bằng một lệnh CPU đặc biệt thay vì khoá/mở khoá cả một vùng. Đo bộ đếm chung, 4 luồng mỗi luồng cộng 2 triệu lần:
Bộ đếm chung, 4 luồng × 2.000.000 = 8.000.000:
(A) Arc<Mutex<u64>> : 193 ms   kết quả=8000000
(B) AtomicU64       :  91 ms   kết quả=8000000
Mutex chậm hơn atomic 2,1 lần
Cả hai cho kết quả đúng 8 triệu, nhưng Mutex chậm gấp 2,1 lần AtomicU64. Lý do: mỗi *m.lock().unwrap() += 1 phải lấy khoá, và khi bốn luồng cùng giành một khoá nóng, phần lớn thời gian là chờ nhau; còn fetch_add nguyên tử tranh chấp ở mức phần cứng, nhẹ hơn nhiều. Quy tắc: bộ đếm/cờ đơn giản thì dùng atomic; Mutex để dành cho dữ liệu phức tạp hơn một số nguyên (một HashMap, một struct nhiều trường) mà atomic không biểu diễn được.
Nhanh nhất là không chia sẻ gì cả
Cả Mutex lẫn atomic đều có chi phí vì chúng chia sẻ trạng thái. Cách scale tốt nhất thường là chia-để-trị: cắt công việc thành các mảnh độc lập, mỗi luồng làm trên dữ liệu riêng, không đụng gì tới nhau, rồi gộp kết quả cuối. Đo tổng của 200 triệu phần tử (mỗi phần tử qua một hàm băm nhỏ để không bị rút gọn):
Tổng việc(i), i in 0..200.000.000, 10 nhân khả dụng:
1 luồng : 154 ms   (=5763027079430274360)
4 luồng :  51 ms   (=5763027079430274360)
tăng tốc: 3,0 lần  (kết quả khớp)
Bốn luồng nhanh gấp 3 lần, cùng kết quả. Không Mutex, không atomic, không tranh chấp — mỗi luồng cộng dồn vào biến cục bộ của riêng nó, chỉ gộp bốn con số ở cuối. (Tăng tốc 3 lần chứ không phải 4 vì phí tạo luồng, chia dữ liệu, và băng thông bộ nhớ dùng chung.) Đây là mẫu hình mà các thư viện như rayon tự động hoá: biến .iter() thành .par_iter() là có song song chia-để-trị, và vẫn không sợ hãi vì Send/Sync canh ở biên dịch. Mô hình của Rust không chỉ bắt lỗi — nó khuyến khích đúng kiến trúc: giảm chia sẻ tới mức tối thiểu.
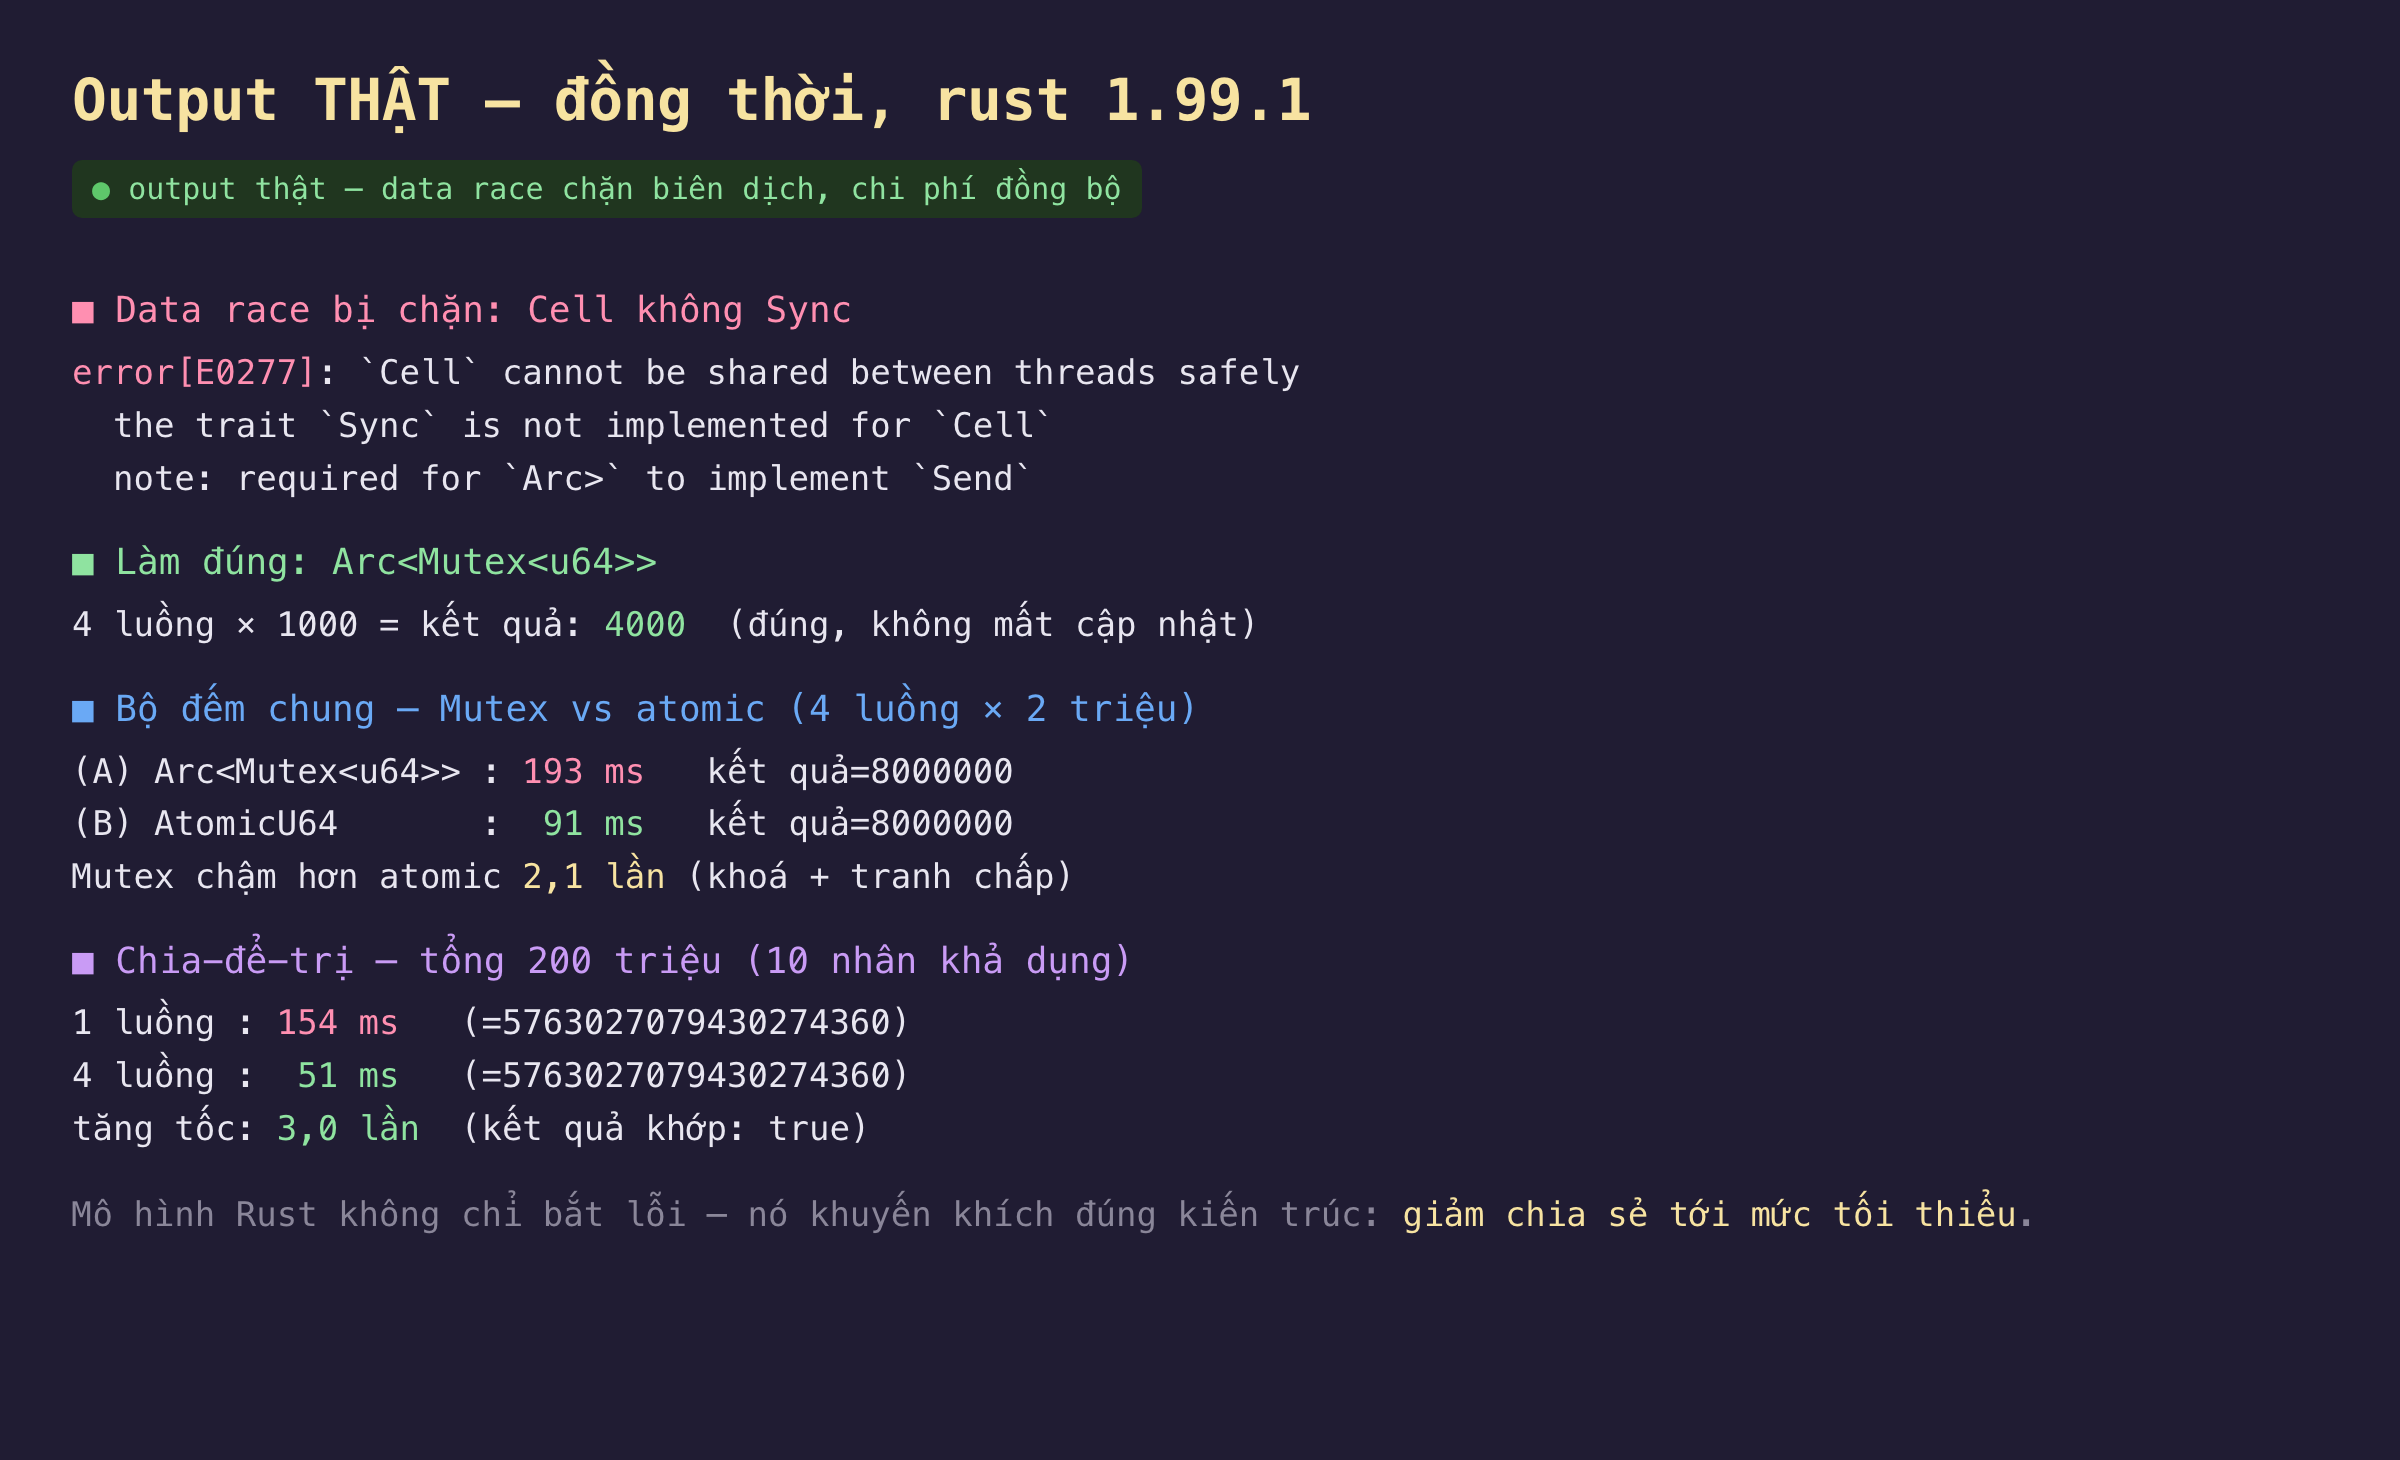
Hình 2: Số đo thật — E0277 chặn data race, Arc=4000, Mutex vs atomic 2,1 lần, và chia-để-trị tăng tốc 3 lần.
Gói lại
"Không sợ hãi" là một khẳng định đo được. Data race không bị bắt bằng chạy thử hay kỷ luật, mà bằng hệ thống kiểu: chia sẻ một Cell không Sync qua luồng cho E0277 ngay lúc biên dịch — chương trình sai không tồn tại. Khi cần chia sẻ thật, Arc<Mutex> cho kết quả đúng (4000, không mất cập nhật) và không cho bạn quên khoá; nhưng nó có giá — chậm gấp 2,1 lần atomic cho một bộ đếm — nên chọn atomic cho cái đơn giản, và tốt hơn nữa là chia-để-trị không chia sẻ gì để đạt tăng tốc 3 lần. Rust cho bạn chạy song song mà không phải sợ cái loại bug tốn-cả-tuần-để-tìm. Bài sau nhìn một mô hình đồng thời khác mà Rust cũng mạnh: async/await với Tokio — hàng nghìn tác vụ trên vài luồng, và chi phí bộ nhớ mỗi tác vụ so với một luồng hệ điều hành.
