Phần lớn những gì làm người dùng ngạc nhiên về hiệu năng MySQL bắt nguồn từ đúng một quyết định thiết kế của InnoDB: bảng không nằm cạnh index, bảng chính là index. Hiểu được điều này thì chuyện tại sao tra theo khóa chính nhanh gần như tức thì, tại sao chọn kiểu khóa chính lại quan trọng, và tại sao secondary index đắt hơn ta tưởng — tất cả rơi vào đúng chỗ. Sê-ri này mổ xẻ MySQL 8 và storage engine InnoDB bằng cách đo thật từng cơ chế trong container; bài mở đầu đặt nền: clustered index là gì, và nó định hình mọi phép truy cập ra sao. Toàn bộ con số dưới đây đo trực tiếp trên một bảng một triệu dòng chạy trong mysql:8.
Clustered index: bảng không nằm cạnh index, bảng LÀ index
Nhiều người hình dung một bảng gồm hai thứ tách rời: vùng dữ liệu chứa các hàng, và các index trỏ vào vùng đó. Đó là mô hình heap — PostgreSQL dùng nó, với vùng heap chứa hàng còn index chứa con trỏ vật lý (ctid) tới heap. InnoDB làm khác hẳn. Mỗi bảng InnoDB được lưu như một cây B+ khóa theo khóa chính (primary key), và các nút lá của cây đó chứa trọn vẹn cả hàng, không chỉ khóa. Cây này gọi là clustered index. Không có vùng heap riêng: clustered index chính là bảng.
Hệ quả xâu chuỗi từ đó. Tra một hàng theo khóa chính là đi xuống cây một lần tới đúng lá chứa hàng — không có bước nhảy thêm. Các hàng nằm trong lá theo đúng thứ tự khóa chính, nên một dải khóa chính là một vùng lá liền nhau. Và vì hàng sống trong lá của cây khóa chính, mọi secondary index (index trên cột khác) không thể trỏ bằng địa chỉ vật lý — nó lưu giá trị khóa chính của hàng, rồi muốn lấy hàng phải tra lại clustered index lần nữa. Bài này đo hai hệ quả đầu; hệ quả thứ ba để dành cho phần nói về secondary index.
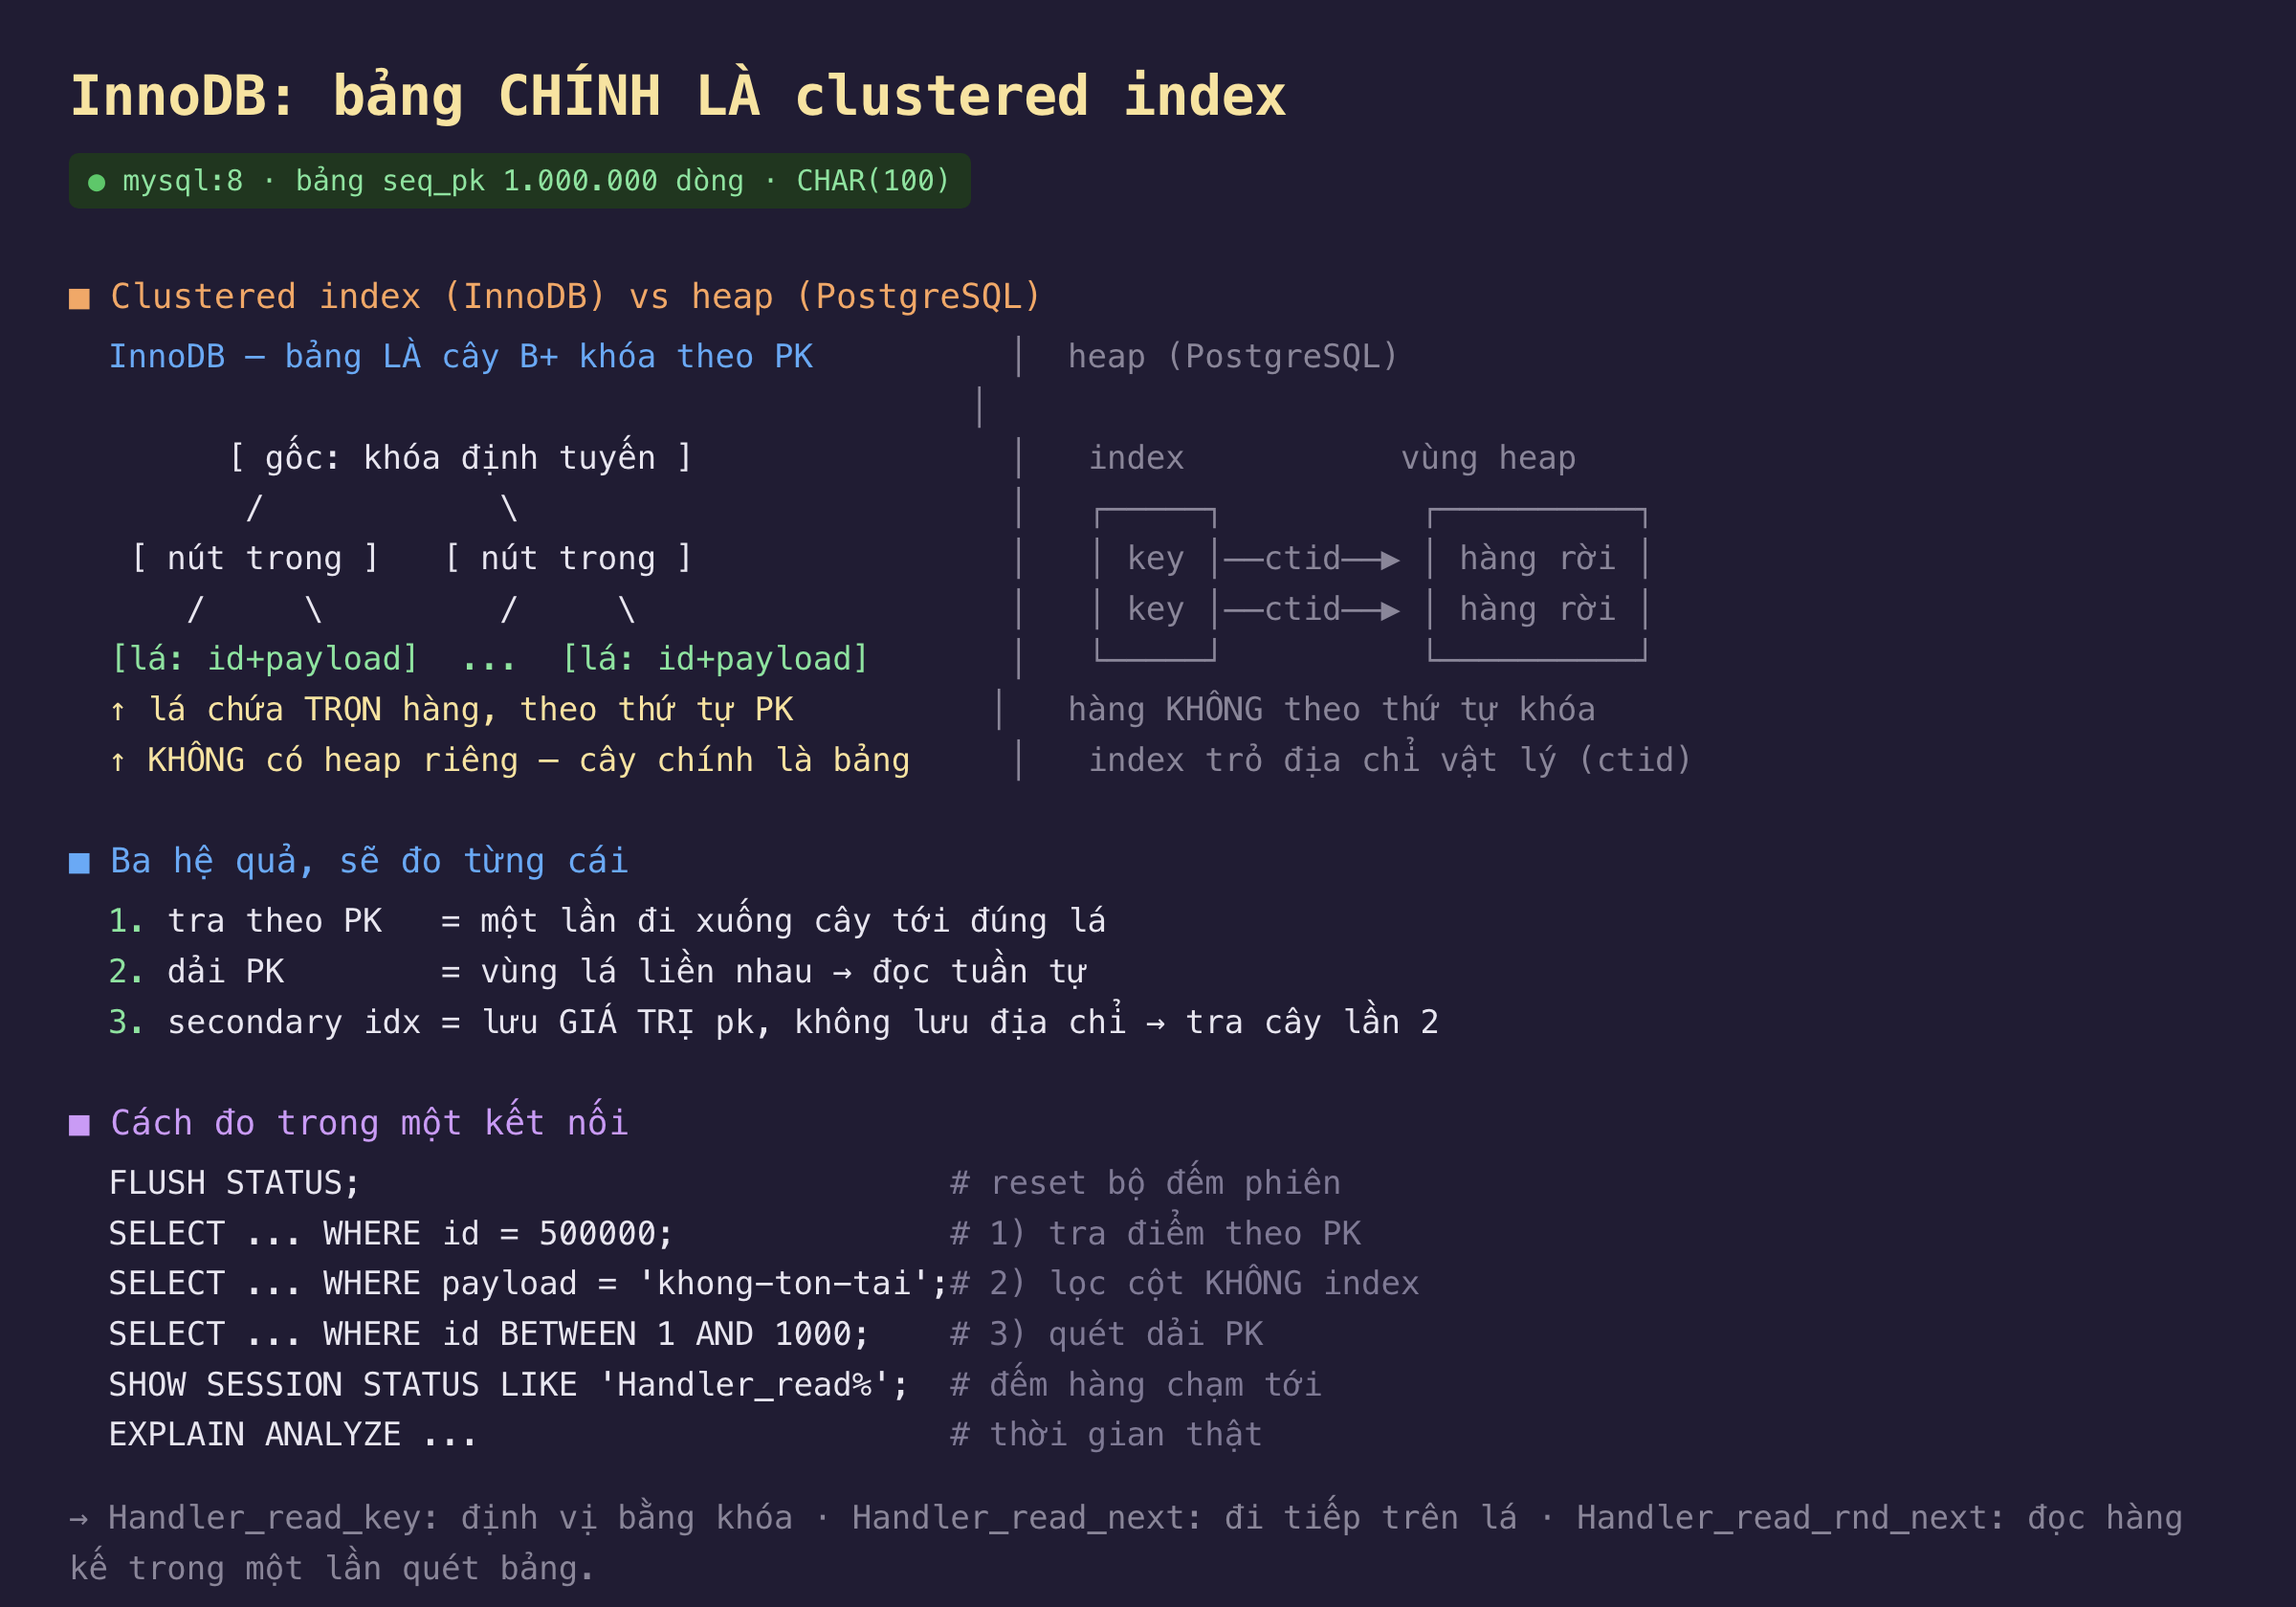
Hình 1: InnoDB lưu bảng như một cây B+ khóa theo khóa chính, lá chứa trọn hàng (clustered index), khác mô hình heap; và cách đo ba kiểu truy cập.
Tra theo khóa chính: một lần đi xuống cây
Bảng đo tên seq_pk, một triệu dòng, khóa chính id tăng dần, cột payload kiểu CHAR(100), tổng khoảng 131,7 MB. Tra một hàng theo khóa chính, rồi đọc bộ đếm handler ngay trong cùng kết nối:
FLUSH STATUS;
SELECT payload FROM seq_pk WHERE id = 500000;
SHOW SESSION STATUS WHERE Variable_name
  IN ('Handler_read_key','Handler_read_next','Handler_read_rnd_next');
Kết quả: Handler_read_key = 1, hai bộ đếm còn lại bằng 0. Đúng một thao tác "định vị bằng khóa" trên cây, không có bước duyệt tiếp nào. EXPLAIN cho type = const, key = PRIMARY, rows = 1; còn EXPLAIN ANALYZE đo thời gian thực thi 0,015 ms cho truy vấn này. InnoDB đi từ gốc cây xuống lá qua vài tầng rồi chạm đúng hàng — nhanh tới mức MySQL xếp nó vào loại const, giải quyết ngay trong lúc tối ưu. Đây là phép truy cập rẻ nhất mà một bảng InnoDB có thể cho: một lần đi xuống clustered index.
Lọc theo cột không index: duyệt sạch một triệu lá
Giờ hỏi cùng bảng đó một câu không chạm được khóa chính — lọc theo payload, cột không có index:
FLUSH STATUS;
SELECT COUNT(*) FROM seq_pk WHERE payload = 'khong-ton-tai';
SHOW SESSION STATUS WHERE Variable_name
  IN ('Handler_read_key','Handler_read_next','Handler_read_rnd_next');
Lần này Handler_read_rnd_next = 1.000.001 — bộ đếm "đọc hàng tiếp theo trong một lần quét bảng" nhảy lên đúng bằng số hàng cộng một. EXPLAIN cho type = ALL (quét toàn bảng), và EXPLAIN ANALYZE đo 161 ms, trong đó riêng bước Table scan on seq_pk mất 119 ms để đi qua một triệu hàng. Chênh lệch với tra khóa chính là hơn mười nghìn lần về số hàng chạm tới và về thời gian.
Điểm mấu chốt không phải "quét bảng thì chậm" — điều đó ai cũng biết. Điểm mấu chốt là vì sao quét bảng ở InnoDB chính là duyệt lá của clustered index. Không có vùng heap tách biệt để nhảy tới; muốn đọc mọi hàng, InnoDB đi qua từng lá của chính cây khóa chính. Bảng là cây, nên "quét toàn bảng" và "duyệt hết lá clustered index" là một. Đó là lý do một cột thường được truy vấn mà thiếu index sẽ kéo cả bảng vào mỗi lần hỏi.
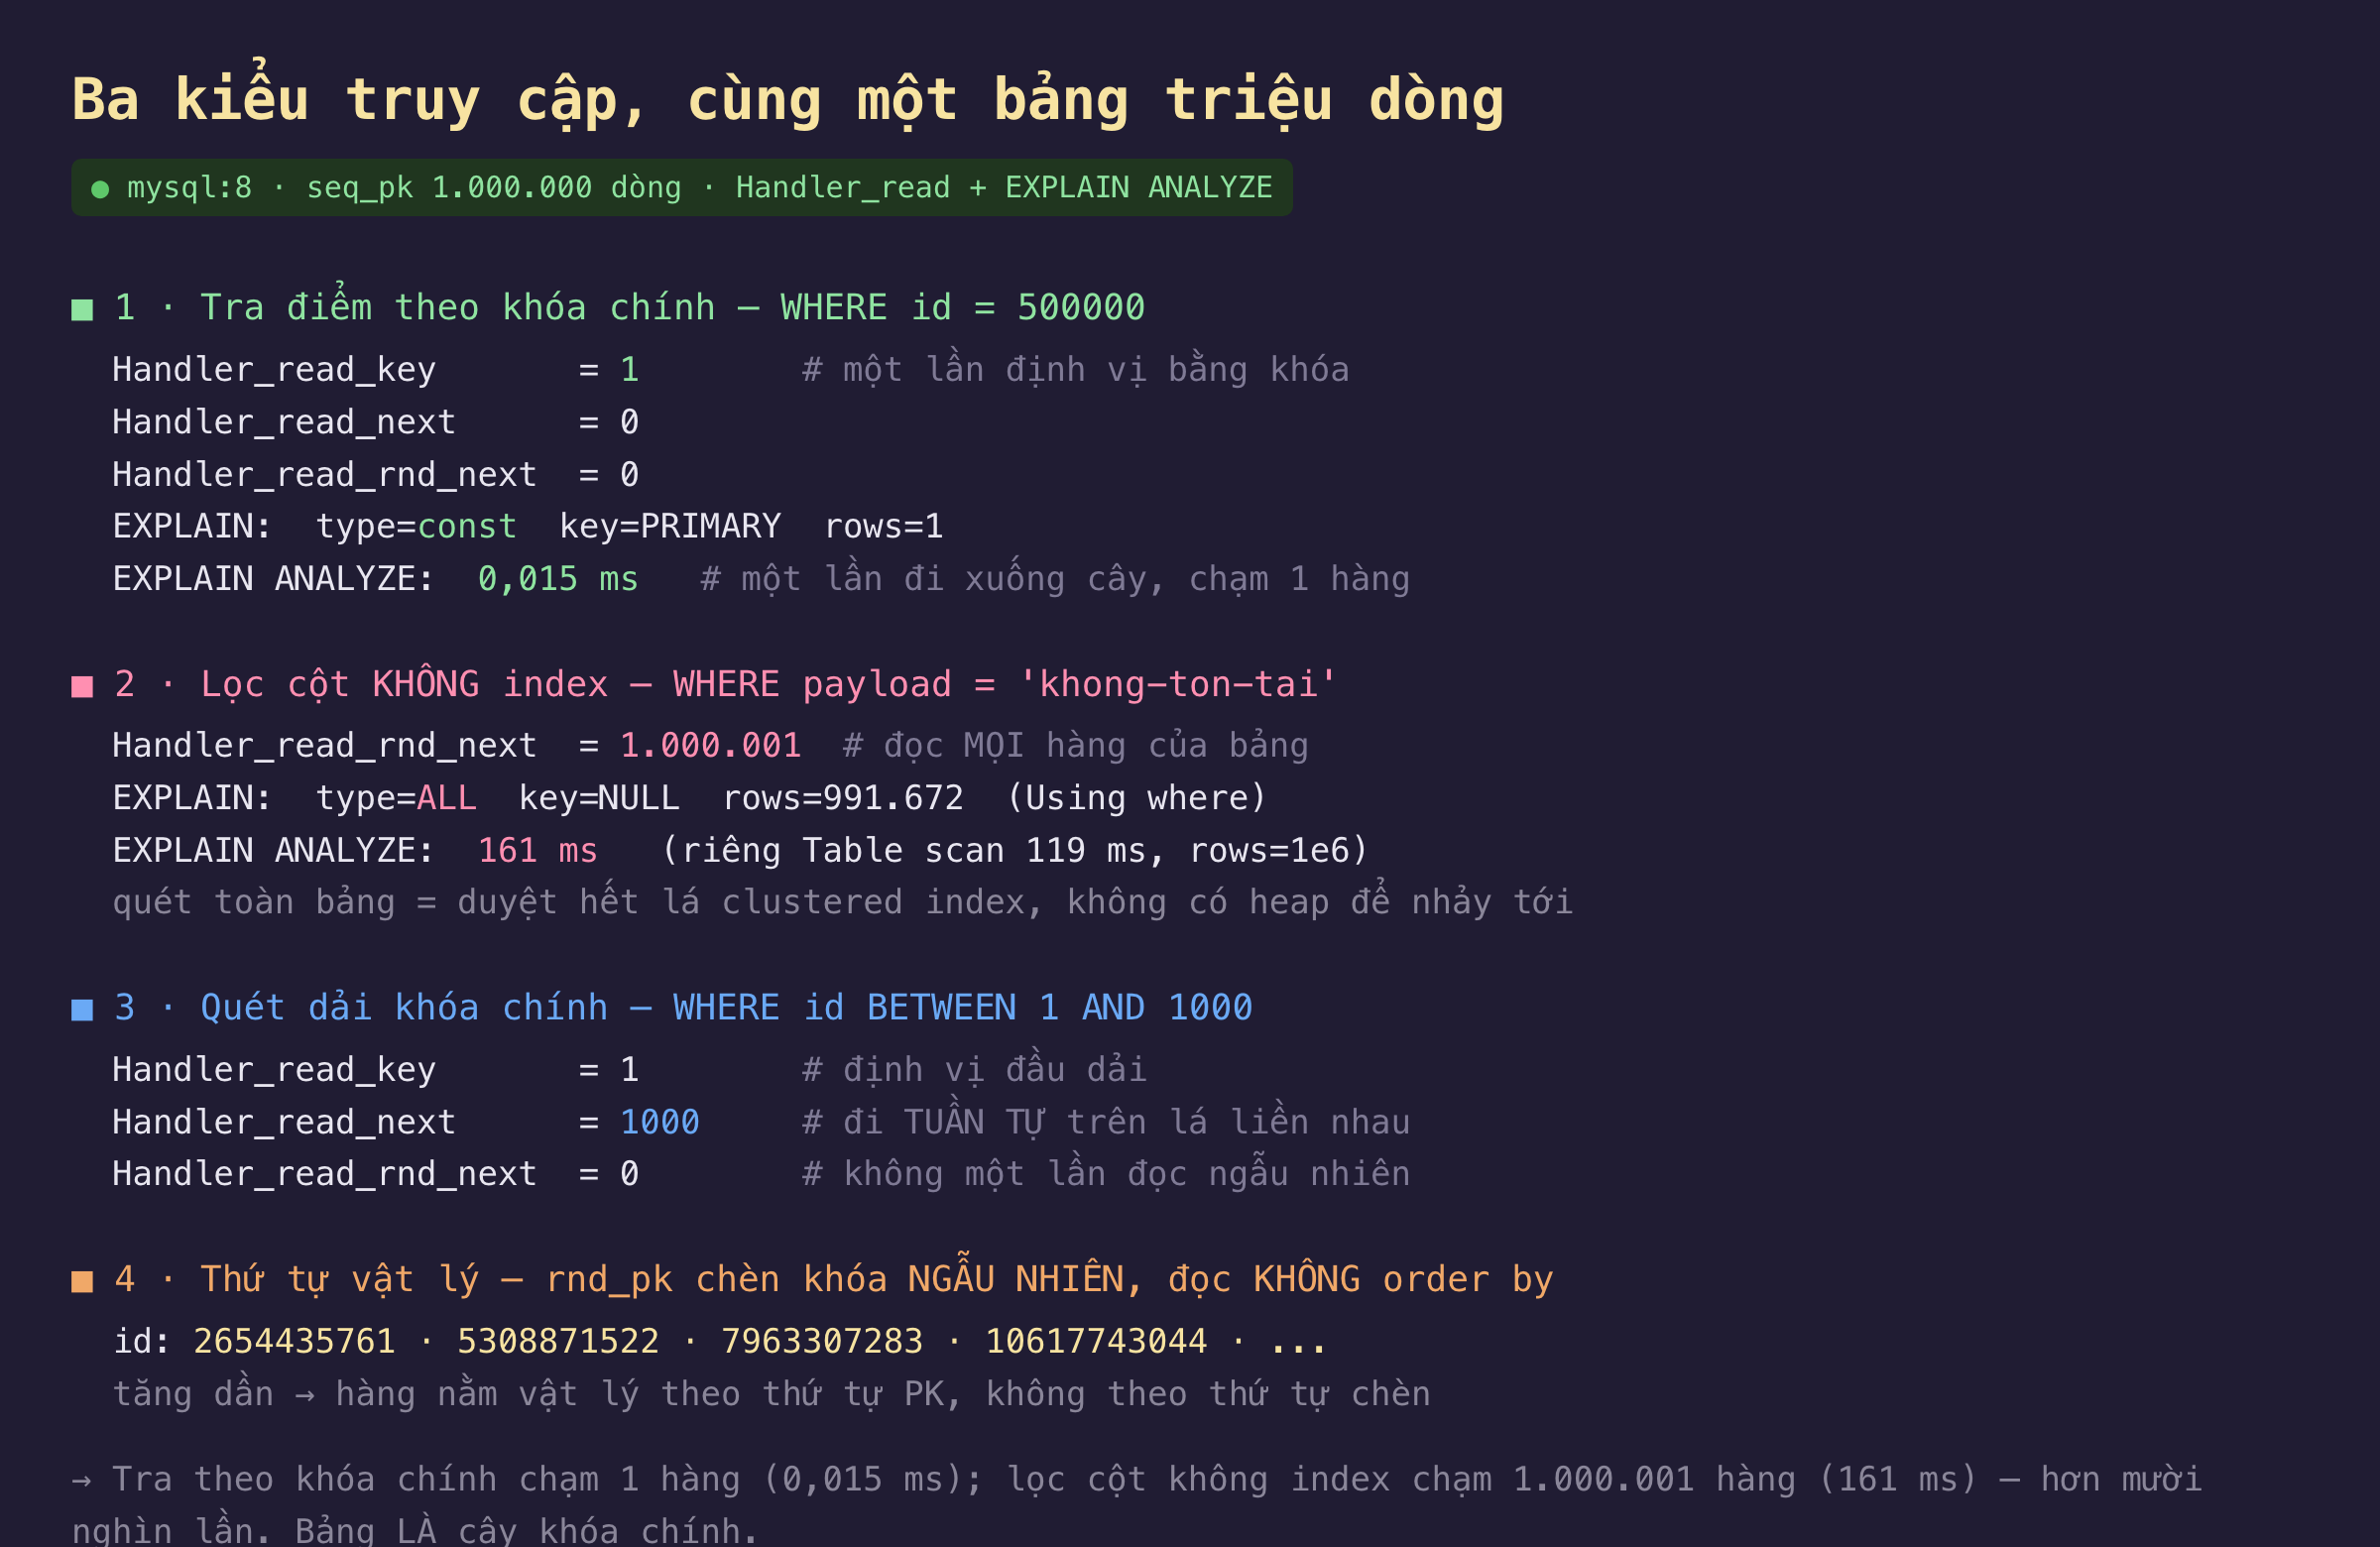
Hình 2: ba kiểu truy cập đo thật — tra khóa chính chạm 1 hàng, lọc cột không index duyệt 1.000.001 hàng, quét dải khóa chính đi tuần tự trên lá.
Hàng nằm vật lý theo thứ tự khóa chính
Hệ quả thứ hai của clustered index là thứ tự vật lý. Vì lá của cây được sắp theo khóa chính, các hàng nằm trên đĩa theo đúng thứ tự đó — bất kể chèn vào lúc nào. Để thấy rõ, bảng rnd_pk được chèn một triệu hàng với khóa chính rải rác ngẫu nhiên (nhân với một số lớn rồi lấy dư), vậy mà đọc ra năm hàng đầu không kèm ORDER BY:
2654435761
5308871522
7963307283
10617743044
13272178805
Chúng tăng dần — tức InnoDB trả hàng theo thứ tự khóa chính, không theo thứ tự chèn, vì đó là thứ tự chúng nằm trong lá. Và một dải khóa chính là một vùng lá liền nhau: SELECT COUNT(*) FROM seq_pk WHERE id BETWEEN 1 AND 1000 cho Handler_read_key = 1 (định vị đầu dải) rồi Handler_read_next = 1000 (đi tuần tự), Handler_read_rnd_next = 0 — không một lần đọc ngẫu nhiên nào. Quét dải trên khóa chính là đọc tuần tự, rẻ như trượt dọc một mảng.
Thứ tự vật lý này là con dao hai lưỡi, và nó quyết định cách chọn khóa chính. Khóa chính tăng dần (như AUTO_INCREMENT) khiến mọi hàng mới chèn vào cuối cây — điểm chèn luôn ở một chỗ, trang lấp đầy gọn gàng. Khóa chính ngẫu nhiên (như UUID sinh ngẫu nhiên) khiến điểm chèn nhảy khắp cây, trang phải tách ra liên tục để nhường chỗ, làm bảng phình và ghi chậm hơn. Đây là lý do tài liệu InnoDB khuyên khóa chính nên ngắn, tăng dần và ít đổi. Cùng lẽ đó, vì mọi secondary index đều mang theo giá trị khóa chính để tra ngược, khóa chính dài còn làm mọi index khác to theo — một điểm sê-ri sẽ đo kỹ ở phần về secondary index.
Ba ý mang về
- Trong InnoDB, bảng chính là clustered index — một cây B+ khóa theo khóa chính, lá chứa trọn hàng, không có heap riêng. Tra theo khóa chính là một lần đi xuống cây:
Handler_read_key = 1,type = const, 0,015 ms, chạm đúng một hàng. Đây là phép truy cập rẻ nhất của bảng. - Lọc theo cột không index chính là duyệt hết lá của clustered index. Vì không có vùng heap tách biệt, câu lọc
payloadkhông index choHandler_read_rnd_next = 1.000.001và mất 161 ms trên một triệu hàng — chạm nhiều hơn mười nghìn lần so với tra khóa chính. "Quét toàn bảng" và "duyệt hết clustered index" là một. - Hàng nằm vật lý theo thứ tự khóa chính, nên chọn khóa chính là quyết định về hiệu năng. Dải khóa chính là đọc tuần tự (
Handler_read_next = 1000, không đọc ngẫu nhiên); khóa tăng dần lấp trang gọn, khóa ngẫu nhiên gây tách trang. Khóa chính nên ngắn và tăng dần vì mọi secondary index đều gánh theo nó.
Nguồn
- MySQL 8.4 Reference Manual — Clustered and Secondary Indexes, mô tả clustered index và cách secondary index mang khóa chính: https://dev.mysql.com/doc/refman/8.4/en/innodb-index-types.html
- MySQL 8.4 Reference Manual — InnoDB Index and Table Structures: https://dev.mysql.com/doc/refman/8.4/en/innodb-physical-structure.html
- MySQL 8.4 Reference Manual — EXPLAIN ANALYZE và các bộ đếm
Handler_read_*: https://dev.mysql.com/doc/refman/8.4/en/server-status-variables.html - MySQL 8.4 Reference Manual — AUTO_INCREMENT Handling in InnoDB, vì sao khóa tăng dần tốt cho clustered index: https://dev.mysql.com/doc/refman/8.4/en/innodb-auto-increment-handling.html
Phần sau đi vào buffer pool — vùng nhớ InnoDB dùng để giữ các trang clustered index và index trong RAM. Đo hit ratio thật, xem innodb_buffer_pool_size ảnh hưởng số lần đọc đĩa ra sao, và vì sao một truy vấn "chậm" lần đầu lại nhanh hẳn ở các lần sau.
