Khi một truy vấn chậm, câu hỏi đầu tiên không phải "nó trả về bao nhiêu dòng" mà "nó quét bao nhiêu dòng để tìm ra chúng". Hai con số này có thể lệch nhau cả vạn lần, và chính con số thứ hai — rows examined — quyết định thời gian. EXPLAIN và EXPLAIN ANALYZE là hai công cụ để nhìn thấy nó: một cái cho kế hoạch và ước tính trước khi chạy, một cái cho số thật sau khi chạy. Bài này đo thật khoảng cách giữa dòng quét và dòng trả về, chỉ ra cách đọc hai lệnh đó, và vì sao ước tính lệch số thật là cảnh báo sớm của một kế hoạch sắp đi sai.
Cùng một kết quả, quét 100 dòng hay 1.000.000 dòng
Lấy một truy vấn đơn giản trên bảng ord một triệu dòng: đếm số dòng có cust = 5000. Kết quả là 100, bất kể chạy thế nào. Nhưng ép hai kế hoạch khác nhau rồi đo số dòng quét bằng bộ đếm handler:
-- kế hoạch 1: dùng index k_cust
FLUSH STATUS;
SELECT COUNT(id) FROM ord WHERE cust = 5000;              -- trả về 100
-- Handler_read_key = 1, Handler_read_next = 100          → quét 100 dòng

-- kế hoạch 2: bỏ index, buộc quét toàn bảng
FLUSH STATUS;
SELECT COUNT(id) FROM ord IGNORE INDEX(k_cust) WHERE cust = 5000;  -- vẫn trả về 100
-- Handler_read_rnd_next = 1.000.001                      → quét 1.000.000 dòng
Cùng một câu hỏi, cùng một đáp số 100 dòng, nhưng một kế hoạch quét 100 dòng còn kế hoạch kia quét một triệu. EXPLAIN ANALYZE đo thời gian: bản dùng index 0,013 ms, bản quét toàn bảng 100 ms — chênh khoảng 7.700 lần. Số dòng trả về không hề nói lên điều này; nó giống hệt nhau ở cả hai. Thứ khác nhau là số dòng phải chạm vào để lọc ra đáp số, và đó là thứ ngốn thời gian.
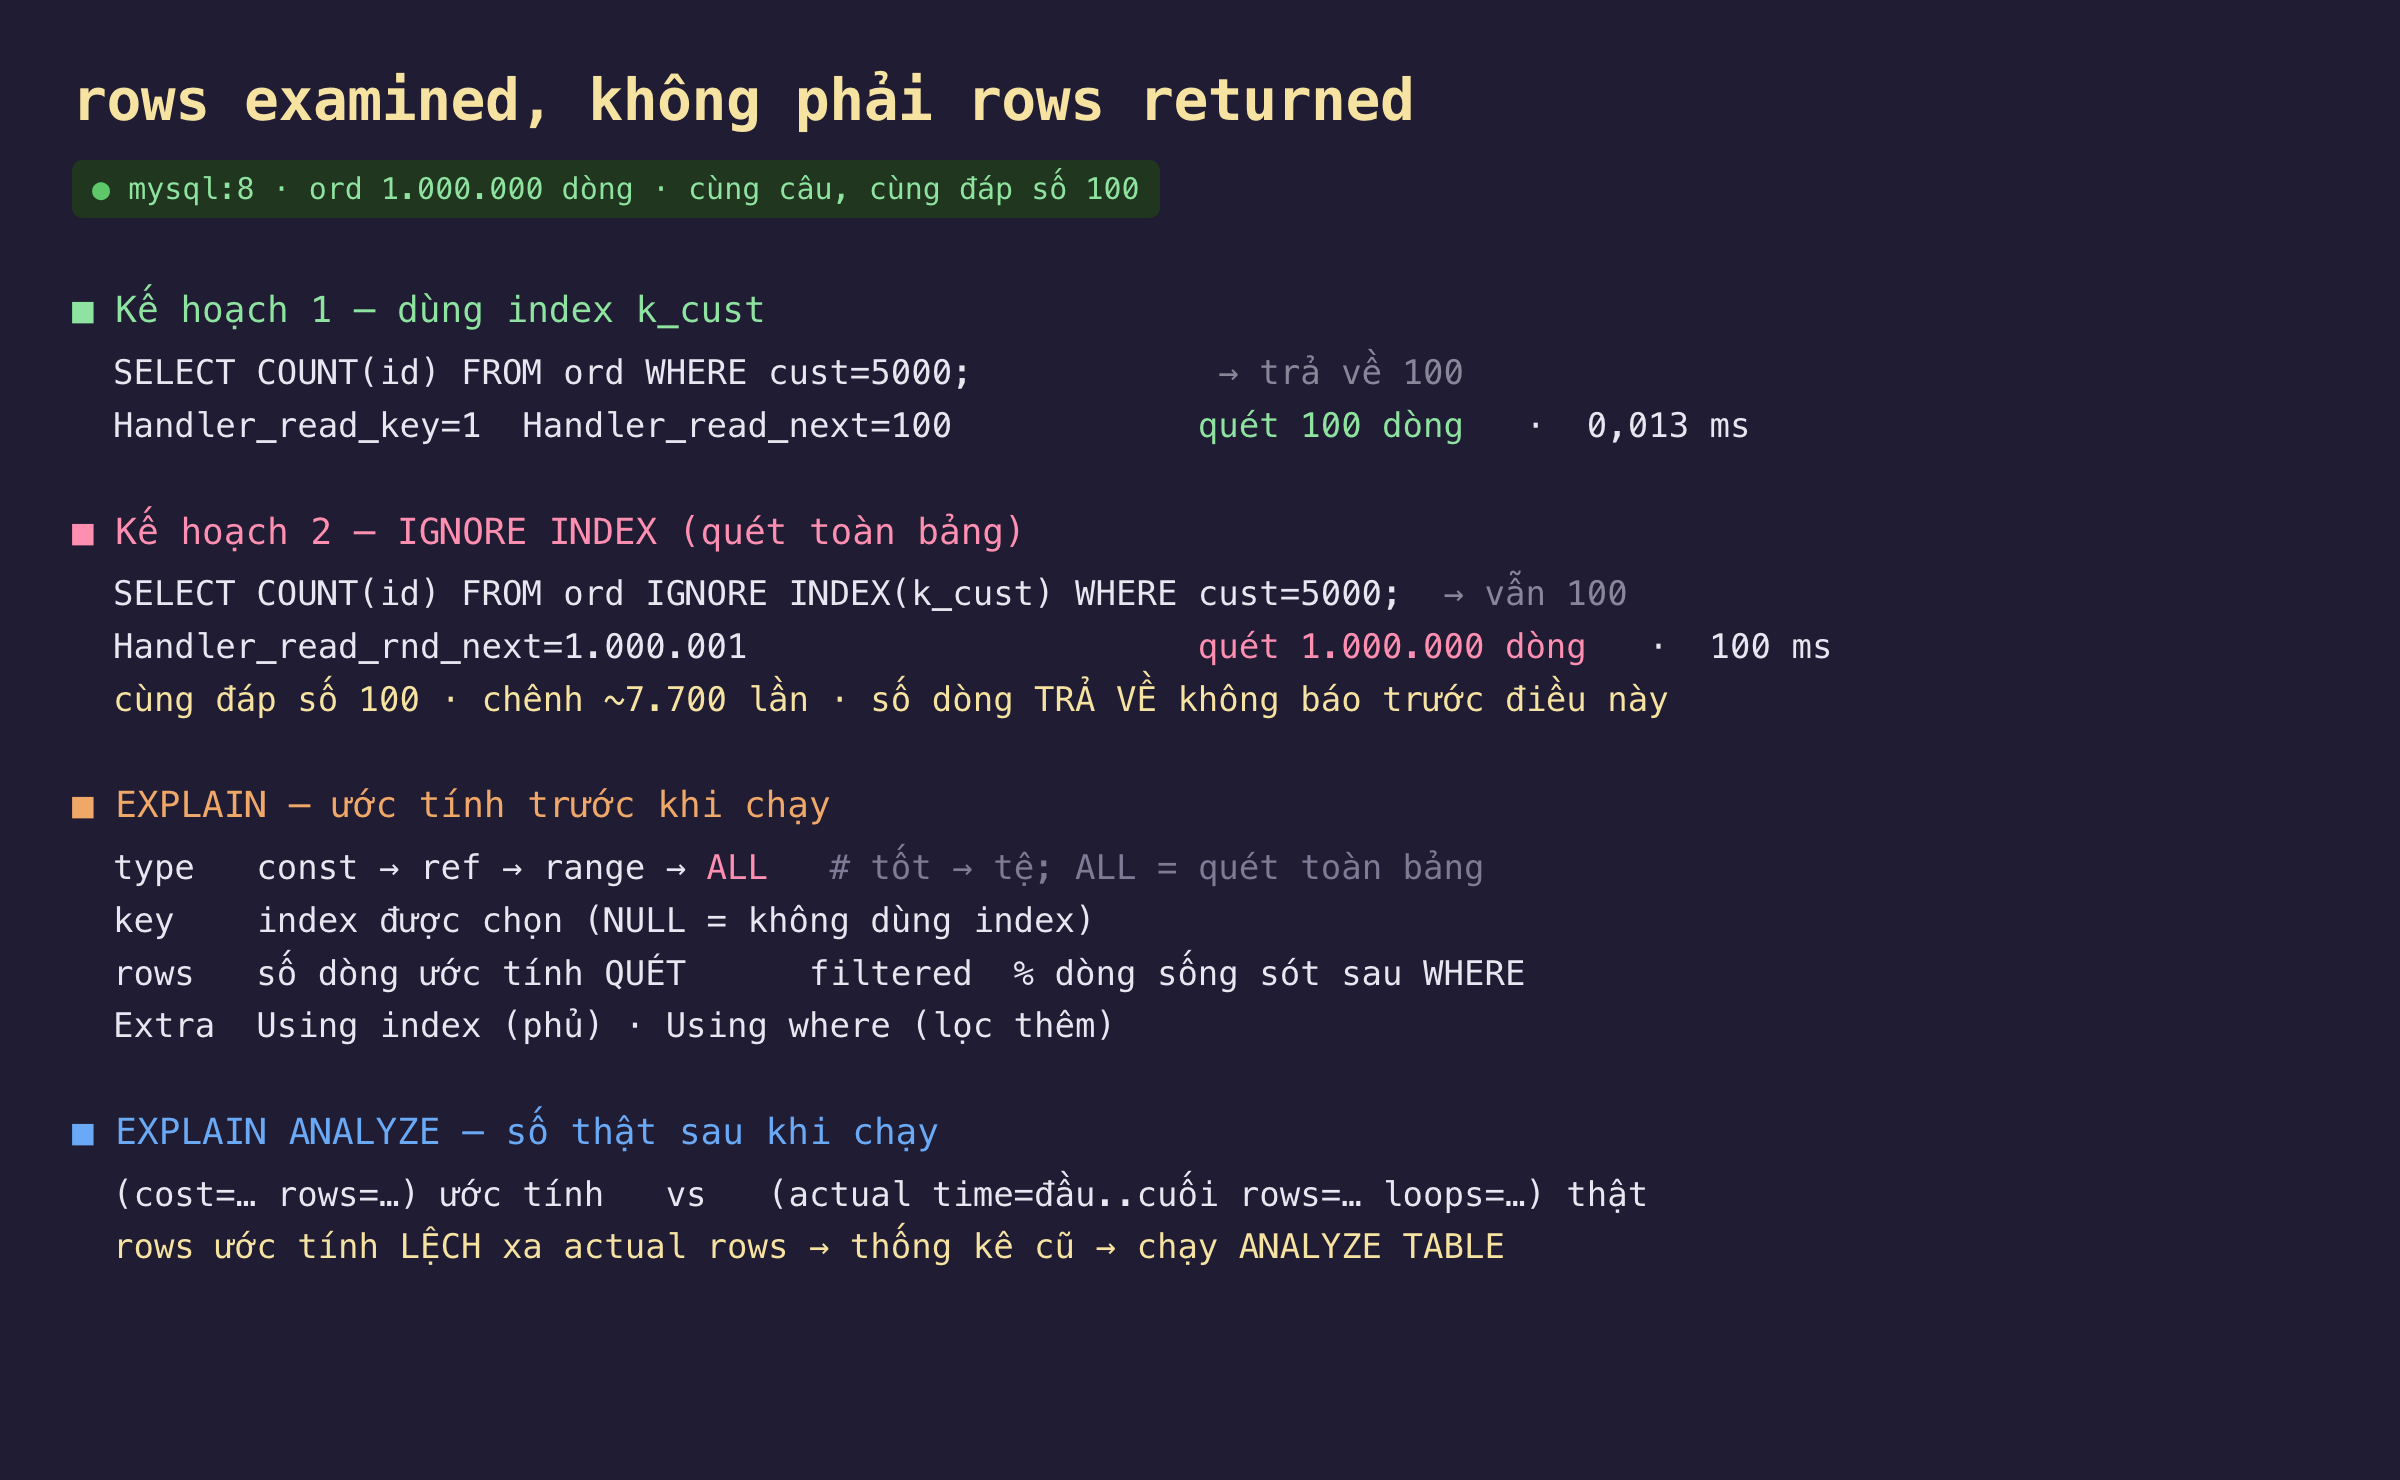
Hình 1: số dòng trả về giống nhau, số dòng quét chênh 10.000 lần; đó là lý do rows examined — không phải rows returned — quyết định thời gian.
Trả về 0 dòng vẫn có thể chậm
Một hệ quả ngược đời của nguyên tắc trên: một truy vấn không trả về dòng nào vẫn có thể rất chậm. Lọc theo payload — cột không có index — với một chuỗi không tồn tại:
FLUSH STATUS;
SELECT COUNT(*) FROM ord WHERE payload LIKE '%khong-bao-gio-co%';   -- trả về 0
-- Handler_read_rnd_next = 1.000.001                                 → quét 1.000.000 dòng
Đáp số là 0, nhưng để chắc chắn không dòng nào khớp, InnoDB phải đọc và kiểm mọi dòng — một triệu lần. Số dòng trả về bằng không, số dòng quét bằng cả bảng. Đây là lý do "truy vấn này trả về ít dữ liệu mà" không bao giờ là lời bào chữa cho một truy vấn chậm: công sức nằm ở việc tìm, không ở việc trả.
Đọc EXPLAIN: ước tính trước khi chạy
EXPLAIN không chạy truy vấn; nó cho kế hoạch mà optimizer định dùng, với các cột cần đọc kỹ nhất:
EXPLAIN SELECT id FROM ord WHERE cust = 5000 AND payload LIKE '%zzz%';
+------+--------+---------+------+----------+-------------+
| type | key    | key_len | rows | filtered | Extra       |
+------+--------+---------+------+----------+-------------+
| ref  | k_cust | 4       |  100 |    11.11 | Using where |
type là kiểu truy cập, từ tốt tới tệ: const (một dòng qua khóa), ref (vài dòng qua index), range (một dải index), tới ALL (quét toàn bảng — dấu hiệu thiếu index). key là index được chọn (NULL nghĩa là không dùng index nào). rows là số dòng optimizer ước tính phải quét — ở đây 100, đúng bằng số dòng có cust = 5000. filtered là phần trăm số dòng ước tính sống sót sau phần WHERE còn lại: 11,11% nghĩa là optimizer đoán khoảng một phần chín trong 100 dòng đó sẽ qua được điều kiện payload LIKE. Extra mang những cờ quan trọng như Using index (index phủ, không tra ngược — xem phần trước) hay Using where (lọc thêm sau khi đọc).
Đọc EXPLAIN ANALYZE: số thật, và khi nào ước tính sai
EXPLAIN ANALYZE chạy thật truy vấn rồi in cây thực thi kèm số đo. Mỗi nút có dạng (cost=… rows=…) là ước tính, và (actual time=bắt_đầu..kết_thúc rows=… loops=…) là số thật. Ví dụ nút quét index cho cust = 5000:
-> Index lookup on ord using k_cust (cust=5000)
     (cost=54.5 rows=100) (actual time=0.0262..0.145 rows=100 loops=1)
So rows=100 (ước tính) với actual ... rows=100 (thật) thấy chúng khớp — kế hoạch đáng tin. Giá trị chẩn đoán lớn nhất của lệnh này là phát hiện khi hai con số lệch xa nhau: nếu optimizer ước tính một nút trả 100 dòng mà thực tế trả một triệu, mọi quyết định xây trên ước tính sai đó — chọn index nào, nối bảng theo thứ tự nào — đều có thể sai theo. Nguyên nhân thường gặp là thống kê bảng đã cũ; cách chữa là chạy ANALYZE TABLE để optimizer cập nhật lại phân bố dữ liệu. actual time còn tách thời gian tới dòng đầu và tới dòng cuối, và loops cho biết một nút bị chạy lại bao nhiêu lần trong phép nối — hai manh mối hay bị bỏ qua khi truy số chậm trong truy vấn nhiều bảng.
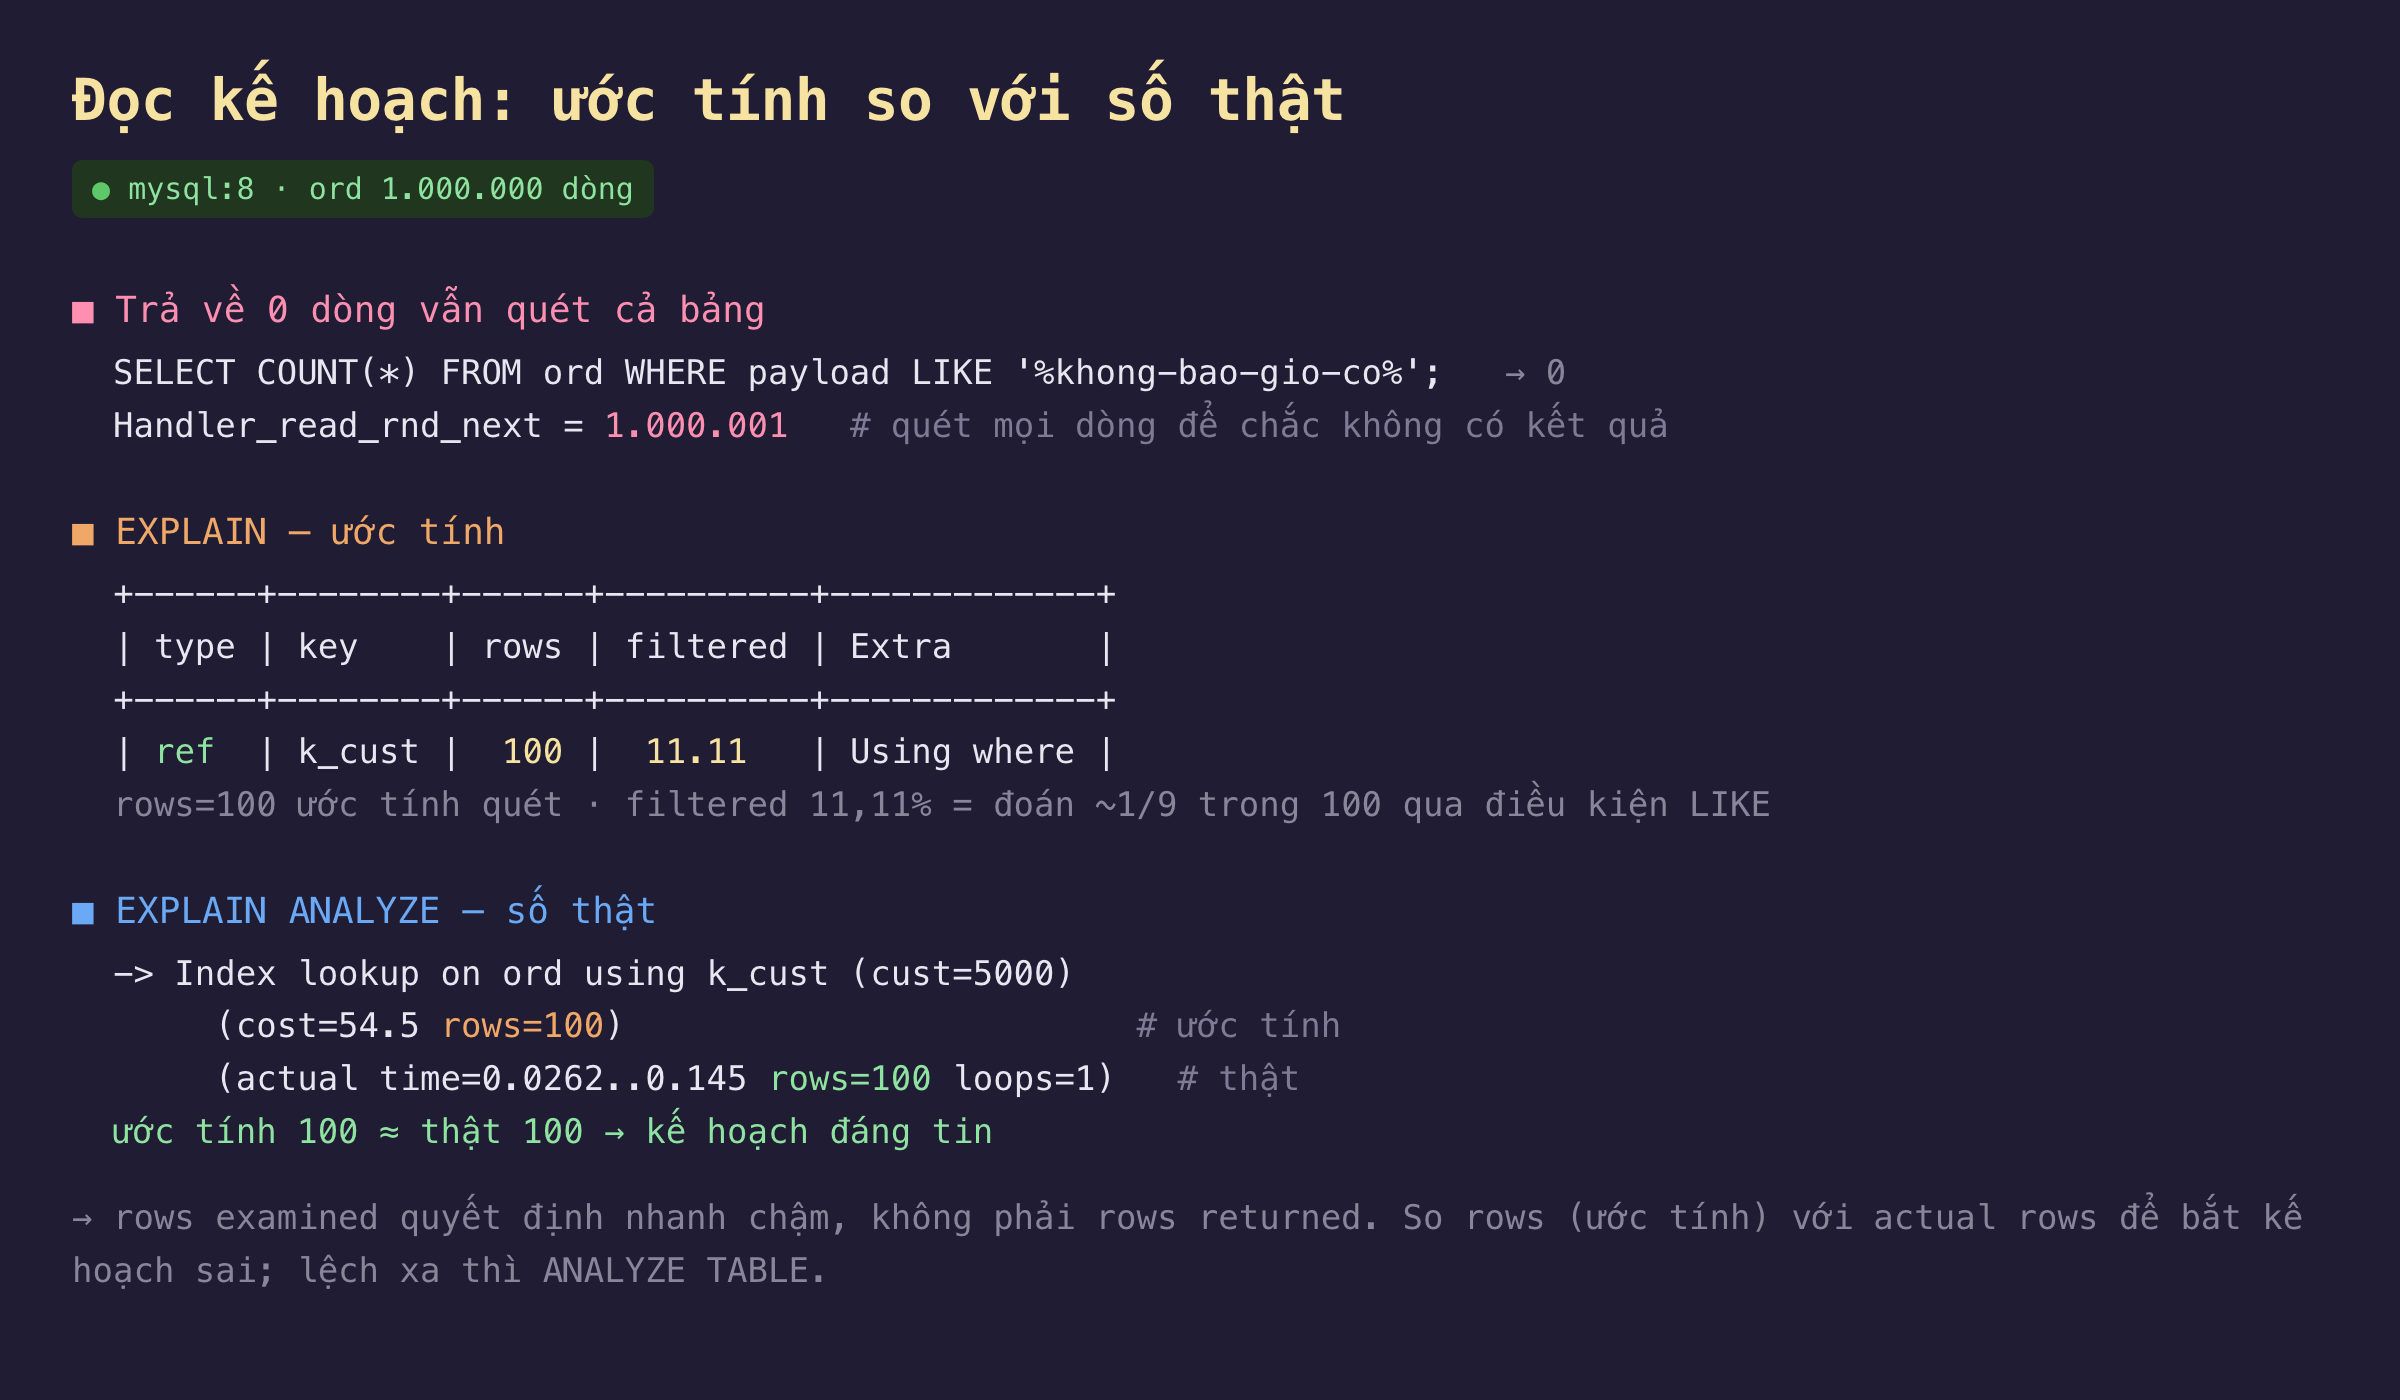
Hình 2: EXPLAIN cho ước tính (type, key, rows, filtered), EXPLAIN ANALYZE cho số thật (actual time, actual rows, loops); khớp thì tin được, lệch xa là thống kê cũ.
Ba ý mang về
- Số dòng quét (rows examined), không phải số dòng trả về, quyết định truy vấn nhanh hay chậm. Cùng một câu trả về đúng 100 dòng: bản dùng index quét 100 dòng (0,013 ms), bản bỏ index quét 1.000.000 dòng (100 ms) — gấp 7.700 lần. Đáp số giống hệt nhau không hề báo trước khoảng cách này.
- Một truy vấn trả về 0 dòng vẫn có thể quét cả bảng. Lọc
payload LIKEmột chuỗi không tồn tại trả về 0 nhưngHandler_read_rnd_next = 1.000.001— quét trọn một triệu dòng để chắc chắn không có kết quả. "Trả về ít dữ liệu" không bào chữa được cho truy vấn chậm. - EXPLAIN cho ước tính, EXPLAIN ANALYZE cho số thật — so hai cái để bắt kế hoạch sai. Đọc
type(const/ref/range/ALL),key,rows,filteredở EXPLAIN; đọcactual time,actual rows,loopsở EXPLAIN ANALYZE. Khirowsước tính lệch xaactual rows, thống kê đã cũ — chạyANALYZE TABLEđể sửa.
Nguồn
- MySQL 8.4 Reference Manual — EXPLAIN Output Format (type, key, rows, filtered, Extra): https://dev.mysql.com/doc/refman/8.4/en/explain-output.html
- MySQL 8.4 Reference Manual — Obtaining Information with EXPLAIN ANALYZE: https://dev.mysql.com/doc/refman/8.4/en/explain.html#explain-analyze
- MySQL 8.4 Reference Manual — ANALYZE TABLE Statement (cập nhật thống kê): https://dev.mysql.com/doc/refman/8.4/en/analyze-table.html
- MySQL 8.4 Reference Manual — biến trạng thái
Handler_read_*(đo số dòng quét): https://dev.mysql.com/doc/refman/8.4/en/server-status-variables.html
Phần sau đi vào MVCC: vì sao InnoDB cho nhiều giao dịch đọc cùng một hàng mà không chặn nhau, bằng cách giữ các phiên bản cũ trong undo log. Đo thật một giao dịch vẫn thấy dữ liệu cũ sau khi giao dịch khác đã sửa và commit, và cái giá của việc đọc xuyên qua chuỗi phiên bản.
