Phần secondary index đã hé lộ sức mạnh của covering index — truy vấn được trả lời trọn vẹn từ index, không chạm clustered. Bài này đi sâu vào loại index mạnh nhất cho việc đó: index composite gồm nhiều cột. Điểm cốt lõi, và cũng là chỗ hay sai nhất, là thứ tự cột: một index (cust, created) không giống (created, cust), và nó chỉ phục vụ được một số dạng truy vấn nhất định. Bài này đo thật index composite tra được gì, tra không được gì, và vì sao thứ tự cột quyết định index đáng giá hay vô dụng.
Index composite là một thứ tự từ điển
Một index (cust, created) sắp các mục theo cust trước, rồi trong cùng một cust thì theo created — đúng như cách từ điển sắp theo chữ cái đầu rồi tới chữ thứ hai. Thứ tự đó cho phép tra theo tiền tố bên trái (leftmost prefix): tìm theo cust, hoặc theo cust cộng created, đều là tìm một đoạn liền nhau trong index. Nhưng tìm theo created một mình thì không — các mục cùng created nằm rải rác khắp index, mỗi cust một chỗ, hệt như tìm mọi từ có chữ cái thứ hai là 'a' trong từ điển: chúng ở khắp nơi.
Đo trên bảng ev một triệu dòng với index k_cc (cust, created), so hai truy vấn chỉ khác ở cột lọc:
WHERE cust = 5000        (cột đầu, leftmost)   Handler_read_key=1       0,018 ms   → 100 dòng
WHERE created = 50000    (cột thứ hai, một mình) Handler_read_key=20001   10 ms      → 10 dòng
Tra theo cust là một lần seek rồi đi tuần tự — đúng bản chất tiền tố bên trái. Tra theo created một mình tốn 20.001 lần seek: không seek thẳng được, MySQL 8 phải dùng index skip scan, lặp qua từng giá trị cust (mười nghìn giá trị) rồi seek created trong mỗi nhóm. Kết quả chỉ 10 dòng mà mất 10 ms — chậm hơn tra cột đầu khoảng 550 lần, cho cùng một index. Muốn tra thẳng theo created, phải có một index đặt created ở vị trí đầu.
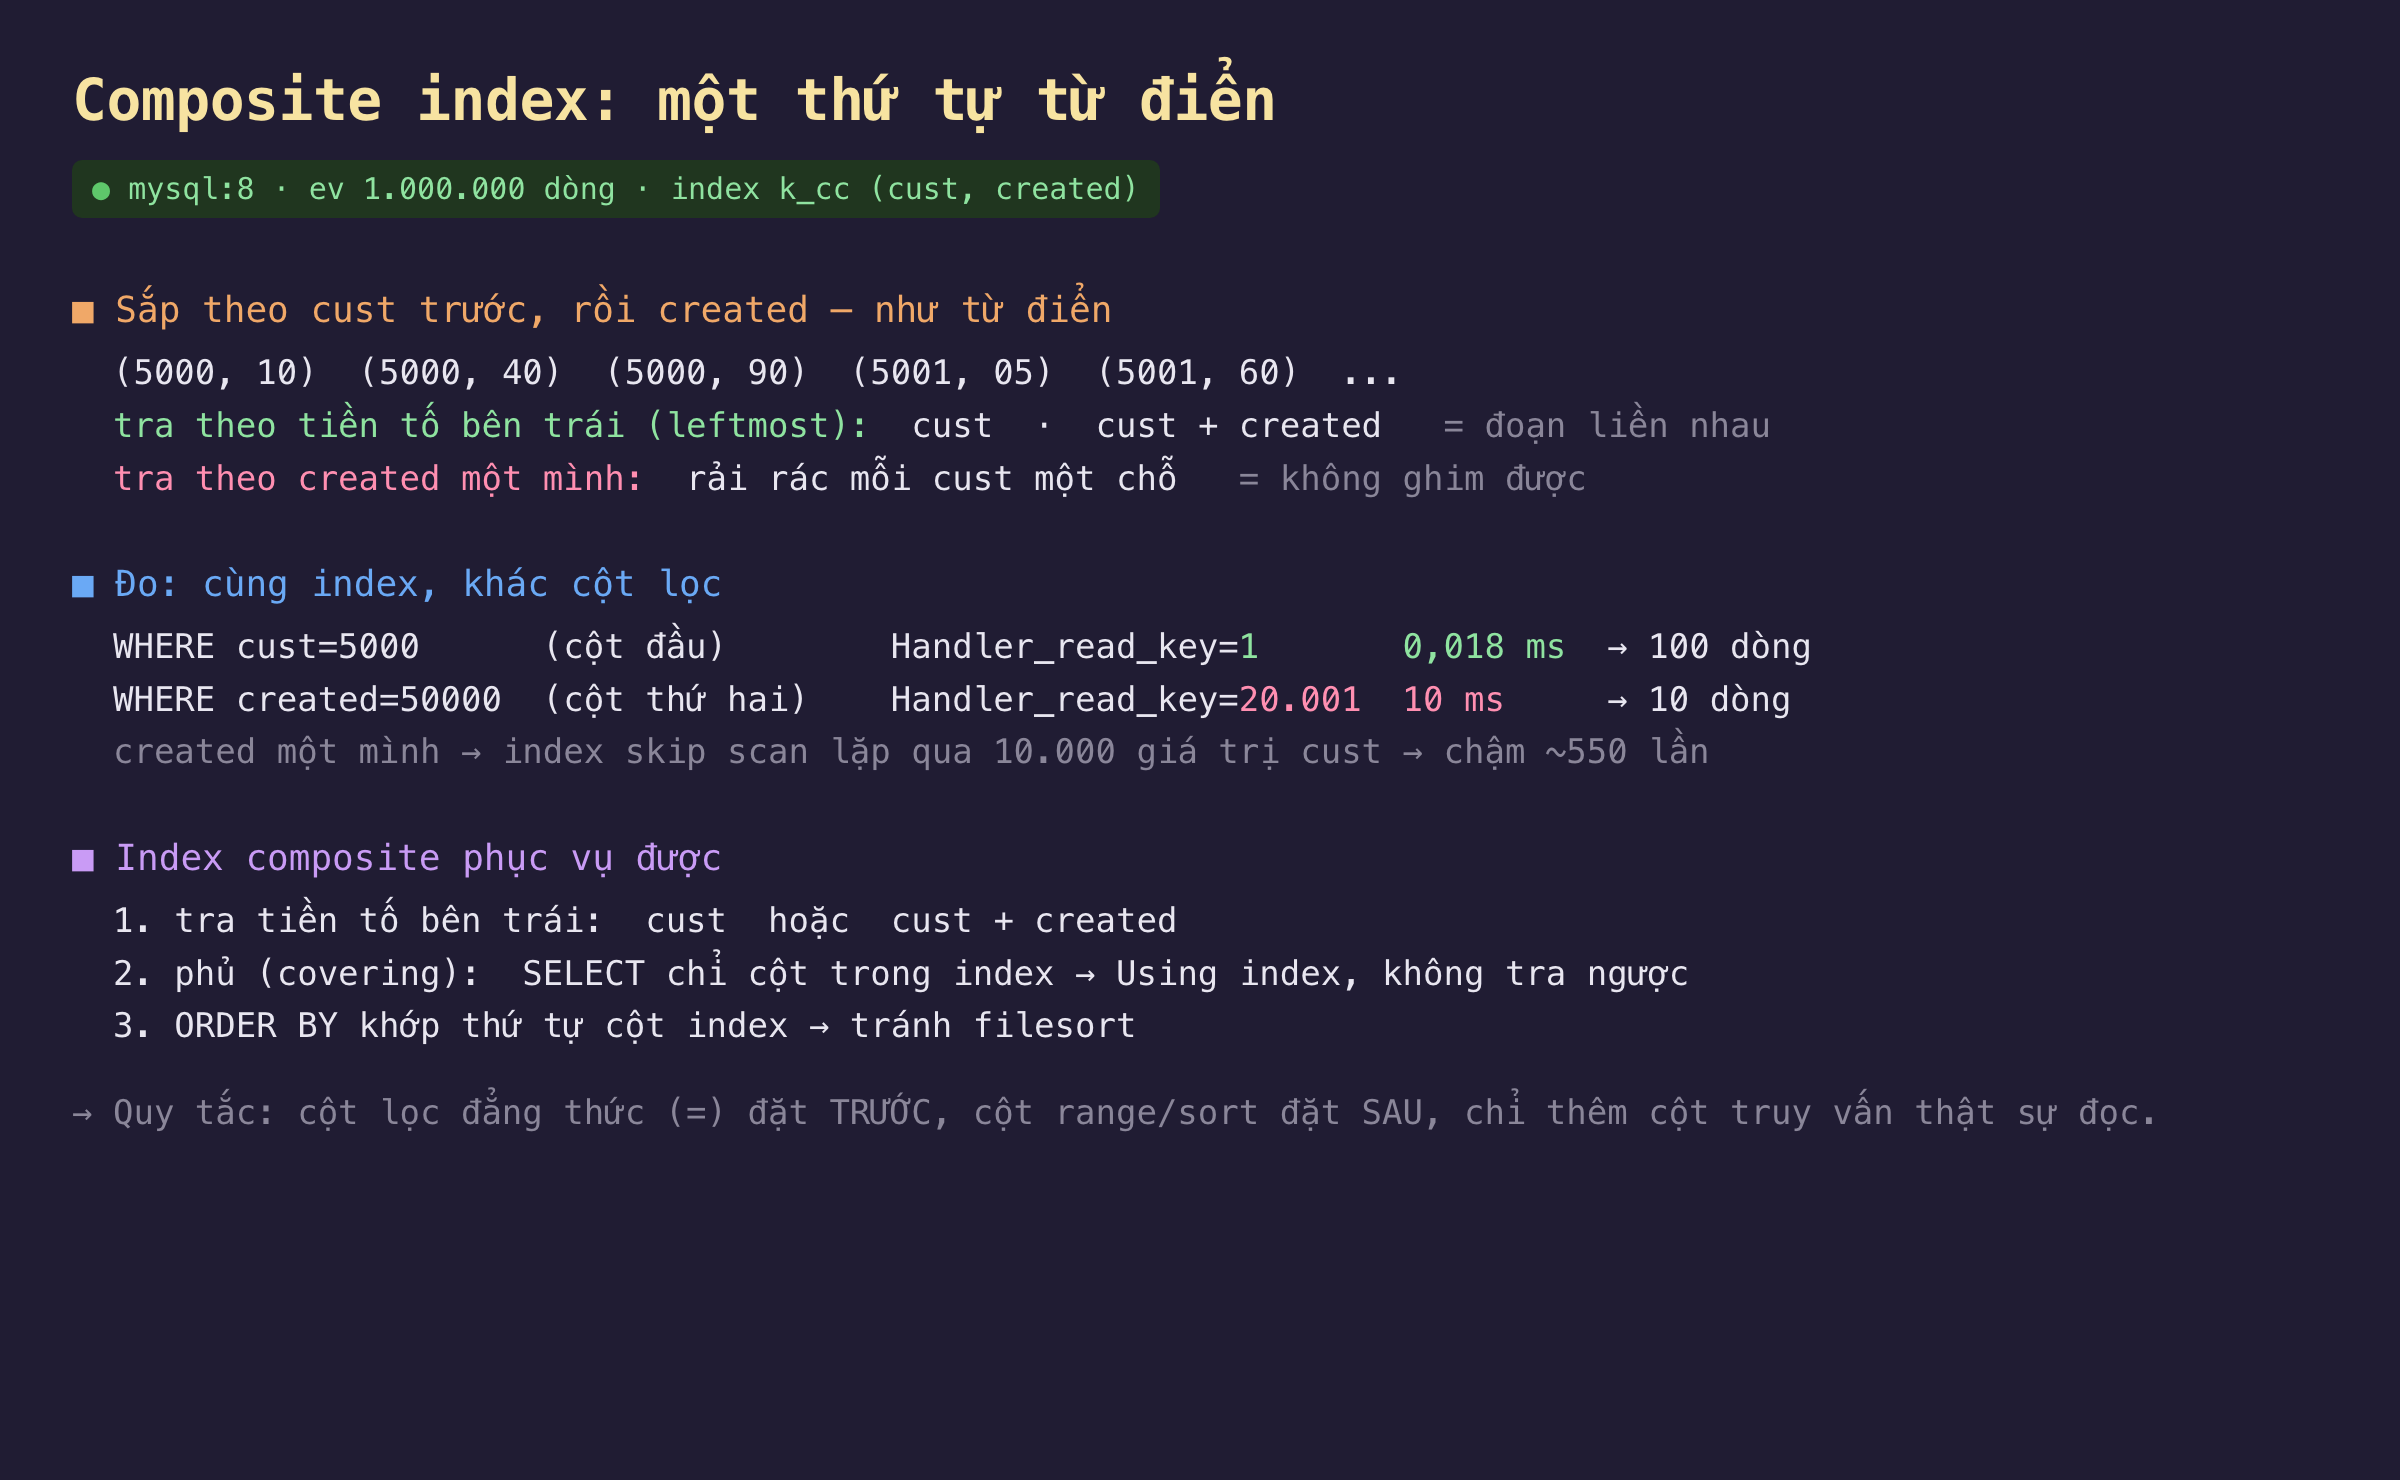
Hình 1: index (cust, created) sắp theo thứ tự từ điển; tra được tiền tố bên trái (cust, hoặc cust+created) nhưng không tra thẳng được created một mình.
Phủ truy vấn: khi index trả lời trọn vẹn
Vì index composite chứa cả hai cột, nó phủ được những truy vấn chỉ cần các cột đó. SELECT cust, created FROM ev WHERE cust = 5000 chỉ đọc những cột đã nằm trong k_cc, nên EXPLAIN hiện Using index — InnoDB trả lời hoàn toàn từ index phụ, không một lần tra ngược về clustered (bookmark lookup) như phần secondary index đã đo. Truy vấn lọc theo cả hai cột cũng vậy: WHERE cust = 5000 AND created > 50000 cho type = range kèm Using index, quét đúng đoạn index thoả cả hai điều kiện rồi trả lời tại chỗ.
Đây là lý do một index composite khéo chọn có thể thay thế nhiều index đơn và né sạch bước tra ngược: nếu các truy vấn hay chạy đọc cust, created, và lọc theo chúng, thì một index (cust, created) vừa tìm vừa trả lời. Cái giá là index rộng hơn (chứa nhiều cột hơn nên tốn chỗ và chậm ghi hơn chút), nên chỉ thêm cột vào index khi truy vấn thật sự đọc tới chúng.
Khớp thứ tự index để tránh filesort
Thứ tự của index còn giúp một việc ít ai để ý: sắp xếp. Vì các mục trong index đã nằm theo thứ tự (cust, created), một truy vấn lọc cust rồi ORDER BY created nhận kết quả đã sẵn đúng thứ tự — không cần sắp lại:
WHERE cust = 5000 ORDER BY created    →  Extra: Using index      (không filesort)
WHERE cust = 5000 ORDER BY amount     →  Extra: Using filesort   (phải sắp lại)
ORDER BY created khớp thứ tự cột thứ hai của index, nên InnoDB chỉ việc đọc đoạn index theo đúng chiều — Using index, không có bước sắp xếp. Còn ORDER BY amount (cột không nằm trong index) buộc MySQL gom kết quả rồi filesort — một bước sắp xếp tốn CPU và có thể tốn cả bộ nhớ tạm hoặc file tạm khi dữ liệu lớn. Với các truy vấn phân trang ORDER BY ... LIMIT, khác biệt này rất lớn: khớp index thì chỉ đọc đúng số dòng cần, còn filesort thì phải sắp cả tập rồi mới cắt. Chọn thứ tự cột index sao cho khớp cả điều kiện lọc lẫn thứ tự sắp là một trong những tối ưu có lãi nhất.
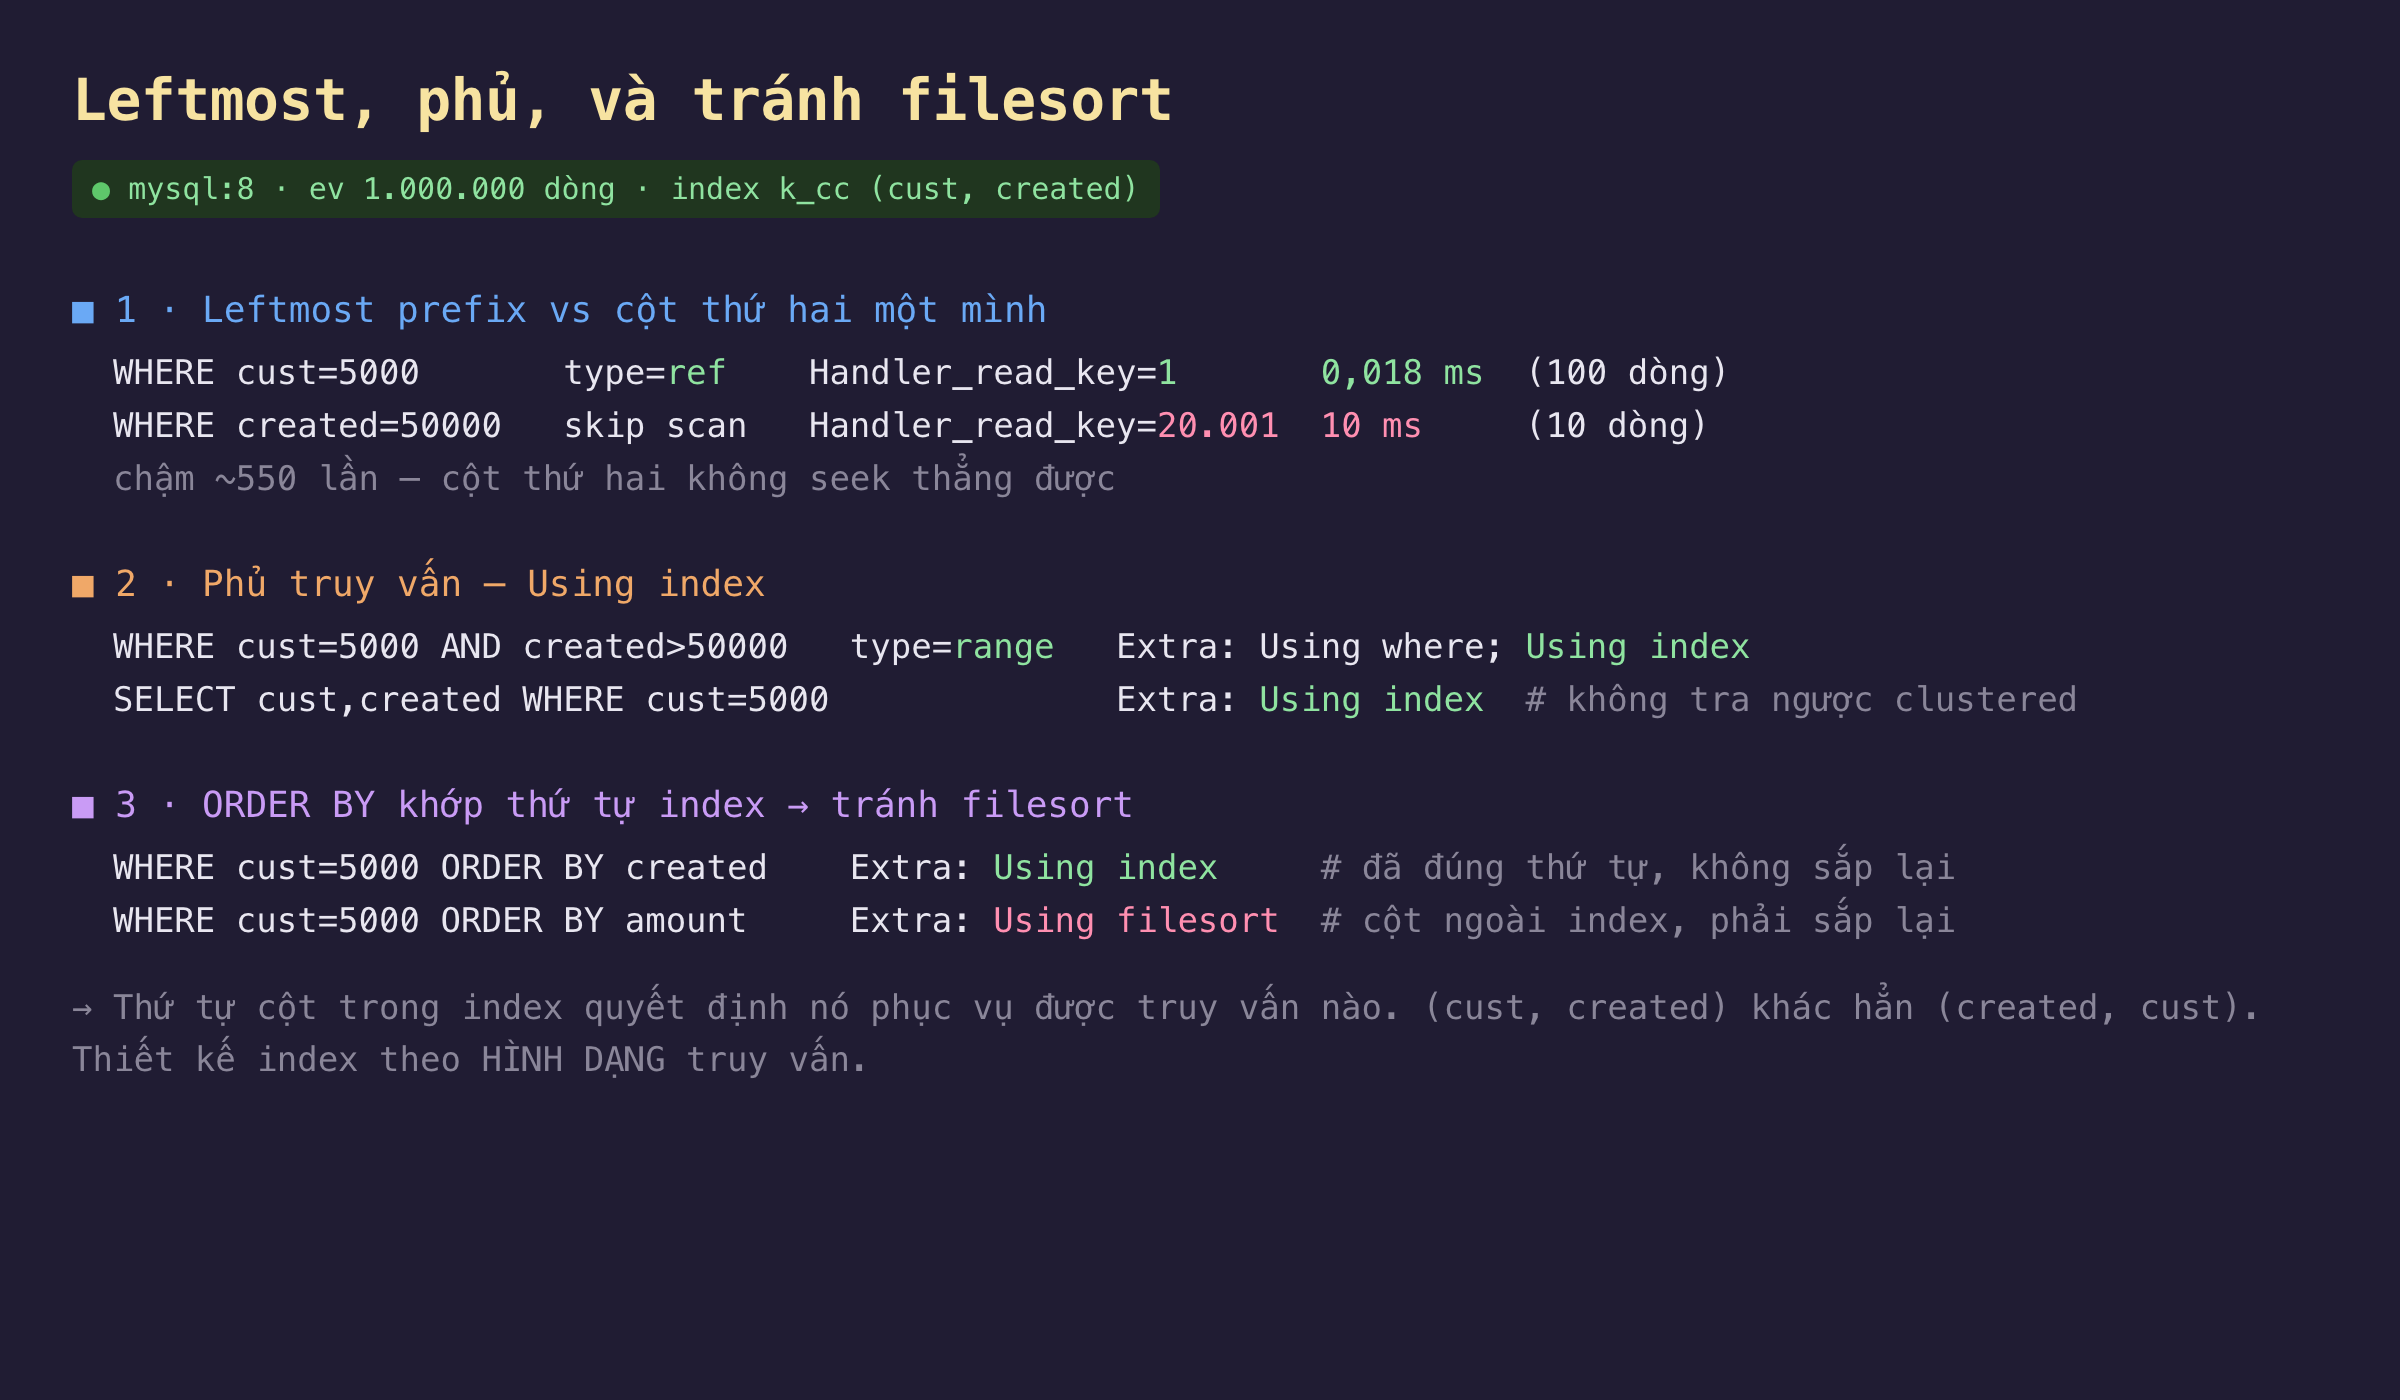
Hình 2: leftmost prefix rẻ còn cột thứ hai một mình đắt 550 lần; index phủ cho Using index; ORDER BY khớp thứ tự index tránh Using filesort.
Quy tắc chọn thứ tự cột
Ba phép đo trên gộp lại thành một quy tắc chọn thứ tự cột cho index composite. Đặt cột lọc bằng đẳng thức (=) lên trước, vì chúng ghim một tiền tố để các cột sau tra tiếp trên đoạn hẹp. Cột dùng cho range (>, <, BETWEEN) hoặc cho ORDER BY đặt sau cột đẳng thức, vì index chỉ sắp đúng thứ tự bên trong mỗi giá trị của cột trước. Và chỉ thêm cột mà truy vấn thật sự đọc để biến index thành index phủ, né tra ngược — nhưng không thêm thừa, vì mỗi cột làm index rộng và nặng thêm. Một index (cust, created) đặt đúng thứ tự có thể phục vụ WHERE cust=, WHERE cust= AND created BETWEEN, WHERE cust= ORDER BY created LIMIT, và phủ luôn các truy vấn đọc hai cột đó — bốn dạng khác nhau từ một index. Đổi thứ tự thành (created, cust) lại phục vụ một tập truy vấn hoàn toàn khác. Thiết kế index là thiết kế theo hình dạng truy vấn, không phải theo từng cột rời.
Ba ý mang về
- Index composite là một thứ tự từ điển, chỉ tra được tiền tố bên trái.
(cust, created)tra theocustmột lần seek (0,018 ms) nhưng tra theocreatedmột mình phải index skip scan 20.001 lần seek (10 ms, chậm 550 lần) vì cột thứ hai không ghim được đoạn. Muốn tra thẳngcreatedthì cần index đặt nó lên đầu. - Index phủ (covering) trả lời trọn vẹn từ index, không tra ngược clustered.
SELECT cust, created WHERE cust=choUsing index; lọc theo cả hai cột cũngUsing index. Một index composite khéo chọn thay được nhiều index đơn và né bookmark lookup — đổi lại index rộng và nặng ghi hơn chút. - Khớp thứ tự index để tránh filesort, và chọn thứ tự cột theo hình dạng truy vấn.
ORDER BY createdkhớp index choUsing index,ORDER BY amountchoUsing filesort. Quy tắc: cột lọc đẳng thức trước, cột range/sort sau, chỉ thêm cột truy vấn thật sự đọc.
Nguồn
- MySQL 8.4 Reference Manual — Multiple-Column Indexes (leftmost prefix): https://dev.mysql.com/doc/refman/8.4/en/multiple-column-indexes.html
- MySQL 8.4 Reference Manual — Index Skip Scan: https://dev.mysql.com/doc/refman/8.4/en/range-optimization.html#range-access-skip-scan
- MySQL 8.4 Reference Manual — ORDER BY Optimization (tránh filesort bằng index): https://dev.mysql.com/doc/refman/8.4/en/order-by-optimization.html
- MySQL 8.4 Reference Manual — Covering Indexes: https://dev.mysql.com/doc/refman/8.4/en/glossary.html#glos_covering_index
Phần sau đi vào partitioning: chia một bảng lớn thành nhiều phân vùng vật lý theo khoá, và đo thật partition pruning — khi truy vấn chỉ chạm đúng phân vùng chứa dữ liệu cần thay vì quét cả bảng. Xem số phân vùng bị quét trước và sau khi điều kiện cắt được theo khoá phân vùng.
