Mười một phần vừa qua mổ xẻ InnoDB từ cấu trúc lưu trữ tới nhân bản, mỗi phần một phép đo thật. Phần cuối này làm hai việc: gom tất cả thành một quy trình chẩn đoán đi từ một truy vấn chậm tới nguyên nhân gốc, và chứng minh sức mạnh của quy trình đó bằng một tối ưu đầu cuối — biến một truy vấn 111 mili-giây thành 0,018 mili-giây chỉ bằng đúng một index, gói gọn bốn bài học về index vào một dòng lệnh.
Một truy vấn, bốn bài học, 6.000 lần
Lấy một truy vấn rất đời thường trên bảng orders một triệu dòng: lấy hai mươi đơn mới nhất của một khách ở một trạng thái, kèm số tiền — SELECT amount FROM orders WHERE cust = 5000 AND status = 1 ORDER BY created DESC LIMIT 20. Khi bảng chưa có index phù hợp, EXPLAIN ANALYZE phơi bày thảm hoạ:
TRƯỚC:  Table scan on orders ... rows=1.000.000 ... + filesort       111 ms
        Handler_read_rnd_next = 1.000.001   (quét sạch cả bảng)
        trả về 20 dòng, nhưng QUÉT một triệu dòng rồi SẮP LẠI toàn bộ
InnoDB quét toàn bộ clustered index (phần 1), chạm cả triệu dòng dù chỉ cần hai mươi (phần 5), rồi còn phải filesort để sắp theo created (phần 9). Thêm đúng một covering composite index (cust, status, created, amount) lật ngược mọi thứ:
SAU:    type = ref,  key = k_cover,  Extra: Backward index scan; Using index   0,018 ms
        Handler_read_key = 1, Handler_read_prev = 17   (chạm 18 dòng)
        KHÔNG filesort, KHÔNG tra ngược clustered
Nhanh hơn khoảng 6.000 lần, số dòng chạm giảm từ một triệu xuống mười tám. Một index duy nhất đã gộp bốn bài học của sê-ri: cust, status là tiền tố bên trái để seek thẳng (phần 9); created đặt sau nên index đã sẵn thứ tự, ORDER BY created DESC chỉ việc quét ngược (Backward index scan) — không filesort; và amount nằm trong index khiến nó phủ truy vấn (Using index), không tra ngược clustered (phần 4). Thiết kế một index đúng không phải thêm cột ngẫu nhiên, mà là đọc đúng hình dạng truy vấn.
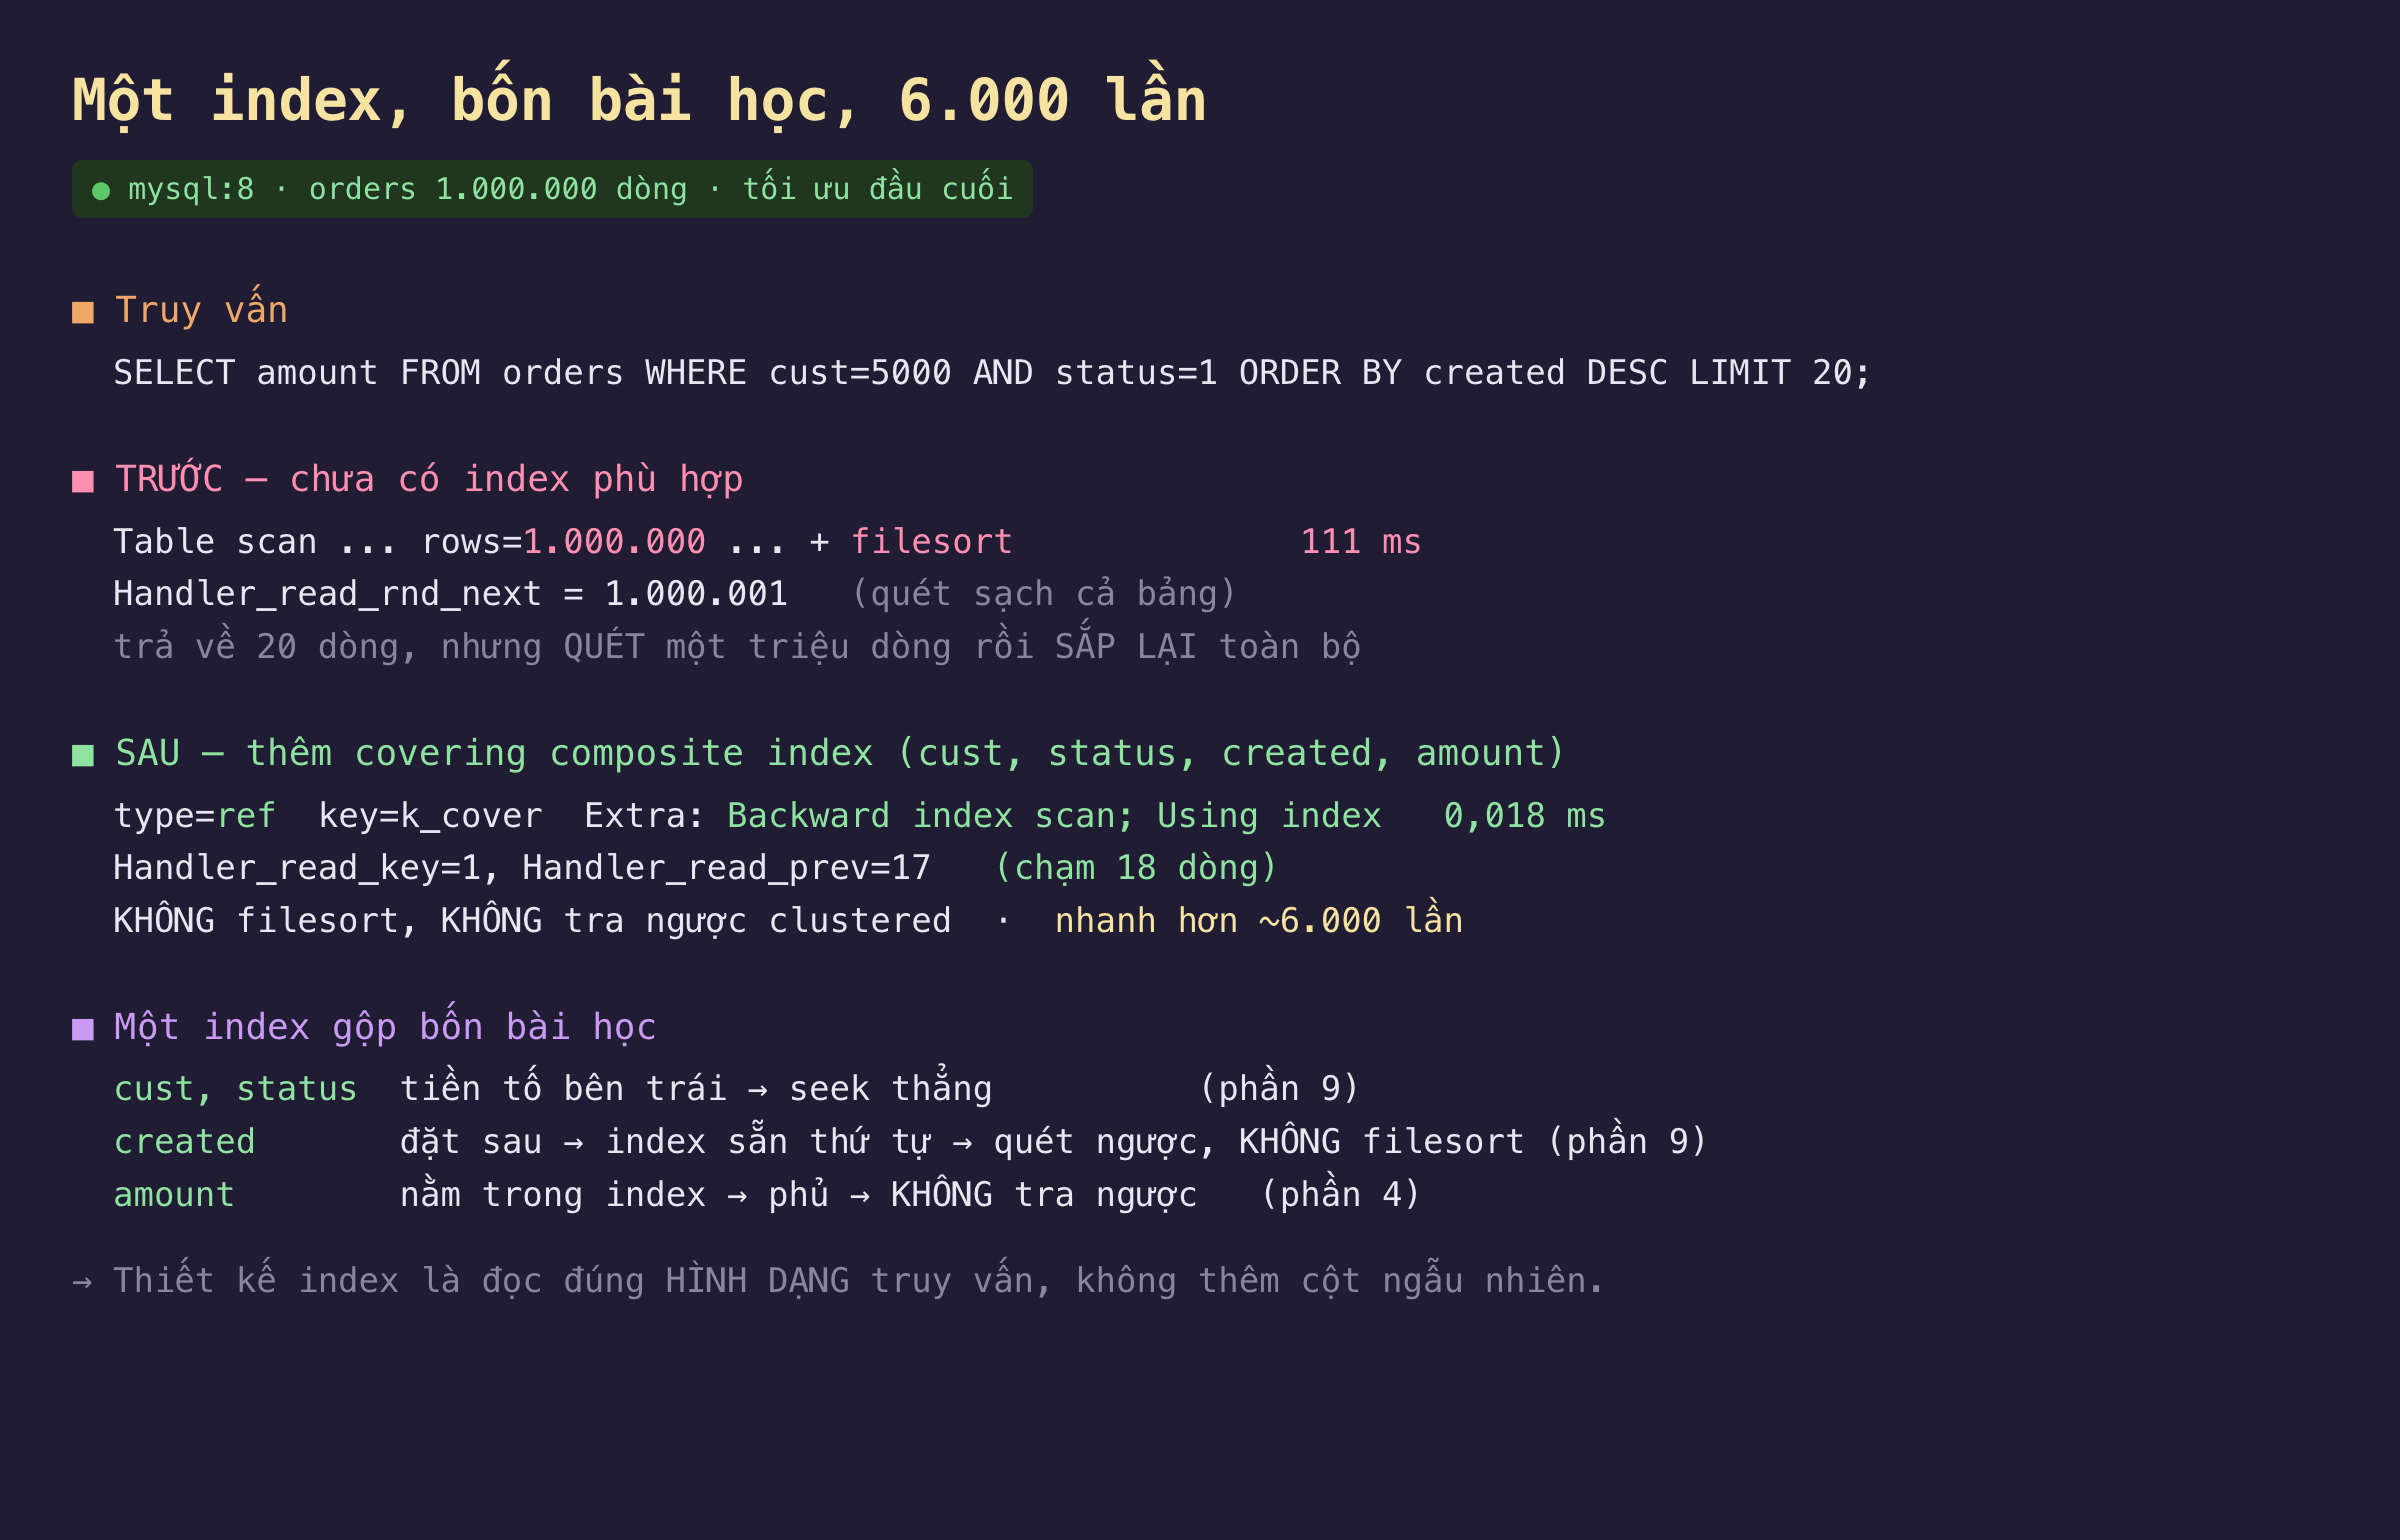
Hình 1: cùng một truy vấn, thêm đúng một covering composite index biến quét cả triệu dòng kèm filesort (111 ms) thành seek 18 dòng Using index (0,018 ms) — gộp bốn bài học về index.
Bảng tra cứu: con số của cả sê-ri
Mỗi phần để lại một vài con số đáng nhớ. Gom lại, chúng vẽ nên bức tranh định lượng về cách InnoDB vận hành:
| Phần | Phép đo cốt lõi | Con số |
|---|---|---|
| 1 Clustered index | Tra khoá chính vs lọc cột không index | 1 dòng / 0,015 ms so với 1.000.001 dòng / 161 ms |
| 2 Buffer pool | Bảng vừa pool vs lớn hơn pool | 0 trang chạm đĩa so với 577 trang mỗi lần quét |
| 3 B+tree | Chiều cao cây từ 1K tới 10M dòng | 2 → 3 tầng (gấp 10.000 lần, thêm 1 tầng) |
| 4 Secondary index | Bookmark lookup vs covering | 410 trang so với 10 trang (cùng 100 dòng) |
| 5 EXPLAIN | Cùng kết quả, hai kế hoạch | quét 100 so với 1.000.000 dòng (~7.700 lần) |
| 6 MVCC | Đọc thường vs FOR UPDATE chặn ghi | B ghi 55 ms so với 2.035 ms |
| 7 Khoá & cô lập | Gap lock chặn chèn; deadlock | chặn 2.035 ms; lỗi 1213 phá tức thì |
| 8 Redo log | flush=1 vs group commit (8 kết nối) | 10.209 so với 3.688 lần fsync |
| 9 Composite index | Tiền tố trái vs cột thứ hai một mình | 1 seek so với 20.001 seek |
| 10 Partitioning | Pruning cắt rows quét | 100.000 so với 1.000.000 dòng |
| 11 Replication | Lan tới replica; ép lag rồi bắt kịp | 59 ms; 20.000 dòng → kịp 1,6 s |
Một sợi chỉ xuyên suốt: hầu hết tối ưu MySQL là giảm số dòng phải chạm và giữ dữ liệu nóng trong RAM. Index giảm số dòng quét; buffer pool giữ chúng khỏi đĩa; covering index và partitioning cắt thêm phần phải đọc; MVCC và khoá quyết định ai chờ ai; redo log và replication lo độ bền và quy mô.
Cây quyết định: từ truy vấn chậm tới cách sửa
Khi một truy vấn chậm, quy trình chẩn đoán gần như luôn bắt đầu từ EXPLAIN ANALYZE và đi theo vài nhánh quen thuộc:
- Thấy
type = ALLhoặcrows examinedlớn hơn nhiềurowstrả về → thiếu index. Thêm index với cột lọc đẳng thức trước, cột range/sort sau, và cột đượcSELECTđể phủ (phần 4, 5, 9). - Thấy
Using filesort→ thứ tự index không khớpORDER BY. Đặt cột sắp xếp vào index ngay sau các cột lọc đẳng thức (phần 9). - Truy vấn lần đầu chậm, lần sau nhanh; hoặc
Innodb_buffer_pool_readscao → tập làm việc không vừa RAM. Tănginnodb_buffer_pool_sizecho vừa (phần 2). - Nhiều pha chờ khoá, hoặc lỗi 1213 → xem lại thứ tự khoá cho thống nhất, rút ngắn giao dịch, và bắt lỗi 1213 để thử lại (phần 7). Giao dịch mở lâu còn làm phình undo (phần 6).
- Throughput ghi thấp dù CPU rảnh → cân nhắc
innodb_flush_log_at_trx_commit, và tăng số kết nối đồng thời để group commit chia sẻ fsync (phần 8). - Bảng time-series khổng lồ, truy vấn theo khoảng ngày và cần xoá dữ liệu cũ → partitioning theo ngày, bỏ phân vùng cũ bằng
DROP PARTITION(phần 10). - Đọc dồn vào một máy, hoặc cần dự phòng → thêm replica, nhớ
super_read_onlyvà theo dõiSeconds_Behind_Source(phần 11).
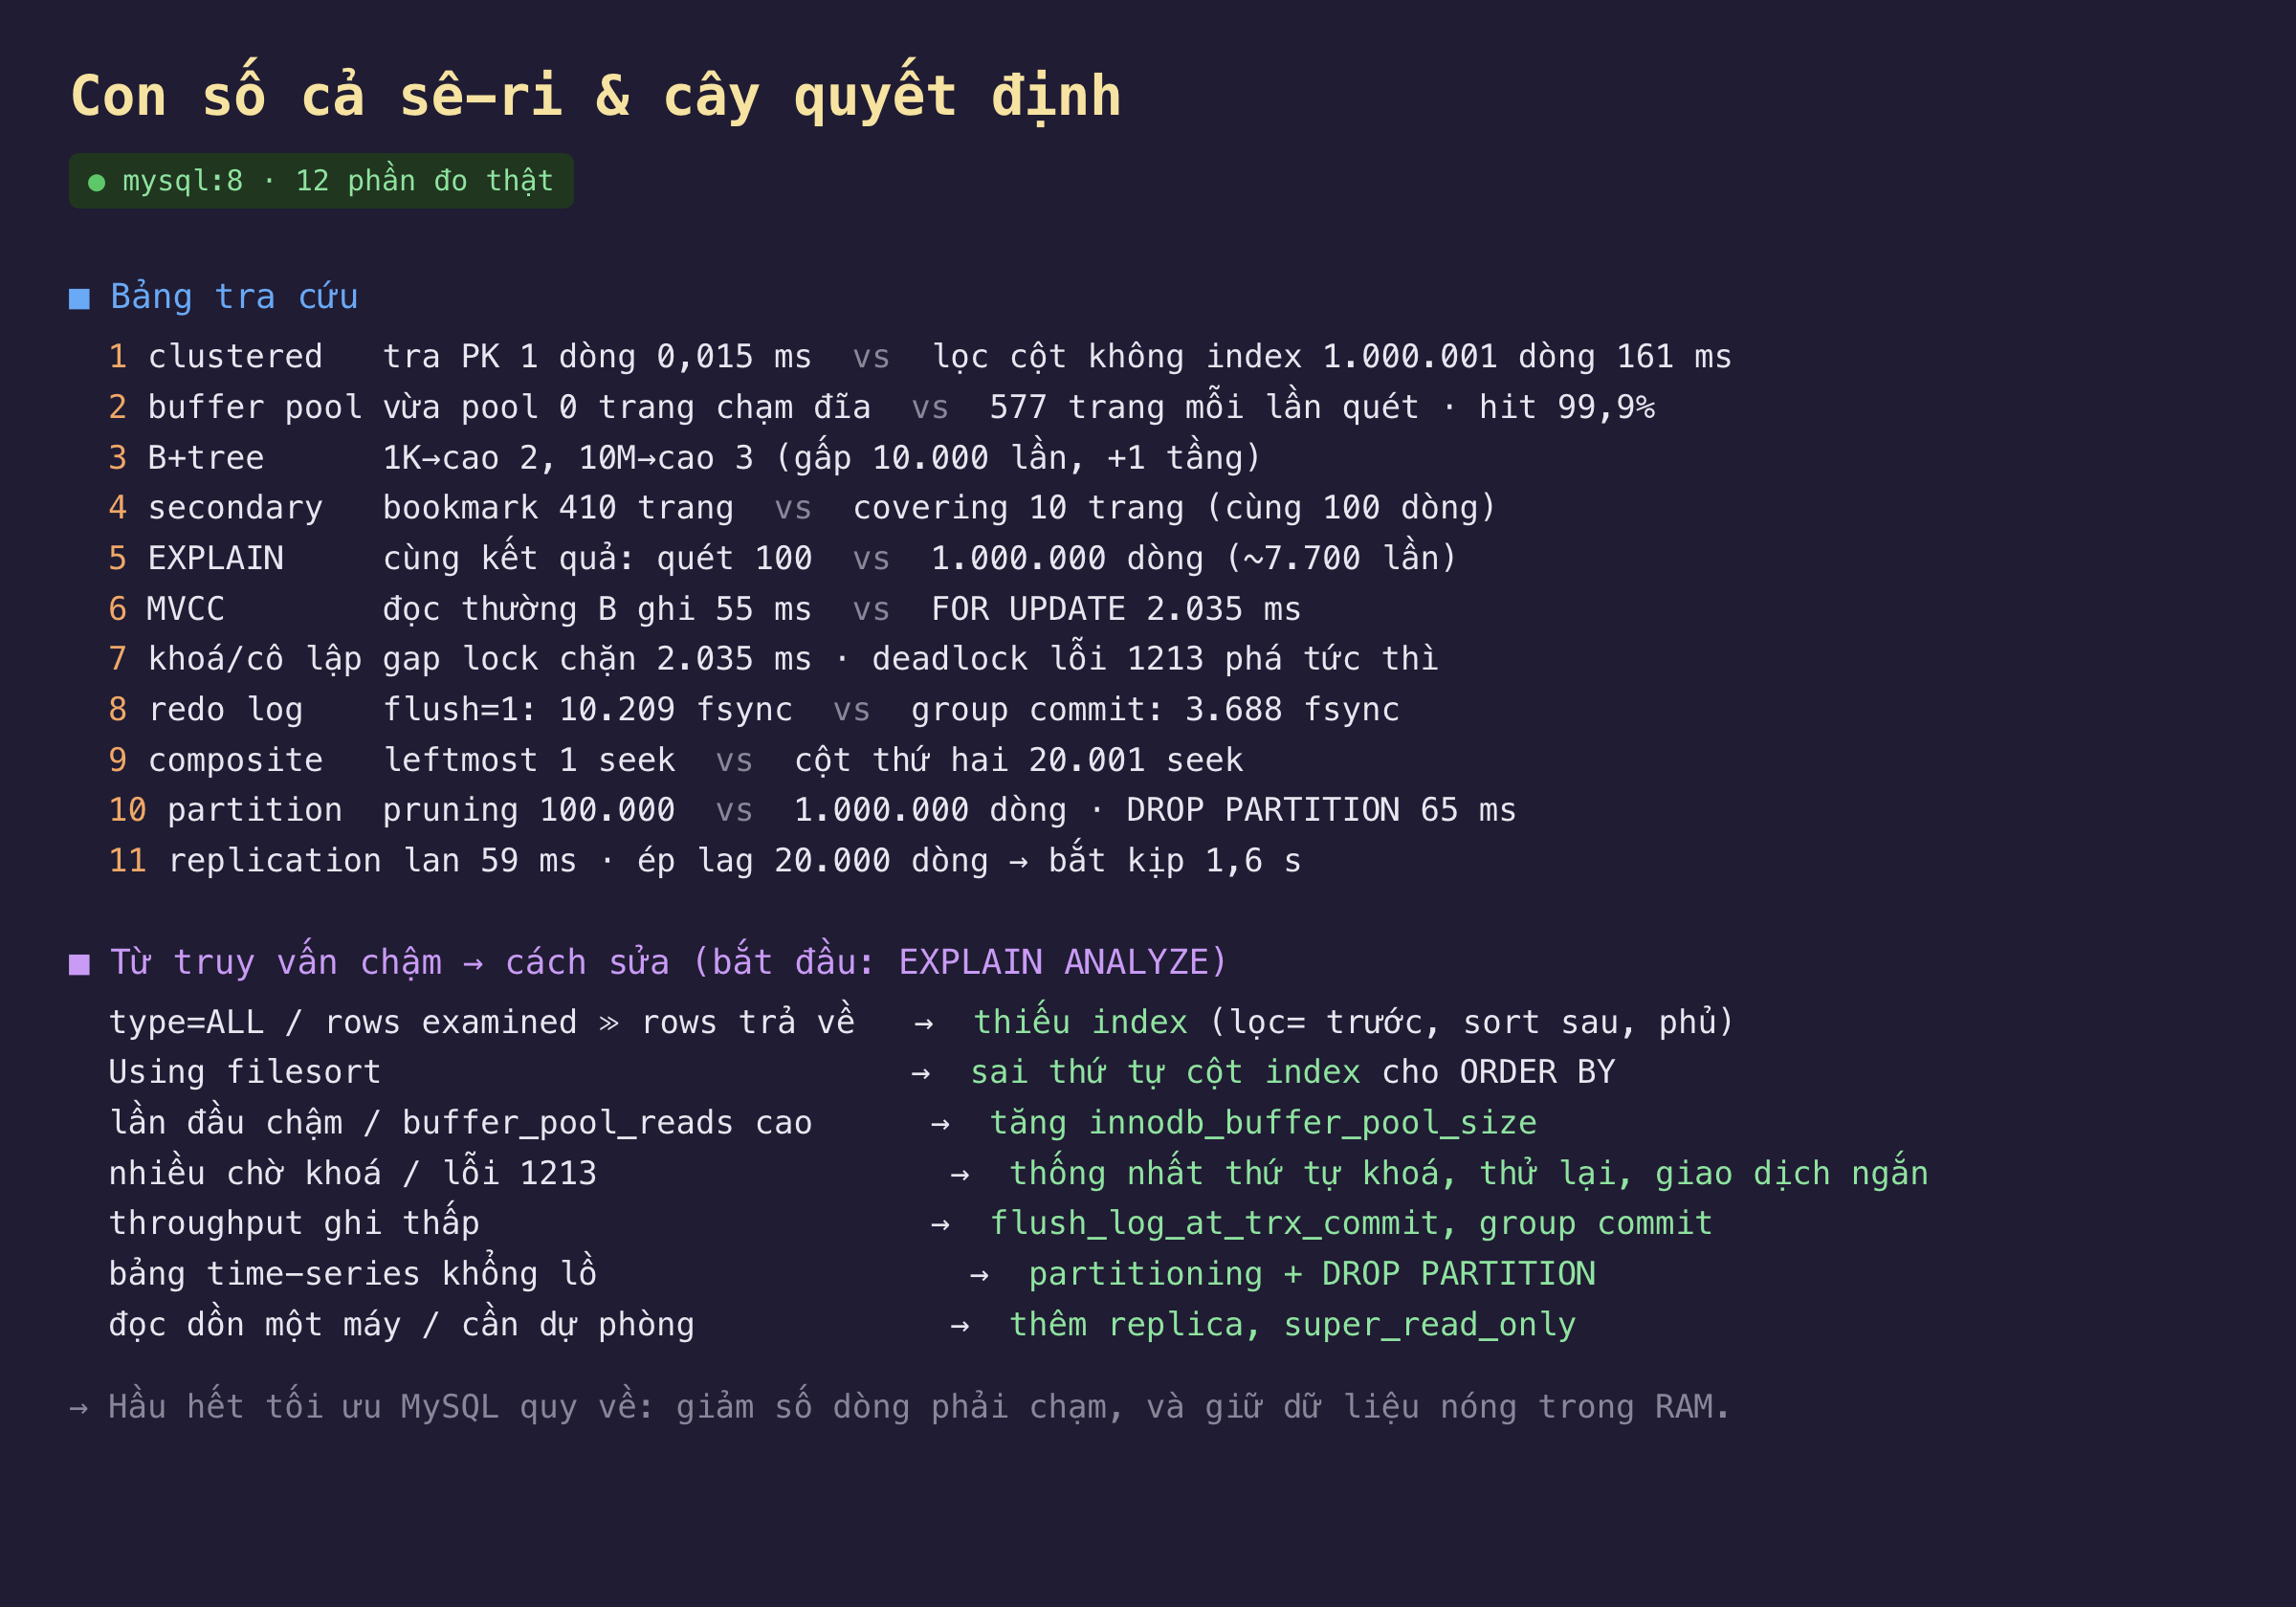
Hình 2: bảng tra cứu con số của cả sê-ri, và cây quyết định đi từ triệu chứng trong EXPLAIN ANALYZE tới nguyên nhân gốc và cách sửa.
Ba ý mang về
- Thiết kế đúng một index có thể thay thế mọi mẹo khác. Một covering composite index
(cust, status, created, amount)biến truy vấn 111 ms (quét một triệu dòng kèm filesort) thành 0,018 ms (seek 18 dòng,Using index), nhanh hơn ~6.000 lần — gộp tiền tố bên trái, thứ tự sắp xếp, và phủ truy vấn vào một dòng lệnh. - Hầu hết tối ưu MySQL quy về giảm số dòng phải chạm và giữ dữ liệu nóng trong RAM. Index và partitioning cắt phần bảng phải đọc; buffer pool giữ nó khỏi đĩa;
rows examinedtrongEXPLAIN ANALYZElà thước đo trung thực nhất, không phải số dòng trả về. - Chẩn đoán bắt đầu từ
EXPLAIN ANALYZEvà đi theo triệu chứng.type = ALLhayrows examinedlớn → thiếu index;Using filesort→ sai thứ tự cột index; đọc đĩa nhiều → tăng buffer pool; lỗi 1213 → thống nhất thứ tự khoá và thử lại. Mỗi triệu chứng trỏ thẳng tới một phần của sê-ri này.
Nguồn
- MySQL 8.4 Reference Manual — Optimization (tổng quan tối ưu): https://dev.mysql.com/doc/refman/8.4/en/optimization.html
- MySQL 8.4 Reference Manual — Optimizing Queries with EXPLAIN: https://dev.mysql.com/doc/refman/8.4/en/using-explain.html
- MySQL 8.4 Reference Manual — InnoDB Storage Engine (chương tổng hợp): https://dev.mysql.com/doc/refman/8.4/en/innodb-storage-engine.html
- Baron Schwartz và cộng sự — High Performance MySQL (sách kinh điển về tối ưu InnoDB): https://www.oreilly.com/library/view/high-performance-mysql/9781492080503/
Sê-ri MySQL và InnoDB đo thật khép lại ở đây: mười hai phần, từ clustered index tới replication, mỗi khẳng định đều có một phép đo trong container đứng sau. Mong rằng lần tới khi một truy vấn chậm hiện ra, bạn sẽ mở EXPLAIN ANALYZE và biết chính xác con số nào cần nhìn, và vì sao.
