Khi một bảng phình tới hàng trăm triệu dòng — thường là dữ liệu theo thời gian như log, sự kiện, giao dịch — hai vấn đề nổi lên: truy vấn phải lục trong khối dữ liệu khổng lồ dù chỉ cần một khoảng thời gian, và xoá dữ liệu cũ bằng DELETE trở nên chậm và nặng nề. Partitioning giải quyết cả hai bằng cách chia một bảng logic thành nhiều phân vùng vật lý theo một khoá. Bài này đo thật hai lợi ích đó: partition pruning giúp truy vấn chỉ chạm đúng phân vùng cần, và DROP PARTITION xoá cả một khoảng dữ liệu trong tích tắc.
Chia bảng theo khoá, truy vấn chỉ chạm phần cần
Bảng plog một triệu dòng được chia thành mười phân vùng theo RANGE(created): p0 chứa created dưới 10000, p1 từ 10000 tới dưới 20000, và cứ thế tới p9. Với người viết truy vấn, plog vẫn là một bảng duy nhất; nhưng dưới đĩa, mỗi phân vùng là một vùng lưu trữ riêng. Khi truy vấn lọc theo created — chính là khoá phân vùng — optimizer biết ngay dữ liệu cần nằm ở phân vùng nào và bỏ qua phần còn lại. Đó là partition pruning, và cột partitions trong EXPLAIN cho thấy chính xác phân vùng nào bị chạm:
WHERE created = 25000              partitions: p2                      ← chỉ 1 phân vùng
WHERE created BETWEEN 15000..35000 partitions: p1,p2,p3                ← 3 phân vùng
WHERE amount = 42                  partitions: p0,p1,p2,...,p9          ← CẢ 10 (không prune)
Lọc theo created cắt gọn xuống đúng phân vùng chứa khoảng đó. Nhưng lọc theo amount — cột không phải khoá phân vùng — thì optimizer không biết amount = 42 nằm ở đâu, nên phải quét cả mười phân vùng. Đây là điều kiện tiên quyết để partitioning có ích: truy vấn phải lọc theo khoá phân vùng thì pruning mới xảy ra.
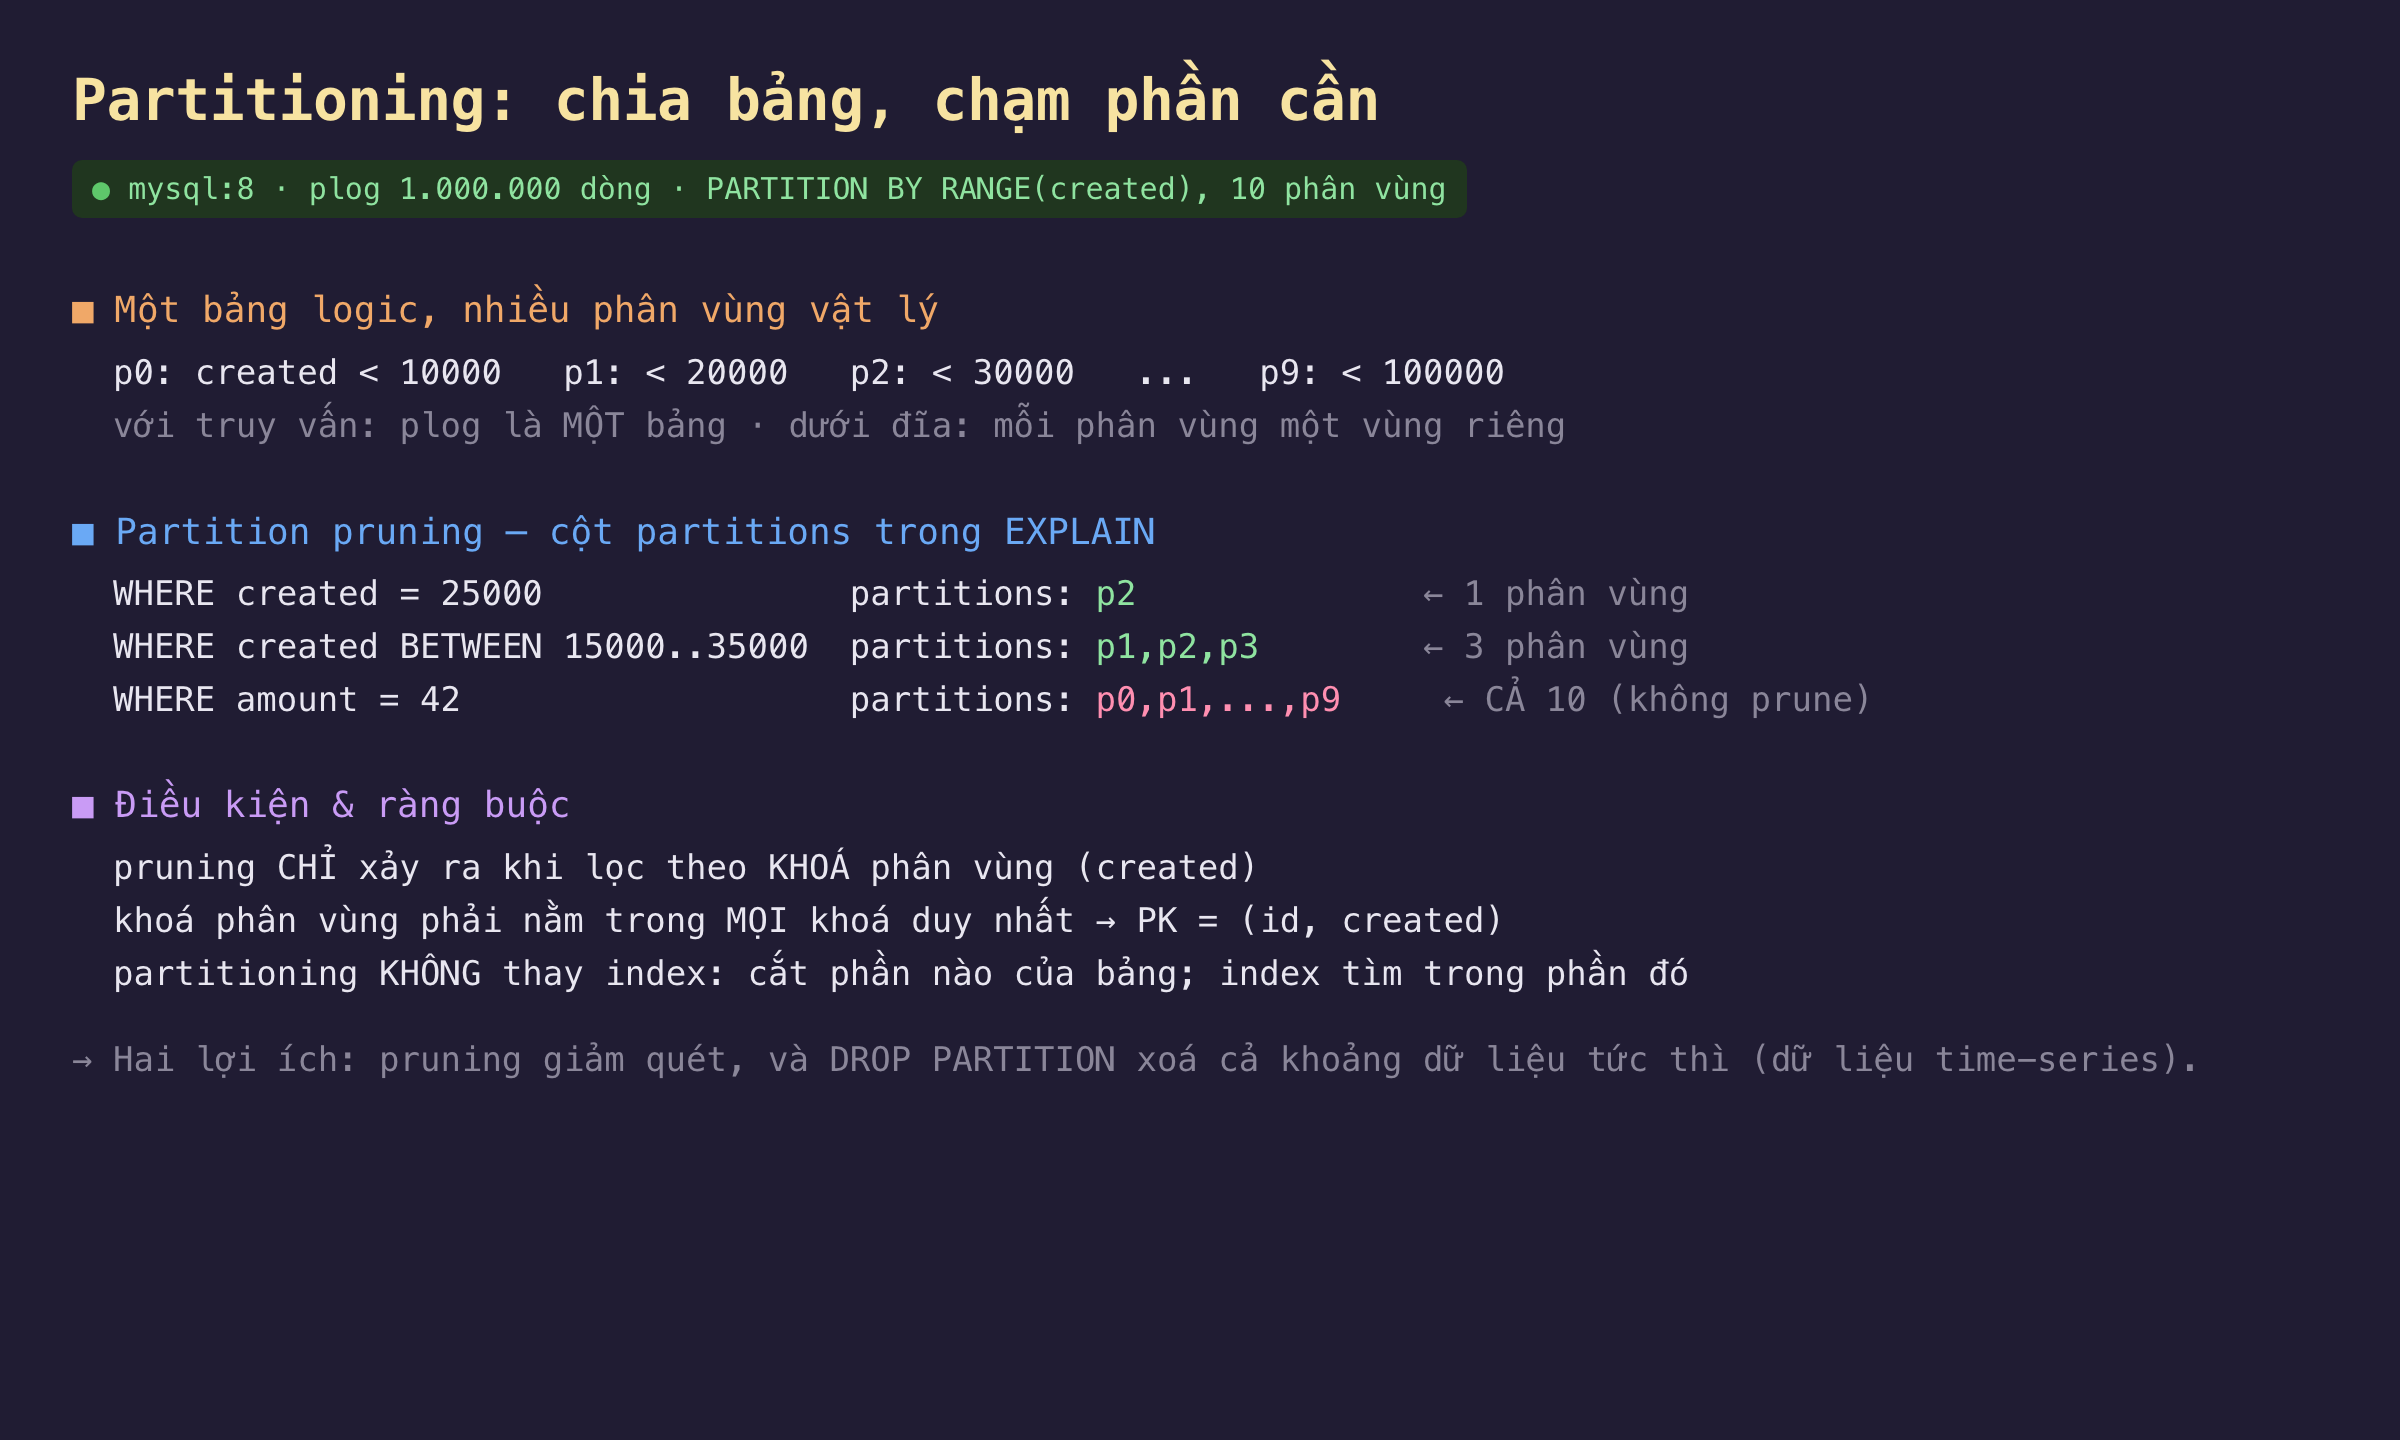
Hình 1: plog chia 10 phân vùng theo RANGE(created); lọc theo khoá phân vùng cho pruning (chỉ chạm phân vùng cần), lọc theo cột khác thì quét cả mười.
Pruning cắt rows quét xuống còn một phần mười
Pruning không chỉ là một dòng đẹp trong EXPLAIN — nó cắt thẳng khối lượng công việc. So hai truy vấn cùng tìm amount = 42, một cái kèm điều kiện khoá phân vùng để prune, một cái không:
WHERE created>=20000 AND created<30000 AND amount=42    quét 100.000 dòng (chỉ p2)    10,8 ms
WHERE amount=42                                          quét 1.000.000 dòng (cả 10)   65,8 ms
Thêm điều kiện created trong khoảng một phân vùng khiến truy vấn chỉ quét 100.000 dòng của p2 thay vì cả một triệu dòng — ít hơn mười lần, và thời gian giảm từ 65,8 xuống 10,8 ms. Với dữ liệu theo thời gian, đây là kịch bản rất thường gặp: hầu hết truy vấn chỉ hỏi dữ liệu trong một khoảng ngày gần đây, và nếu phân vùng theo ngày, mỗi truy vấn chỉ chạm vài phân vùng mới nhất thay vì cả lịch sử. Pruning biến một bảng khổng lồ thành hiệu quả như thể nó chỉ bằng một phân vùng.
DROP PARTITION: xoá cả một khoảng trong tích tắc
Lợi ích thứ hai lộ ra khi cần xoá dữ liệu cũ — việc thường xuyên với dữ liệu theo thời gian (giữ 90 ngày, bỏ phần cũ hơn). So xoá một khoảng khoảng 100.000 dòng bằng hai cách:
ALTER TABLE plog DROP PARTITION p9;              65 ms    ← thao tác metadata
DELETE FROM plog WHERE created>=80000 AND <90000; 150 ms    ← xoá từng dòng
DROP PARTITION nhanh hơn, nhưng con số 65 so với 150 ms trên tmpfs còn giấu đi khác biệt thật. DELETE phải đọc từng dòng, ghi undo log cho từng dòng (để có thể cuộn lại), ghi redo log, rồi để purge dọn các phiên bản cũ về sau — chi phí tỉ lệ với số dòng. DROP PARTITION chỉ là một thao tác metadata: nó bỏ nguyên cả tệp phân vùng, gần như không phụ thuộc số dòng bên trong. Trên đĩa thật với dữ liệu lớn, DELETE vài triệu dòng tốn hàng phút và làm phình undo log, trong khi DROP PARTITION vẫn gần như tức thì. Đó là lý do mô hình "phân vùng theo ngày rồi bỏ phân vùng cũ" là cách chuẩn để quản lý vòng đời dữ liệu theo thời gian, thay cho DELETE định kỳ.
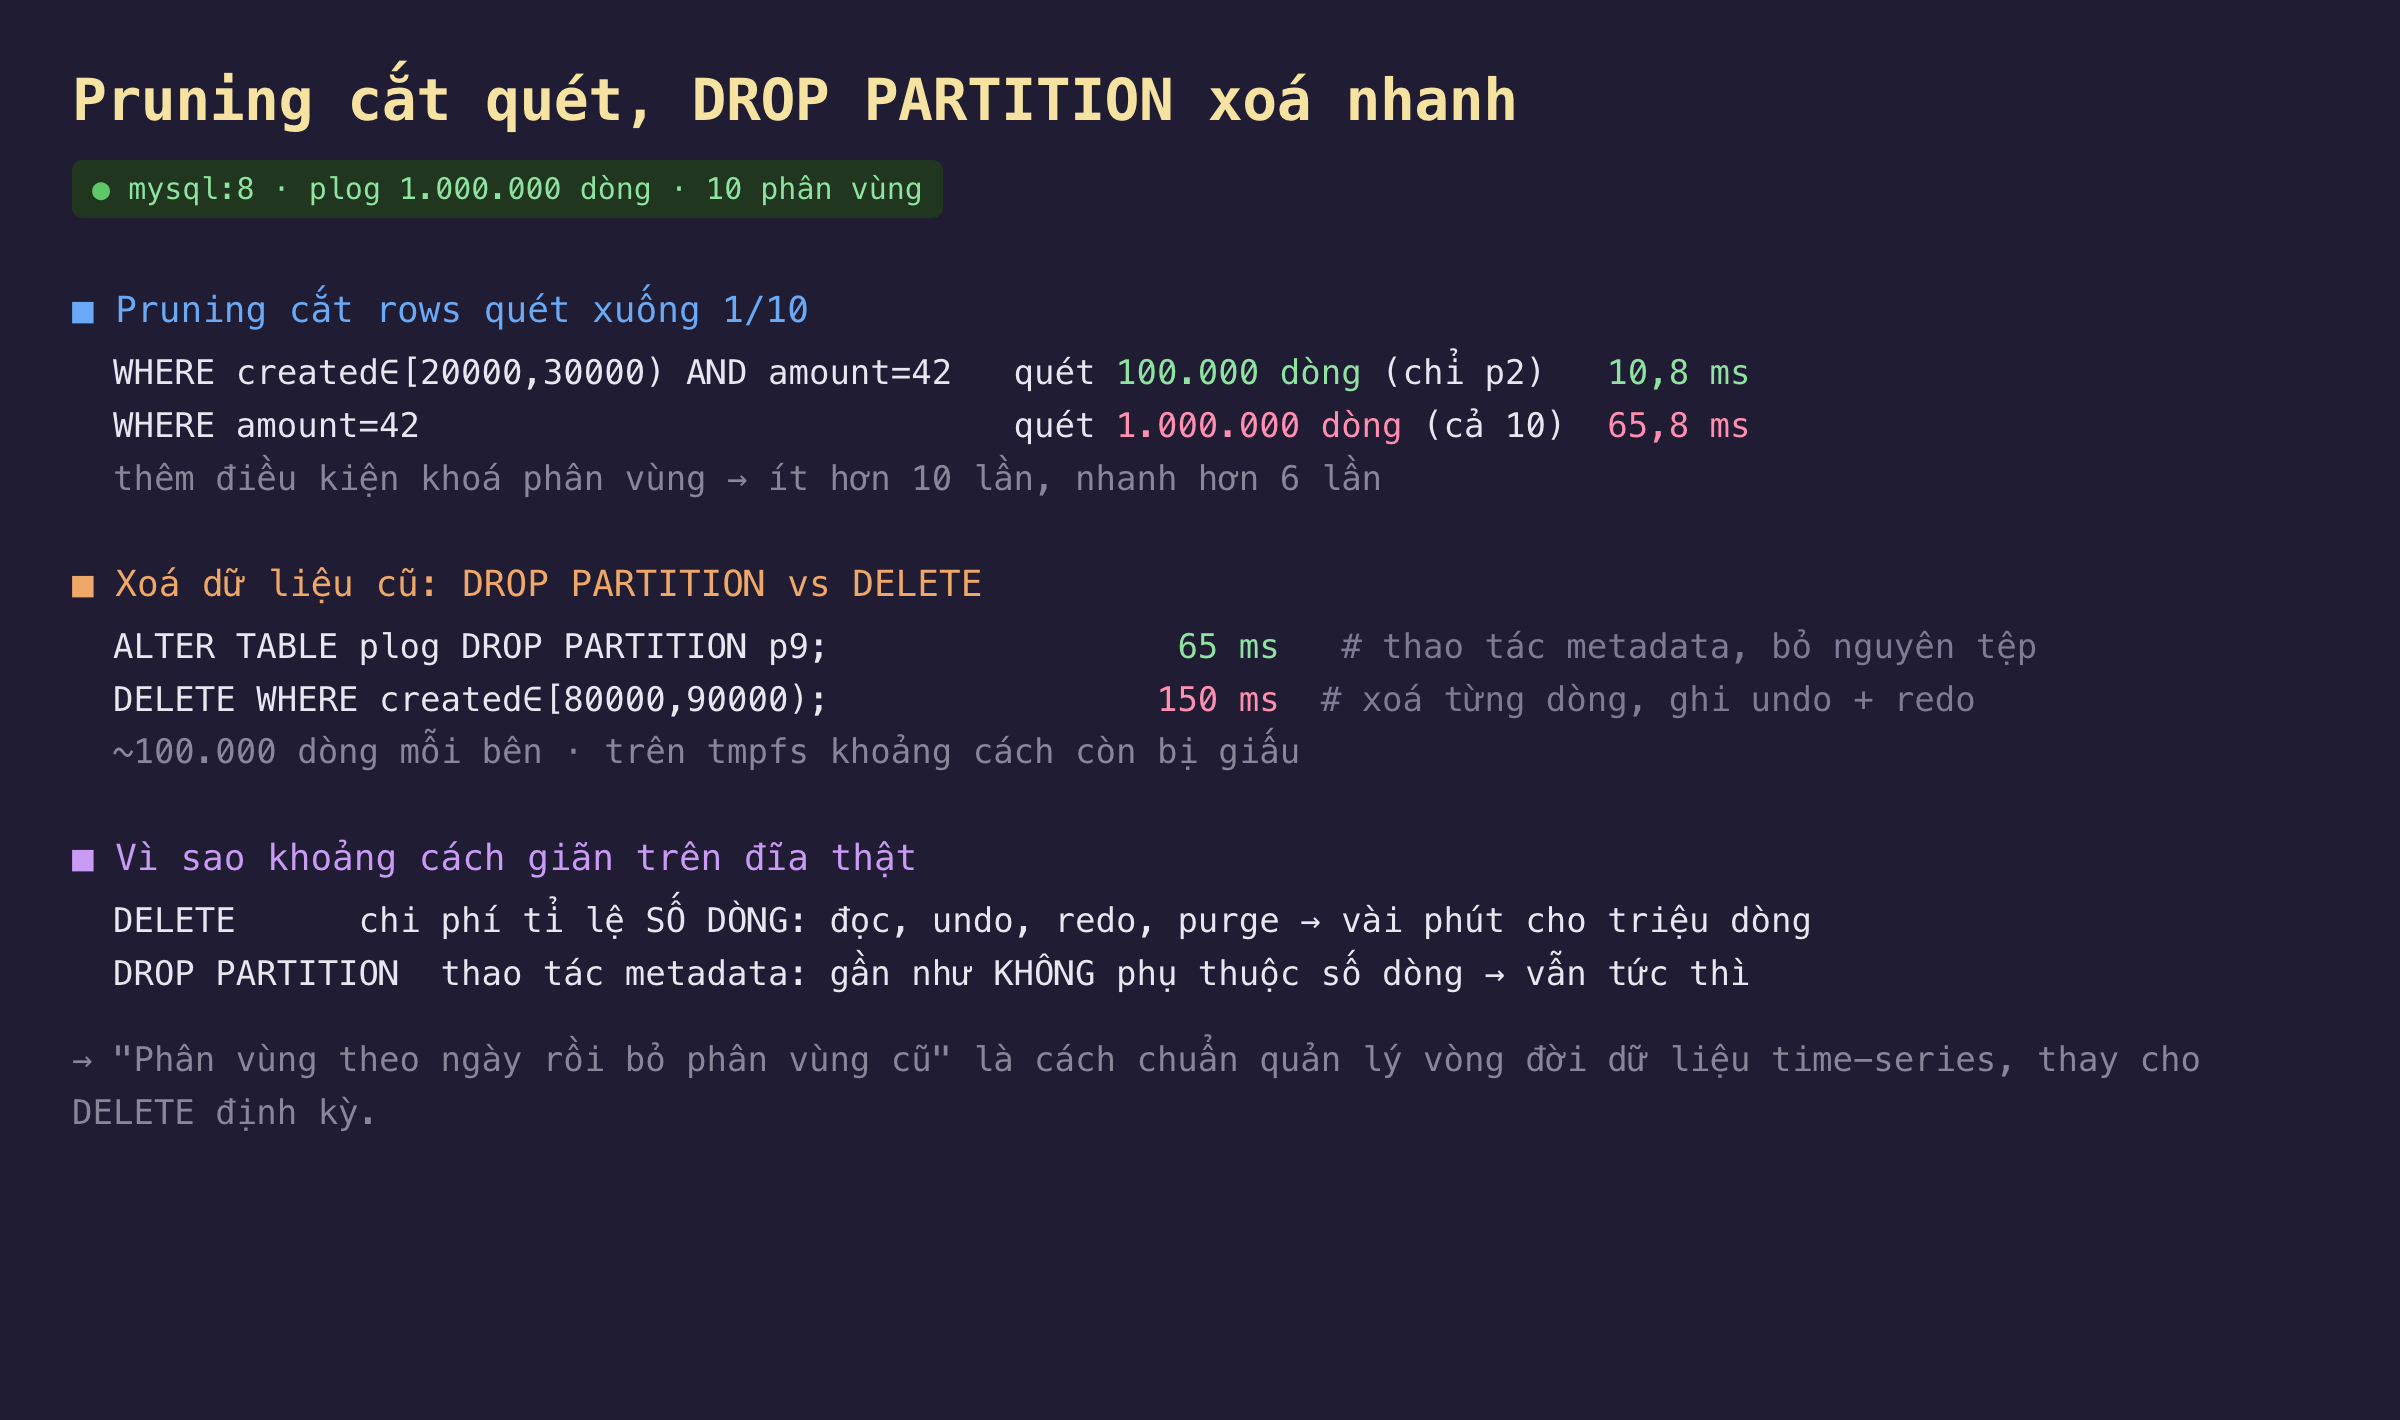
Hình 2: pruning cắt rows quét từ 1 triệu xuống 100 nghìn (65,8 → 10,8 ms); DROP PARTITION xoá cả khoảng bằng thao tác metadata, nhanh hơn và không phụ thuộc số dòng như DELETE.
Những ràng buộc cần nhớ
Partitioning mạnh nhưng có cái giá và điều kiện. Khoá phân vùng phải nằm trong mọi khoá duy nhất của bảng, kể cả khoá chính — đó là lý do plog có khoá chính (id, created) chứ không chỉ id: nếu không, InnoDB không thể bảo đảm tính duy nhất mà chỉ nhìn trong một phân vùng. Pruning chỉ xảy ra khi truy vấn lọc theo khoá phân vùng; một truy vấn lọc theo cột khác không được lợi gì, thậm chí còn chậm hơn bảng thường vì phải mở nhiều phân vùng. Và partitioning không thay thế index — bên trong mỗi phân vùng vẫn cần index cho các truy vấn điểm; partitioning chỉ cắt bớt phần nào của bảng cần tìm, còn index quyết định tìm trong phần đó nhanh ra sao. Chọn khoá phân vùng là chọn theo cách dữ liệu được lọc và được xoá theo lô — thường là một cột thời gian.
Ba ý mang về
- Partitioning chia một bảng logic thành nhiều phân vùng vật lý theo khoá, và pruning cho truy vấn chỉ chạm phân vùng cần. Lọc
created=chạm 1 phân vùng (p2),BETWEENchạm p1,p2,p3, còn lọc cột không phải khoá phân vùng quét cả 10. CộtpartitionstrongEXPLAINcho thấy chính xác. - Pruning cắt khối lượng quét xuống tỉ lệ số phân vùng bị bỏ qua. Cùng tìm
amount=42: thêm điều kiện khoá phân vùng để prune về p2 thì quét 100.000 dòng (10,8 ms), không prune thì quét 1.000.000 dòng (65,8 ms) — ít hơn mười lần. Hợp nhất với dữ liệu theo thời gian, nơi truy vấn chỉ hỏi vài khoảng gần đây. DROP PARTITIONxoá cả một khoảng dữ liệu bằng thao tác metadata, khôngDELETEtừng dòng. 65 ms so với 150 ms cho ~100.000 dòng trên tmpfs; trên đĩa thật khoảng cách giãn rất lớn vìDELETEghi undo/redo cho từng dòng cònDROP PARTITIONbỏ nguyên tệp. Phân vùng theo ngày rồi bỏ phân vùng cũ là cách chuẩn quản lý dữ liệu time-series.
Nguồn
- MySQL 8.4 Reference Manual — Partitioning (tổng quan, RANGE): https://dev.mysql.com/doc/refman/8.4/en/partitioning.html
- MySQL 8.4 Reference Manual — Partition Pruning: https://dev.mysql.com/doc/refman/8.4/en/partitioning-pruning.html
- MySQL 8.4 Reference Manual — Partitioning Keys, Primary Keys, and Unique Keys (ràng buộc khoá): https://dev.mysql.com/doc/refman/8.4/en/partitioning-limitations-partitioning-keys-unique-keys.html
- MySQL 8.4 Reference Manual — ALTER TABLE ... DROP PARTITION: https://dev.mysql.com/doc/refman/8.4/en/partitioning-management-range-list.html
Phần sau đi vào replication: dựng một máy chủ primary và một replica, xem binlog ghi lại mọi thay đổi và được phát sang replica, đo độ trễ nhân bản, và hiểu vì sao replica có thể tụt lại sau primary khi tải ghi cao.
