Một máy chủ MySQL đơn lẻ có hai giới hạn khó vượt: nó là điểm chết duy nhất (hỏng là mất dịch vụ), và mọi truy vấn đọc lẫn ghi đều dồn vào một chỗ. Replication — nhân bản — giải cả hai: dữ liệu được sao từ một primary sang một hay nhiều replica, để đọc có thể trải ra nhiều máy và một replica có thể lên thay khi primary hỏng. Bài này dựng thật một cặp primary–replica bằng hai container, đo thời gian một thay đổi lan tới replica, chỉ ra cơ chế giữ replica khỏi bị ghi nhầm, và đo cảnh "replica tụt lại rồi bắt kịp" — nút thắt thường gặp nhất của hệ nhân bản.
Binlog, relay log, và hai luồng của replica
Cơ chế nhân bản của MySQL xoay quanh binary log (binlog): primary ghi mọi thay đổi dữ liệu vào binlog theo thứ tự. Trên replica có hai luồng làm việc nối tiếp. Luồng IO kết nối tới primary, kéo các sự kiện binlog về và chép vào relay log của replica. Luồng SQL đọc relay log và áp dụng từng thay đổi vào dữ liệu của replica. Hai luồng tách rời này là chìa khoá để hiểu lag: dữ liệu có thể đã tới replica (nằm trong relay log) nhưng chưa được áp dụng xong.
Điểm cốt lõi: nhân bản mặc định là bất đồng bộ. Primary ghi binlog rồi trả về commit ngay, không chờ replica nhận hay áp dụng. Nhờ vậy ghi trên primary không bị chậm theo replica, nhưng đổi lại replica luôn đi sau primary một khoảng — thường rất nhỏ, nhưng có thể nới ra khi tải cao. Thiết lập trong bài dùng GTID (global transaction identifier) để replica tự biết đã áp dụng tới đâu và tiếp tục đúng chỗ, và binlog định dạng ROW (ghi lại giá trị hàng thay đổi, chính xác hơn ghi lại câu lệnh).
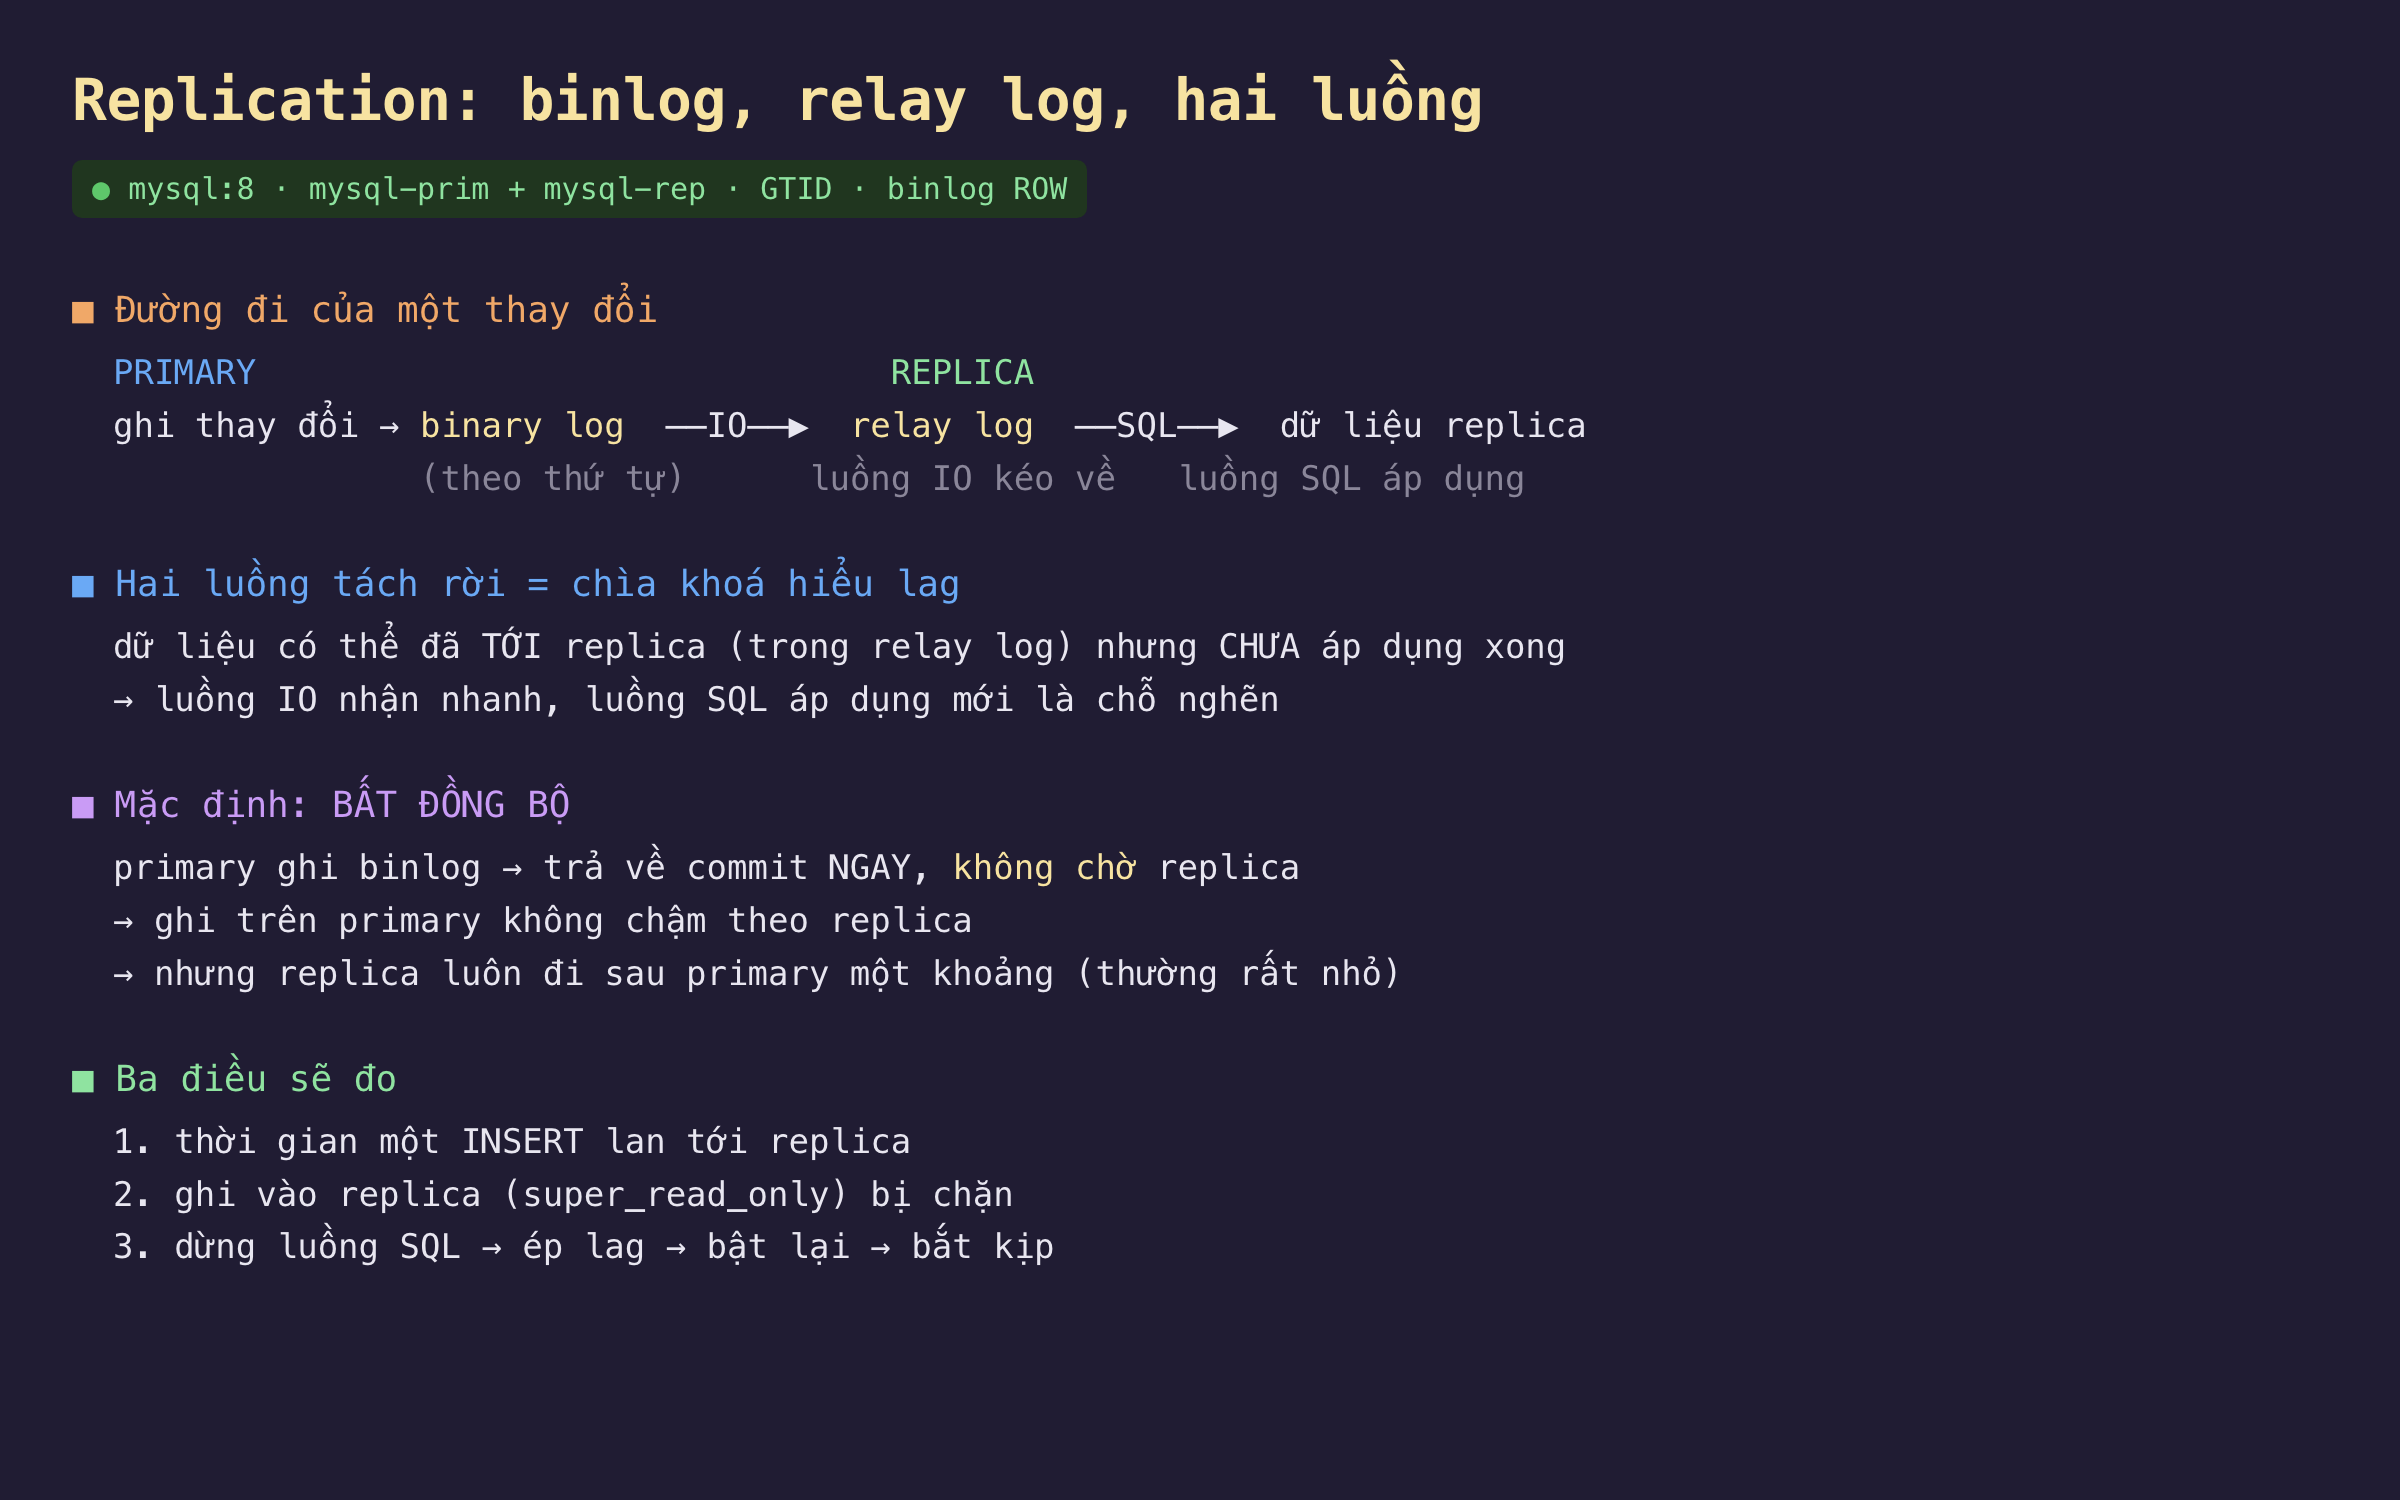
Hình 1: primary ghi binlog; luồng IO của replica kéo về relay log, luồng SQL áp dụng — tách rời nên dữ liệu có thể đã tới mà chưa áp dụng xong.
Một thay đổi lan tới replica sau 59 ms
Dựng hai container mysql-prim và mysql-rep nối qua một mạng Docker, cấu hình replication bằng GTID. Tạo một bảng và chèn một hàng trên primary, rồi đo bao lâu replica đọc được:
primary:  INSERT INTO t VALUES (1, 'hello');
replica:  SELECT v FROM t WHERE id = 1;   → 'hello'   sau ~59 ms
Năm mươi chín mili-giây để một thay đổi đi trọn đường: ghi vào binlog primary, luồng IO kéo sang relay log, luồng SQL áp dụng vào bảng của replica. Đây là độ trễ nhân bản ở trạng thái rảnh — rất nhỏ, gần như tức thì với mắt người. Trong một hệ thực, con số này phụ thuộc độ trễ mạng giữa primary và replica và tải hiện thời, nhưng ở điều kiện bình thường, replica phản chiếu primary chỉ sau một nhịp ngắn.
Replica chặn ghi: super_read_only
Một replica phải là bản sao chỉ đọc — nếu ai đó ghi thẳng vào replica, dữ liệu của nó lệch khỏi primary và nhân bản vỡ. MySQL có cờ read_only, nhưng nó không chặn người dùng có quyền SUPER như root. Để chặn triệt để, dùng super_read_only:
replica:  SET GLOBAL super_read_only = ON;
replica:  INSERT INTO t VALUES (500, 'blocked');
          → ERROR 1290 (HY000): The MySQL server is running with the
            --super-read-only option so it cannot execute this statement
Ngay cả root cũng bị chặn — chỉ luồng SQL của nhân bản mới được ghi vào replica. Đây là lớp bảo vệ bắt buộc cho mọi replica: nó đảm bảo nguồn thay đổi duy nhất của replica là relay log từ primary, không có cửa sau nào làm hai bên phân kỳ. Quên bật super_read_only là một trong những nguyên nhân kinh điển khiến replica "trôi" khỏi primary rồi báo lỗi khi gặp hàng không khớp.
Replica tụt lại, rồi bắt kịp
Vì nhân bản bất đồng bộ, replica có thể đi sau primary khi luồng SQL áp dụng không theo kịp tốc độ ghi. Để thấy rõ, cố ý dừng luồng SQL của replica (luồng IO vẫn chạy, vẫn nhận binlog vào relay log), rồi ghi hai mươi nghìn dòng vào primary:
replica:  STOP REPLICA SQL_THREAD;
primary:  (chèn 20.000 dòng vào lagdemo)

  primary = 20.000 dòng,  replica = 0 dòng   → TRỄ 20.000 dòng
Replica tụt lại đúng hai mươi nghìn dòng: dữ liệu đã nằm trong relay log của nó (luồng IO vẫn kéo về) nhưng chưa được áp dụng vì luồng SQL đang dừng. Đây chính xác là hình ảnh của replication lag trong thực tế — chỉ khác là ở đây ta tạo nó bằng tay. Bật lại luồng áp dụng, replica replay relay log và bắt kịp:
replica:  START REPLICA SQL_THREAD;
  → replica = 20.000 dòng = primary, sau 1.646 ms
Một giây sáu, replica áp xong cả hai mươi nghìn dòng dồn ứ và khớp lại với primary. Ở điều kiện tải bình thường trên cùng phần cứng, replica theo kịp primary gần như tức thời (độ trễ ~0); lag chỉ xuất hiện khi luồng áp dụng không theo kịp — do replica yếu hơn primary, do áp dụng tuần tự không kịp một burst ghi lớn, hay do một giao dịch dài chặn luồng SQL. Theo dõi Seconds_Behind_Source là cách thường dùng để báo động khi replica tụt quá xa, vì đọc từ một replica trễ nghĩa là đọc dữ liệu cũ.
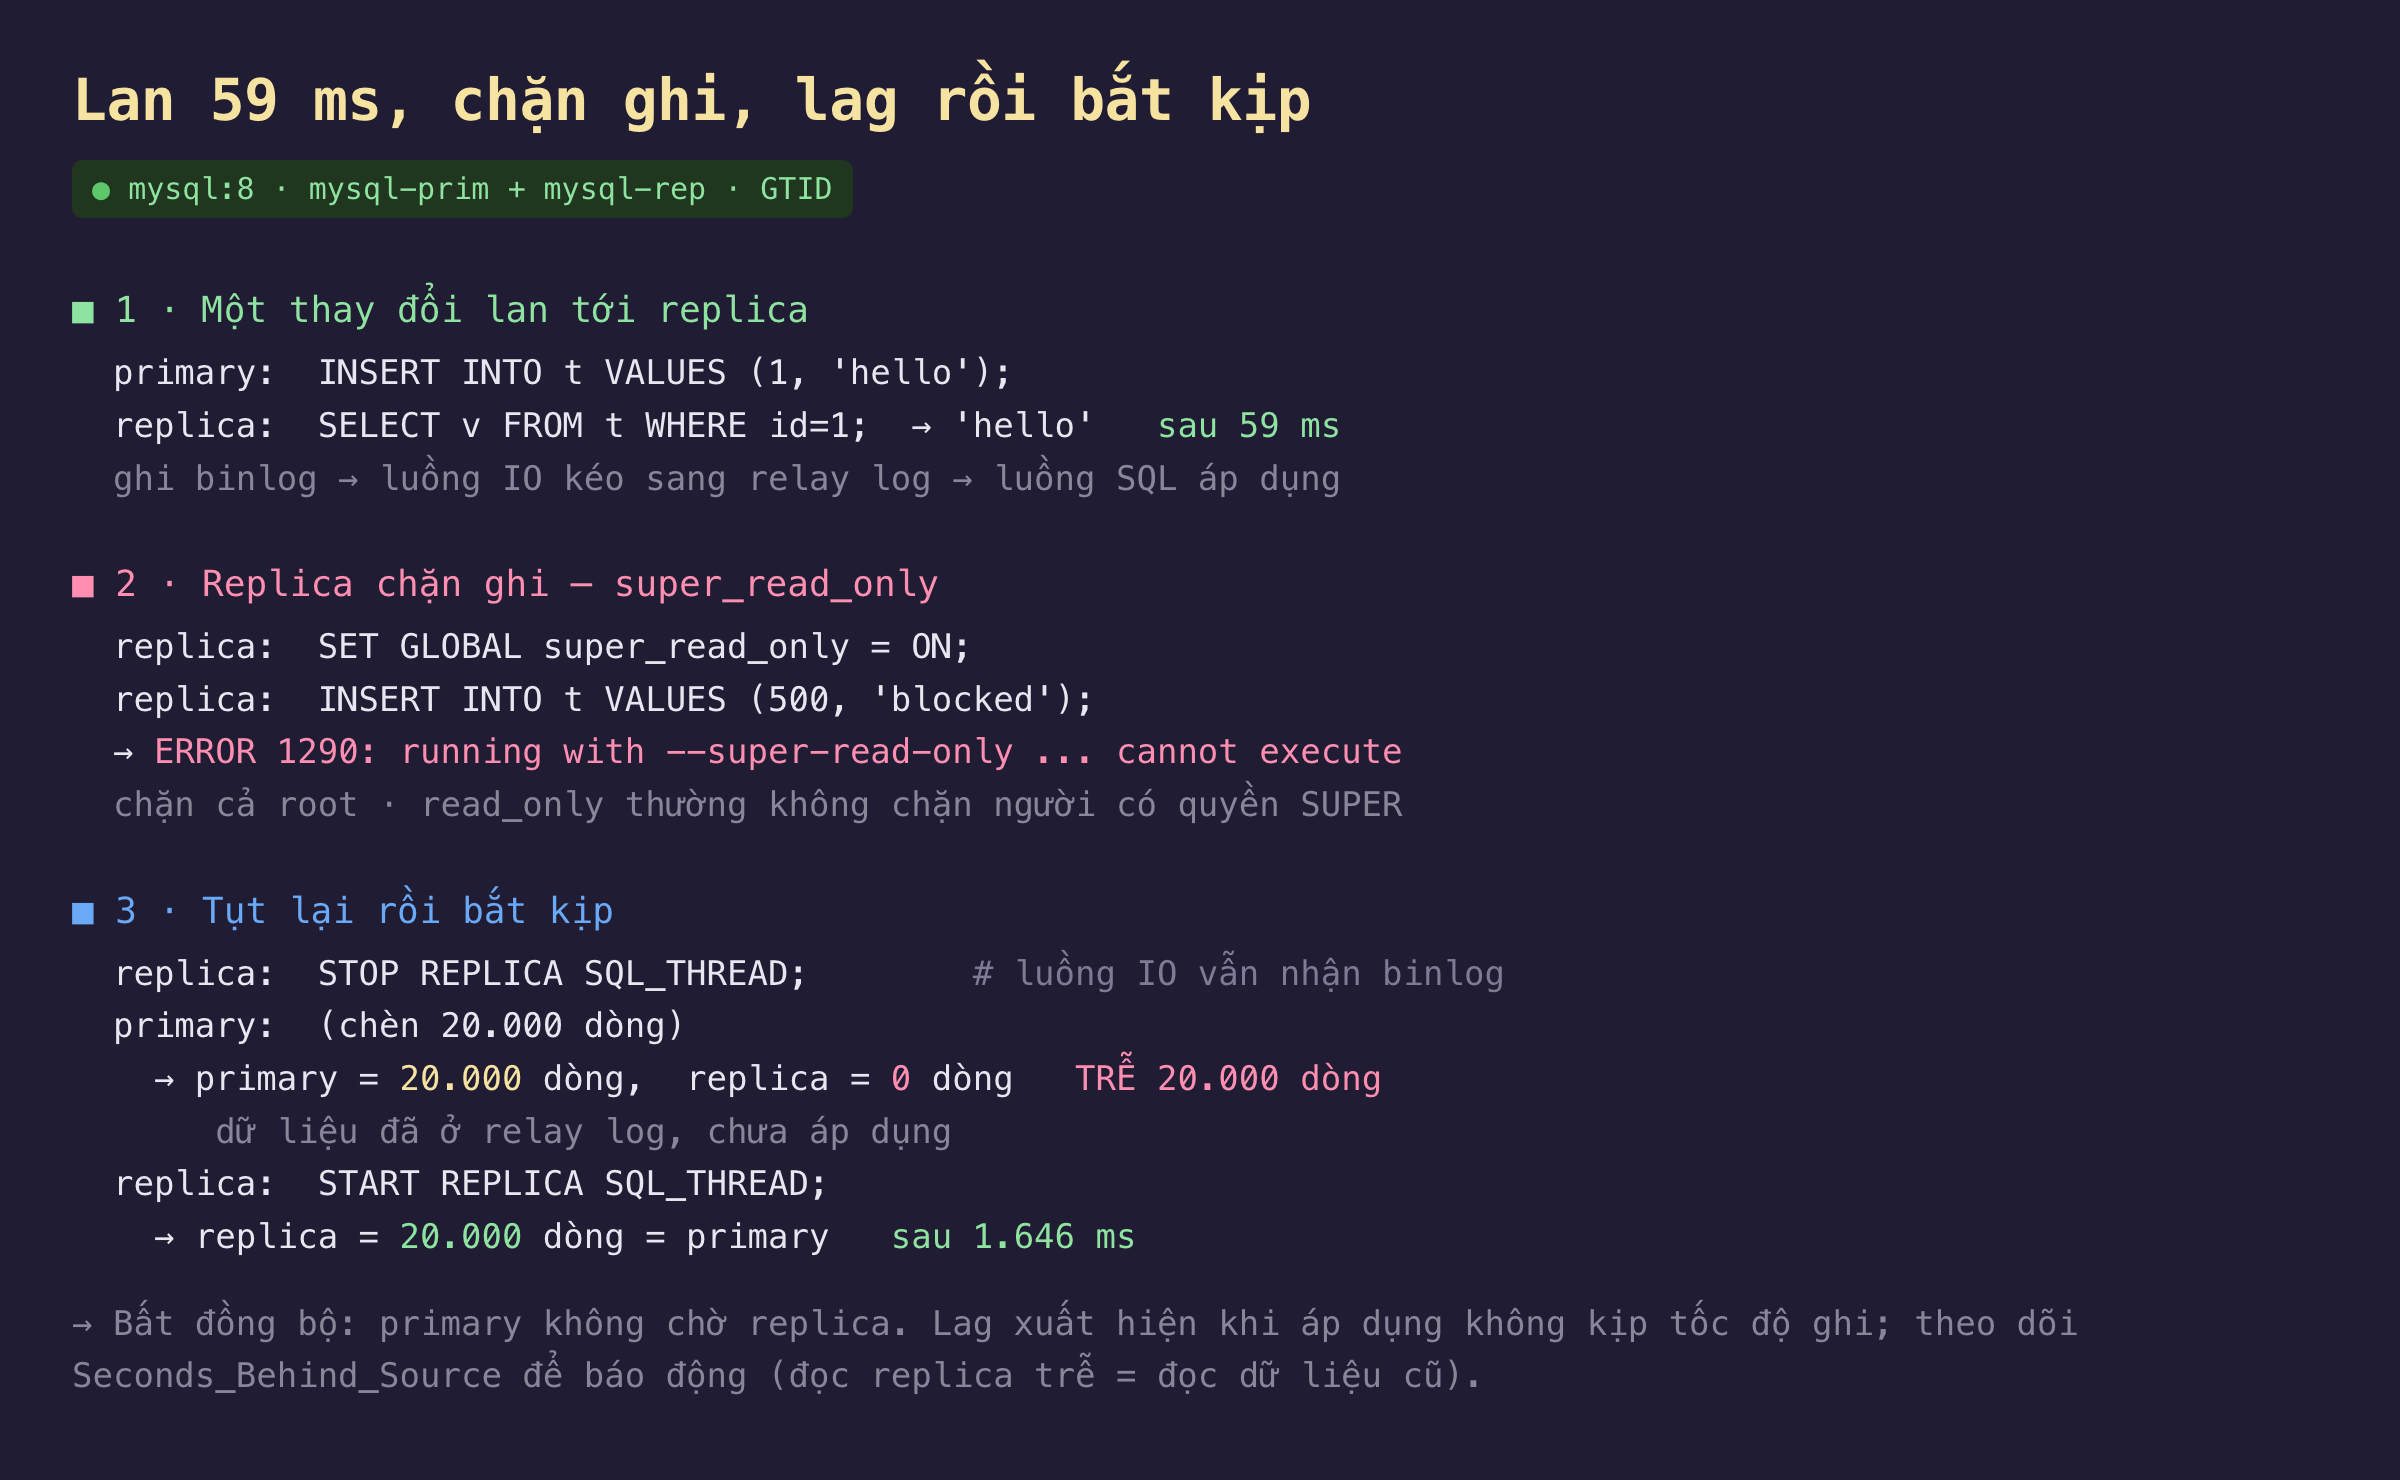
Hình 2: một thay đổi tới replica sau 59 ms; super_read_only chặn cả root (lỗi 1290); dừng luồng áp dụng ép lag 20.000 dòng rồi bật lại bắt kịp trong 1,6 giây.
Ba ý mang về
- Replication nhân bản dữ liệu qua binlog, bất đồng bộ, với hai luồng trên replica. Luồng IO kéo binlog của primary vào relay log, luồng SQL áp dụng. Một thay đổi đi trọn đường tới replica sau ~59 ms ở trạng thái rảnh. Primary commit không chờ replica, nên ghi không chậm theo replica nhưng replica luôn đi sau một khoảng.
- Replica phải chỉ đọc, và
super_read_onlychặn cả root.read_onlythường không chặn người có quyền SUPER;super_read_onlykhiến cảrootnhận lỗi 1290. Đây là lớp bảo vệ bắt buộc để nguồn thay đổi duy nhất của replica là relay log từ primary, tránh phân kỳ dữ liệu. - Replica có thể tụt lại rồi bắt kịp — đó là replication lag. Dừng luồng SQL rồi ghi 20.000 dòng vào primary làm replica trễ đúng 20.000 dòng (dữ liệu đã ở relay log, chưa áp dụng); bật lại thì replay và bắt kịp trong 1,6 giây. Lag xuất hiện khi áp dụng không theo kịp tốc độ ghi; theo dõi
Seconds_Behind_Sourceđể báo động.
Nguồn
- MySQL 8.4 Reference Manual — Replication (binlog, relay log, luồng IO/SQL): https://dev.mysql.com/doc/refman/8.4/en/replication.html
- MySQL 8.4 Reference Manual — Replication with Global Transaction Identifiers (GTID): https://dev.mysql.com/doc/refman/8.4/en/replication-gtids.html
- MySQL 8.4 Reference Manual — super_read_only và read_only: https://dev.mysql.com/doc/refman/8.4/en/server-system-variables.html#sysvar_super_read_only
- MySQL 8.4 Reference Manual — Checking Replication Status (
Seconds_Behind_Source): https://dev.mysql.com/doc/refman/8.4/en/replication-administration-status.html
Phần sau khép lại sê-ri bằng một checklist tối ưu MySQL đo thật: gom mọi phép đo từ clustered index, buffer pool, B+tree, secondary index, EXPLAIN, MVCC, khoá, redo log, covering index, partitioning và replication thành một quy trình chẩn đoán — từ một truy vấn chậm tới nguyên nhân gốc và cách sửa.
