Khi một giao dịch COMMIT trả về thành công, bạn tin rằng dữ liệu đã an toàn — dù ngay giây sau máy chủ mất điện. Nhưng InnoDB không thể ghi thẳng mọi thay đổi vào đúng chỗ của chúng trên đĩa ở mỗi lần commit: các trang nằm rải rác, ghi ngẫu nhiên như vậy quá chậm. Thay vào đó nó dùng redo log — một cuốn nhật ký ghi tuần tự những thay đổi, flush trước khi commit trả về. Trang dữ liệu thật được ghi về sau, thong thả. Đây là write-ahead logging, và tham số điều khiển độ bền của nó, innodb_flush_log_at_trx_commit, là một trong những nút chỉnh có ảnh hưởng lớn nhất tới throughput ghi. Bài này đo thật ảnh hưởng đó bằng chính số lần InnoDB gọi fsync.
Redo log: ghi tuần tự trước, trang dữ liệu sau
Mỗi thay đổi được ghi vào redo log dưới dạng "trang X, vị trí Y, đổi thành Z" — một bản ghi nhỏ, nối tiếp vào cuối log. Khi commit, InnoDB đảm bảo phần redo log tương ứng đã nằm an toàn trên đĩa; còn trang dữ liệu thật trong buffer pool thì được ghi về chỗ của nó sau, theo nhịp riêng. Nếu máy chủ sập, lúc khởi động lại InnoDB đọc redo log và làm lại (redo) những thay đổi chưa kịp vào trang dữ liệu — không mất gì đã commit. Vì redo log ghi tuần tự (nhanh) thay cho ghi ngẫu nhiên khắp đĩa (chậm), commit vừa bền vừa nhanh.
Mấu chốt của độ bền nằm ở động tác fsync — lệnh buộc hệ điều hành đẩy dữ liệu từ bộ đệm của nó xuống đĩa vật lý thật. innodb_flush_log_at_trx_commit quyết định InnoDB gọi fsync redo log khi nào:
- =1 (mặc định): ghi và fsync redo log ở MỖI commit. Bền tuyệt đối — commit xong là chắc chắn trên đĩa, sập kiểu gì cũng không mất.
- =2: ghi redo log vào bộ đệm hệ điều hành ở mỗi commit, nhưng fsync mỗi giây một lần. Sống sót khi MySQL sập, nhưng mất ~1 giây commit cuối nếu cả hệ điều hành hay nguồn điện sập.
- =0: ghi và fsync mỗi giây một lần. Nhanh nhất, nhưng mất ~1 giây commit cuối ngay cả khi chỉ MySQL sập.
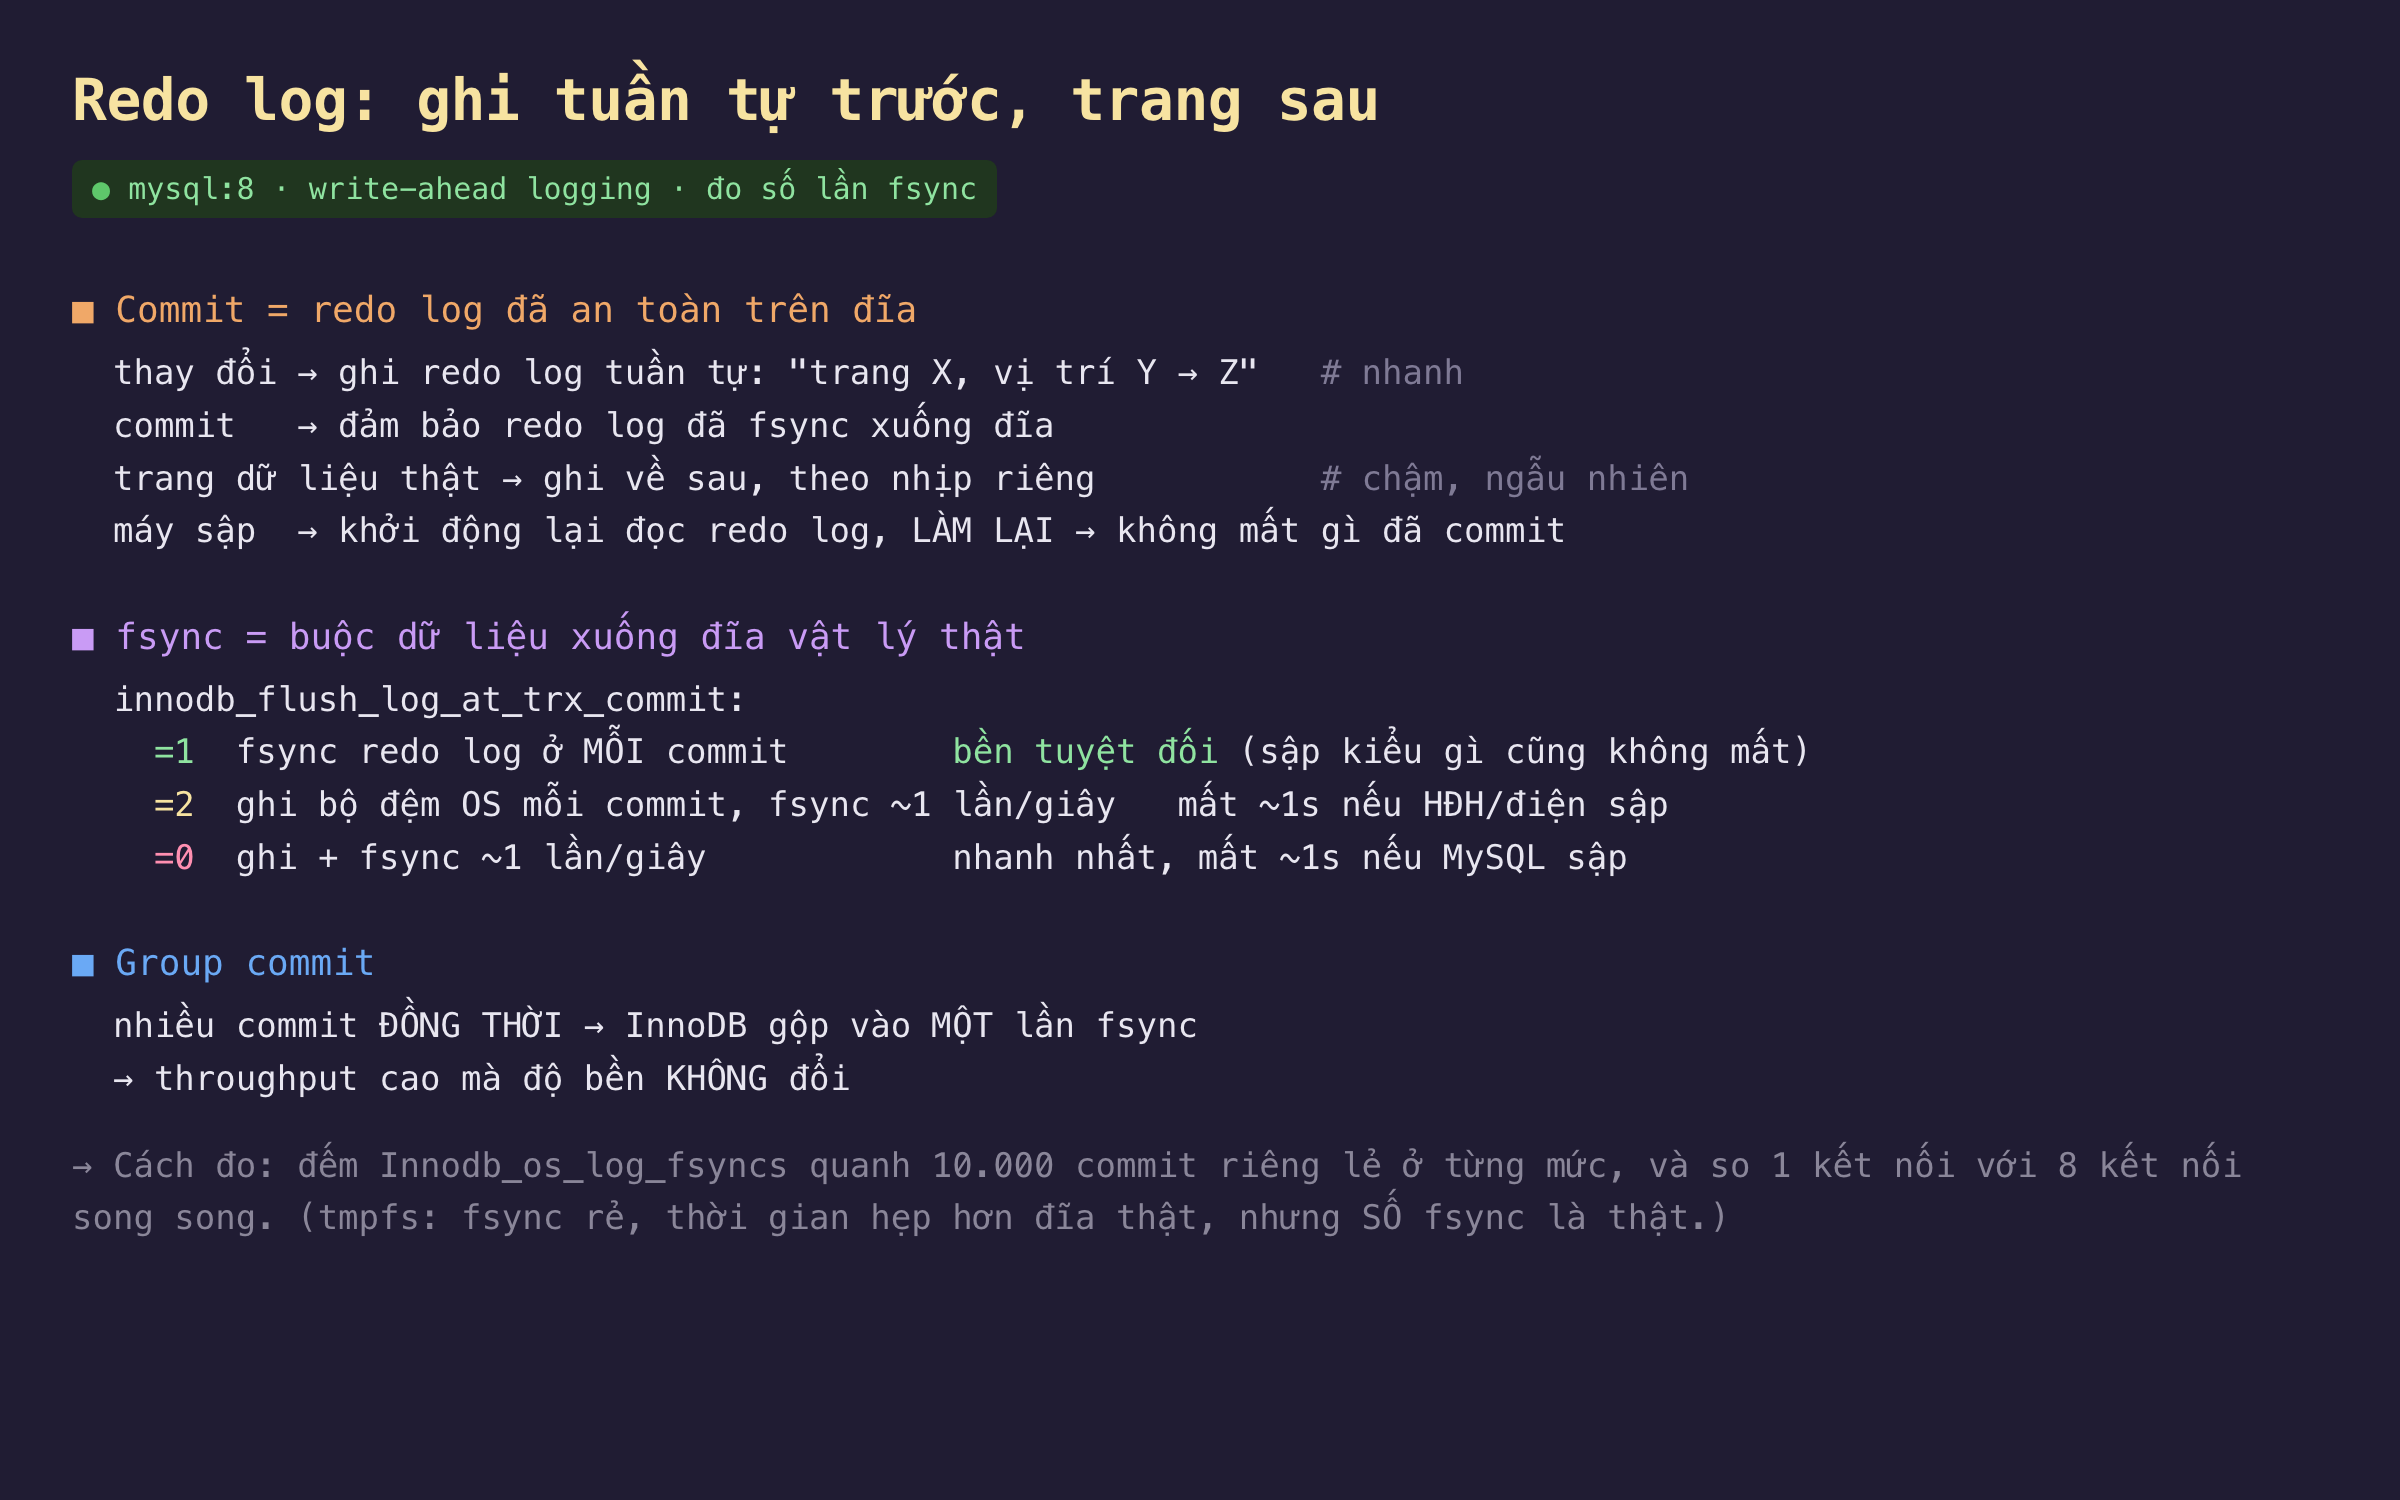
Hình 1: redo log ghi tuần tự trước khi commit trả về; innodb_flush_log_at_trx_commit quyết định fsync khi nào, đánh đổi độ bền lấy throughput.
Đếm fsync: 10.209 lần hay 4 lần
Cách trung thực nhất để thấy ba mức khác nhau là đếm số lần InnoDB thật sự gọi fsync redo log — biến trạng thái Innodb_os_log_fsyncs. Chạy mười nghìn câu INSERT riêng lẻ (mỗi câu một commit tự động) trên một kết nối, đo delta fsync và thời gian ở từng mức:
10.000 commit riêng lẻ, 1 kết nối
  flush=1:  redo fsyncs +10.209   1302 ms    7.680 commit/s   ← fsync mỗi commit
  flush=2:  redo fsyncs +4         963 ms   10.384 commit/s   ← fsync ~1 lần/giây
  flush=0:  redo fsyncs +1         559 ms   17.889 commit/s   ← fsync ~1 lần/giây
Con số nói thẳng: ở mức 1, mười nghìn commit kéo theo 10.209 lần fsync — gần như đúng một fsync cho mỗi commit, đó chính là cái giá của độ bền tuyệt đối. Ở mức 2 và mức 0, cả mười nghìn commit chỉ gom lại 4 và 1 lần fsync vì InnoDB chỉ fsync mỗi giây một lần. Số fsync ít đi kéo throughput tăng từ 7.680 lên 10.384 rồi 17.889 commit mỗi giây. Cần nói rõ, như các phần trước: dữ liệu ở đây trên tmpfs nên fsync rẻ, khoảng cách thời gian hẹp hơn đĩa thật nhiều; nhưng số lần fsync là chính xác, và trên đĩa quay hay SSD, mỗi fsync tốn hàng trăm micro-giây tới vài mili-giây, nên khoảng cách throughput giữa mức 1 và mức 2 sẽ giãn ra rất lớn. Đó là lý do mức 2 là lựa chọn quen thuộc cho hệ thống chịu được mất một giây dữ liệu cuối khi mất điện, đổi lấy throughput cao hơn nhiều.
Group commit: vừa bền vừa nhanh
Có một cách tăng throughput mà không hạ độ bền: để nhiều giao dịch commit đồng thời. InnoDB gộp các commit đến cùng lúc vào một lần fsync chung — gọi là group commit. Chạy lại đúng mười nghìn commit ở mức 1 (bền tuyệt đối), nhưng lần này rải qua tám kết nối song song:
flush=1, 10.000 commit
  1 kết nối:   redo fsyncs +10.209    7.680 commit/s
  8 kết nối:   redo fsyncs + 3.688   17.990 commit/s   ← cùng độ bền, gấp 2,3 lần
Cùng mức bền nhất, cùng mười nghìn commit, nhưng tám kết nối song song chỉ cần 3.688 lần fsync thay vì 10.209 — trung bình gần ba commit chung một fsync — và throughput nhảy từ 7.680 lên 17.990 commit mỗi giây. InnoDB không phải fsync riêng cho từng commit nữa; những commit nào xếp hàng cùng lúc được đẩy xuống đĩa trong một nhịp. Đây là lý do một máy chủ bận rộn đạt throughput ghi cao hơn hẳn phép nhân ngây thơ từ chi phí một commit đơn lẻ: càng nhiều commit đồng thời, fsync càng được chia sẻ. Và nó cho một lời khuyên thực tế ngược trực giác — với tải ghi cao, tăng số kết nối đồng thời (tới một mức) có thể tăng throughput tổng nhờ group commit, dù mỗi commit lẻ không nhanh hơn.
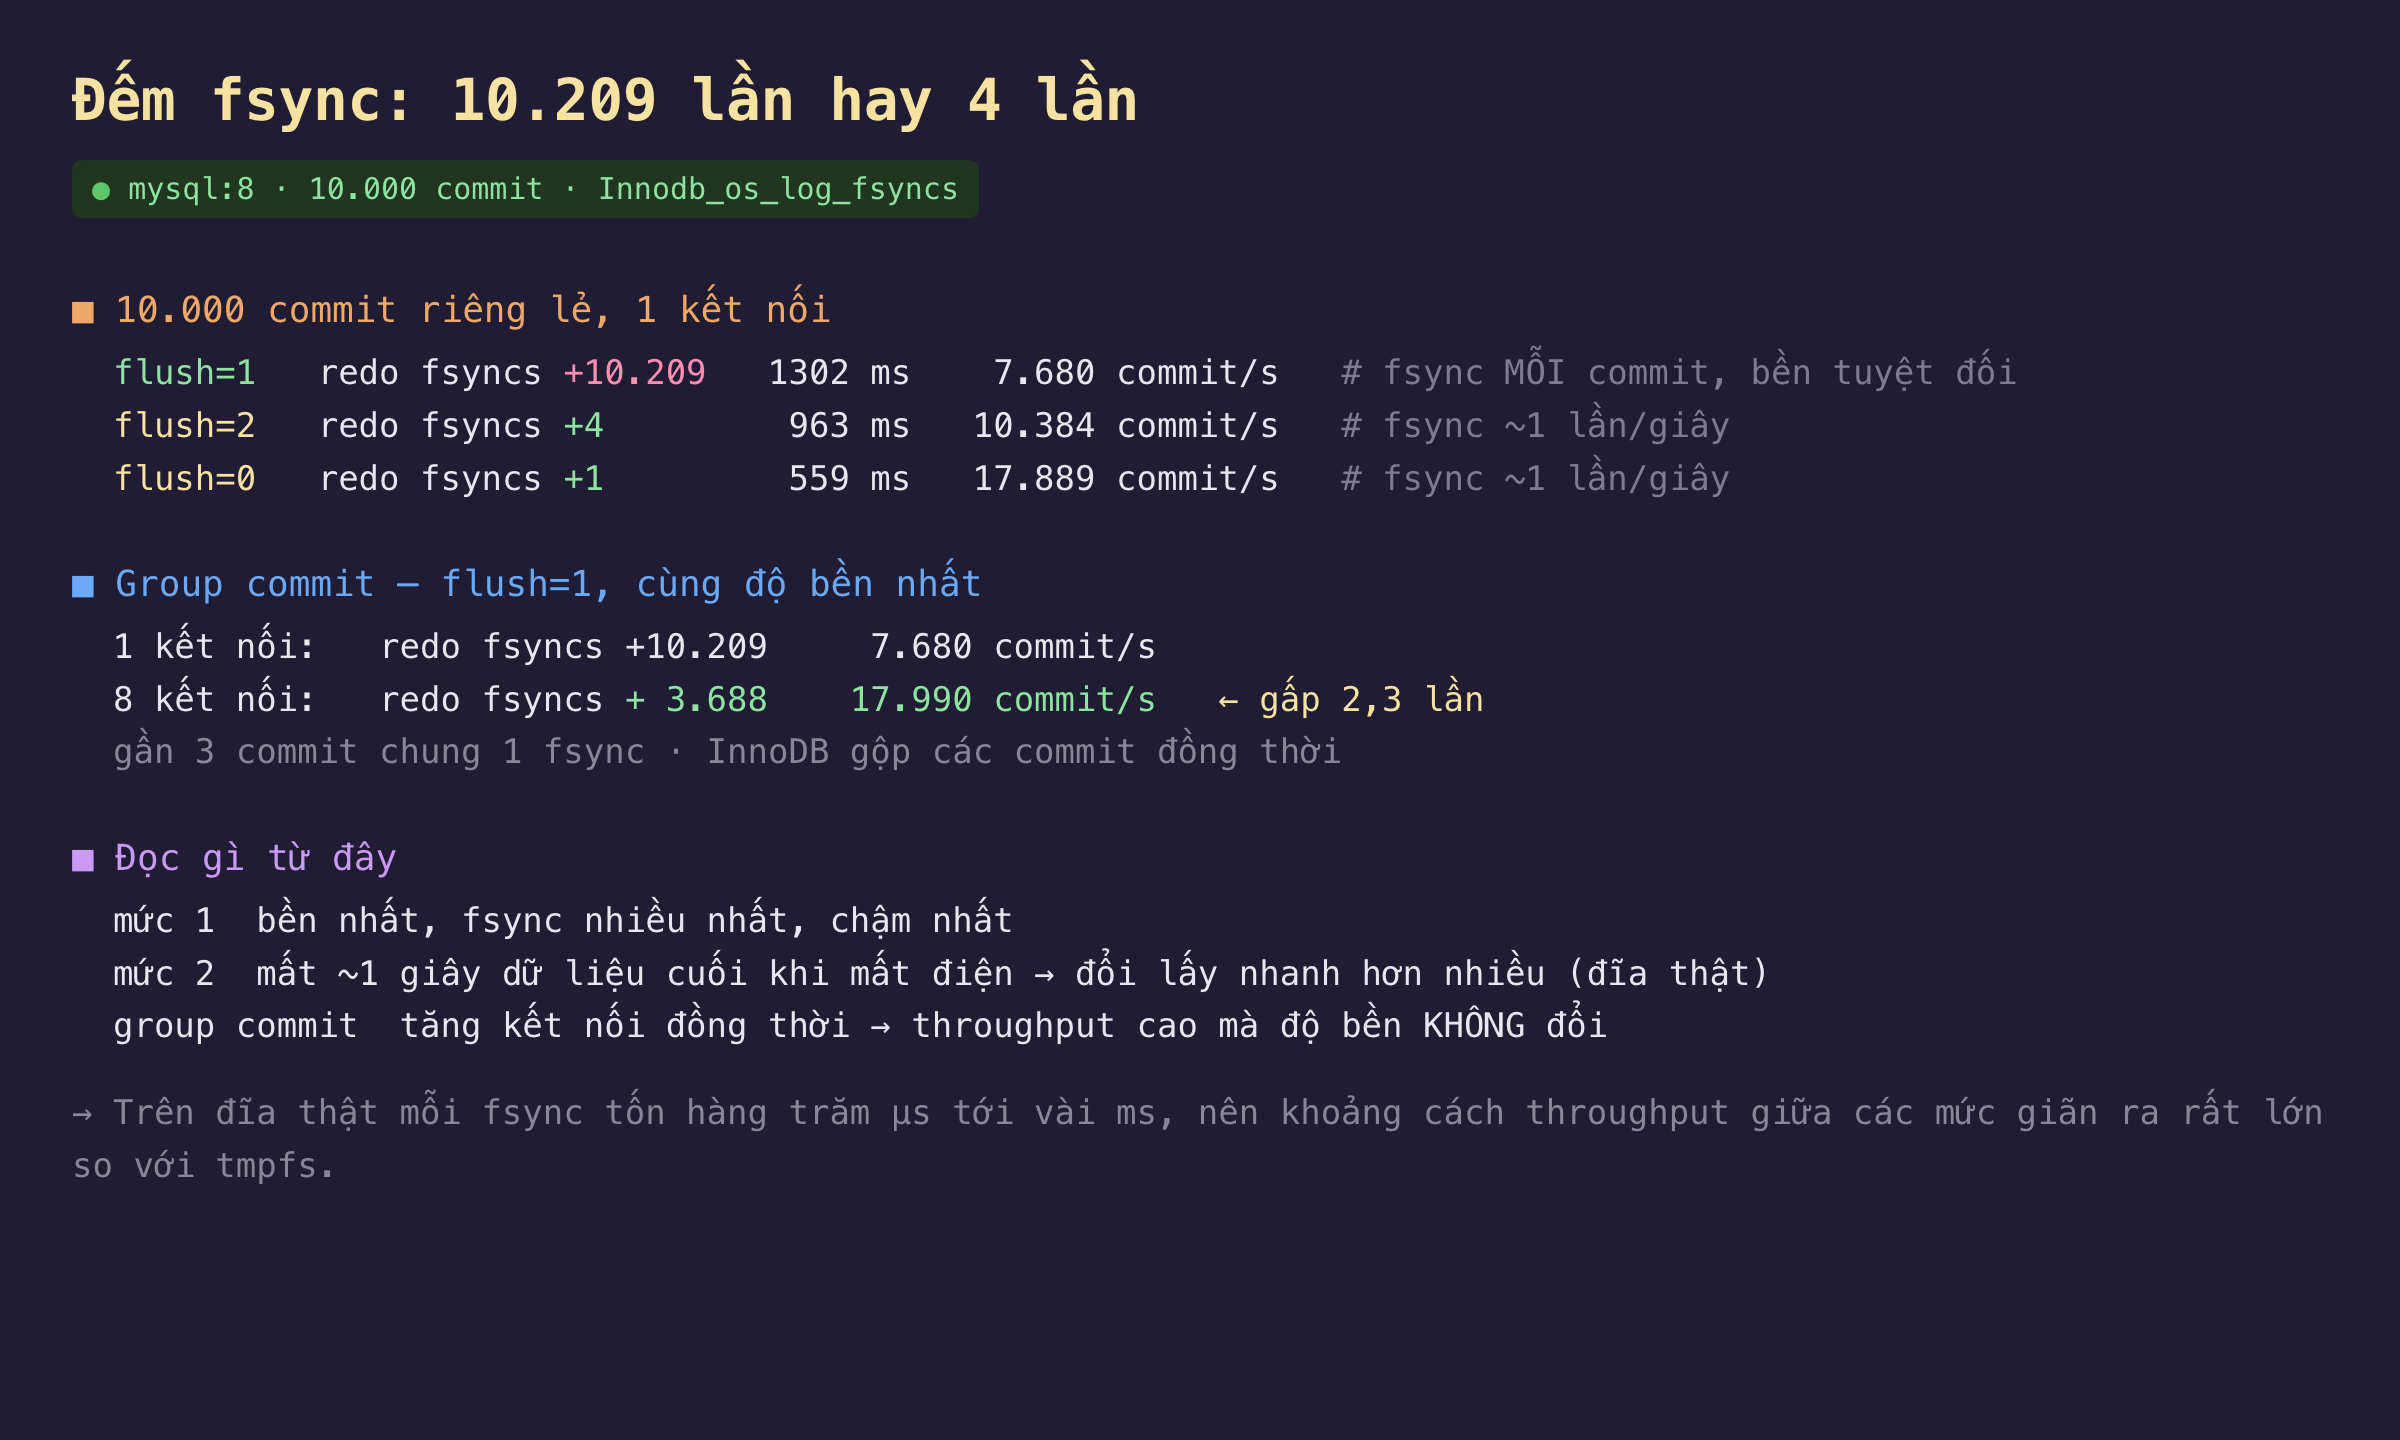
Hình 2: số fsync theo từng mức flush, và group commit gộp commit đồng thời xuống 3.688 fsync cho gấp đôi throughput ở cùng mức bền nhất.
Ba ý mang về
- Redo log là write-ahead logging: ghi tuần tự nhật ký thay đổi và fsync trước khi commit trả về, nên commit vừa bền vừa nhanh. Trang dữ liệu thật ghi về sau; nếu máy sập, InnoDB đọc redo log làm lại những gì đã commit. Độ bền nằm ở động tác fsync buộc dữ liệu xuống đĩa vật lý.
innodb_flush_log_at_trx_commitđánh đổi độ bền lấy throughput, đo được bằng số lần fsync. Mức 1 fsync mỗi commit (10.209 fsync cho 10.000 commit, bền tuyệt đối); mức 2 và 0 fsync mỗi giây (4 và 1 lần). Throughput tăng từ 7.680 lên 17.889 commit/s. Mức 2 mất ~1 giây dữ liệu cuối khi mất điện, đổi lấy nhanh hơn nhiều.- Group commit cho throughput cao mà không hạ độ bền. Ở mức bền nhất, mười nghìn commit qua 8 kết nối song song chỉ cần 3.688 lần fsync (thay vì 10.209) và đạt 17.990 commit/s — gấp 2,3 lần, vì InnoDB gộp các commit đồng thời vào một fsync. Tải ghi cao hưởng lợi từ việc tăng số kết nối đồng thời.
Nguồn
- MySQL 8.4 Reference Manual — innodb_flush_log_at_trx_commit: https://dev.mysql.com/doc/refman/8.4/en/innodb-parameters.html#sysvar_innodb_flush_log_at_trx_commit
- MySQL 8.4 Reference Manual — InnoDB Redo Log: https://dev.mysql.com/doc/refman/8.4/en/innodb-redo-log.html
- MySQL 8.4 Reference Manual — Group Commit và tối ưu redo log: https://dev.mysql.com/doc/refman/8.4/en/innodb-redo-log.html
- MySQL 8.4 Reference Manual — biến trạng thái
Innodb_os_log_fsyncs: https://dev.mysql.com/doc/refman/8.4/en/server-status-variables.html
Phần sau quay lại index để đo một kiểu tối ưu mạnh mà phần secondary index đã hé lộ: covering index và composite index. Đo thật khác biệt khi Using index xuất hiện trong EXPLAIN — truy vấn được trả lời trọn vẹn từ index mà không chạm clustered index một lần nào — và cách chọn thứ tự cột trong index composite để nó phủ được nhiều truy vấn nhất.
