Phần một đã nói một câu để dành cho bài này: trong InnoDB, secondary index không lưu địa chỉ vật lý của hàng — nó lưu giá trị khóa chính. Khác biệt nghe nhỏ đó quyết định phần lớn chuyện index nào giúp được truy vấn nào. Vì index phụ chỉ biết khóa chính của hàng chứ không biết hàng nằm đâu trên đĩa, muốn lấy các cột không có trong index, InnoDB phải tra ngược vào clustered index một lần nữa — và làm vậy cho từng hàng. Bài này đo thật cái giá của bước tra ngược đó, chỉ ra truy vấn phủ (covering index) né được nó thế nào, và vì sao qua một ngưỡng chọn lọc, bỏ index quét cả bảng lại rẻ hơn.
Secondary index lưu khóa chính, nên phải đi hai cây
Bảng đo tên ord, một triệu dòng: khóa chính id, cột cust có index phụ k_cust, và payload kiểu CHAR(100). Cột cust có 10.000 giá trị phân biệt, nên mỗi giá trị ứng với khoảng 100 dòng. Lá của index phụ k_cust chứa các cặp (cust, id) — giá trị cột được index cộng khóa chính — chứ không chứa payload và cũng không chứa địa chỉ hàng.
Giờ chạy SELECT payload FROM ord WHERE cust = 5000. InnoDB đi cây index phụ, tìm được 100 cặp (5000, id) — tức 100 khóa chính. Nhưng truy vấn cần payload, mà payload không nằm trong index phụ. Với mỗi khóa chính đó, InnoDB phải tra ngược vào clustered index để lấy trọn hàng — đây là bookmark lookup. Một trăm dòng kết quả nghĩa là một lần quét index phụ cộng một trăm lần tra ngược vào cây khóa chính, mỗi lần là một lần đi từ gốc xuống lá.
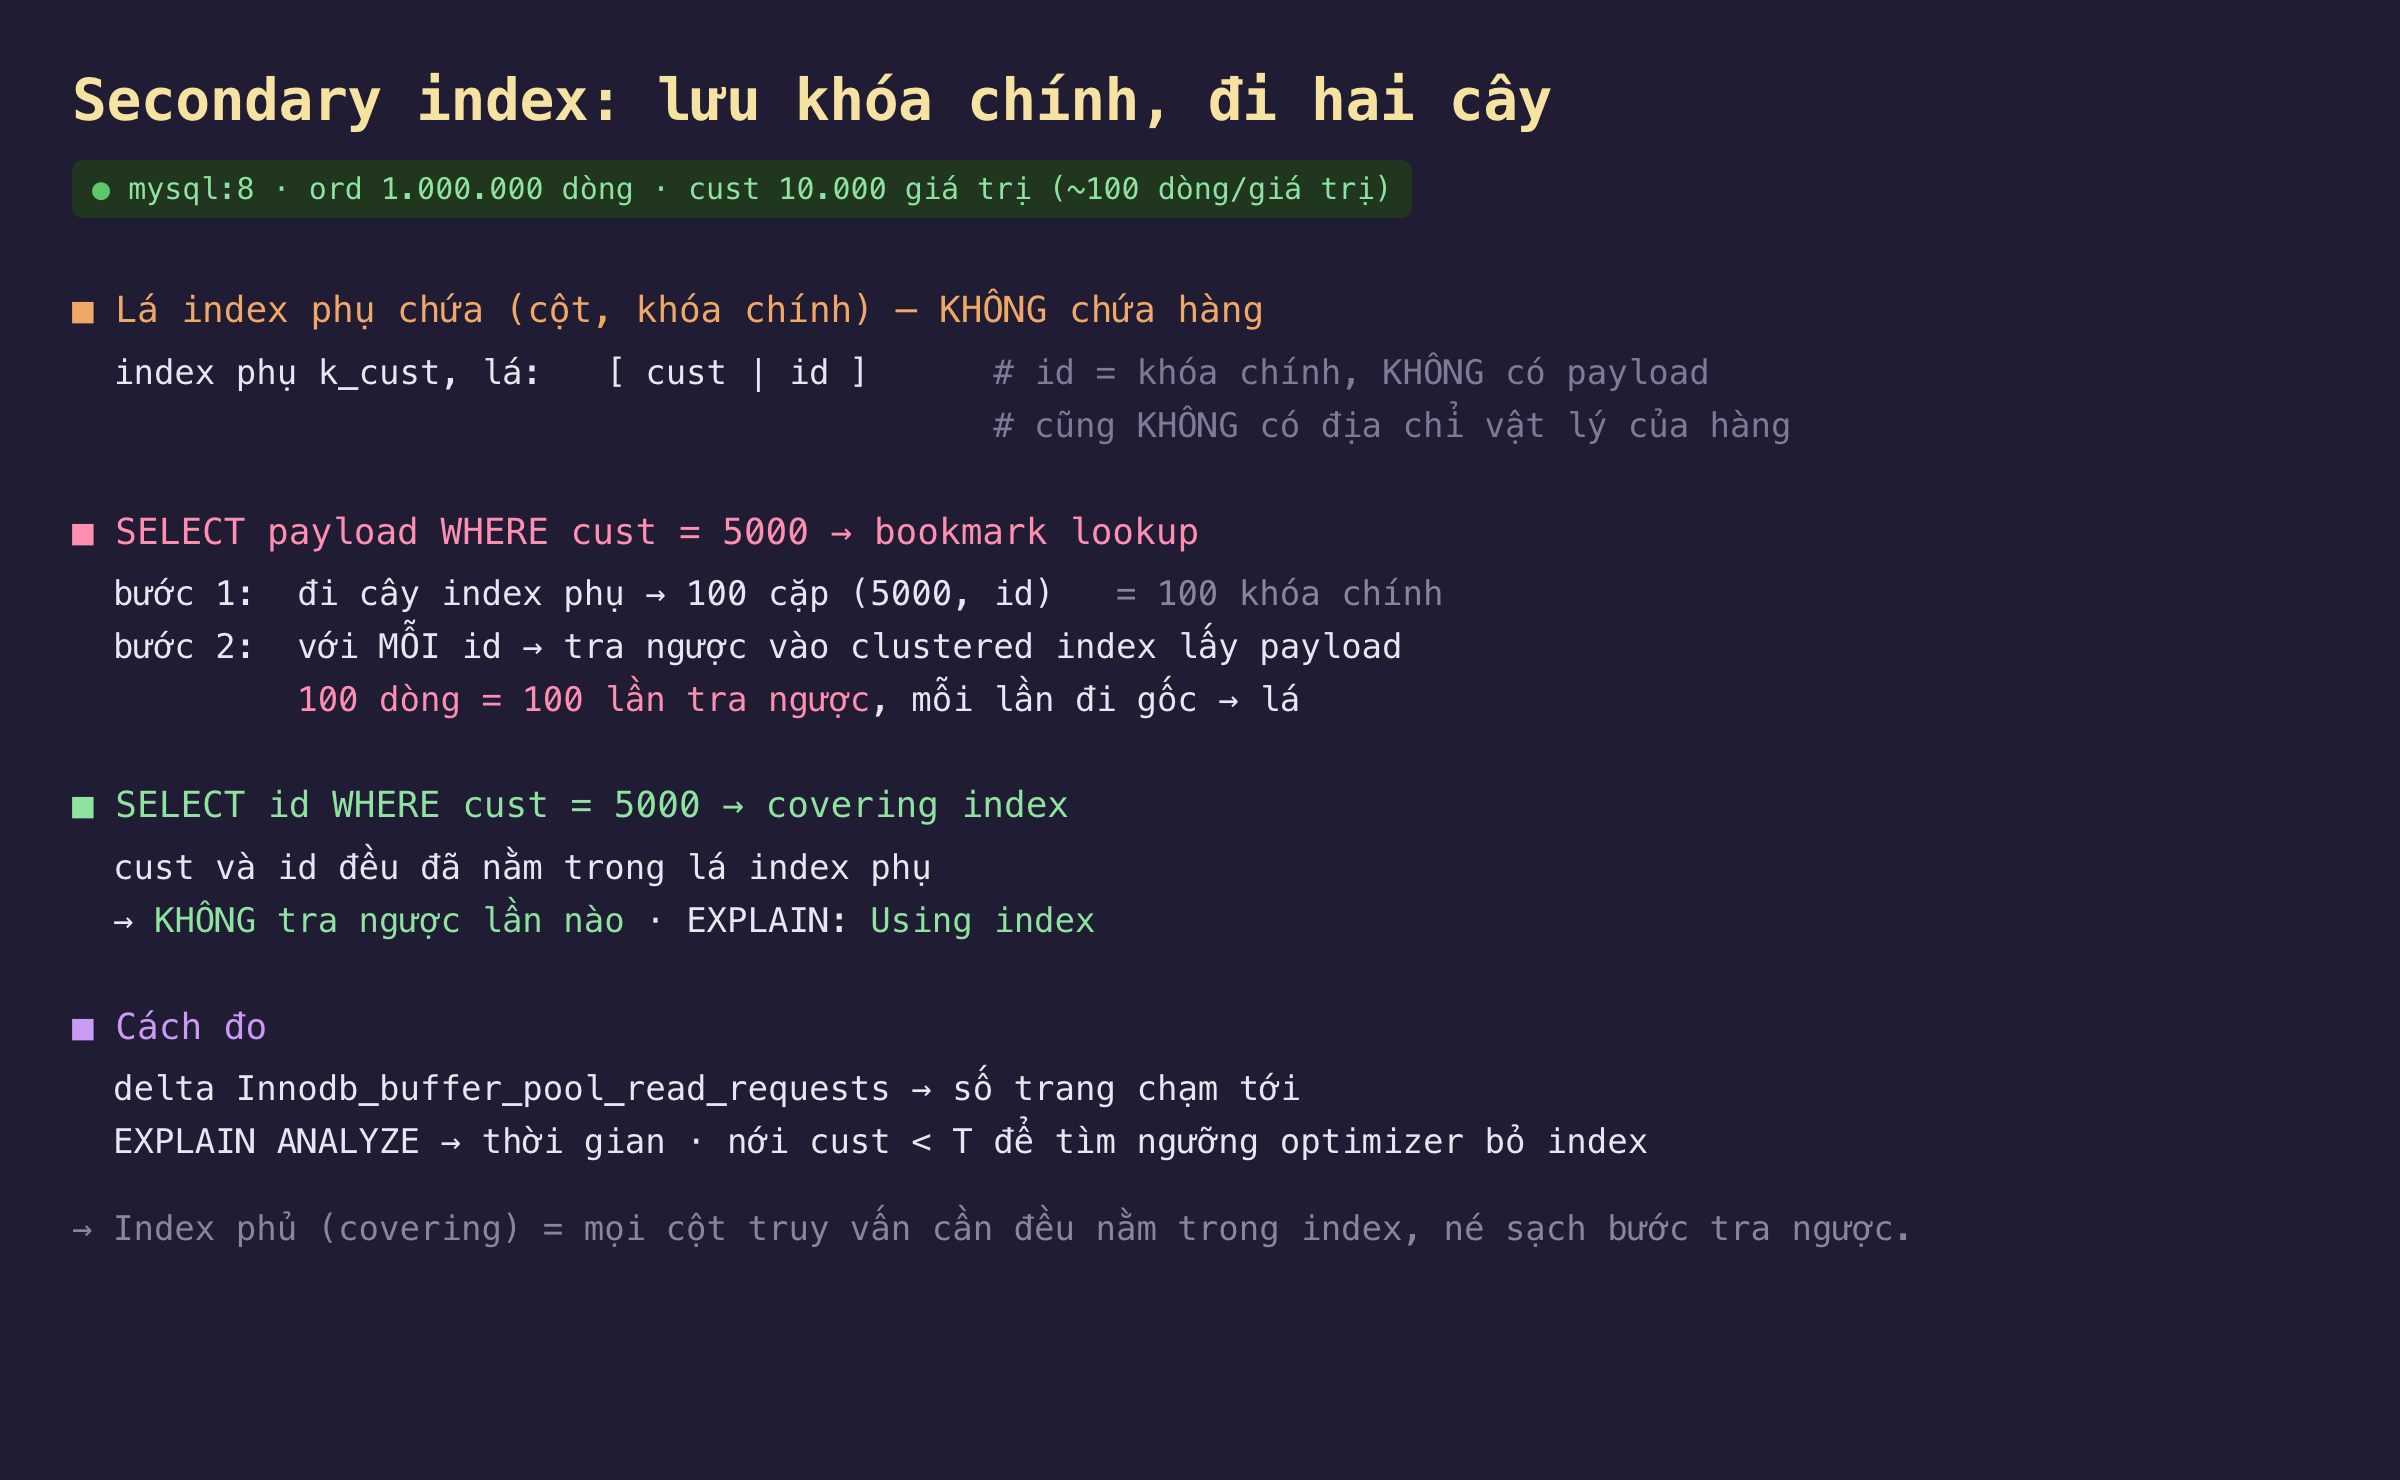
Hình 1: lá index phụ chứa (cột, khóa chính), không chứa hàng; lấy cột ngoài index phải tra ngược vào clustered index từng dòng (bookmark lookup).
410 trang cho 100 dòng, hay 10 trang nếu index phủ
Đo số trang chạm tới bằng delta Innodb_buffer_pool_read_requests quanh mỗi truy vấn, trên cùng 100 dòng kết quả:
SELECT payload FROM ord WHERE cust = 5000     → 410 trang   (EXPLAIN: ref, KHÔNG "Using index")
SELECT id      FROM ord WHERE cust = 5000     →  10 trang   (EXPLAIN: ref, "Using index")
Chênh lệch 41 lần chỉ vì một câu cần payload còn câu kia không. Câu đầu trả 100 dòng nhưng chạm 410 trang: vài trang đi cây index phụ, rồi khoảng 400 trang cho 100 lần tra ngược vào clustered index (mỗi lần vài trang, có chia sẻ các tầng trên). Câu sau chỉ cần id, mà id chính là khóa chính đã nằm sẵn trong lá index phụ — InnoDB trả lời chỉ bằng index phụ, không tra ngược một lần nào. EXPLAIN đánh dấu Using index: đó là covering index (index phủ), khi mọi cột truy vấn cần đều có trong index. EXPLAIN ANALYZE cho thấy câu phủ (0,01 ms) nhanh hơn câu có bookmark lookup (0,14 ms) cả chục lần.
Đây là bài học thực dụng nhất về index phụ: thêm vào index đúng những cột mà truy vấn đọc để nó trở thành index phủ, né sạch bước tra ngược. Một index (cust) giúp tìm hàng; một index (cust, payload) còn trả lời luôn truy vấn đọc payload theo cust, không chạm clustered index.
Mỗi dòng một lần tra ngược: ngưỡng bỏ index quét cả bảng
Vì mỗi dòng kết quả cần một lần tra ngược, chi phí đường index tăng tuyến tính theo số dòng khớp. Lấy 100 dòng thì 100 lần tra ngược còn rẻ; lấy 200.000 dòng thì 200.000 lần tra ngược — mỗi lần nhảy tới một chỗ ngẫu nhiên trong clustered index — có thể đắt hơn quét tuần tự cả bảng một lượt. MySQL biết điều này, và optimizer tự chọn. Đo ngưỡng bằng cách nới dần khoảng cust < T rồi xem EXPLAIN chọn gì:
cust < 100   (~1%)    key = k_cust     ← dùng index
cust < 500   (~5%)    key = k_cust     ← dùng index
cust < 1000  (~10%)   key = k_cust     ← dùng index
cust < 1500  (~15%)   key = NULL       ← BỎ index, quét cả bảng (type = ALL)
Quanh ngưỡng 10–15% số dòng, optimizer lật từ "đi index rồi tra ngược" sang "quét toàn bảng". Với một truy vấn lấy 20% số dòng, nó ước tính quét bảng rẻ hơn (cost 144.128) so với đường index phải tra ngược (cost 257.799), nên chọn quét bảng. Đây không phải lỗi mà là tính toán: vượt ngưỡng đó, gom hết bookmark lookup lại thì đọc ngẫu nhiên nhiều hơn cả việc đọc tuần tự mọi trang một lần.
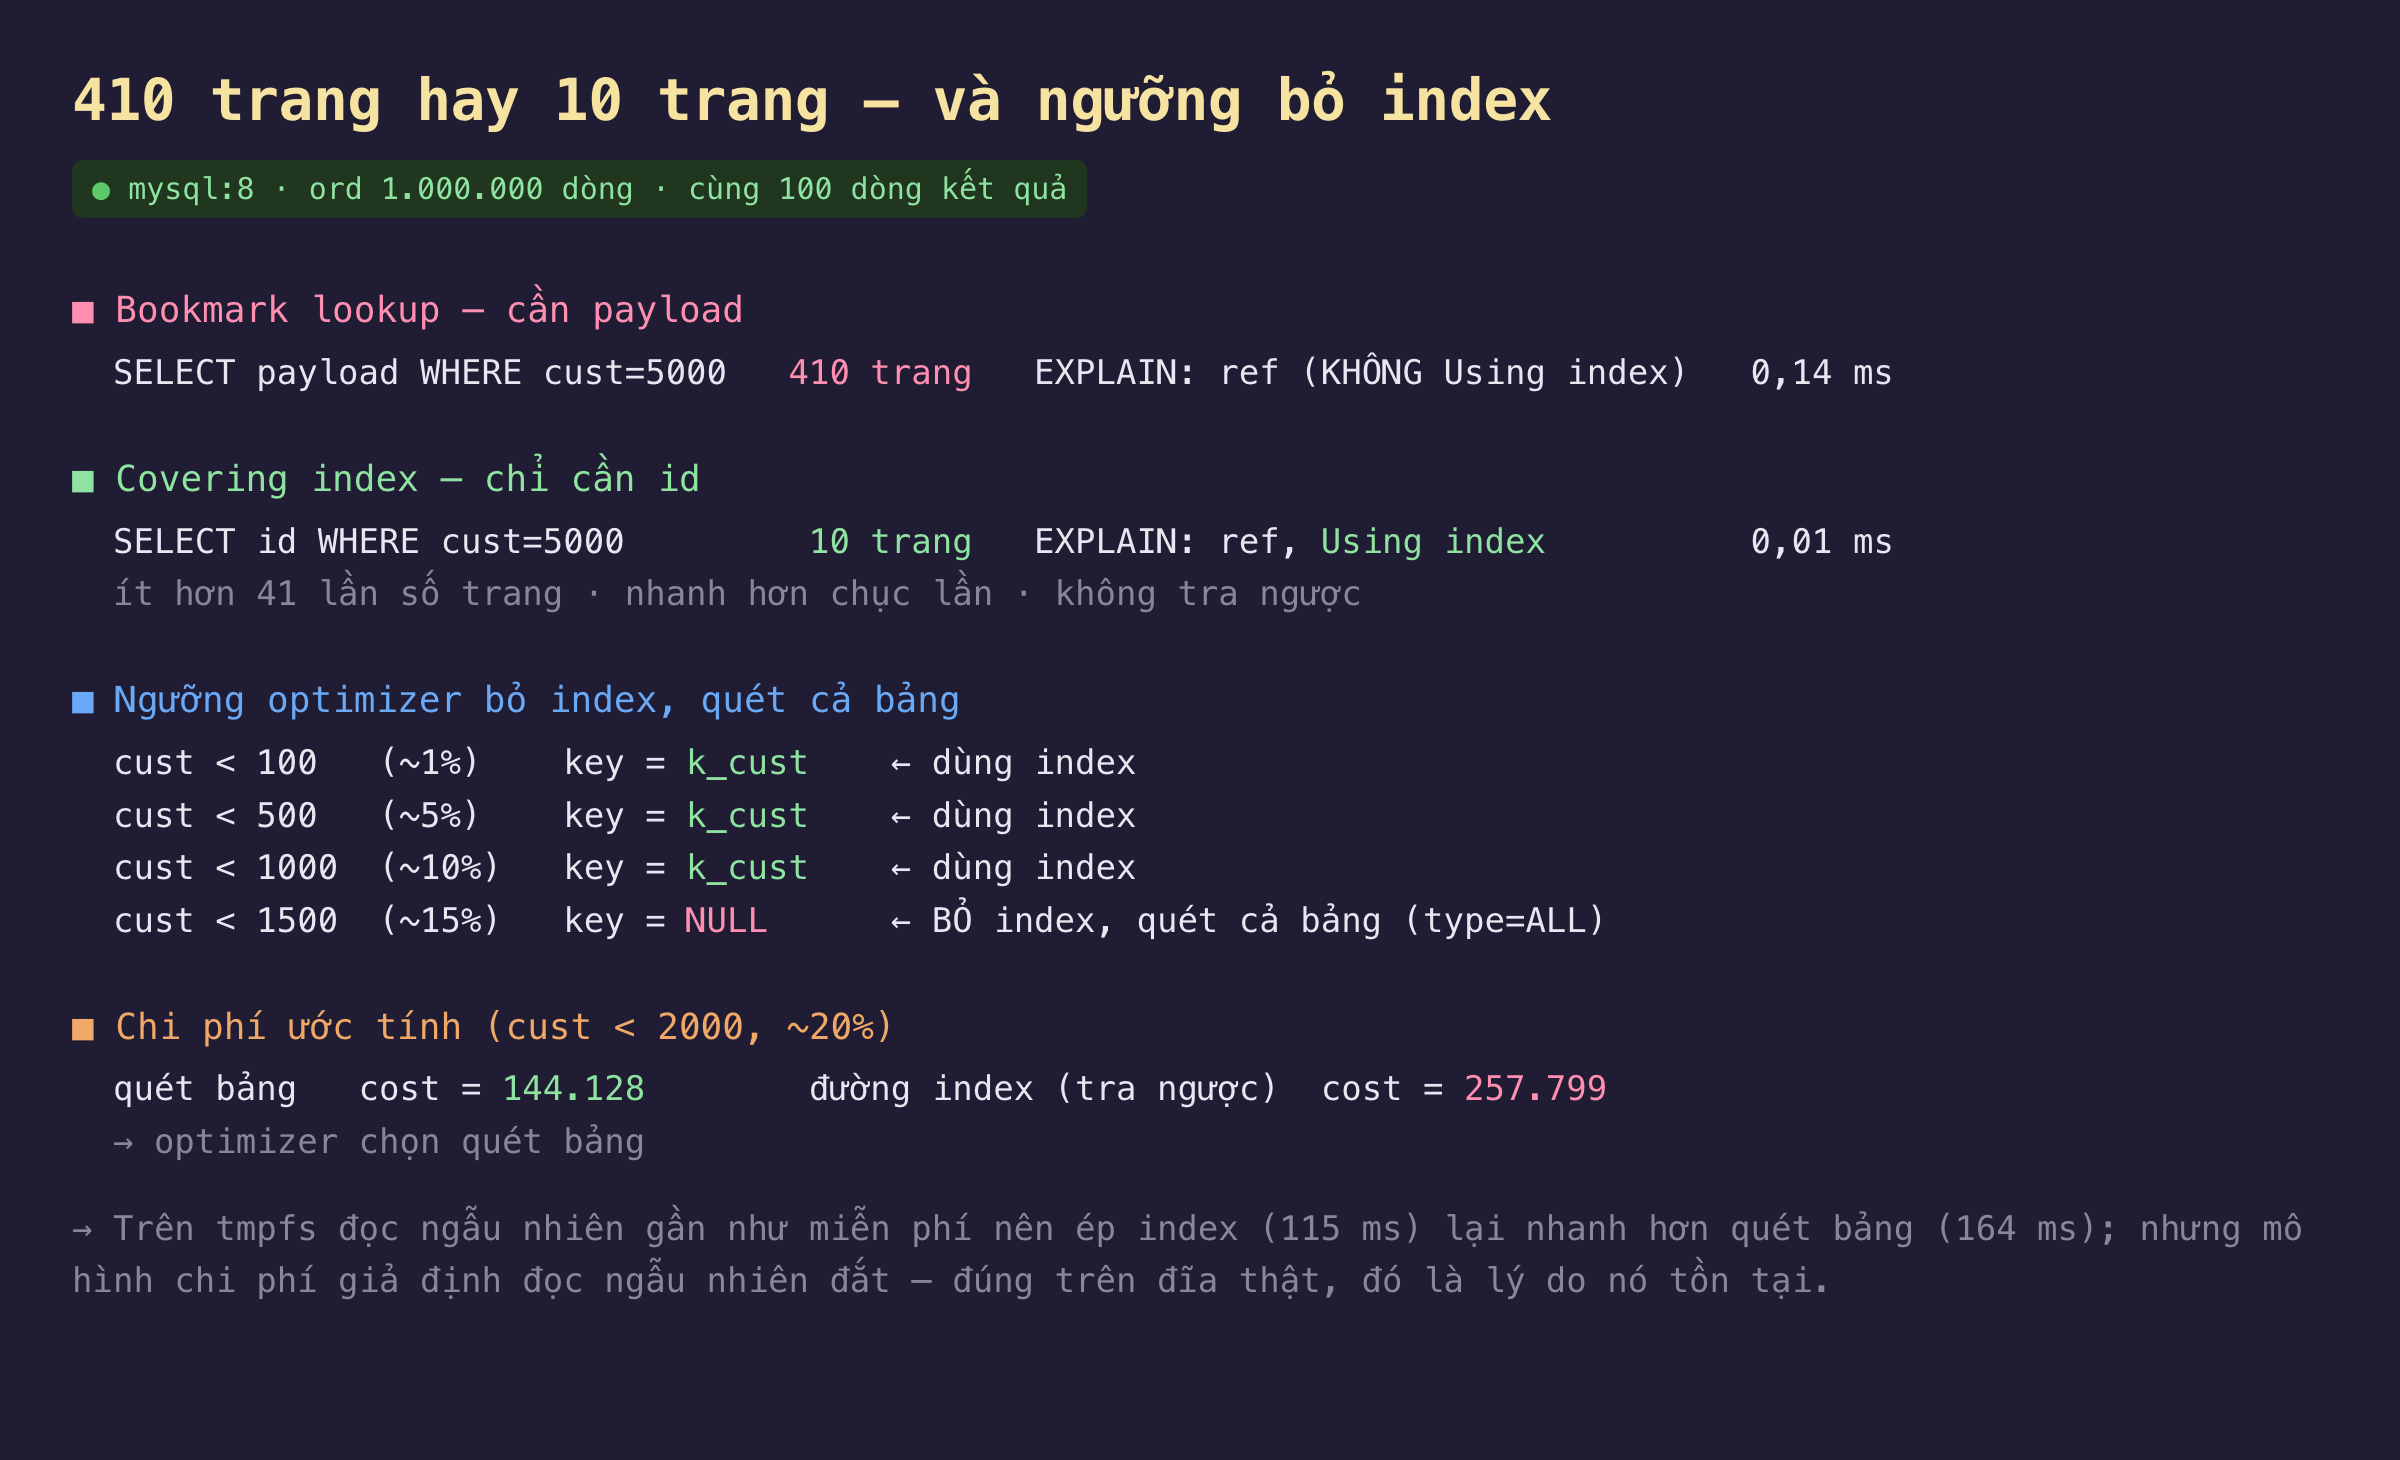
Hình 2: bookmark lookup 410 trang so với truy vấn phủ 10 trang; và ngưỡng ~10–15% nơi optimizer bỏ index để quét cả bảng.
Một lưu ý thành thật về mô hình chi phí
Cần nói rõ một điều, tiếp nối ghi chú về tmpfs ở phần buffer pool. Khi ép dùng index cho truy vấn 20% dòng bằng FORCE INDEX, thời gian thực đo được lại nhanh hơn quét bảng: 115 ms so với 164 ms. Nghe như optimizer chọn sai. Nhưng dữ liệu ở đây nằm trên tmpfs (RAM), nơi một lần đọc ngẫu nhiên gần như miễn phí; còn mô hình chi phí của MySQL được xây cho đĩa thật, nơi 200.000 lần tra ngược ngẫu nhiên là 200.000 lần nhảy đầu đọc, đắt hơn hẳn một lượt quét tuần tự. Trên SSD và nhất là đĩa quay, lựa chọn quét bảng của optimizer là đúng. Sự đảo ngược trên tmpfs chính là minh họa vì sao mô hình chi phí tồn tại: nó mã hóa giả định "đọc ngẫu nhiên đắt hơn đọc tuần tự" — giả định sai trong RAM nhưng đúng ở nơi dữ liệu thật sự sống.
Ba ý mang về
- Secondary index lưu khóa chính, không lưu địa chỉ hàng — nên lấy cột ngoài index phải tra ngược vào clustered index từng dòng. Lấy 100 dòng theo
custcó kèmpayloadchạm 410 trang: một lần quét index phụ cộng 100 lần bookmark lookup. - Truy vấn phủ (covering index) né sạch bước tra ngược. Cùng 100 dòng nhưng chỉ cần
id— vốn đã nằm trong lá index phụ — chỉ chạm 10 trang,Using index, nhanh hơn chục lần. Thêm đúng cột truy vấn đọc vào index để biến nó thành index phủ là tối ưu rẻ nhất. - Mỗi dòng một lần tra ngược, nên qua ~10–15% số dòng thì quét cả bảng rẻ hơn và optimizer tự bỏ index.
cust<1000(10%) vẫn dùng index,cust<1500(15%) chuyển full scan. Mô hình chi phí giả định đọc ngẫu nhiên đắt — đúng trên đĩa thật, dù trên tmpfs của phòng thí nghiệm thì đọc ngẫu nhiên gần như miễn phí.
Nguồn
- MySQL 8.4 Reference Manual — Clustered and Secondary Indexes (index phụ lưu khóa chính): https://dev.mysql.com/doc/refman/8.4/en/innodb-index-types.html
- MySQL 8.4 Reference Manual — Covering Indexes và
Using indextrong EXPLAIN: https://dev.mysql.com/doc/refman/8.4/en/glossary.html#glos_covering_index - MySQL 8.4 Reference Manual — The Range Access Method và lựa chọn index của optimizer: https://dev.mysql.com/doc/refman/8.4/en/range-optimization.html
- MySQL 8.4 Reference Manual — EXPLAIN Output Format: https://dev.mysql.com/doc/refman/8.4/en/explain-output.html
Phần sau đọc kỹ EXPLAIN và EXPLAIN ANALYZE: phân biệt số dòng ước tính và số dòng thật, hiểu type, rows, filtered, và vì sao con số rows examined mới là thứ quyết định một truy vấn nhanh hay chậm — chứ không phải số dòng trả về.
