Phần một cho thấy bảng InnoDB là một cây B+ khóa theo khóa chính; phần hai cho thấy các trang của cây đó sống trong buffer pool. Giờ tới câu hỏi làm nên sức mạnh của index: vì sao tra một khóa trên bảng mười triệu dòng lại nhanh gần như tra trên bảng một nghìn dòng? Câu trả lời nằm ở hình dạng cây B+ — nó rộng chứ không cao. Bài này đo thật chiều cao cây khi bảng lớn dần, bằng chính số trang mà một lần tra khóa phải đọc, và cho thấy chiều cao tăng chậm đến mức gần như là hằng số trong mọi quy mô thực tế.
Cây B+ rộng vì mỗi nút là một trang 16 KB
Cây B+ của InnoDB không giống cây nhị phân trong sách giáo khoa, nơi mỗi nút có hai con. Ở đây mỗi nút là một trang 16 KB, và một trang chứa được rất nhiều mục. Nút lá chứa các hàng (với clustered index là trọn hàng); nút trong chứa các cặp "khóa định tuyến + con trỏ tới trang con". Vì khóa định tuyến và con trỏ nhỏ (khóa chính kiểu BIGINT là 8 byte, con trỏ 6 byte), một nút trong 16 KB nhét được cả nghìn cặp như vậy. Con số đó gọi là fanout — số con của mỗi nút.
Fanout lớn khiến cây rất thấp. Nếu mỗi nút trong có fanout khoảng 1.000 và mỗi lá chứa khoảng 110 hàng (hàng rộng 130 byte), thì một cây cao 2 tầng (một nút trong trỏ tới các lá) chứa được tới 1.000 × 110 ≈ 110 nghìn hàng, còn cao 3 tầng chứa được 1.000 × 1.000 × 110 ≈ 110 triệu hàng. Mỗi khi thêm một tầng, sức chứa nhân lên cả nghìn lần. Đó là lý do chiều cao tăng theo logarit của số hàng, với cơ số là fanout — và logarit cơ số nghìn tăng cực chậm.
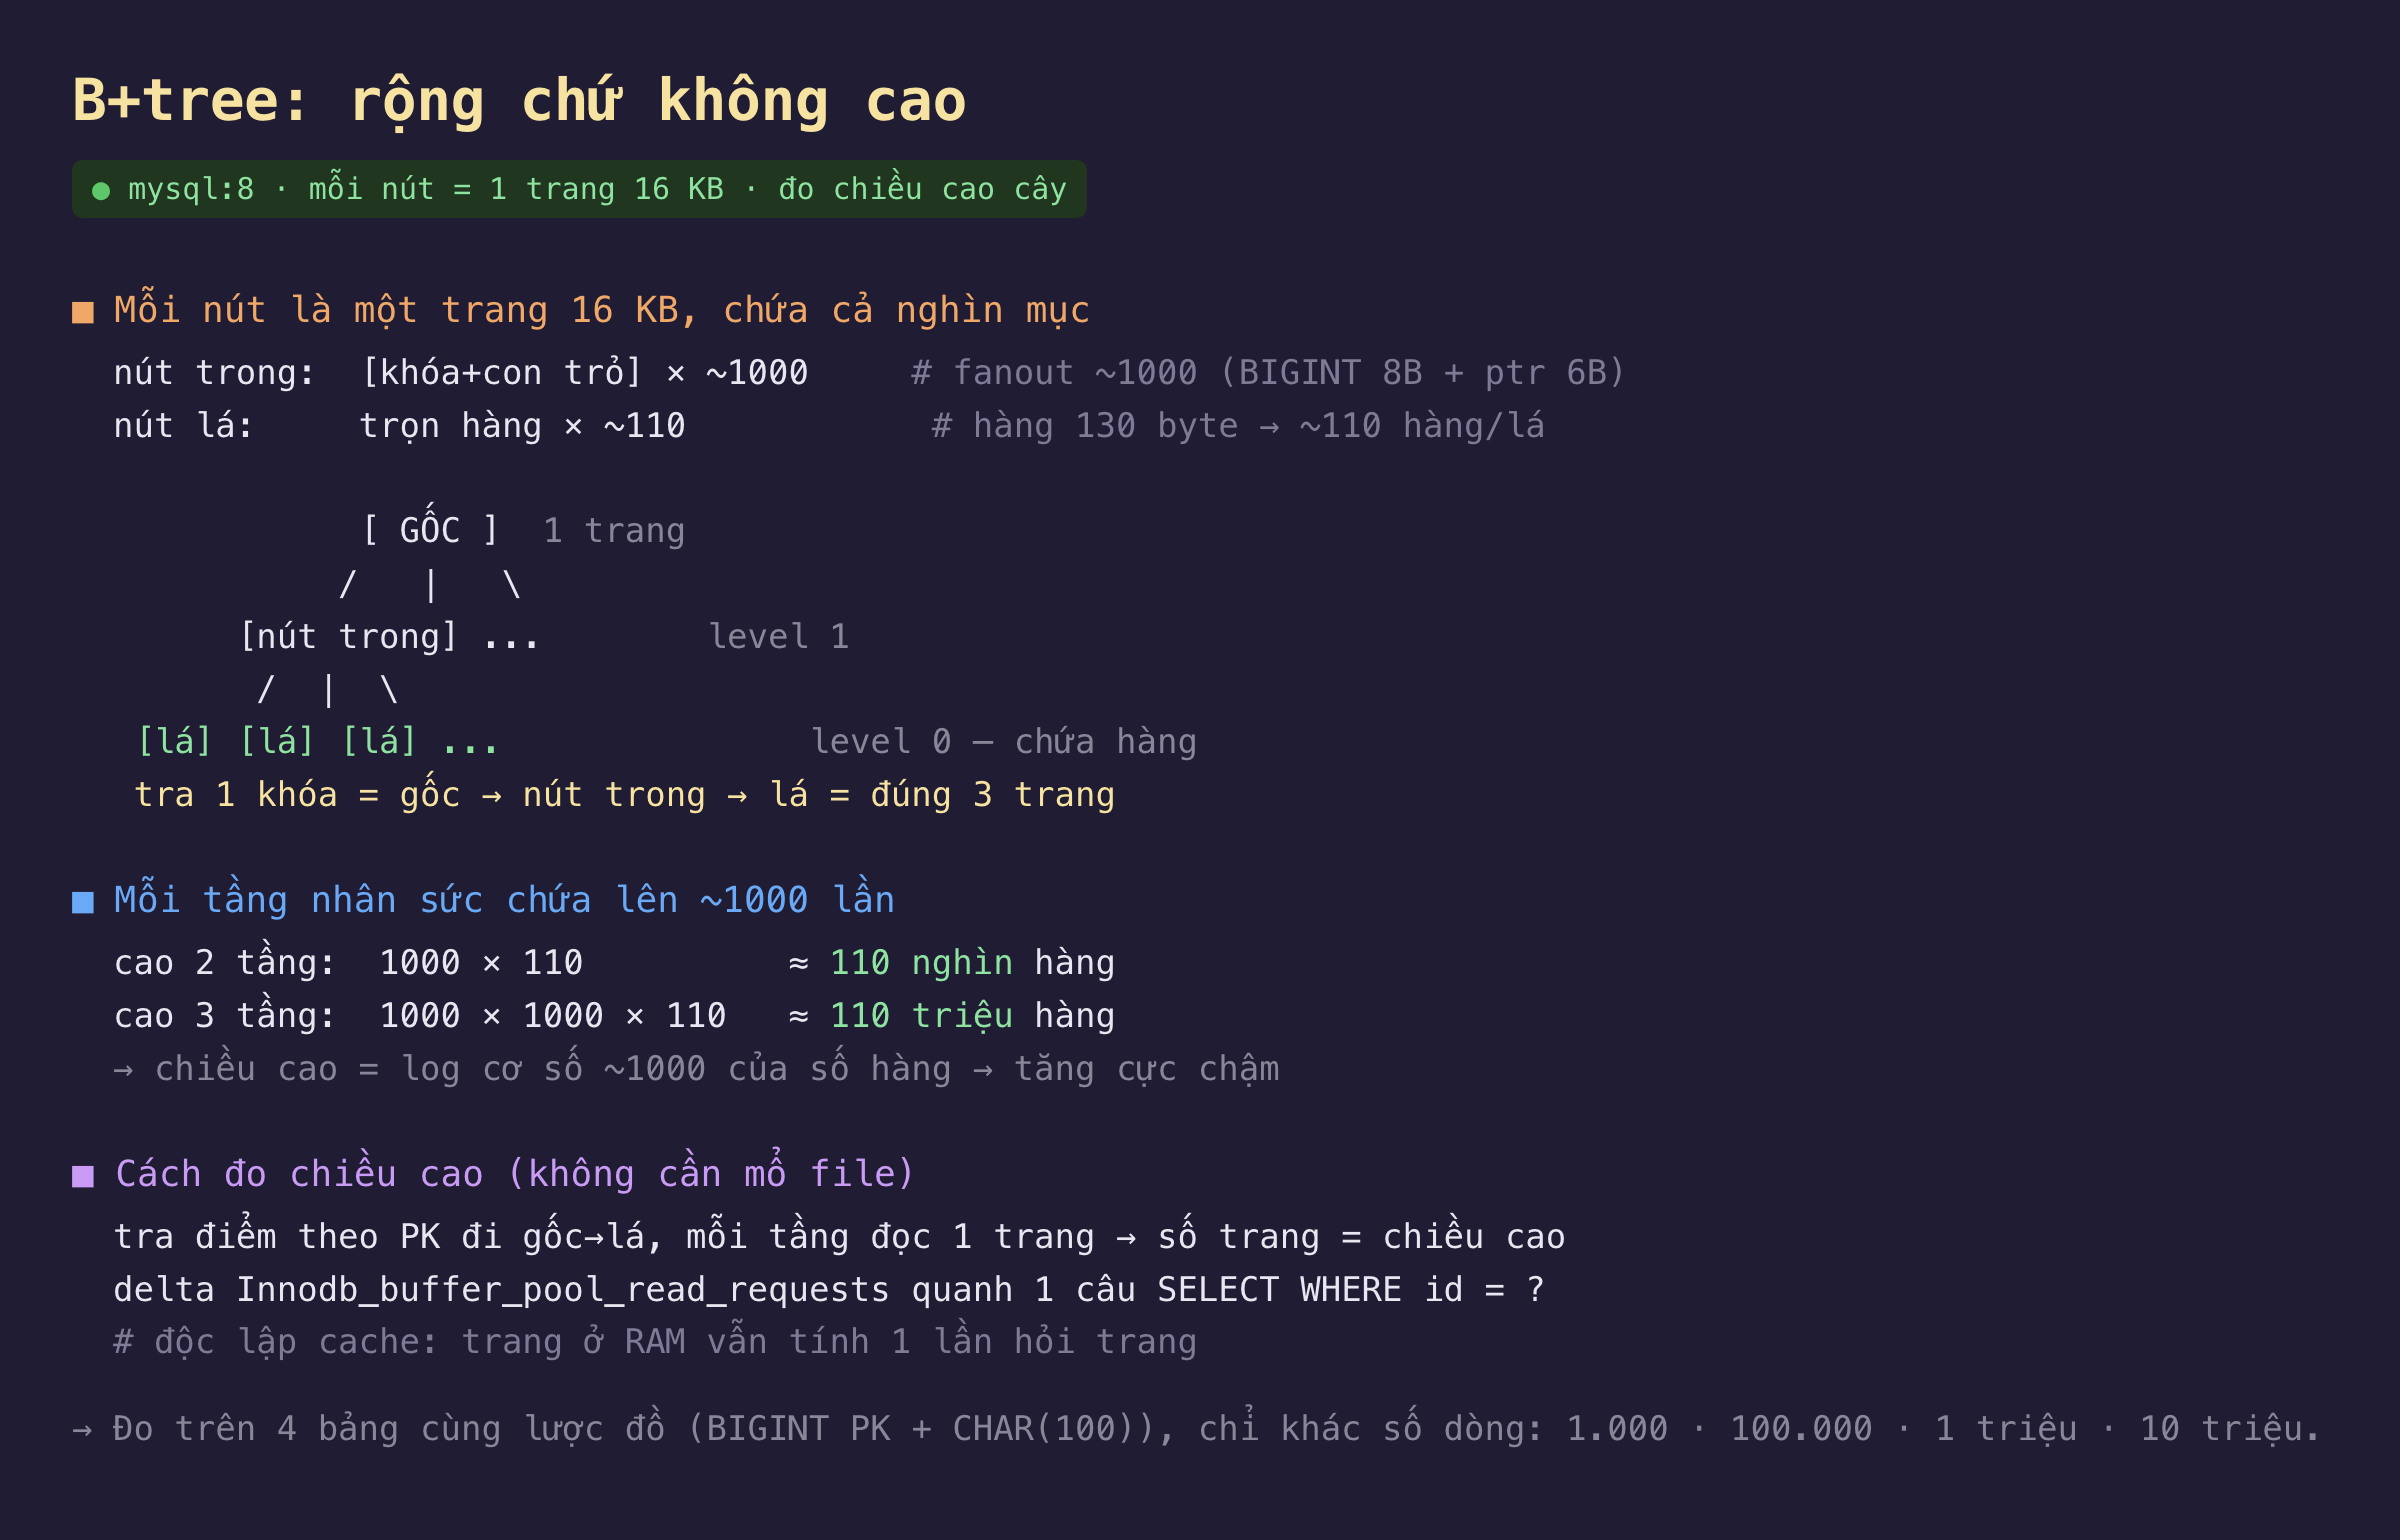
Hình 1: cây B+ rộng vì mỗi nút là một trang 16 KB chứa cả nghìn khóa; mỗi tầng thêm nhân sức chứa lên cả nghìn lần, nên chiều cao tăng theo logarit.
Đo chiều cao bằng số trang một lần tra khóa phải đọc
Không cần công cụ mổ file: chiều cao cây lộ ra ngay trong một lần tra khóa. Tra điểm theo khóa chính đi từ gốc xuống lá, mỗi tầng đọc đúng một trang, nên số trang đọc bằng chiều cao. Đếm số trang bằng cách chụp Innodb_buffer_pool_read_requests (số lần hỏi trang, kể cả khi trang đã ở RAM) trước và sau một câu SELECT ... WHERE id = <giá trị>:
-- làm ấm đường đi trước, rồi đo lần cuối
SELECT @a := VARIABLE_VALUE FROM performance_schema.global_status
  WHERE VARIABLE_NAME='Innodb_buffer_pool_read_requests';
SELECT payload FROM seq_pk WHERE id = 500000;
-- delta read_requests = số trang đã đi qua = chiều cao cây
Phép đo này độc lập với cache: dù trang đã nằm trong buffer pool, mỗi lần đi qua vẫn tính một lần hỏi trang. Chạy trên bốn bảng cùng lược đồ (khóa chính BIGINT, cột CHAR(100)), chỉ khác số dòng, cho kết quả rất gọn.
Gấp 10.000 lần số dòng, thêm đúng một tầng
bảng        số dòng       chiều cao cây (số trang mỗi lần tra)
t3            1.000              2
t5          100.000              2
seq_pk    1.000.000              3
t7       10.000.000              3
Từ một nghìn dòng tới mười triệu dòng — gấp mười nghìn lần dữ liệu — chiều cao cây chỉ đi từ 2 lên 3. Một nghìn và một trăm nghìn dòng dùng chung chiều cao 2; một triệu và mười triệu dòng dùng chung chiều cao 3. Con số khớp đúng mô hình sức chứa: cây cao 2 tầng đủ cho tới ~110 nghìn dòng (nên 100 nghìn vẫn vừa, một triệu thì không), cây cao 3 tầng đủ cho tới ~110 triệu dòng (nên mười triệu vẫn vừa). Muốn chạm chiều cao 4, bảng phải vượt cả trăm triệu dòng với lược đồ này.
Hệ quả thực tế: tra điểm theo khóa chính trên bảng mười triệu dòng đọc đúng 3 trang, và trên bảng một nghìn dòng đọc 2 trang — chênh nhau một trang. EXPLAIN ANALYZE một câu tra khóa trên bảng mười triệu dòng cho thời gian dưới một mili-giây, Handler_read_key = 1 như bảng nhỏ. Kích thước bảng gần như không ảnh hưởng tới chi phí một lần tra khóa, và đó chính là điều khiến index B+tree trở thành nền tảng của mọi CSDL quan hệ.
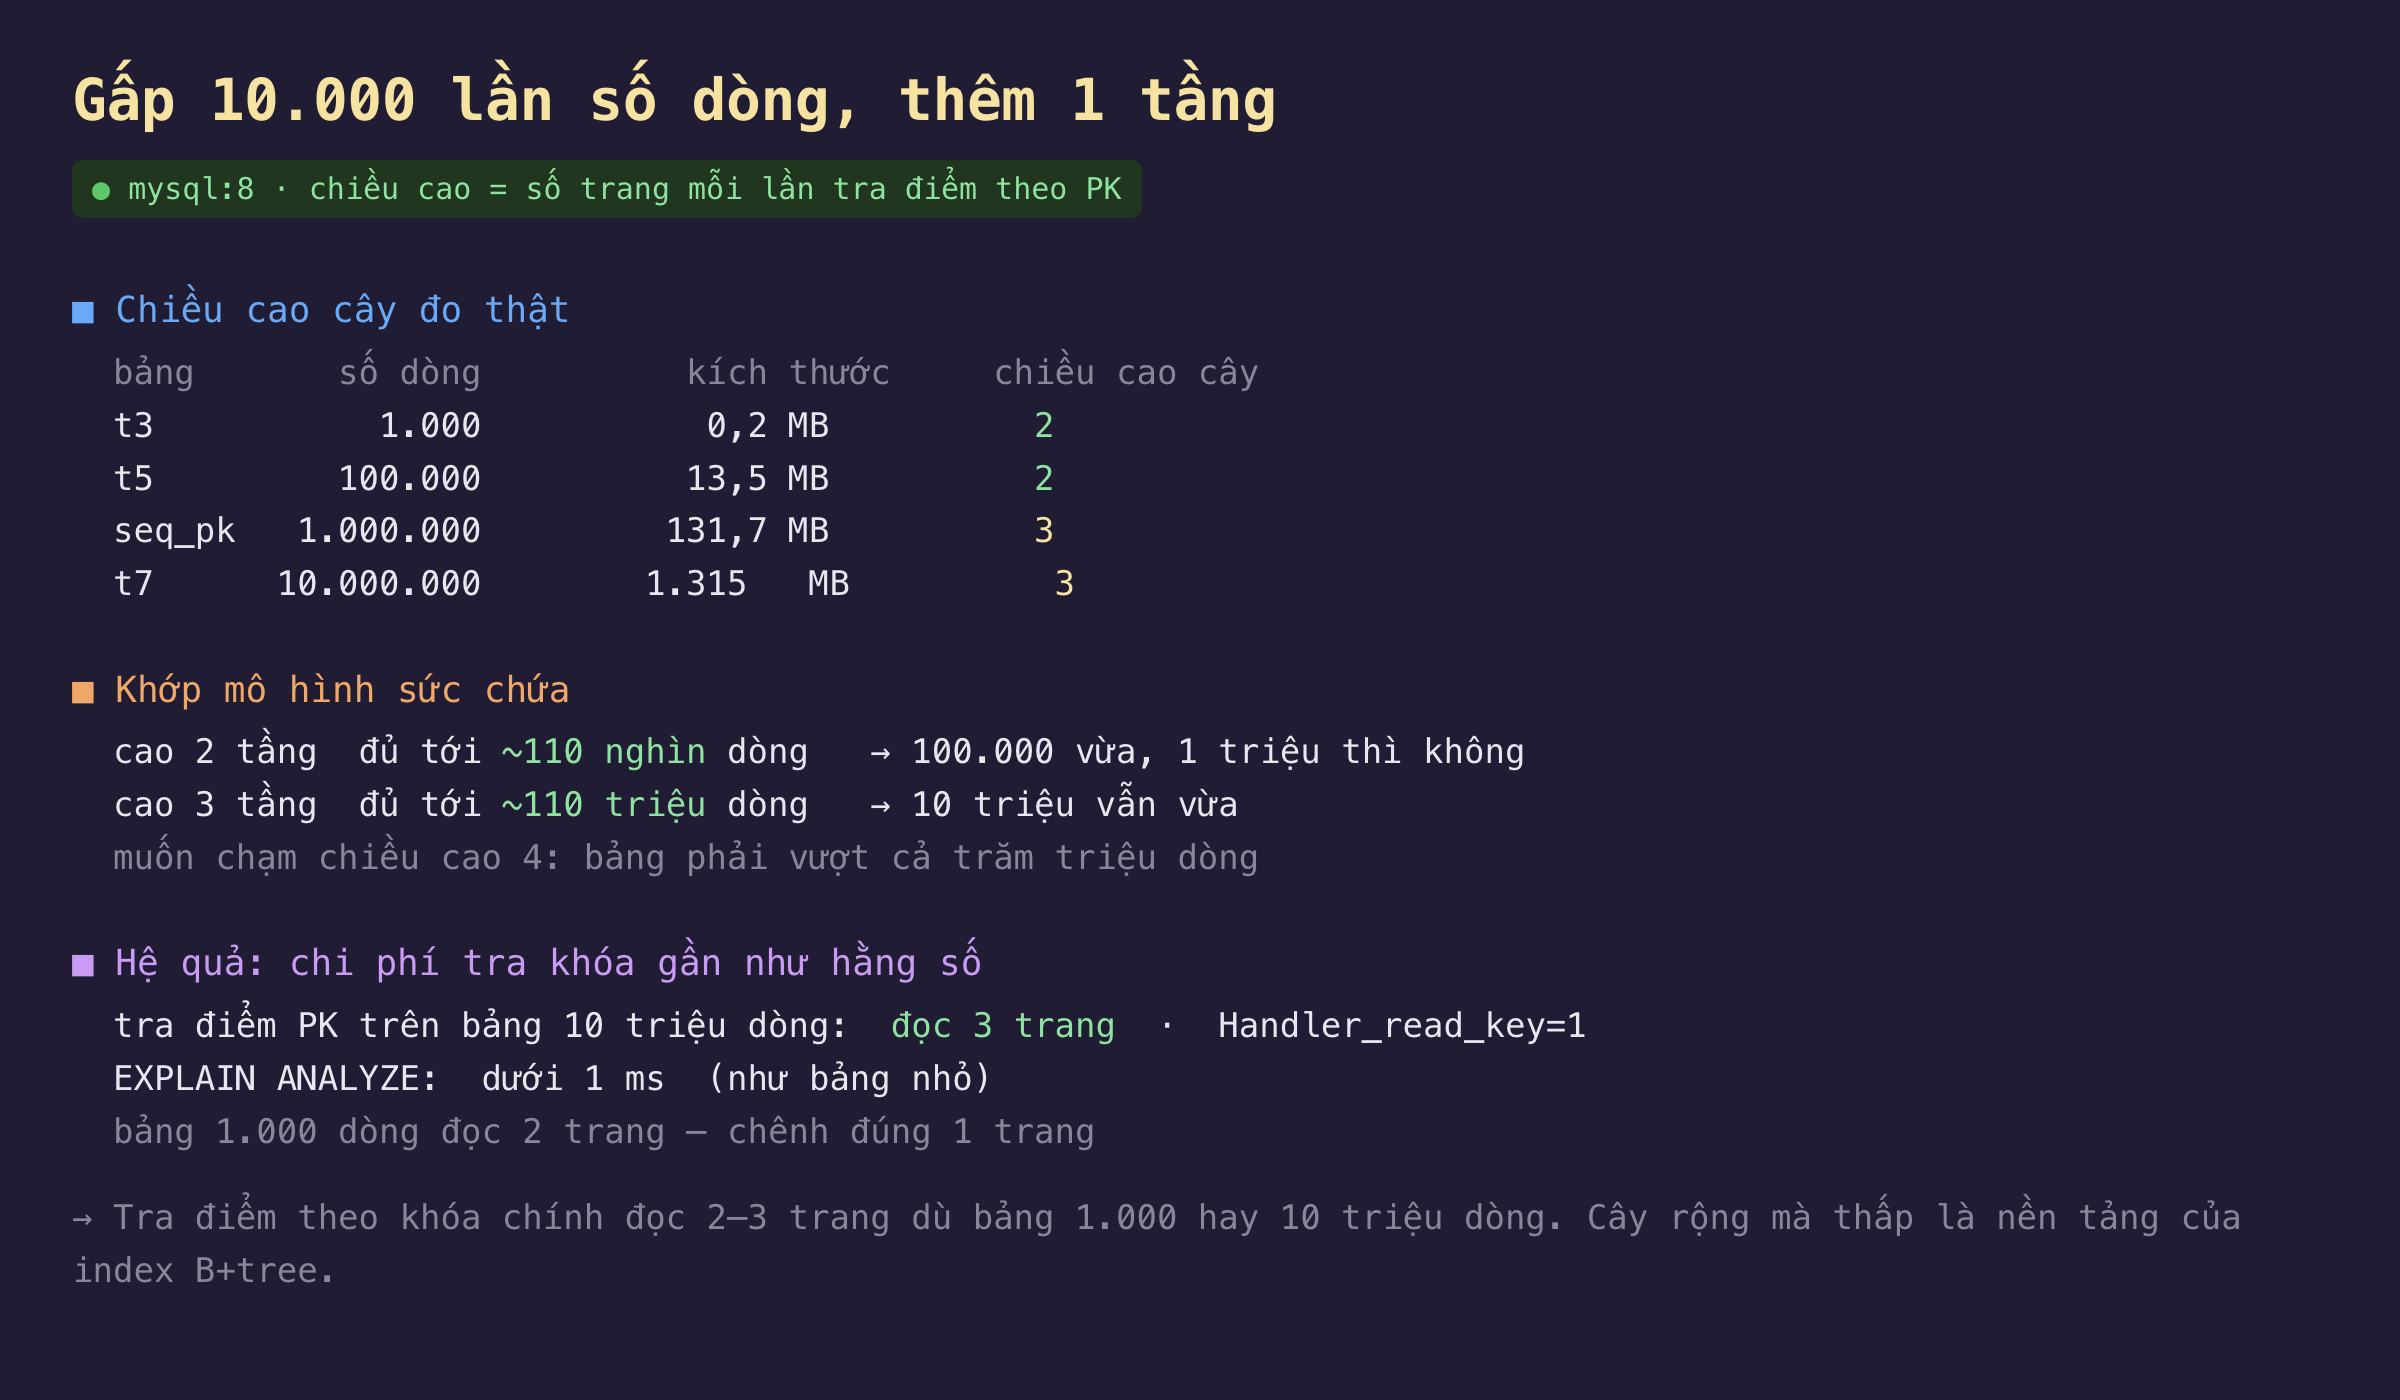
Hình 2: chiều cao cây đo thật trên bốn quy mô — 2, 2, 3, 3 — gấp mười nghìn lần số dòng chỉ thêm một tầng; tra khóa đọc 2–3 trang bất kể bảng to cỡ nào.
Vì sao điều này định hình cách thiết kế index
Cây rộng mà thấp giải thích vài khuyến nghị quen thuộc theo cách định lượng. Khóa chính nên ngắn vì khóa càng nhỏ, một nút trong càng nhét được nhiều cặp định tuyến, fanout càng lớn, cây càng thấp — khóa chính BIGINT 8 byte cho fanout cả nghìn, còn khóa chuỗi dài vài chục byte cắt fanout xuống nhiều lần và có thể đội thêm một tầng. Ngược lại, không cần sợ bảng to: thêm một tầng cây mua thêm cả nghìn lần sức chứa, nên ngay cả bảng trăm triệu dòng cũng chỉ tra bốn trang mỗi lần. Chi phí thật của một truy vấn hiếm khi nằm ở chiều cao cây; nó nằm ở việc truy vấn có dùng được index hay không, có phải tra ngược về clustered index hay không — đúng những chủ đề các phần sau mổ xẻ.
Ba ý mang về
- Cây B+ rộng chứ không cao: mỗi nút là một trang 16 KB chứa cả nghìn khóa định tuyến. Fanout lớn khiến chiều cao tăng theo logarit cơ số nghìn của số dòng — tăng cực chậm. Cây cao 2 tầng chứa tới ~110 nghìn dòng, cao 3 tầng chứa tới ~110 triệu dòng.
- Đo thật: gấp 10.000 lần số dòng chỉ thêm một tầng. Tra điểm theo khóa chính đọc số trang đúng bằng chiều cao; bảng 1.000 dòng cao 2, 100.000 dòng cao 2, 1 triệu dòng cao 3, 10 triệu dòng vẫn cao 3. Phép đo dùng delta
Innodb_buffer_pool_read_requests, độc lập với cache. - Tra điểm theo khóa chính đọc 2–3 trang bất kể bảng to cỡ nào, nên chi phí gần như hằng số. Đó là lý do khóa chính nên ngắn (fanout lớn, cây thấp) và là lý do không cần sợ bảng nhiều dòng — chi phí thật nằm ở việc có dùng được index hay không, không ở chiều cao cây.
Nguồn
- MySQL 8.4 Reference Manual — InnoDB Index and Table Structures (trang, nút, mục): https://dev.mysql.com/doc/refman/8.4/en/innodb-physical-structure.html
- MySQL 8.4 Reference Manual — The Physical Structure of an InnoDB Index (B-tree, fanout): https://dev.mysql.com/doc/refman/8.4/en/innodb-physical-structure.html
- MySQL 8.4 Reference Manual — biến trạng thái
Innodb_buffer_pool_read_requests: https://dev.mysql.com/doc/refman/8.4/en/server-status-variables.html - Goetz Graefe — Modern B-Tree Techniques, tổng quan học thuật về B+tree trong CSDL: https://www.nowpublishers.com/article/Details/DBS-028
Phần sau đo cái giá của secondary index: vì nó lưu giá trị khóa chính chứ không lưu địa chỉ hàng, tra theo secondary index phải đi hai cây — một lần trên index phụ rồi một lần nữa trên clustered index để lấy hàng. Đo số trang và thời gian của bước "tra ngược về khóa chính", và khi nào nó đắt tới mức quét bảng còn nhanh hơn.
