Tám phần trước dùng hit ratio làm thước đo chính: 37,6% leo lên 95% ở phần 2, 80,2% so với 100% ở phần 8. Giờ là lúc soi lại chính cái thước đó, vì nó có hai cách hiểu sai phổ biến đến mức gần như mặc định — và cả hai đều làm bạn mù đúng lúc cần nhìn nhất.
Hai cách tính, hai kết luận
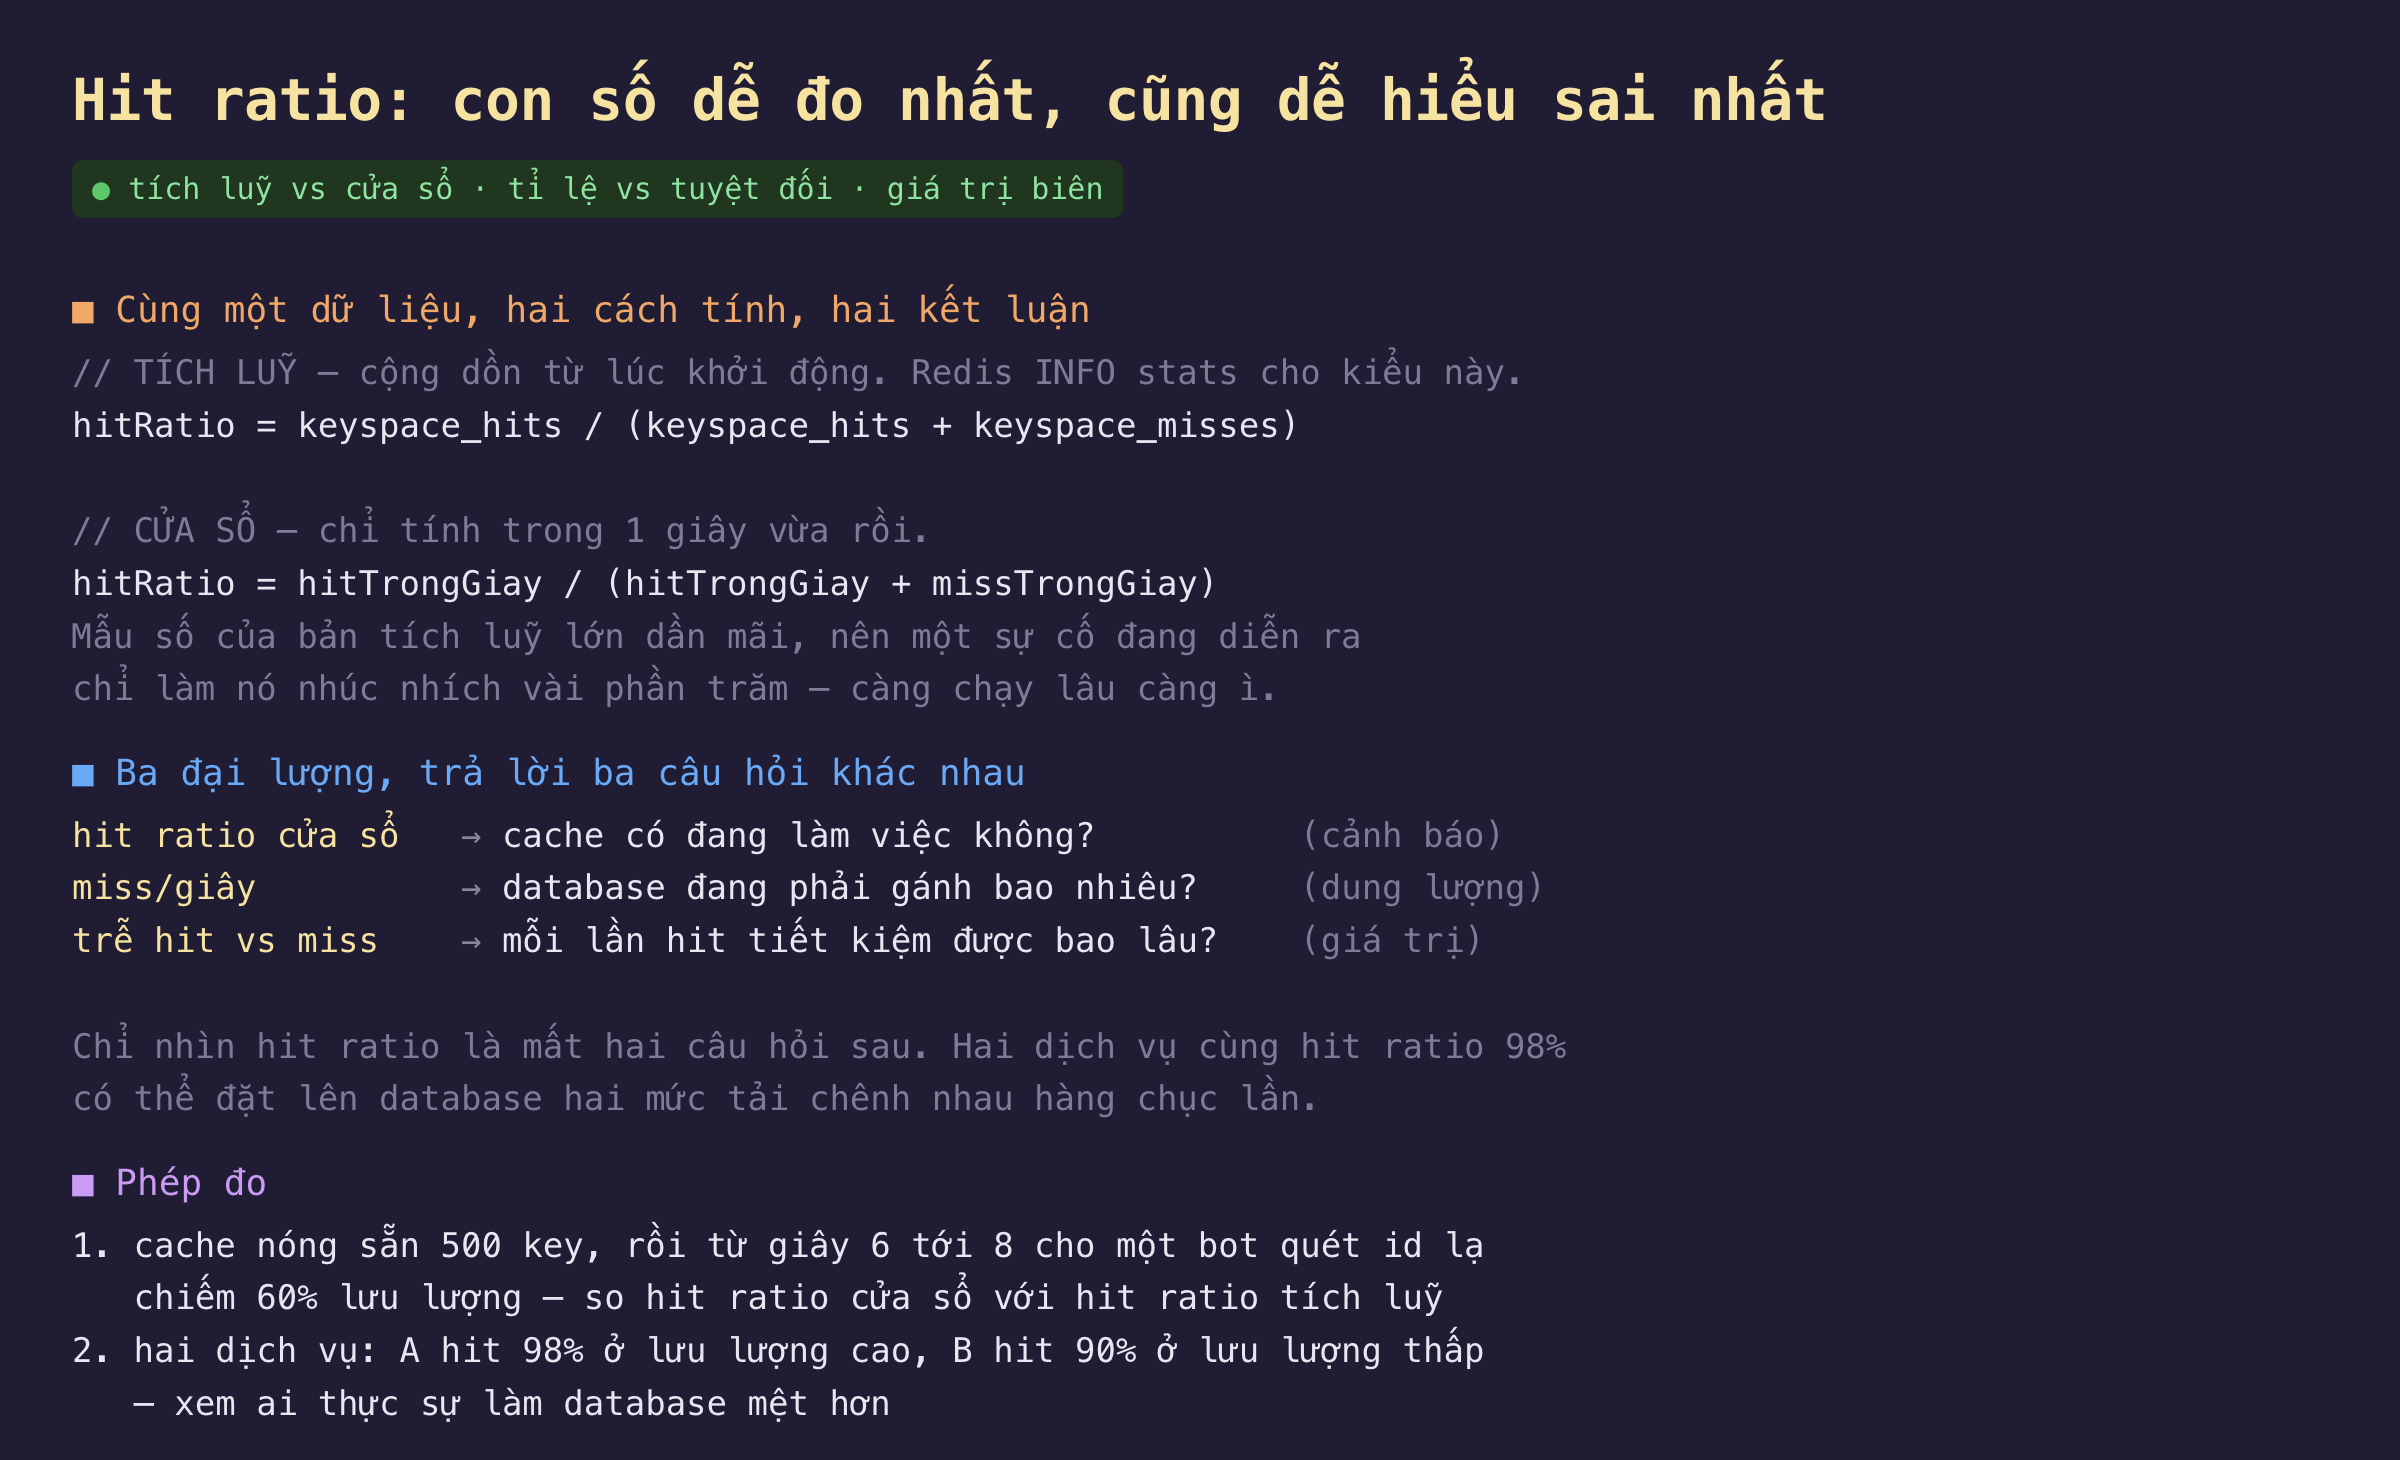
Hình 1: Hai công thức khác nhau đúng ở mẫu số. Bản tích luỹ — chính là thứ INFO stats của Redis cho bạn — có mẫu số lớn dần mãi theo thời gian chạy.
Công thức quen thuộc nhất là lấy thẳng từ INFO stats:
hitRatio = keyspace_hits / (keyspace_hits + keyspace_misses)
Hai bộ đếm này cộng dồn từ lúc Redis khởi động. Sau một tuần chạy, mẫu số có thể là hàng tỉ — và một sự cố kéo dài vài phút chỉ làm nó nhúc nhích ở chữ số thập phân thứ hai. Con số đó trả lời câu hỏi "cache đã làm việc tốt tới đâu tính từ đầu", không phải "cache có đang làm việc lúc này không". Hai câu hỏi khác nhau, và chỉ có câu thứ hai dùng để cảnh báo được.
Đo thật: cửa sổ 44,82% trong khi tích luỹ vẫn 95,78%
Mình làm nóng 500 key, rồi từ giây thứ 6 tới giây thứ 8 cho một "bot" chiếm 60% lưu lượng và quét các id lạ — tình huống rất thật: một con crawler, một client có bug, hoặc ai đó dò id tuần tự.
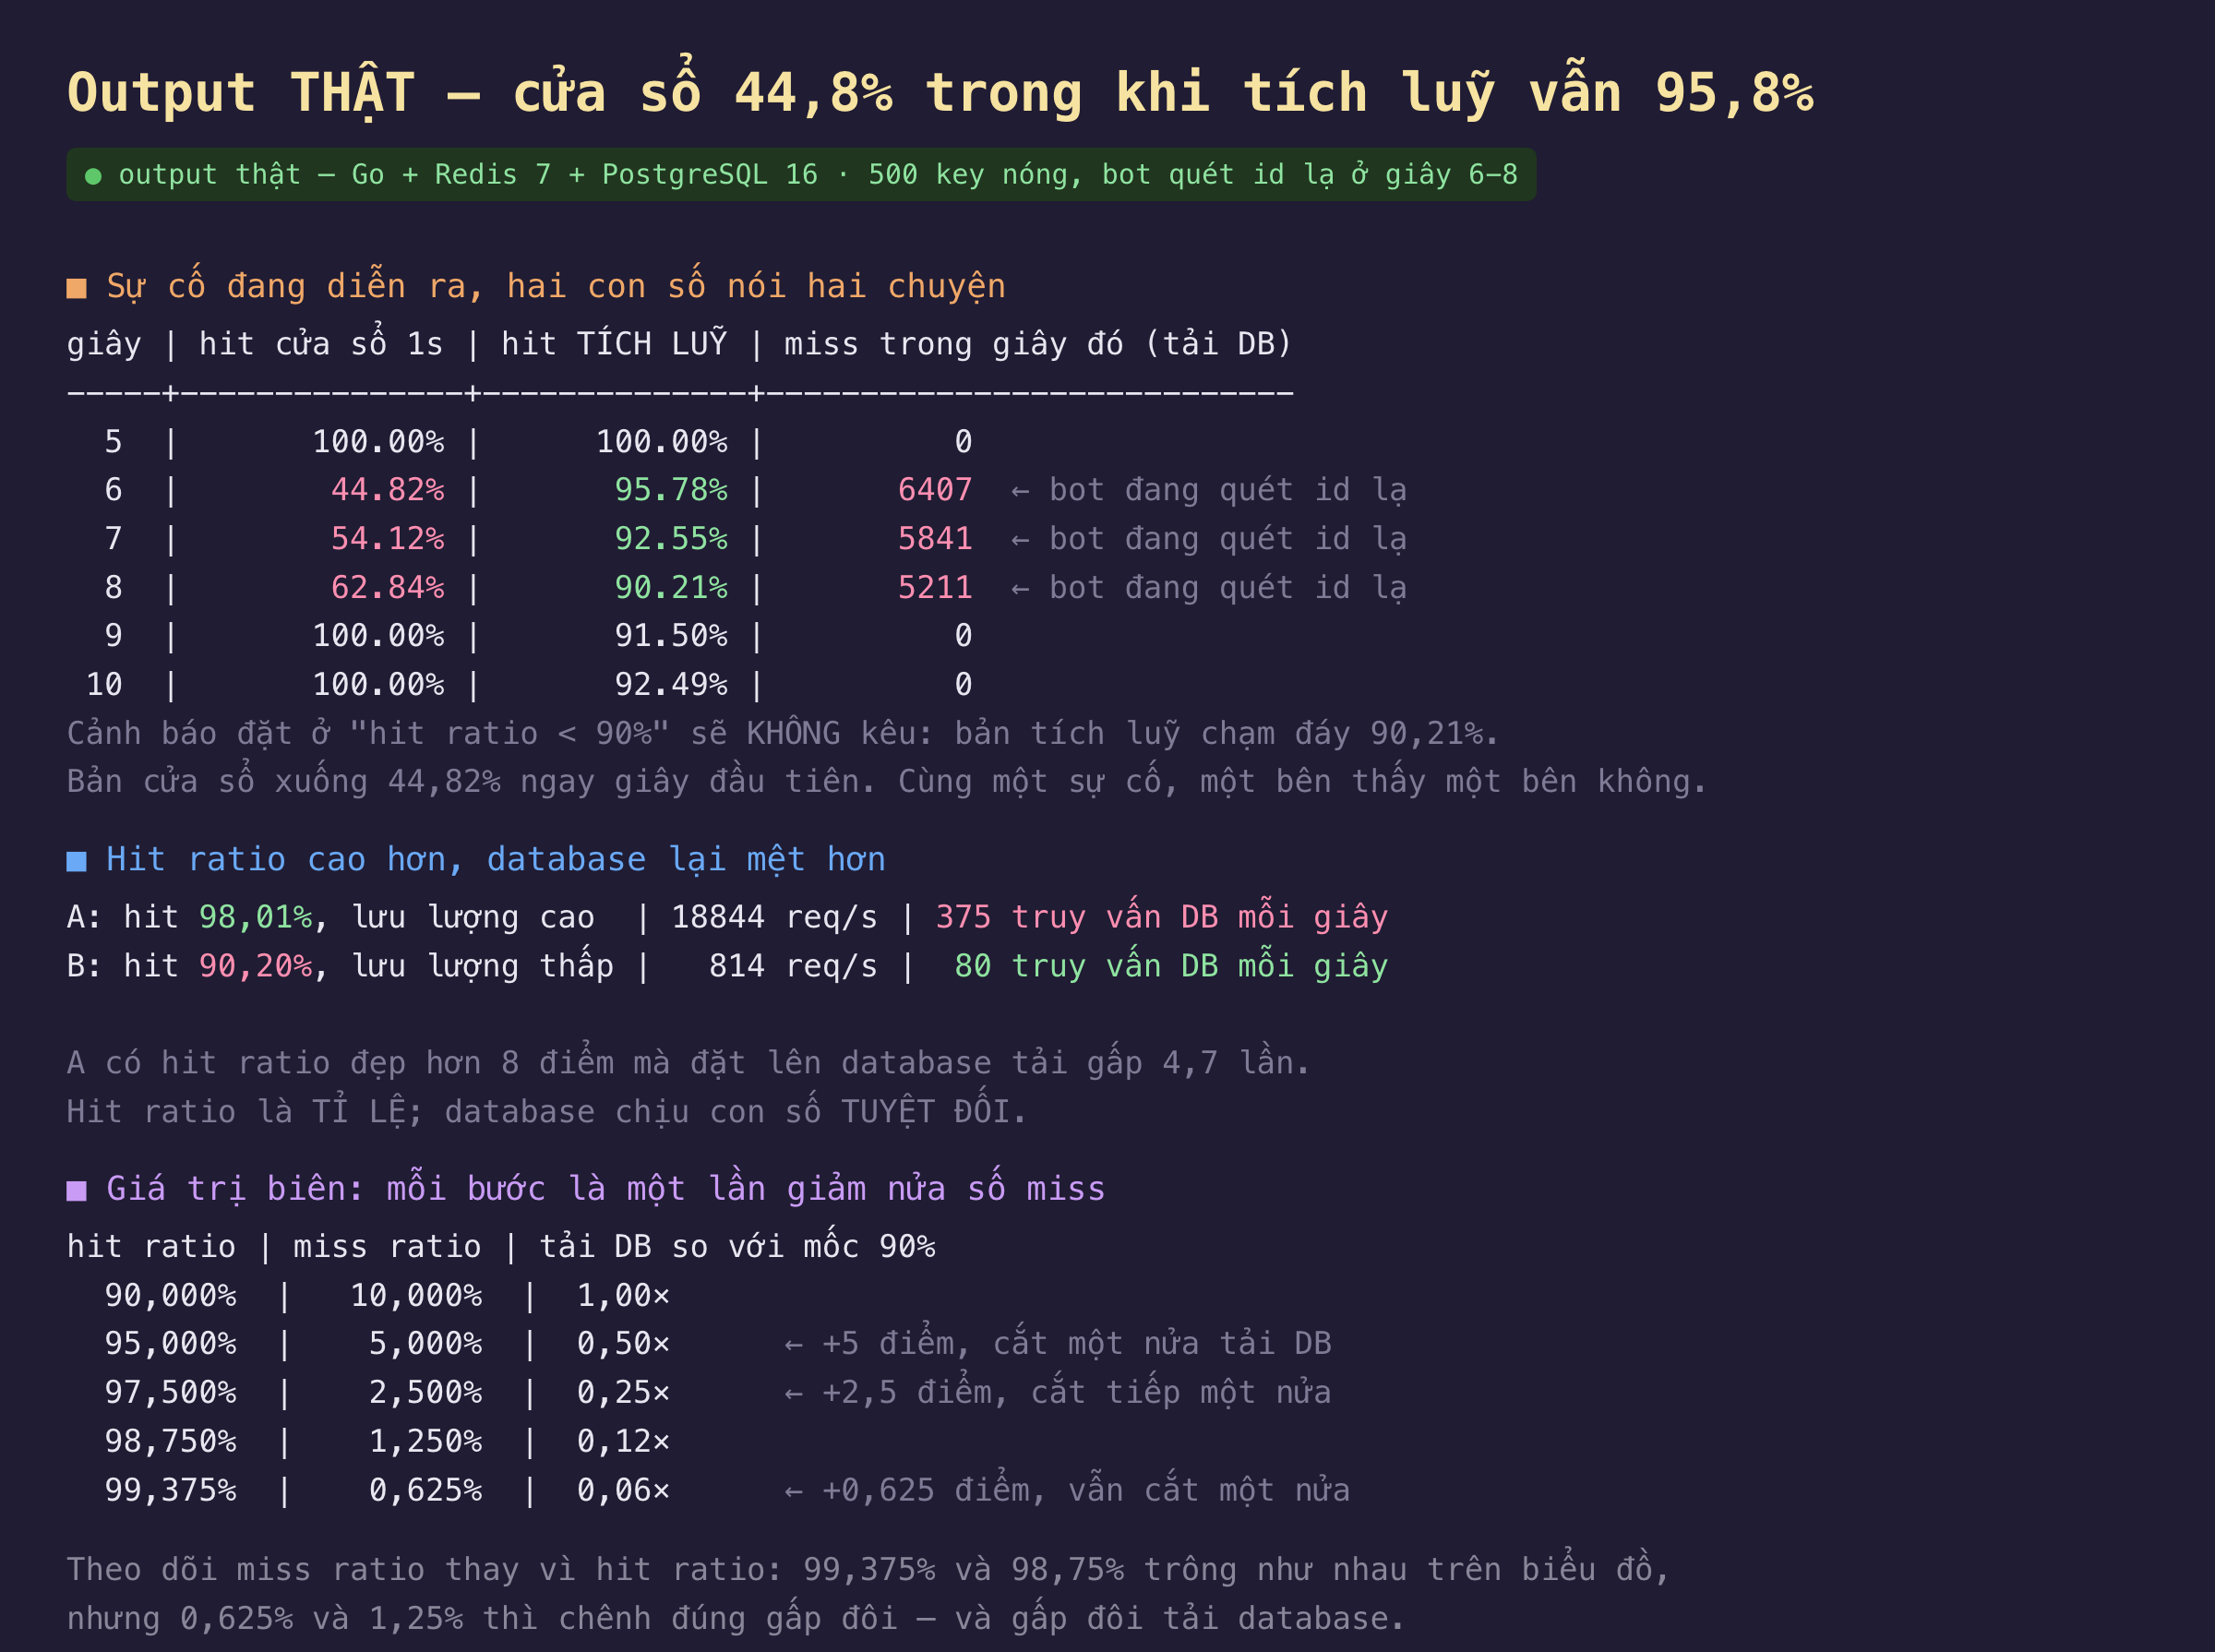
Hình 2: Kết quả thật. Ba bảng cho ba hiểu lầm khác nhau về hit ratio.
Hit ratio cửa sổ rơi xuống 44,82% ngay giây đầu tiên của sự cố. Hit ratio tích luỹ, cùng lúc đó, vẫn là 95,78%.
Hệ quả rất cụ thể cho việc giám sát: một cảnh báo đặt ở ngưỡng quen thuộc "hit ratio < 90% thì kêu" sẽ không kêu, vì bản tích luỹ chạm đáy ở 90,21% rồi bò lên lại. Trong khi đó database đang nhận hơn 6.000 truy vấn mỗi giây mà trước đó nhận 0. Cùng một sự cố: một thước đo thấy rõ, một thước đo gần như không thấy gì.
Và chú ý bản tích luỹ không hồi phục sau khi sự cố qua: giây 9 và 10 có hit ratio cửa sổ 100% nhưng tích luỹ chỉ bò từ 91,50% lên 92,49%. Nó mang theo quá khứ mãi mãi. Một sự cố tuần trước vẫn đang kéo con số của hôm nay xuống, và bạn không có cách nào phân biệt "đang hỏng" với "từng hỏng".
Hiểu lầm thứ hai: hit ratio cao hơn không có nghĩa database nhẹ hơn
Bảng thứ hai so hai dịch vụ:
| hit ratio | lưu lượng | truy vấn DB mỗi giây | |
|---|---|---|---|
| A | 98,01% | 18.844 req/s | 375 |
| B | 90,20% | 814 req/s | 80 |
A có hit ratio đẹp hơn 8 điểm nhưng đặt lên database tải gấp 4,7 lần. Không có gì nghịch lý ở đây, chỉ là số học: tải database = lưu lượng × miss ratio. A có miss ratio nhỏ hơn 5 lần nhưng lưu lượng lớn hơn 23 lần.
Hệ quả thực dụng: hit ratio không phải thước đo dung lượng. Nếu bạn đang hỏi "database có gánh nổi không?", con số cần nhìn là miss trên giây — một đại lượng tuyệt đối. Hit ratio chỉ trả lời "cache có hiệu quả không", một câu hỏi về chất lượng cấu hình. Dashboard cache nên có cả hai, và cảnh báo về dung lượng phải gắn vào con số tuyệt đối.
Hiểu lầm thứ ba: mỗi điểm hit ratio không đáng giá như nhau
Bảng thứ ba là số học thuần, không phải đo đạc, nhưng nó sửa một trực giác sai rất dai dẳng:
| hit ratio | miss ratio | tải DB so với mốc 90% |
|---|---|---|
| 90% | 10% | 1,00× |
| 95% | 5% | 0,50× |
| 97,5% | 2,5% | 0,25× |
| 98,75% | 1,25% | 0,12× |
| 99,375% | 0,625% | 0,06× |
Mỗi bước trong bảng cắt một nửa tải database, nhưng số điểm hit ratio tăng thêm nhỏ dần: 5 điểm, rồi 2,5, rồi 1,25, rồi 0,625. Nói cách khác: đi từ 98,75% lên 99,375% có giá trị đúng bằng đi từ 90% lên 95% — cả hai đều cắt một nửa số lần chạm database — dù trên biểu đồ, cái sau trông như một bước nhảy còn cái trước trông như đường thẳng.
Đây là lý do nên vẽ miss ratio, không vẽ hit ratio. 99,375% và 98,75% nhìn như nhau trên trục 0–100%; 0,625% và 1,25% thì rõ ràng chênh gấp đôi. Trục log cho miss ratio còn tốt hơn nữa.
Đánh đổi cần cân nhắc
Hit ratio cao không tự nó là mục tiêu. Rất dễ kéo hit ratio lên bằng cách tăng TTL — nhưng như phần 3 đã đo, cái giá là dữ liệu cũ hơn, và cái giá đó không xuất hiện trên biểu đồ hit ratio. Một hệ thống hit ratio 99,9% phục vụ dữ liệu cũ 10 phút có thể tệ hơn hẳn hệ thống 95% phục vụ dữ liệu cũ 10 giây. Luôn đọc hit ratio cạnh một thước đo về độ cũ, nếu không bạn đang tối ưu đúng một nửa bài toán.
Hit ratio của Redis khác hit ratio của ứng dụng. keyspace_hits đếm mọi lệnh đọc trúng key trên toàn instance — gồm cả key khoá của phần 6, key phiên đăng nhập, key hàng đợi, mọi thứ. Nếu ứng dụng dùng chung một Redis cho nhiều việc, con số đó trộn lẫn hết và không nói lên gì về cache của bạn. Bộ đếm trong ứng dụng, tách theo từng loại key, mới là thứ dùng được — và đó cũng là lý do mọi phép đo trong loạt bài này đều đếm ở tầng ứng dụng rồi mới đối chiếu với INFO stats.
Cửa sổ quá ngắn thì nhiễu, quá dài thì ì. Cửa sổ 1 giây ở đây hợp với một thí nghiệm 10 giây, nhưng ở production nó sẽ nhảy loạn vì lưu lượng tự nhiên không đều. Cửa sổ 1–5 phút (hoặc rate() trong Prometheus) là điểm cân bằng thường dùng: đủ nhạy để bắt sự cố trong vài phút, đủ mượt để không báo động giả. Điều quan trọng là có cửa sổ, chứ không phải chọn đúng con số.
Số đo ở đây là một tiến trình, tập key 500, trong container. Con số tuyệt đối (18.844 req/s, 6.407 miss/giây) chỉ là của môi trường này. Thứ mang đi được là ba quan hệ: mẫu số tích luỹ làm thước đo ì dần, tải database = lưu lượng × miss ratio, và mỗi lần giảm nửa miss ratio là một bước có giá trị như nhau.
Ba ý mang về
- Hit ratio tích luỹ không dùng để cảnh báo được: khi bot quét làm cache gãy, cửa sổ 1 giây rơi xuống 44,82% còn tích luỹ chỉ chạm đáy 90,21% — ngưỡng cảnh báo 90% không kêu. Bản tích luỹ còn mang theo mọi sự cố cũ mãi mãi, nên không phân biệt được "đang hỏng" với "từng hỏng".
- Hit ratio là tỉ lệ, database chịu con số tuyệt đối: A hit 98,01% đặt 375 truy vấn/giây lên database, B hit 90,20% chỉ đặt 80 — chênh 4,7 lần theo chiều ngược với hit ratio. Hỏi về dung lượng thì nhìn miss trên giây.
- Vẽ miss ratio thay vì hit ratio: mỗi lần giảm nửa miss ratio cắt một nửa tải database, nên 98,75% → 99,375% đáng giá đúng bằng 90% → 95%. Trên trục hit ratio, bước thứ hai trông như không có gì.
Nguồn
- Redis docs — INFO (keyspace_hits, keyspace_misses): https://redis.io/docs/latest/commands/info/
- Google SRE Book — Monitoring Distributed Systems (rate, errors, duration): https://sre.google/sre-book/monitoring-distributed-systems/
- Prometheus docs — rate() và counter: https://prometheus.io/docs/prometheus/latest/querying/functions/
- AWS Builders' Library — Caching challenges and strategies: https://aws.amazon.com/builders-library/caching-challenges-and-strategies/
Phần sau ta nhìn vào chỗ hit ratio hoàn toàn không thấy: một key duy nhất hút phần lớn lưu lượng. Hit ratio vẫn 100%, mọi biểu đồ vẫn xanh, mà một shard Redis nóng rực còn các shard khác ngồi chơi — đo thật phân bố lệch và cách gỡ.
