Phần trước đo được con số đầy đủ của một cơn stampede: 500 request cùng miss một key kéo theo đúng 500 truy vấn giống hệt nhau xuống database, và request xấu nhất chờ 1128,4ms cho một việc vốn chỉ tốn 6,2ms. Nguyên nhân gốc đã rõ: cache-aside không có khái niệm "đã có người đang đi lấy".
Vậy thì thêm khái niệm đó vào. Có hai cách, chúng khác nhau ở một điểm mà chỉ khi chạy nhiều instance mới lộ ra.
Hai cách cho đúng một request đi lấy
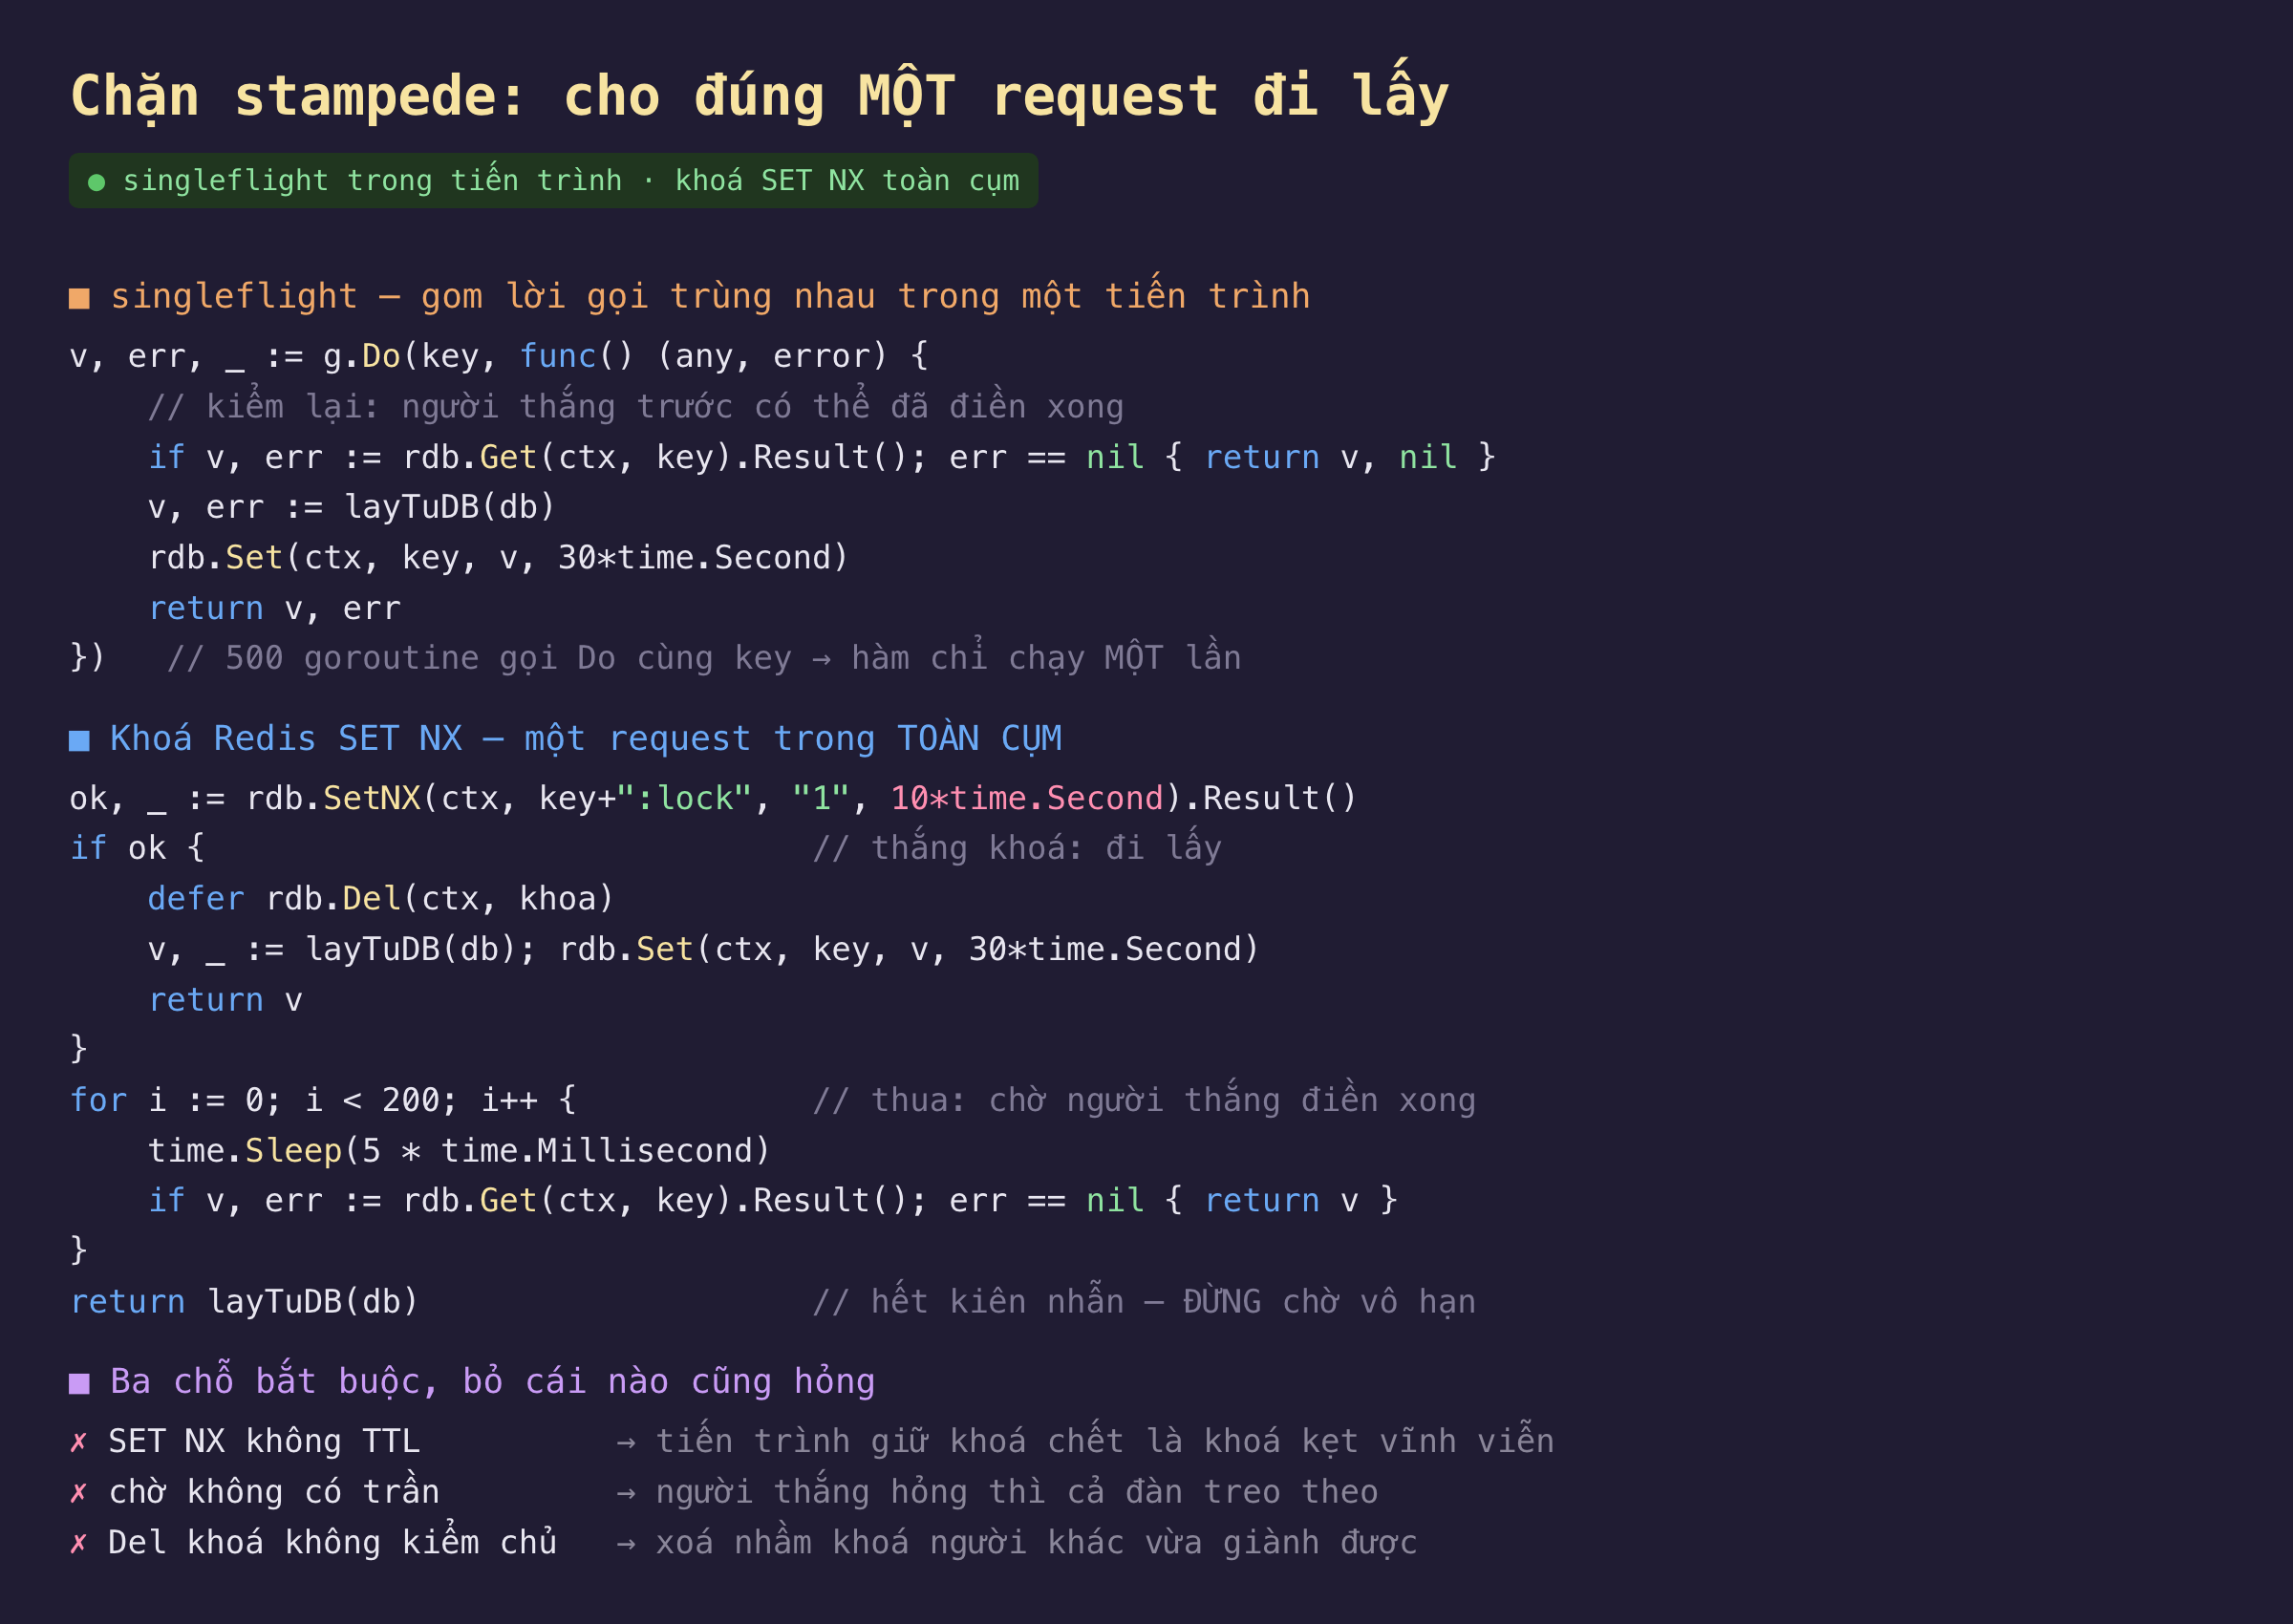
Hình 1: Hai cơ chế. singleflight.Do gom các lời gọi trùng key trong một tiến trình; SET NX đặt khoá trên Redis nên mọi instance cùng tranh một khoá.
Khác biệt nằm ở phạm vi của khoá:
singleflightlà mộtmap[string]*callcó mutex trong bộ nhớ tiến trình. GọiDo(key, fn)nhiều lần với cùng key thìfnchỉ chạy một lần, những lời gọi còn lại chờ cùng kết quả đó. Không có vòng lặp, không có chờ theo nhịp, không chạm mạng.- Khoá
SET NXghi một key khoá lên Redis với cờ "chỉ đặt nếu chưa có". Ai đặt được thì đi lấy; ai thua thì chờ và đọc lại. Vì khoá nằm ngoài tiến trình, mọi instance đều thấy chung một khoá.
Ba chi tiết trong Hình 1 không phải tuỳ chọn:
SET NX phải có TTL. Nếu tiến trình giữ khoá chết giữa chừng — panic, OOM, bị kill — mà khoá không có hạn thì nó kẹt vĩnh viễn: không ai điền được cache nữa, mọi request rơi xuống database mãi mãi. TTL của khoá nên dài hơn thời gian chạy truy vấn một chút, không hơn.
Vòng chờ phải có trần. Code ở đây chờ tối đa 200 nhịp × 5ms = 1 giây, hết thì tự đi lấy. Chờ vô hạn nghĩa là khi người thắng khoá hỏng, cả đàn treo theo — đổi một sự cố database thành một sự cố toàn bộ ứng dụng, tệ hơn hẳn cái ta đang muốn tránh.
Xoá khoá phải kiểm mình có phải chủ không. rdb.Del(khoa) trần là một bug chờ xảy ra: nếu truy vấn của bạn chạy quá TTL khoá, khoá tự hết hạn, người khác giành được — rồi bạn Del đúng khoá của người đó. Cách đúng là ghi một token ngẫu nhiên lúc SET NX và xoá bằng script Lua so token trước khi xoá. Đoạn code trong bài giữ Del trần cho gọn vì TTL khoá 10 giây dài hơn truy vấn 6ms rất nhiều; ở hệ thật thì đừng bỏ qua chi tiết này.
Đo thật: 500 lượt chạm database còn 1
Cùng kịch bản phần 5 — xoá key, 500 goroutine cùng xuất phát, truy vấn gộp 400.000 dòng, pool database 50 kết nối:
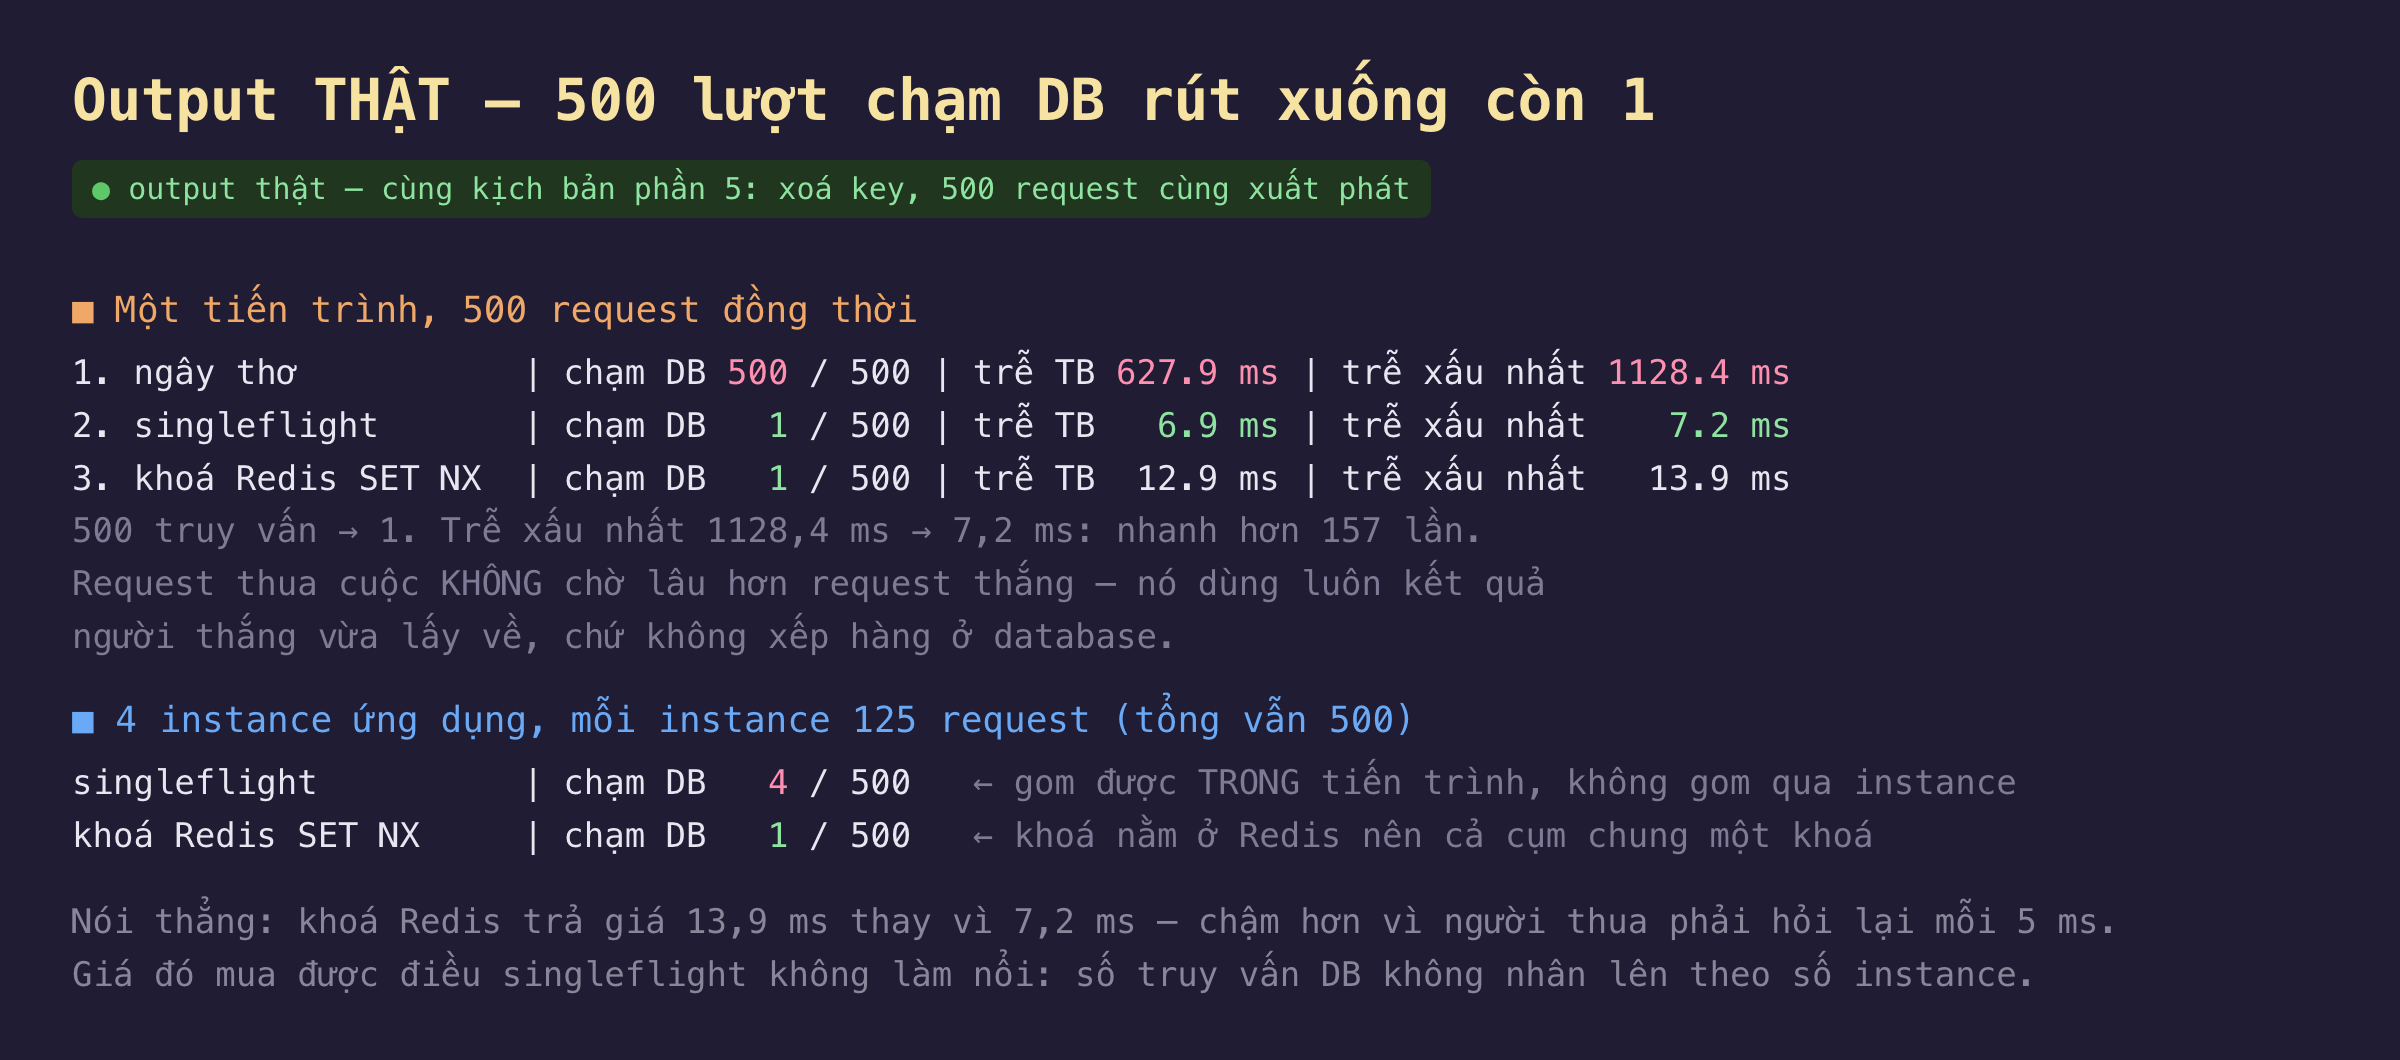
Hình 2: Kết quả thật. Hai bảng kể hai câu chuyện khác nhau — bảng trên nói cả hai cách đều hiệu quả như nhau, bảng dưới nói chúng hoàn toàn không như nhau.
- 500 truy vấn → 1. Cả
singleflightlẫn khoá Redis đều kéo số lượt chạm database xuống đúng 1. Đây là mức sàn lý thuyết: một key miss thì phải có đúng một lần đi lấy. - Trễ xấu nhất 1128,4ms → 7,2ms, nhanh hơn ~157 lần. Con số này đáng dừng lại vì nó phản trực giác: 499 request thua cuộc lại không hề chờ lâu hơn request thắng. Chúng không xếp hàng ở database; chúng chờ đúng một lượt truy vấn 6,2ms rồi cùng nhận kết quả. Chống stampede không phải là bắt phần lớn request chờ lâu hơn để database đỡ mệt — nó làm mọi request đều nhanh hơn, kể cả người thua.
- Khoá Redis chậm hơn singleflight: 13,9ms so với 7,2ms. Chênh lệch gần đúng một nhịp thăm dò: người thua ngủ 5ms rồi mới hỏi lại, nên trung bình mất thêm ~2,5ms, cộng thêm một vòng
SET NXqua mạng. Rút nhịp ngủ xuống thì nhanh hơn nhưng tốn thêm lệnh Redis; đây là núm đánh đổi rõ ràng.
Chỗ hai cách thật sự khác nhau: nhiều instance
Bảng đầu khiến singleflight trông thắng tuyệt đối — rẻ hơn, nhanh hơn, không cần Redis. Nhưng production không chạy một tiến trình. Mình chạy lại với 4 instance ứng dụng, mỗi instance có singleflight.Group riêng, mỗi instance nhận 125 request (tổng vẫn 500):
singleflight: 4 lượt chạm database. Đúng một lượt mỗi instance.singleflightgom hoàn hảo trong tiến trình và hoàn toàn mù với các tiến trình khác.- Khoá Redis: 1 lượt. Khoá nằm ở Redis nên cả bốn instance tranh chung một khoá, ba instance thua và cùng chờ.
Con số 4 nghe vẫn nhỏ so với 500, nhưng nó nhân theo số instance: 40 instance là 40 truy vấn đồng thời, 200 instance là 200 — và quy mô instance thường tăng đúng lúc lưu lượng cao, tức đúng lúc bạn cần bảo vệ database nhất. Đây là lý do singleflight một mình không đủ ở hệ phân tán.
Cách dùng thực tế là chồng cả hai: singleflight ở vòng ngoài để gom hàng trăm goroutine trong mỗi instance xuống còn 1 lời gọi mà không tốn một lệnh mạng nào, rồi khoá Redis ở vòng trong để gom N instance xuống còn 1 truy vấn. Mỗi lớp xử lý đúng phần nó làm tốt nhất, và lớp rẻ hơn chặn phần lớn lưu lượng trước khi tới lớp đắt hơn.
Đánh đổi cần cân nhắc
Khoá Redis là một điểm hỏng mới, và nó nằm đúng trên đường đọc. Nếu Redis chậm hoặc mất kết nối ngay lúc đặt khoá, mỗi request miss lại cộng thêm một vòng đi-về thất bại trước khi xuống database. Code phải quyết định rõ: Redis lỗi thì đi thẳng xuống database (chấp nhận stampede, giữ dịch vụ sống) chứ không phải trả lỗi cho người dùng. Đây là áp dụng lại nguyên tắc ở phần 2: lỗi Redis không bao giờ được biến thành lỗi của request.
Người thua vẫn chờ, và cái chờ đó có trần bằng độ dài truy vấn gốc. Phép đo này dùng truy vấn 6,2ms nên chờ gần như vô hình. Nếu truy vấn gốc mất 3 giây, 499 request kia chờ 3 giây — chúng không giết database nữa, nhưng người dùng vẫn thấy chậm. Khi truy vấn gốc đắt tới mức đó, cách tốt hơn là không bắt ai chờ cả: phục vụ bản cũ trong lúc một request đi làm mới ở nền (stale-while-revalidate). Đó là hướng khác hẳn với "cho một người đi lấy", và nó chỉ dùng được khi dữ liệu hơi cũ chấp nhận được.
Đừng thêm cơ chế này cho mọi key. Luật R × D ở phần trước cho biết key nào thực sự có nguy cơ. Với key chỉ vài req/s, singleflight không tốn gì nhưng cũng chẳng gom được gì, còn khoá Redis thì cộng một vòng đi-về cho mỗi lần miss — thuần tuý là phí. Bảo vệ đúng những key có R × D lớn.
Số đo ở đây là bốn singleflight.Group trong cùng một tiến trình để mô phỏng bốn instance. Chúng chia sẻ cùng pool Redis và cùng pool database, nên không mô phỏng được độ trễ mạng giữa các máy hay việc mỗi instance có pool riêng. Điều cần mang đi là tỉ lệ: số truy vấn của singleflight bằng đúng số instance, còn khoá Redis thì bằng 1 bất kể bao nhiêu instance.
Ba ý mang về
- Cho đúng một request đi lấy kéo 500 truy vấn xuống 1, và điều phản trực giác là nó làm mọi request nhanh hơn: trễ xấu nhất từ 1128,4ms xuống 7,2ms (~157 lần) — người thua cuộc chờ đúng một lượt truy vấn rồi dùng chung kết quả, chứ không xếp hàng ở database.
singleflightgom trong tiến trình, khoá Redis gom toàn cụm: với 4 instance,singleflightcho 4 truy vấn còn khoá Redis vẫn 1. Con số củasingleflightnhân theo số instance, nên ở hệ phân tán hãy chồng hai lớp —singleflightở ngoài (rẻ, không chạm mạng), khoá Redis ở trong.- Khoá phải có TTL, vòng chờ phải có trần, và xoá khoá phải kiểm chủ. Thiếu TTL là khoá kẹt vĩnh viễn khi tiến trình giữ khoá chết; thiếu trần chờ là biến sự cố database thành sự cố toàn ứng dụng;
Deltrần có thể xoá nhầm khoá người khác vừa giành được.
Nguồn
golang.org/x/sync/singleflight— tài liệu gói: https://pkg.go.dev/golang.org/x/sync/singleflight- Redis docs — SET với NX và EX: https://redis.io/docs/latest/commands/set/
- Redis docs — Distributed locks with Redis: https://redis.io/docs/latest/develop/clients/patterns/distributed-locks/
- AWS Builders' Library — Caching challenges and strategies: https://aws.amazon.com/builders-library/caching-challenges-and-strategies/
Phần sau ta quay về vấn đề mà TTL chỉ che được chứ không giải: khi database đổi, làm sao cache biết? Đo thật cửa sổ dữ liệu sai của từng cách xoá cache, và vì sao thứ tự "ghi DB rồi xoá cache" hay "xoá cache rồi ghi DB" cho ra hai kết quả khác nhau.
